谷歌和微软很少达成一致。但现在它们正在构建同样的东西来修复智能体访问网页的问题,这可能是多年来网络最大的变革。
让智能体帮你买东西,然后看看它实际在做什么。
它截取页面的截图。它寻找类似按钮的东西。它点击、等待,再截图。它像你一样读取屏幕,只是速度更慢,而且每次查看都要消耗 token。
这种方式在演示时往往够用。但当网站发布重新设计时,它就失效了。
这里比表面看起来更奇怪的地方在于:网站已经确切知道自己能做什么。它有搜索、购物车、结账、预订流程。但这一切都没有以程序可读的形式记录下来。所有功能都被埋在为人类设计的布局中。
所以问题不在于智能体不擅长读页面,而在于页面从来不是为了除人类以外的任何东西而编写的。
看看这个例子:
WebMCP 是来自 Chrome 和 Edge 团队的一个浏览器 API,让网站能够把这些操作写下来。搜索、加入购物车、预订时段,每个操作都有一个名称、一段为模型阅读而编写的描述,以及它接受的输入列表。
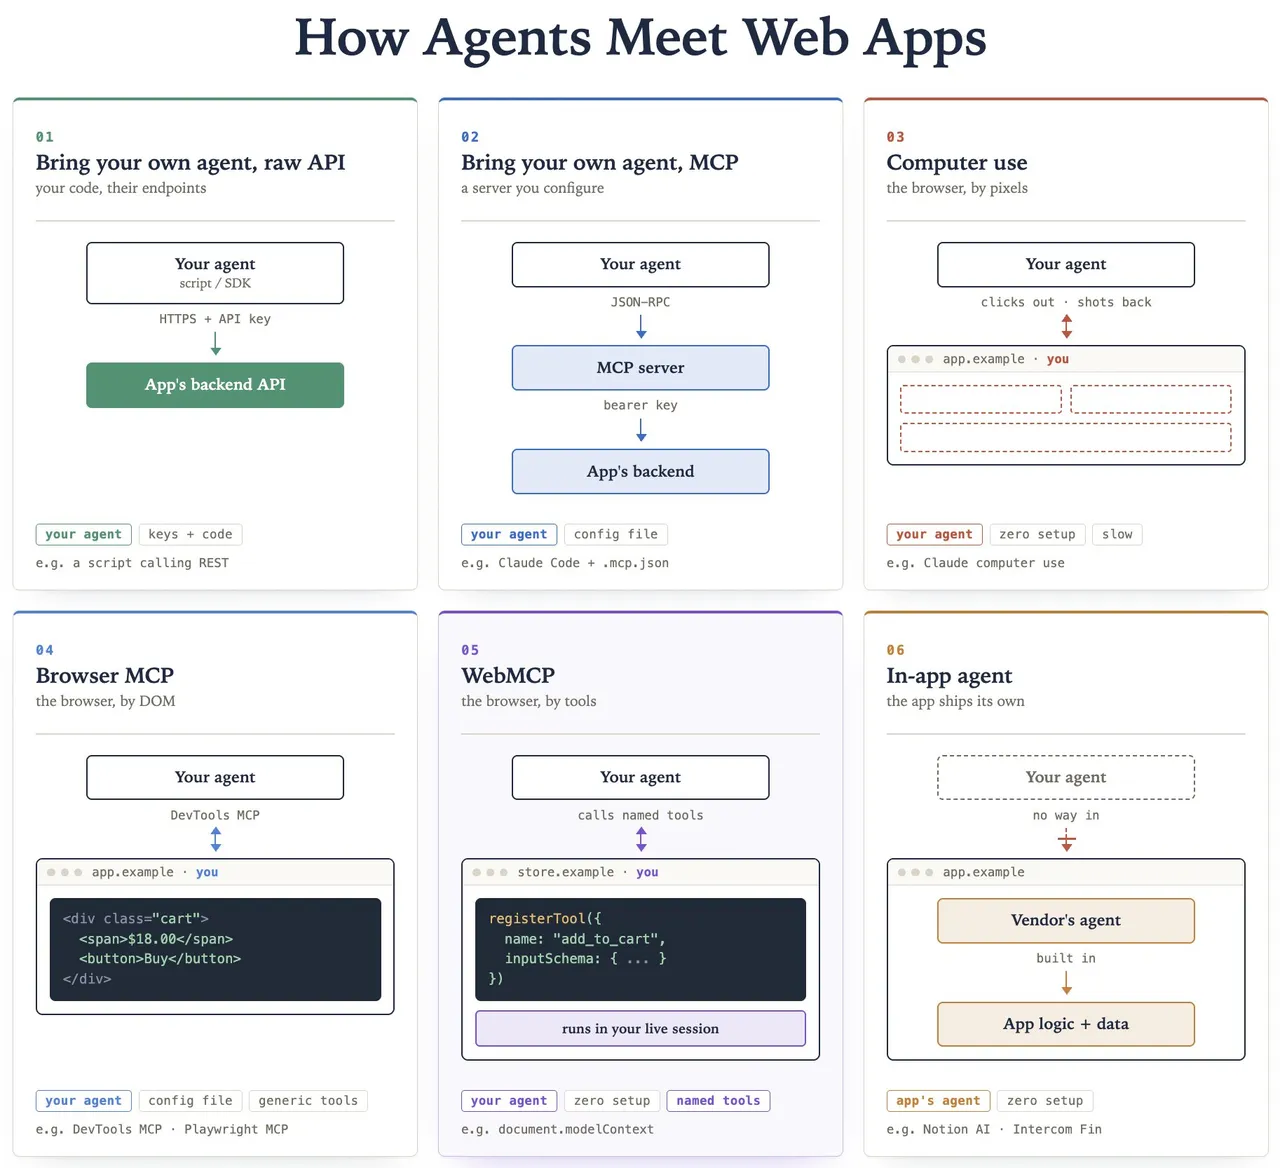
WebMCP 是智能体到达应用的六种方式之一。把六种方式并排放在一起,逐个审视,就会明白为什么这一种是更优的选择。
我们开始吧!
Six ways an agent can reach an app(智能体访问应用的六种方式)
把它们从距离接口最远到最近排列。
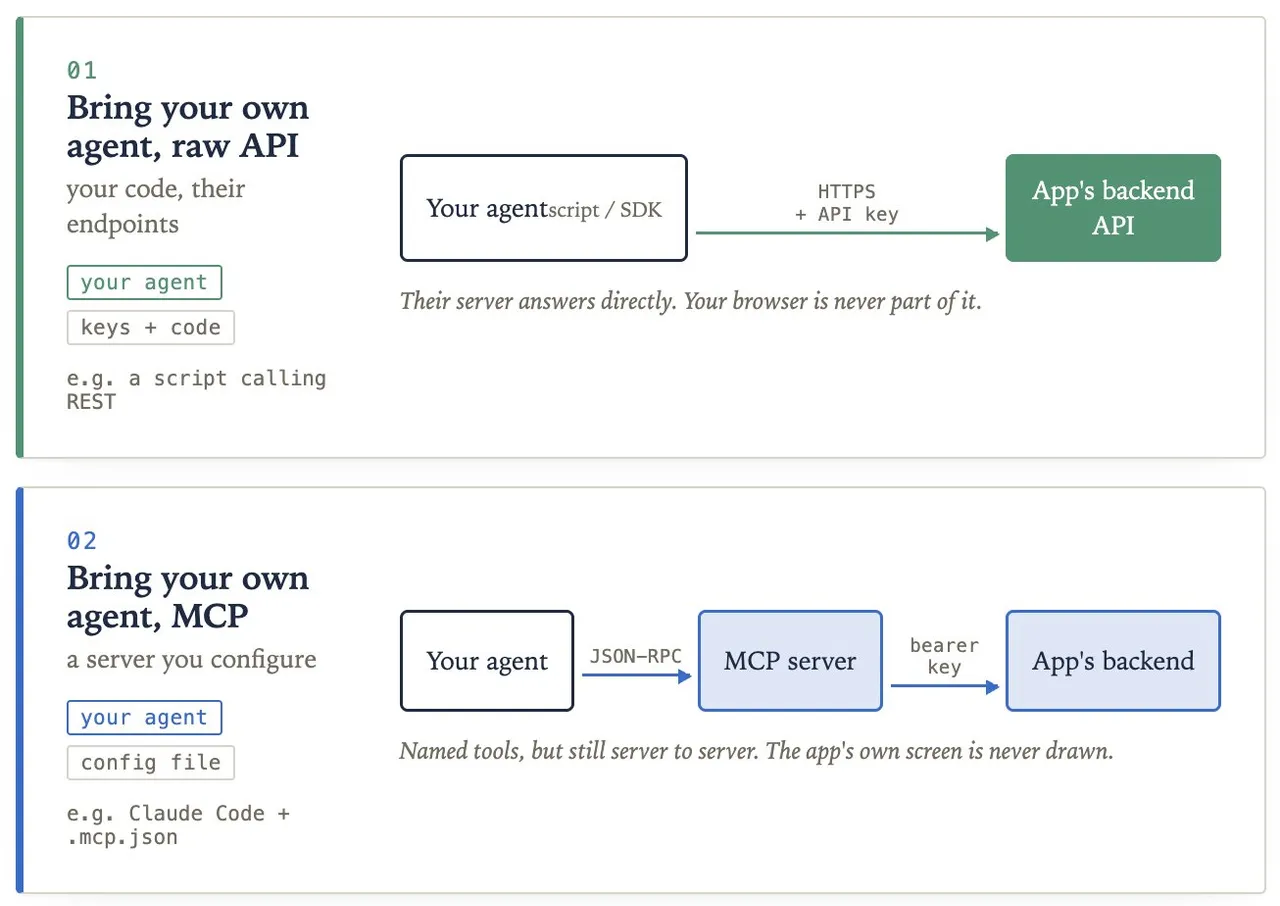
1. 直接调用原始 API。 你的脚本用 API 密钥直接访问公司的后端。精确且快速。但你得自己找到端点,自己管理密钥,网站完全不参与。
2. 连接后端 MCP 服务器。 公司构建一个服务器,把其操作描述为命名工具,你的智能体连接到它。更好,因为定义这些工具的是了解产品的人。用户界面仍然完全被跳过。
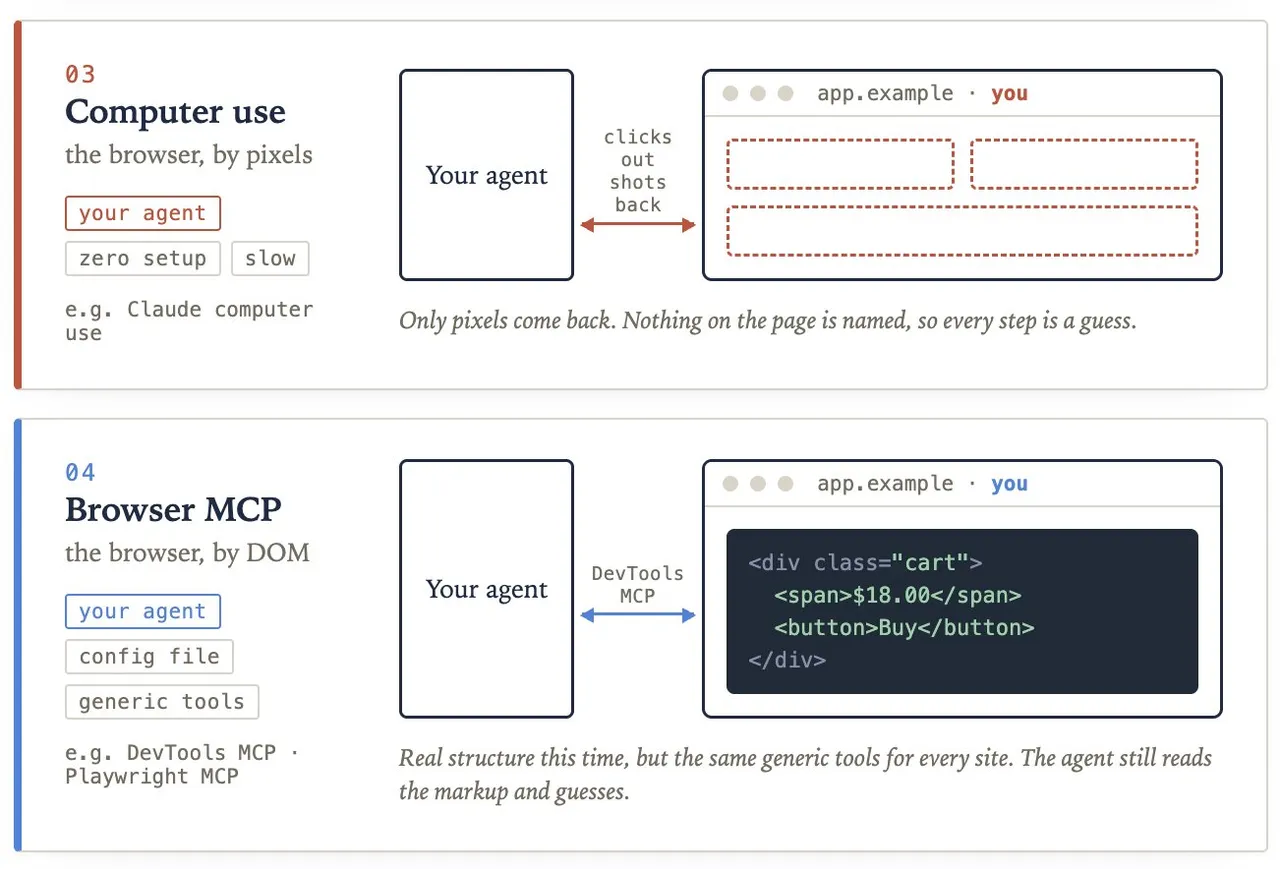
3. 让智能体使用计算机。 你的智能体把实时页面当作图像来看,并四处点击。无需任何设置。但速度慢,每次查看都花钱,而且布局变化会把它搞糊涂。
4. 用浏览器自动化工具指向它。 你的智能体读取页面底层代码,而不是它的图片。比像素更可靠。但工具仍然是通用的,所以智能体只能从匿名的 div 和按钮中推断含义。
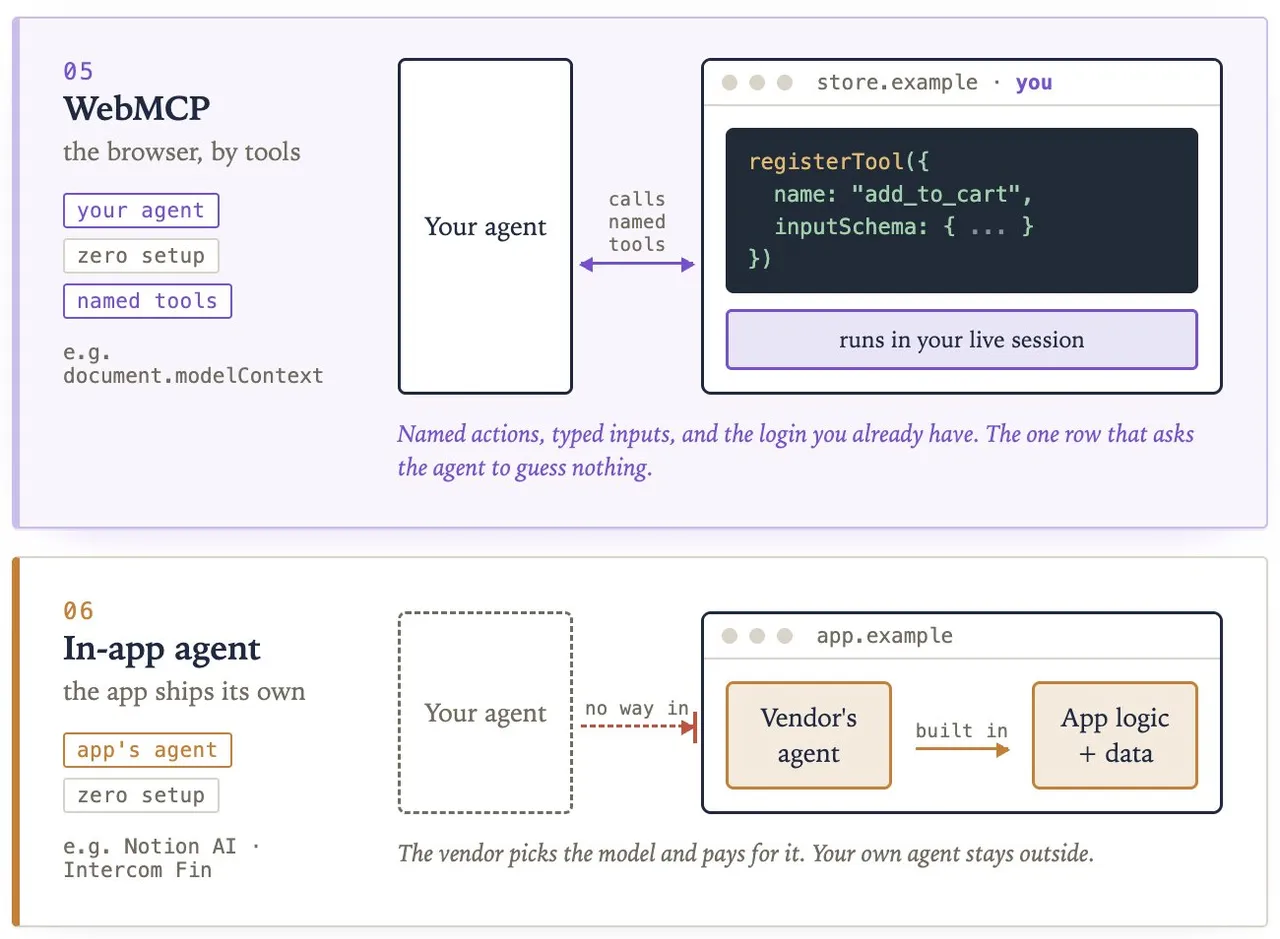
5. WebMCP。 页面声明自己的操作,带有名称、描述和类型化输入。你的智能体调用它们。
6. 使用网站内置助手。 公司自带聊天框。它选择模型,支付 token 费用,你的智能体被挡在外面。基本上,这不让你带自己的智能体去和网站交互。
What lining them up actually shows(并排比较真正揭示了什么)
当六种方式并排放在一起,模式就显而易见了。有三件事在它们之间各不相同。
谁家的智能体在做工作。用户在任何事情发生之前需要配置什么。以及智能体到达时实际收到的是什么。
每一种选项都至少放弃这三者中的一项。
- 原始 API 和后端 MCP 服务器给你干净的类型化操作,但你需要自己配置,而且网站从画面中消失了。
- 计算机使用无需设置,但把像素交给智能体,让它自己去解决一切。
- 浏览器自动化提供了结构,但对互联网上每个网站都是同样的通用结构。
- 内置助手免费且精确,但它不是你的智能体,所以它了解你的信息不会带到任何其他地方。
WebMCP 是唯一保留全部三者的方式。你自己的智能体,无需配置,真正命名的操作而不是猜测。
Why declaring beats guessing(为什么声明胜过猜测)
这个变化说起来很小,但影响很大。不再是智能体自己猜测按钮做什么,而是网站直接说出它做什么。
由此带来几件事。
- 猜测停止了。 智能体拿到一份带有类型化输入的操作列表。不再有解释步骤,也就不会发生错误的点击悄悄做了错误的事情。
- 登录免费获得。 操作在你的浏览器标签页中、在你的会话中运行。智能体不需要持有 API 密钥,不需要单独登录,不需要传递 token。你已经登录了,所以它已经有了访问权限。
- 可用操作随页面变化。 这是人们常常忽略的部分。未登录访客的智能体只能看到少量只读操作,比如搜索和产品查询。登录后,网站会添加其余操作,比如订单历史、购物车和结账。智能体端不需要任何特殊处理,它只是重新读取列表。
- 你的界面保持不变。 操作在你的可见页面上运行,所以用户能看到它发生,你的产品也不会被简化成别人聊天窗口调用的 API。
- 任何模型都能使用它。 输入用 JSON Schema 描述,这是 Claude、GPT 和 Gemini 做工具调用时已经使用的同一格式。你只需描述一次你的操作。
What it looks like in code(代码中是什么样子)
工具就是一个普通的 JavaScript 对象,交给浏览器。代码放在你页面自己的前端脚本中,就是当有人加载网站时已经在运行的那个 JavaScript。你在页面加载时注册每个工具一次,之后任何访问该页面的智能体都能看到并调用它。
document.modelContext.registerTool({
  name: "add_to_cart",
  description: "Add a product to the shopping cart",
  inputSchema: {
    type: "object",
    properties: {
      productId: { type: "string" },
      quantity: { type: "number" }
    },
    required: ["productId"]
  },
  async execute({ productId, quantity }) {
    await addToCart(productId, quantity);
    return `Added ${quantity} to the cart`;
  }
});四个部分,其中只有一个是新工作。
名称是智能体调用的标识。描述用普通英文编写,因为语言模型读它来决定这是否是正确的操作。schema 说明哪些输入是有效的,这样错误的参数永远到不了你的代码。
最后一部分是运行的函数。注意它只是调用了 addToCart,这与你自己的按钮背后的函数完全相同。你不是在为智能体构建产品的第二个版本。你指向的是你已有的那个。
如果你想公开的内容已经是一个表单,你完全不需要编写 JavaScript。你只需在已有的 HTML 表单标记中添加两个属性。
Search
两个属性。浏览器读取表单,计算出它接受一个出发地和一个目的地,并自行构建模式。
这就是全部的想法。网络用三十年的时间通过布局向人们描述自己,它没有为程序提供相应的描述。WebMCP 是对缺失描述的一种尝试,由已经知道答案的网站编写。
这对你的影响
在互联网历史的大部分时间里,唯一值得为其设计的访客是人。这种情况开始改变,告诉智能体它能做什么的网站将比让智能体从像素中猜测的网站获得更干净、更可靠的结果。
这仍然处于早期阶段。一家浏览器厂商已经发布了它,标准还未最终确定,今天只有浏览器自己的智能体调用这些工具。但尝试的成本几乎为零。如果你拥有一个网站,最便宜的起点是你已经拥有的表单。添加这两个属性,在支持试验的浏览器中打开它,然后观看智能体使用它。
在此阅读官方文档 →
下面的插图概述了当今智能体如何访问网络应用。