
2026 年,所有人都在谈 AI agent。
但大多数人并不知道它们到底怎么工作。
今天这篇会把它讲清楚。
我花了几周时间,把课程、书、真实构建经验和生产故障都压缩到一起。
下面是你真正需要知道的内容。
无论你是想自动化自己的工作流,还是为公司构建生产级 AI 系统,这都是你的路线图。
收藏下来。这篇很长,但值得。
第一部分:入门,AI agent 到底是什么
1. 什么是 AI Agent?
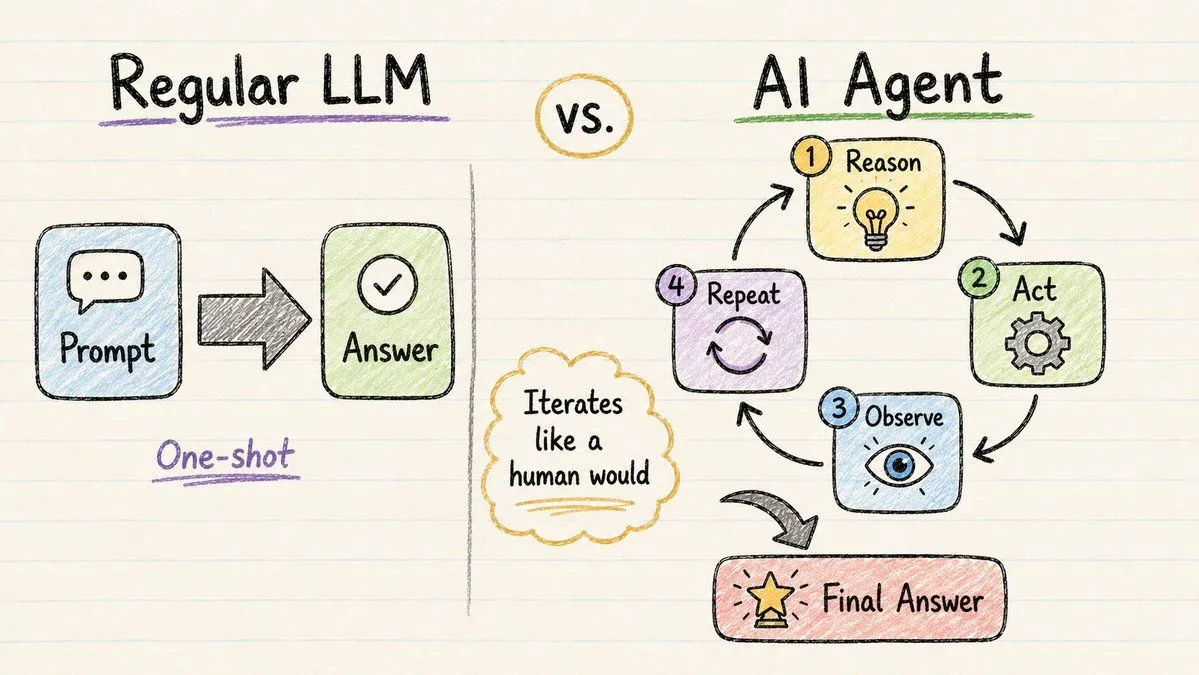
普通 LLM 只做一件事:
你问,它答,然后结束。
一次性、线性、没有迭代。
AI agent 的工作方式不同。
它更接近你真正处理困难任务的方式:
→ 先规划→ 研究→ 起草→ 审查自己的工作→ 修改→ 重复
这叫 ReAct loop:
Reason → Act → Observe → Repeat
模型会推理下一步该做什么,执行动作(通常是调用工具),观察结果,然后要么给出答案,要么回到循环里继续。
为什么这很重要?
每一轮都会增加深度:更强的推理、更少的幻觉、更好的组织结构。
你试图一次性完成任务时丢掉的那些东西,agent 能拿回来。
2. Agent 到底适合做什么?
不是每个任务都需要 agent。
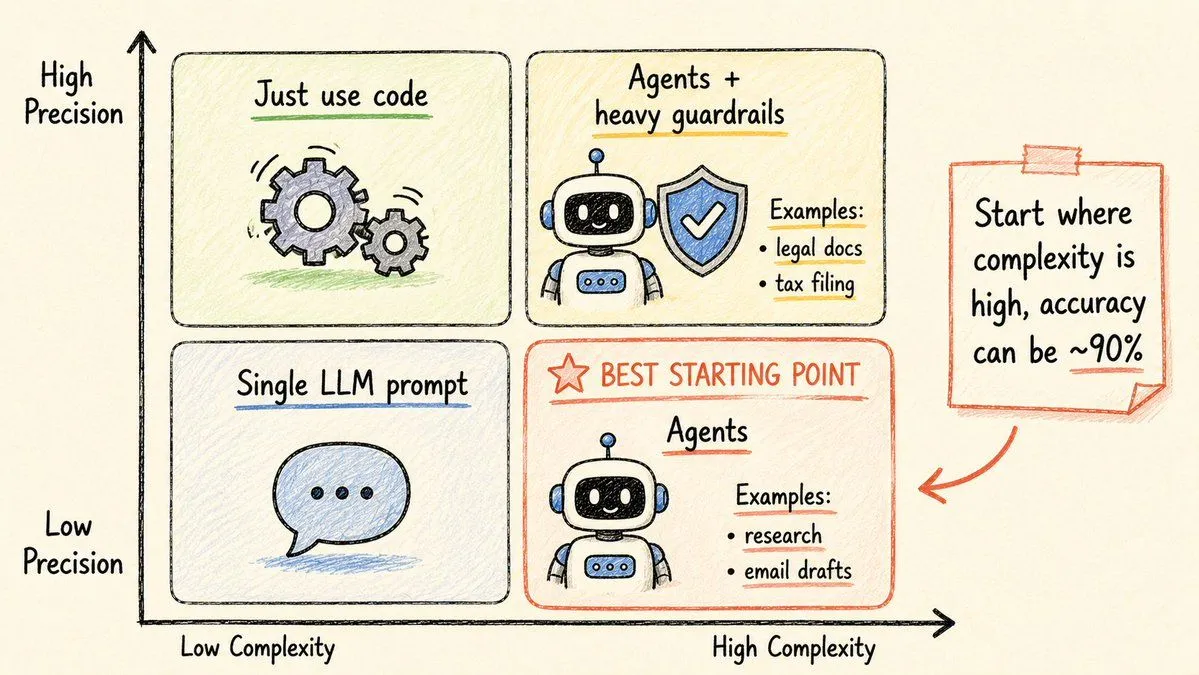
正确的心智模型是一个 2×2 矩阵。
两个轴:复杂度与所需精确度。
→ 低复杂度 + 高精确度 = 直接用代码→ 低复杂度 + 低精确度 = 用单个 LLM prompt 就够→ 高复杂度 + 高精确度 = 带重 guardrails 的 agent(税表、法律文档)→ 高复杂度 + 低精确度 = 最适合起步的甜点区
最后这个象限,是最快能拿到早期收益的地方。
非常适合 agent 的任务示例:
→ 调研并写报告→ 回复客户邮件(查订单 → 起草回复)→ 处理发票→ 保存到数据库→ 回答“你们有没有 80 美元以下的蓝色牛仔裤?”并真的检查库存
当任务需要下面这些能力时,agent 会发光:
→ 多步骤→ 外部信息→ 迭代和自我修正
如果一个 prompt 就能解决,就不要构建 agent。
3. 自主能力层级
构建 agent 时,第一个重大决定是:
你给它多少控制权?
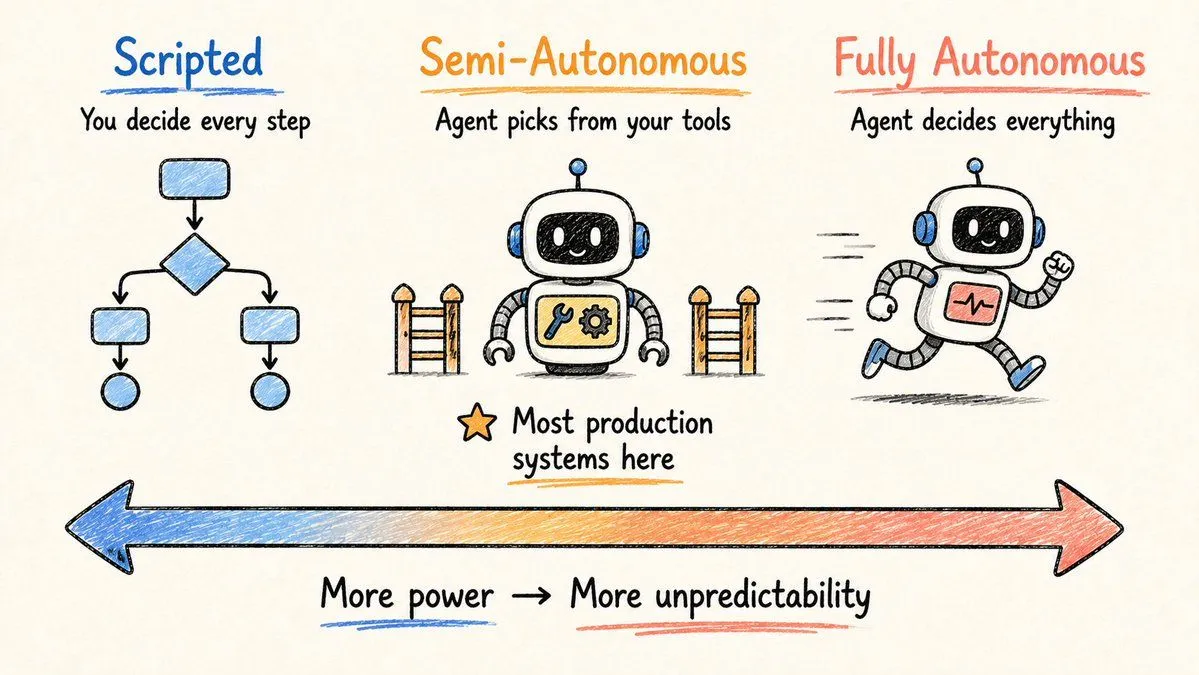
可以把它想成一条光谱。
脚本式(最左端)
你硬编码每一步。
→ 生成搜索词→ 调用网络搜索→ 抓取页面→ 写文章
模型只负责文本生成,其他一切都由你决定。可预测,容易调试,但能力有限。
半自主(中间)
agent 从你定义好的工具里选择,在你设置的 guardrails 内做决定。多数真实生产系统都在这里。
完全自主(最右端)
LLM 决定一切:搜什么、抓多少页面、是否反思、是否写新代码并运行。能力更强,也难控制得多。
应该从哪里开始?
从光谱中间开始。给它工具,设好 guardrails。只有在信心增加后再逐步提高自主性。
4. 上下文工程
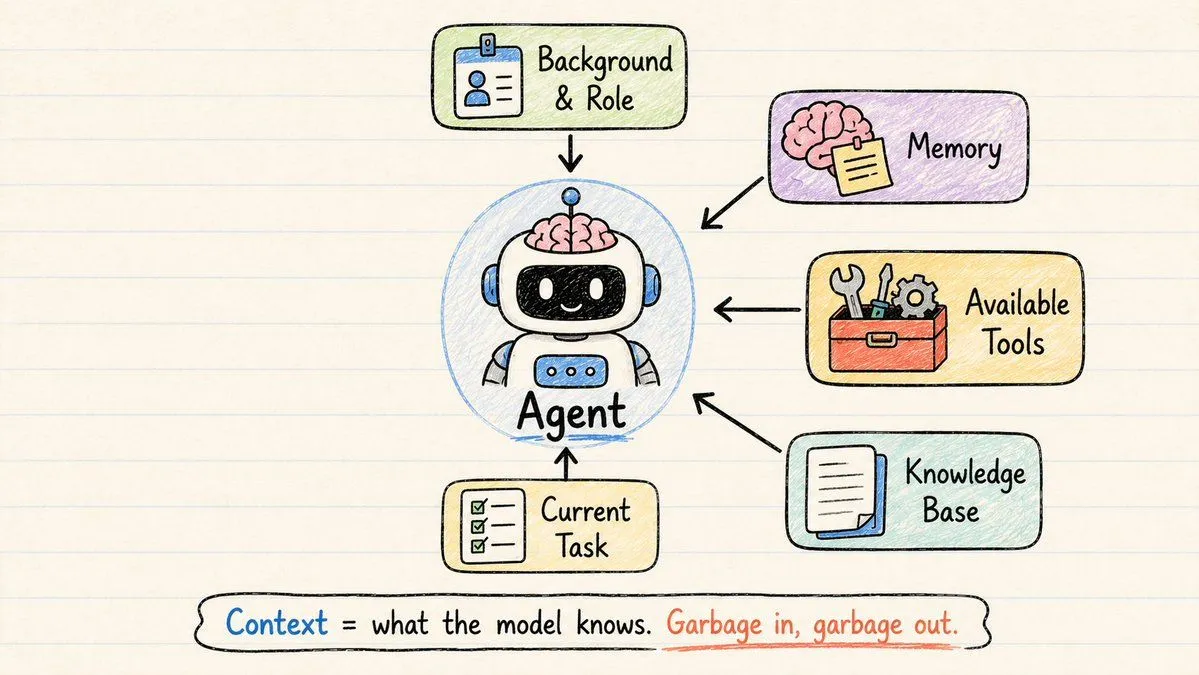
真正让 agent 显得“智能”的是什么?
不是模型本身。
是你围绕它构建的 context。
context engineering = 决定 agent 在每个时刻能看到哪些信息。
这包括:
→ 背景:任务是什么,用户是谁→ 角色:“你是专注市场分析的研究型 agent”→ Memory:前面步骤发生过什么→ 可用工具:它可以调用哪些函数→ Knowledge:它可以引用的文档、数据库、PDF
context 设计得好,模型行为就稳定。
context 设计得差,输出就不可预测。
模型两种情况下是同一个模型。
context 才是优秀 agent 和坏掉 agent 的分水岭。
5. 任务分解
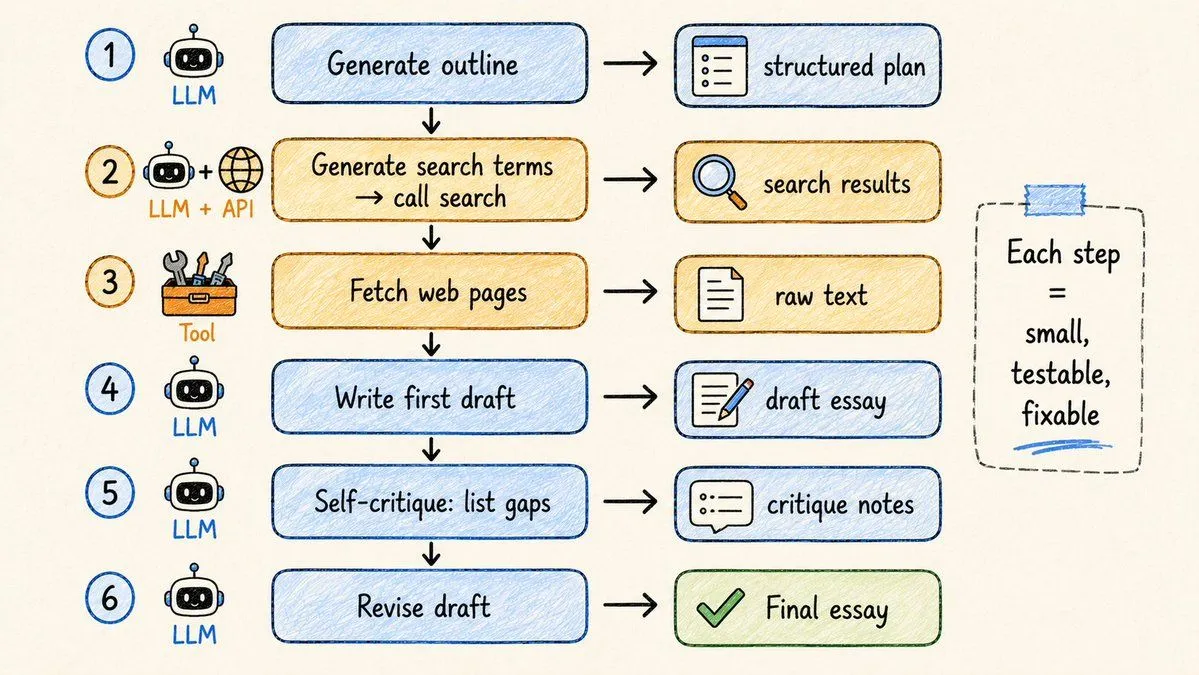
构建 agent 最重要的技能。
先问:如果是人类,会怎样完成这个任务?
然后对每一步问:这一步能由 LLM 完成吗?能由一点代码完成吗?能由 API call 完成吗?
如果答案是否定的,就继续拆,直到每一步都能做。
例子:写作型 agent。
- 大纲 → LLM 生成结构
- 搜索词 → LLM 生成搜索词,然后调用搜索 API
- 抓取页面 → 工具调用
- 写草稿 → LLM 基于抓取来源写草稿
- 自我评审 → LLM 列出缺口和弱点
- 修订 → LLM 基于评审意见重写
每一步都应该:
→ 小→ 可检查→ 有清晰输入和输出
当最终输出不好时,你能准确知道该修哪一步。
这就是 decomposition 的超能力。
第二部分:中级,构建真正能工作的 multi-agent system
6. 评估:把专业构建者和业余玩家区分开的东西
没人想聊评估。
但所有能上线真实系统的人都会做。
怎么衡量你的 agent 是否在工作?
简单任务:数正确答案。客服 bot 是否正确回答了库存问题?是/否。
复杂任务:用 LLM-as-judge。让第二个模型根据固定评分标准给输出打 1-5 分。文章论证强吗?引用合适吗?语气对吗?
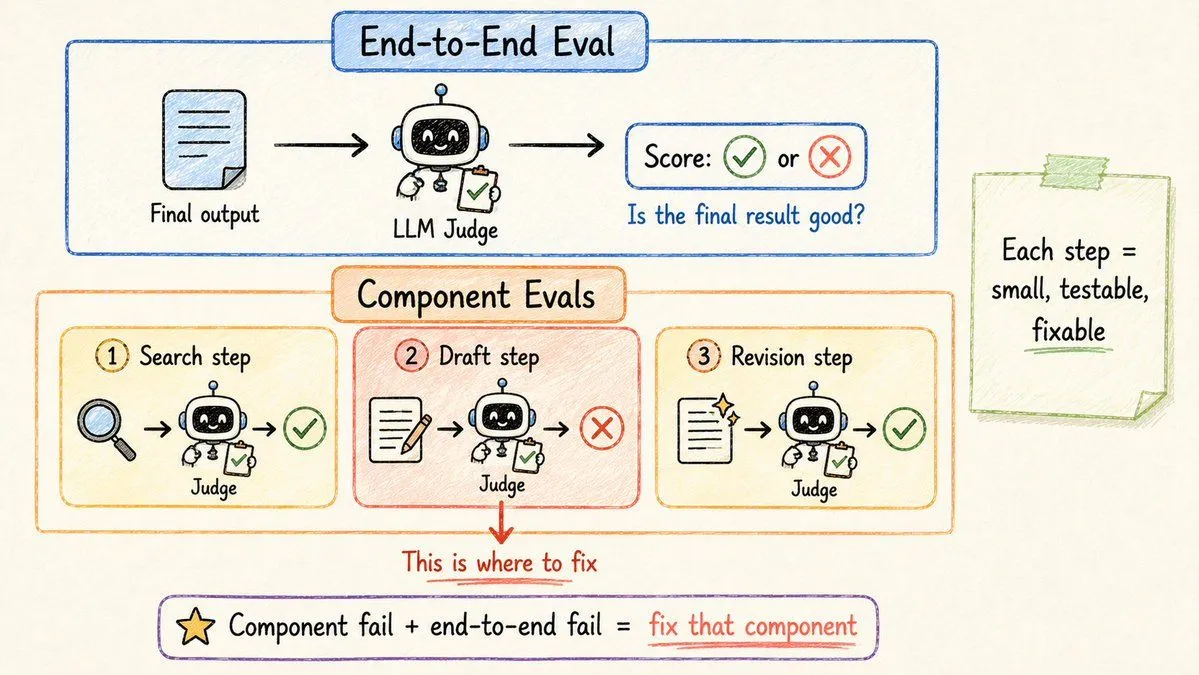
你需要两层评估:
→ 组件级:每个单独步骤是否正常?搜索 query 是否足够具体?评审是否给出真实反馈?
→ 端到端:最终输出是否足够好?文章本身是否真的好?
如果端到端失败但组件评估通过,那是交接问题。如果某个组件失败,那就是这个 agent 需要修。
从第一天就开始评估。不要等所谓“完美”的评估系统。先快速上线一个版本,然后迭代。
7. 记忆与知识
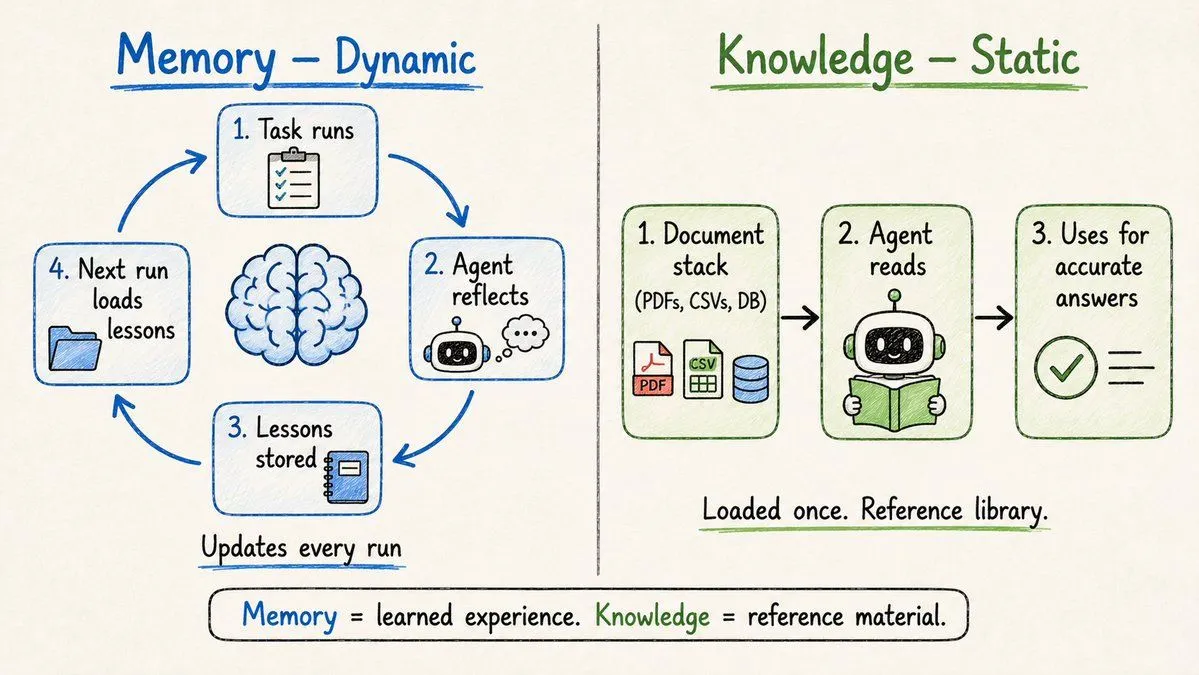
两个完全不同、但经常被混淆的东西。
Memory = 动态的。每次运行都会更新。
→ 短期:agent 工作时写笔记,其他 agent 可以读这些笔记。→ 长期:任务结束后,agent 反思哪里做得好、哪里做得不好,并存储经验。
下一次运行时,加载这些经验,再应用它们。
这就是不 fine-tuning 也能“训练”agent 的方式:给反馈,agent 每次运行都会变好。
Knowledge = 静态的。启动前加载。
→ PDF、CSV、内部文档、数据库访问→ agent 的参考资料库→ 给它一次,它需要准确回答时随时引用
可以这样理解:
Memory = 你从经验中学到的东西。Knowledge = 你可以查阅的教材。
两者都重要,谁也不能替代谁。
8. 护栏
一个能工作的 agent,不等于一个安全的 agent。
LLM 是非确定性的。
它可能写错格式,陈述错误事实,偏离任务。
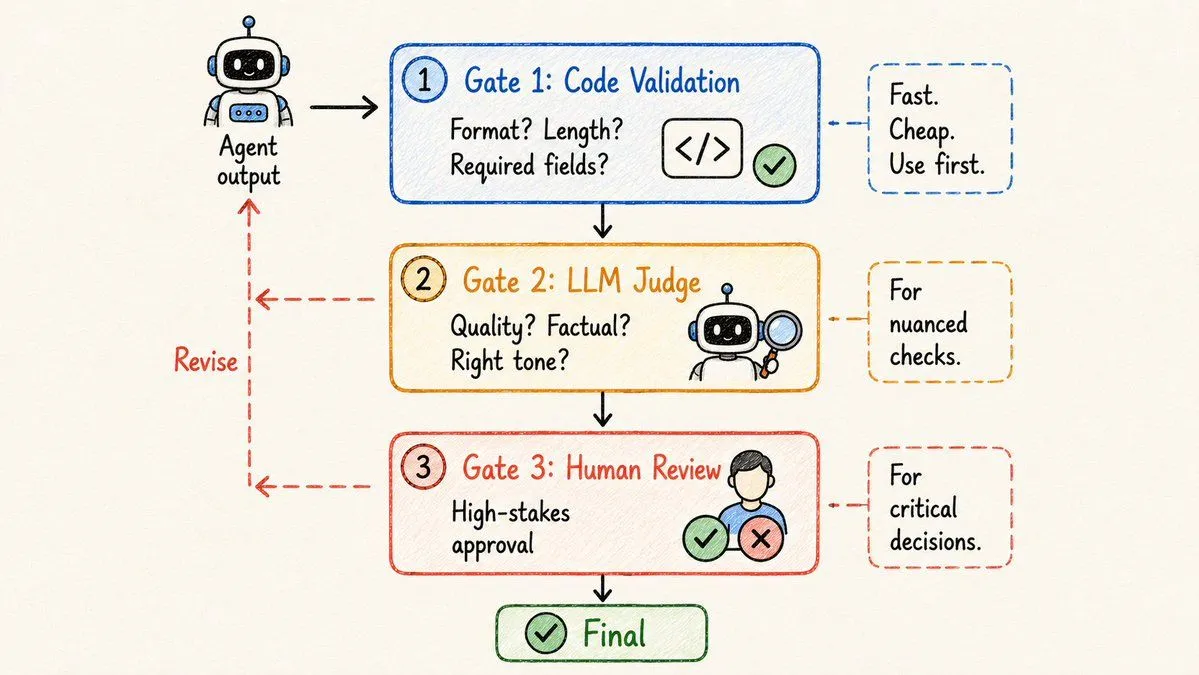
guardrails 是“agent 说它完成了”和“任务真的可以定稿”之间的质量闸门。
有三种类型:
类型 1:代码检查(快 + 便宜)
用于确定性的事情。输出格式对吗?长度对吗?必要字段都在吗?写一个简单校验函数,立刻运行。只要可能,永远优先用这个。
类型 2:LLM judge
用于更细腻的质量检查。例如:“这个回答是否与来源文档事实一致?”“语气是否专业且积极?”如果 judge 说不行,就解释原因,agent 修改,再试一次。
类型 3:Human in the loop
用于高风险决策。agent 在定稿前停下来,把输出发给人类审阅。人类批准、拒绝或要求修改。
大多数生产系统至少会用到这三种里的两种。
9. 让每个 agent 变强的 4 个设计模式
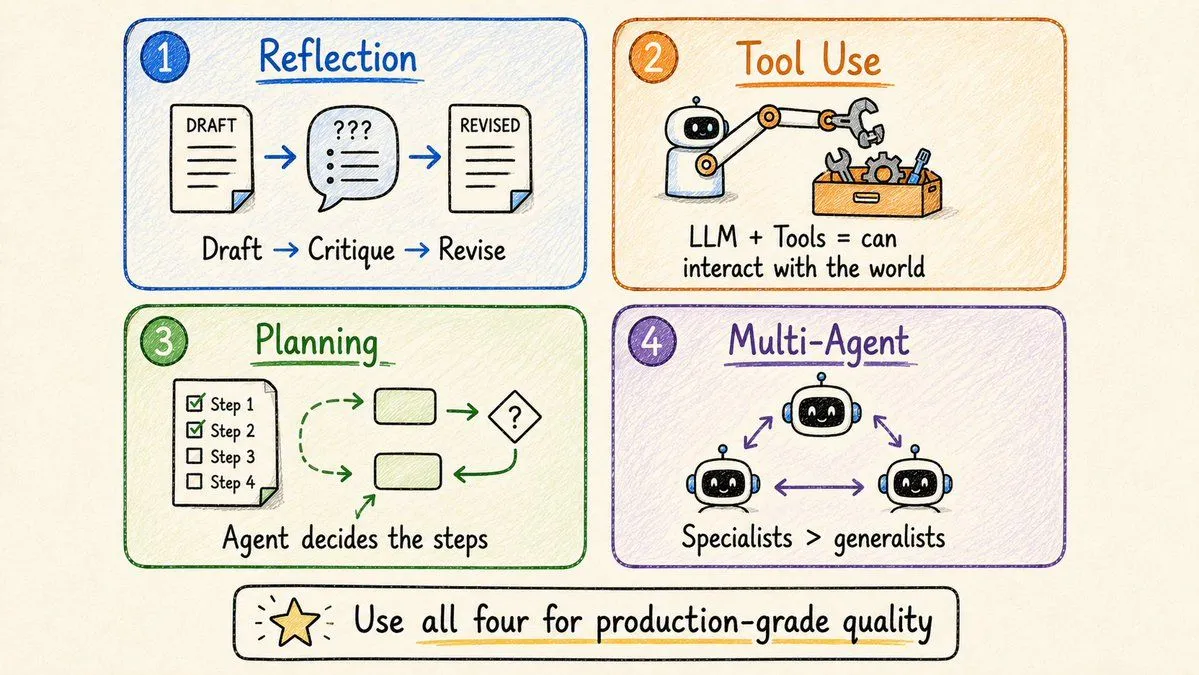
这四种模式能稳定提升 agent 表现。
模式 1:Reflection(反思)
不要停在第一版草稿。
模型生成输出 → 批评它 → 基于批评重写。
邮件 v1:“嘿,我们下个月见。谢谢。”评审意见:日期模糊、没有签名、语气太随意。邮件 v2:“Alex 你好,我们可以在 1 月 5-7 日之间约。告诉我你哪天方便。祝好,Sai。”
这在代码上更强:写代码、运行、捕获错误、反馈给模型、模型修复。
适用场景:结构化输出、长文写作、代码、流程步骤。
模式 2:Tool Use(工具使用)
给 LLM 一个可调用函数菜单。
模型决定什么时候调用、调用哪个工具。
网络搜索、数据库查询、代码执行、日历、邮件、API 调用。
LLM 单独做不了这些事。工具是 agent 与世界交互的方式。
模式 3:Planning(规划)
不要用固定流水线,而是让 agent 决定步骤。
给它工具箱,提示它制定计划,然后一步步执行。
零售例子:“100 美元以下的圆形太阳镜有吗?”agent 规划:搜索描述 → 查库存 → 按价格过滤 → 回答。
你没有写死这些步骤,是 agent 自己选的。
模式 4:Multi-Agent Collaboration(多 agent 协作)
把复杂工作拆给专门化 agent。
研究员 → 设计师 → 写作者。
每个 agent 都擅长自己的具体工作。输出会更好,因为没有单个 agent 试图包办一切。
10. 多智能体系统 设计
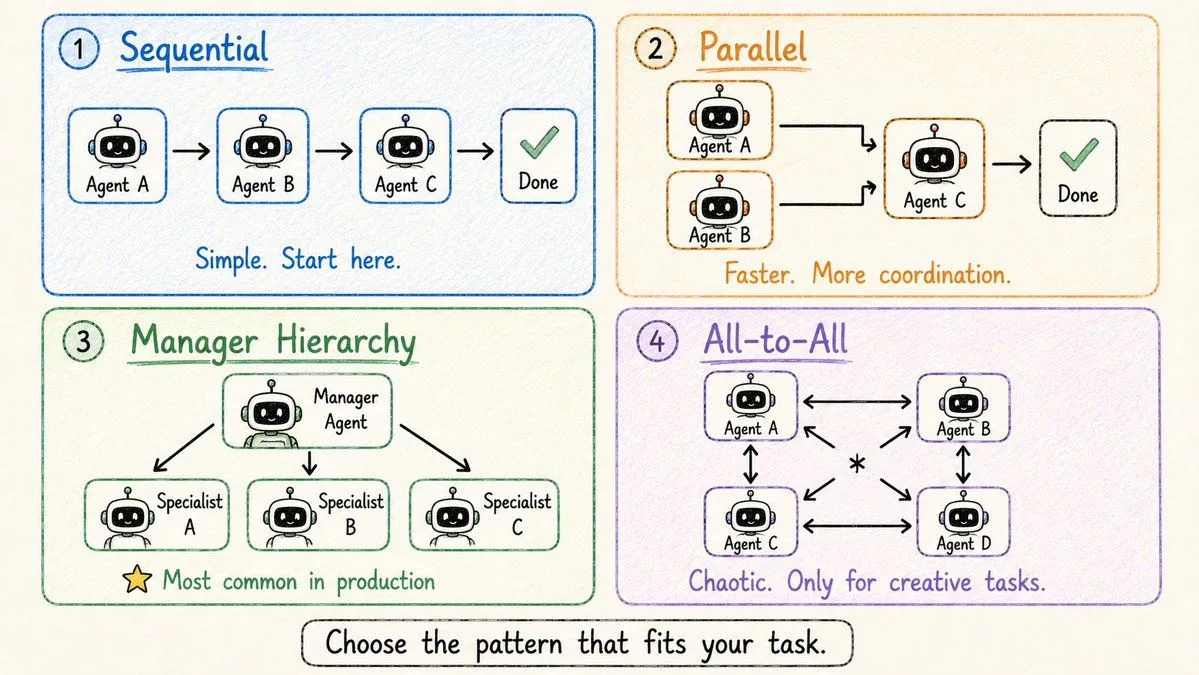
你到底该怎样组织一个 multi-agent system?
四种协调模式,从最简单到最复杂。
模式 1:Sequential(顺序执行)
每个 agent 完成后,把输出交给下一个 agent。像流水线。研究员 → 设计师 → 写作者 → 完成。容易调试,可预测。从这里开始。
模式 2:Parallel(并行执行)
同时运行彼此独立的 agent。研究员和设计师同时工作,写作者合并他们的输出。更快,但协调复杂度更高。
模式 3:Manager Hierarchy(管理者层级)
一个 manager agent 协调专家 agent。manager 规划、委派、审阅。专家 agent 向 manager 汇报,不彼此汇报。这是今天真实生产系统里最常见的模式。
模式 4:All-to-All(全连接)
任何 agent 都可以给任何其他 agent 发消息。混乱,难预测。只适合创意类或低风险工作,也就是允许变化的场景。不要在生产里用。
经验法则:从顺序模式开始。只有确实需要时,再增加复杂度。
第三部分:生产,从原型到真正上线靠什么
11. 进阶任务拆解
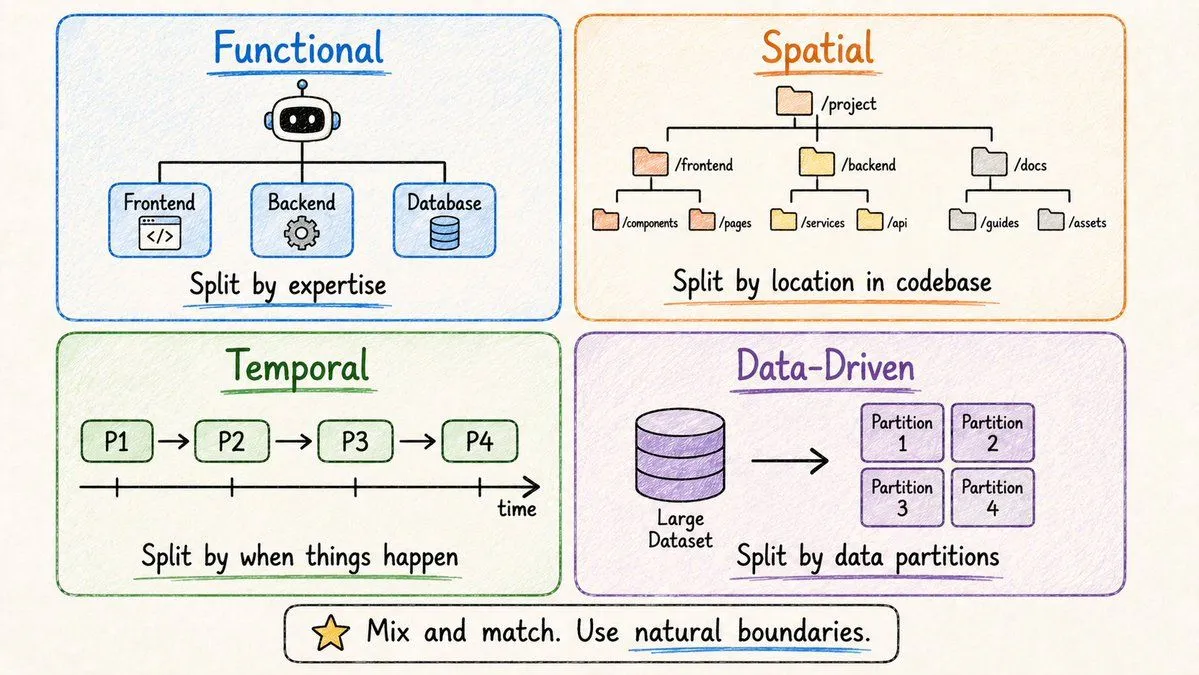
在复杂 multi-agent system 中,分解方式非常重要。
4 种模式:
按功能拆分:按技术领域拆分。前端 agent、后端 agent、数据库 agent。工程团队的经典做法。
按空间拆分:按文件或目录结构拆分。Agent 1 处理 /services/users/*,Agent 2 处理 /services/orders/*。适合大型代码库,能减少冲突。
按时间拆分:按顺序阶段拆分。阶段 1:研究。阶段 2:计划。阶段 3:构建。阶段 4:上线。每个阶段结束后再进入下一阶段。
按数据驱动拆分:按数据分区拆分。Agent 1 处理第 1 周日志,Agent 2 处理第 2 周日志,依此类推。适合大型数据集,可以并行分析。
这些方式可以混合。
主结构用功能拆分,每个 agent 内部再用时间拆分。
选择最匹配任务自然边界的拆法。
12. 提升生产环境质量
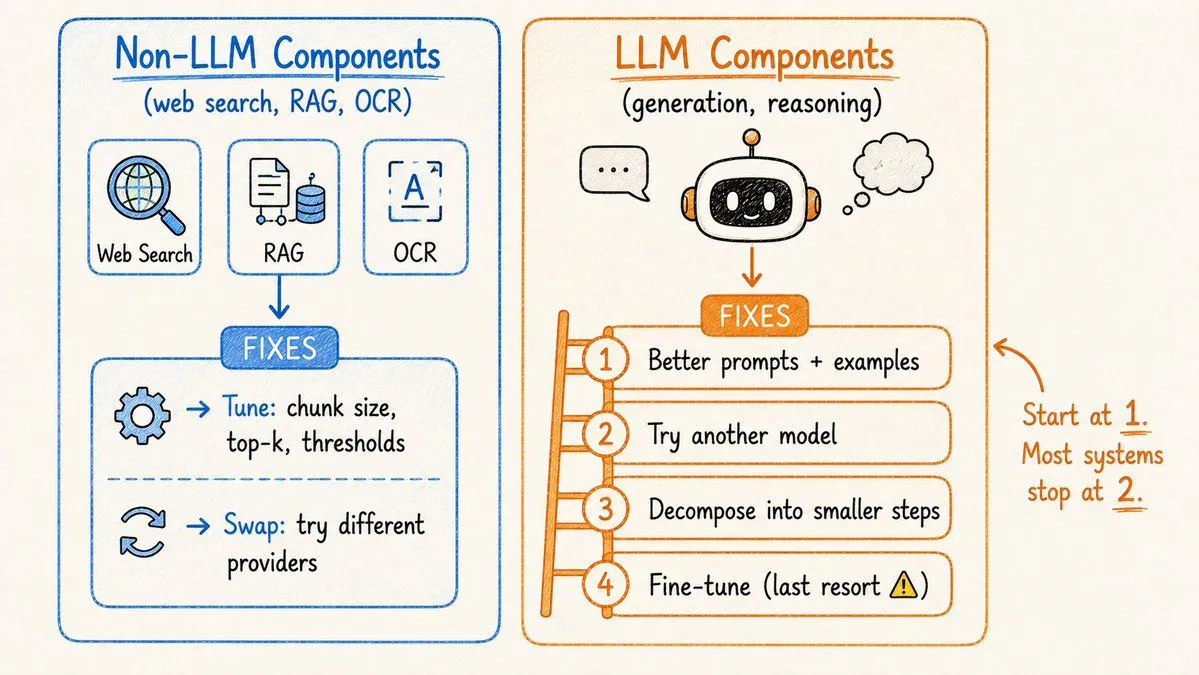
系统能跑了,但质量还不够。
两类组件,对应两种修复策略。
非 LLM 组件(网络搜索、RAG、OCR、代码执行):
→ 调参数:搜索日期范围、top-k 结果数、chunk size、similarity threshold→ 换 provider:尝试不同搜索 API、视觉模型、解析器
LLM 组件(生成、推理、抽取):
→ 改 prompt:增加约束、示例、output schema→ 换模型:有些模型更擅长代码,有些更擅长遵循指令→ 把困难任务拆得更小→ fine-tune(只作为最后手段,成本高,留给最后几个百分点)
顺序很重要。
先修 prompt。再试不同模型。继续拆任务。最后才 fine-tune。
大多数团队到第 2 步就能达到足够好的质量。
13. 延迟与成本
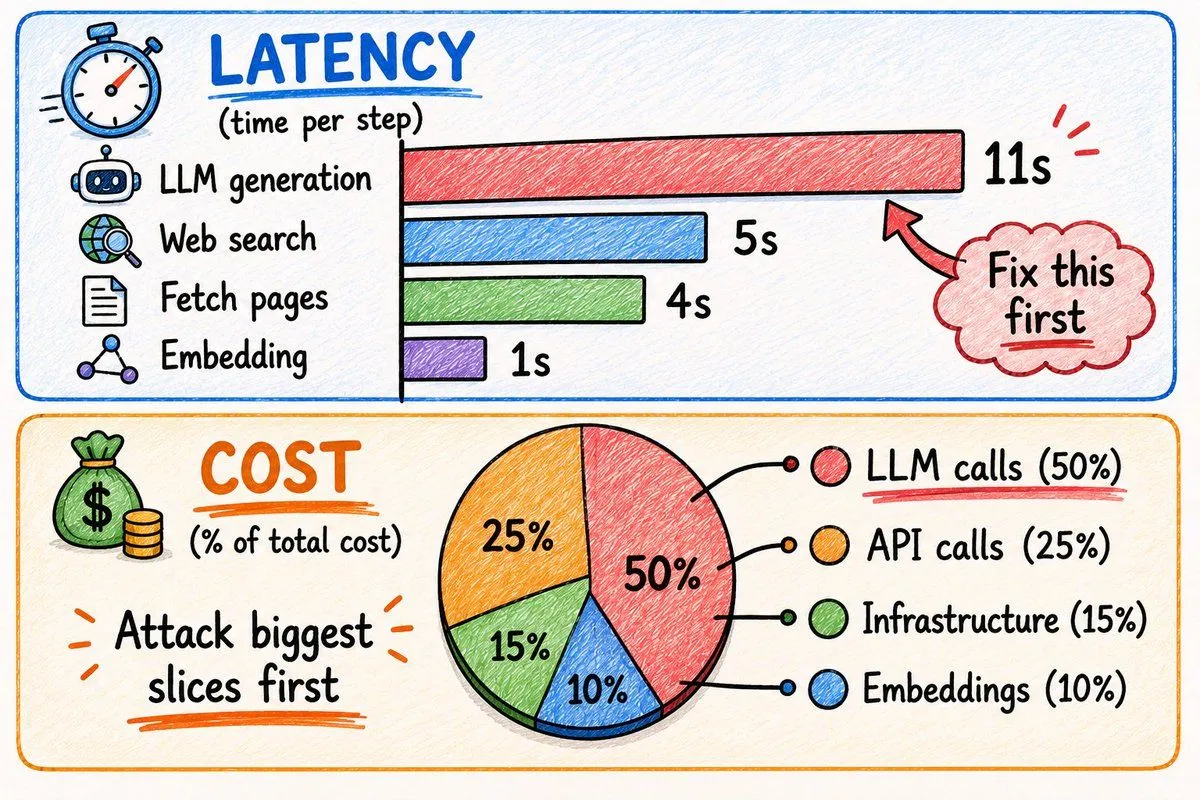
先保证质量,再处理速度和成本。
降低延迟:
- 测量每一步,找到真正瓶颈。
- 凡是不依赖其他步骤的,都并行化。
- 选择合适大小的模型:简单步骤用快而便宜的 LLM,推理步骤用大模型。
- 尝试更快 provider:token streaming 速度差异很大。
- 裁剪 context:prompt 更短,decode 更快。
降低成本:
一个典型 research agent 运行的真实成本拆分:
→ LLM 生成调用:约 0.04 美元→ 网络搜索 API 调用:约 0.02 美元→ Embedding 调用:约 0.005 美元→ 基础设施:约 0.015 美元→ 每次总成本:约 0.08 美元
每天 1000 次运行 = 每天 80 美元 = 每月 2400 美元。
怎么砍成本:
→ 先打最大的成本桶→ 给模型分层:简单任务用便宜模型,困难任务用贵模型→ 激进缓存结果(搜索结果、embeddings、摘要)→ 限制输出(“Return JSON. 5 fields max.”)→ 尽可能批量处理操作
14. 可观测性:规模化观察你的 Agents
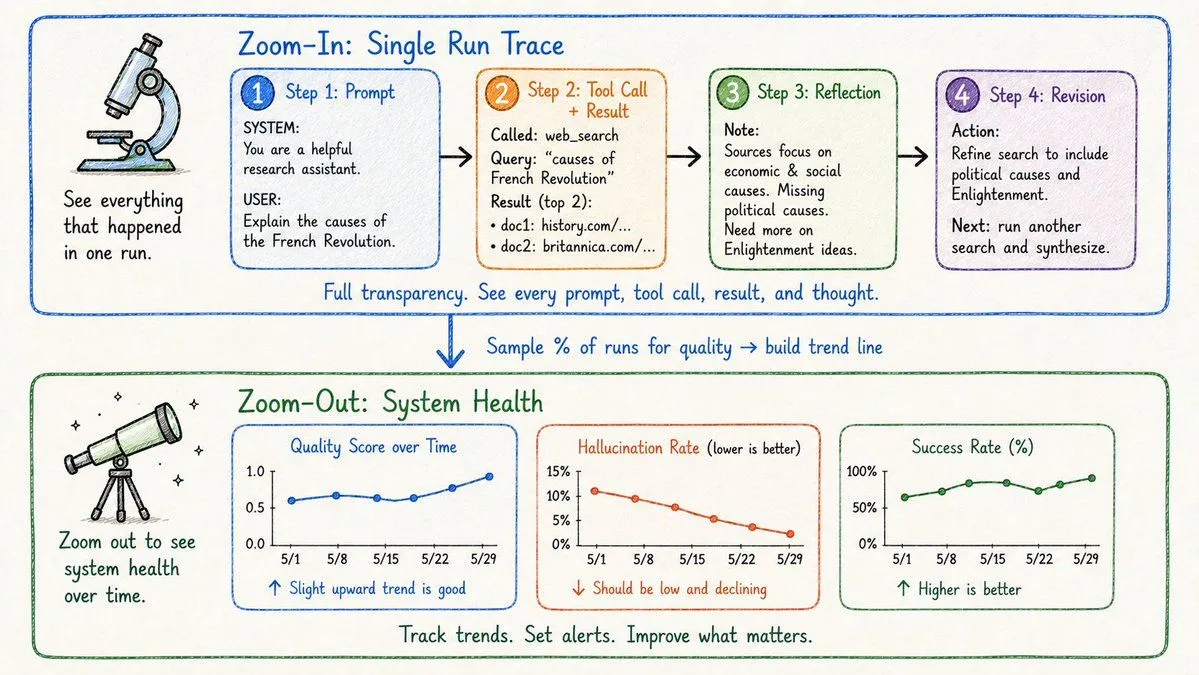
传统软件:追踪执行路径。A 调 B,B 调 DB,返回结果。
AI agent 不是这样工作的。
它们是非确定性的。同样输入可能产生不同输出。执行是分布式的。外部依赖可能失败。
你需要两种可见性:
单次运行视角指标(用于调试)
→ 完整 trace:每个 prompt、每次工具调用、每个用掉的 token→ agent 为什么选择这个工具?→ 每一步返回了什么?→ 它到底在哪里失败?
不仅要记录发生了什么,还要记录为什么:
“agent 选择网络搜索而不是 RAG,因为 query 包含近期信息”“reflection 识别出 3 个问题:缺引用、日期模糊、语气错误”
整体健康视角指标(大量运行下的系统健康度)
→ 质量分数随时间变化→ 幻觉率→ 成功率→ 改动是在变好还是变差?
你不可能在规模化后手工检查每条 trace。
使用质量抽样:评估一定比例的运行,建立趋势线。
这能让你在用户发现前抓到退化。
15. 安全:没人想聊但必须聊的部分
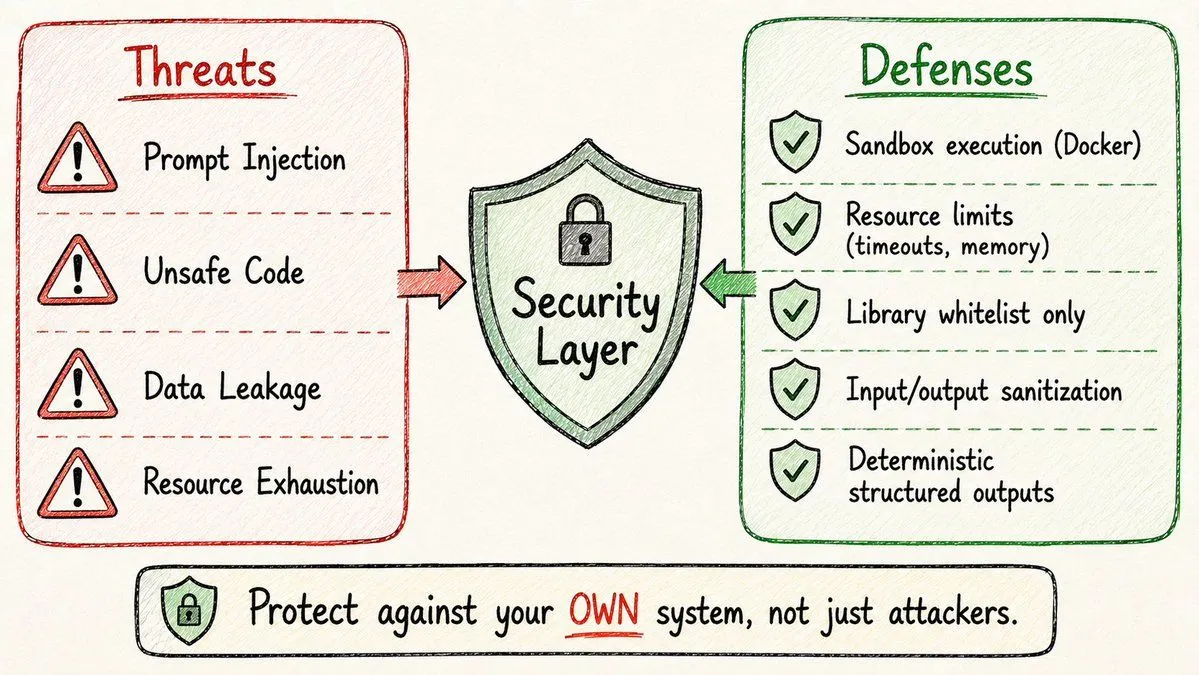
AI agent 的安全不像传统应用安全。
你防的不只是外部攻击者。
你还要防自己的系统做出危险决策。
威胁包括:
→ Prompt injection:用户输入中的恶意内容劫持 agent 指令→ Unsafe code generation:agent 写出访问敏感数据或造成伤害的代码→ Data leakage:PII 或专有信息通过输出或 tool call 暴露→ Resource exhaustion:agent 无限循环,或烧掉昂贵 API call
代码执行是风险最高的功能。
如果你启用它,安全做法是:
→ 在 Docker 里 sandbox,容器每次运行后销毁→ 设置硬资源限制:timeout、memory cap、CPU limit→ 只允许使用特定安全库→ 所有输入进入 agent 前都先验证→ 扫描所有输出里的敏感数据(API keys、PII)→ 使用确定性 I/O:代码返回结构化 JSON,不把自由文本直接发给用户
多数团队会用痛苦方式学会这些。
上线前先读这一段。
完整课程到这里。
回顾
入门:
→ agent 通过迭代工作:计划、行动、观察、重复→ 最适合复杂多步骤任务,并能接受约 90% 准确率→ 从半自主开始,不要从完全自主开始→ context engineering 才是真正的智能→ task decomposition 是最重要的技能
中级:
→ 从第一天就做评估,复杂任务用 LLM-as-judge→ Memory(动态)≠ Knowledge(静态)→ 三类 guardrails:code → LLM judge → human→ 4 个总能帮上忙的模式:reflection、tool use、planning、multi-agent→ 从顺序模式开始,只在需要时增加协调复杂度
生产:
→ 4 种拆解模式:功能拆分、空间拆分、时间拆分、数据驱动拆分→ fine-tuning 之前先修 prompt→ 逐步测量延迟和成本,再处理最大的成本桶→ 两种可观测性模式:单次 trace + 整体健康指标→ 安全 = 防自己的系统,而不只是防攻击者
大多数人会开始构建 agent。
很少有人能交付在规模下可靠工作的 agent。
这篇文章讲的就是中间的差距。
如果这篇有用:
→ 转发分享→ 关注 @sairahul1,看更多这样的拆解→ 收藏下来,构建时你会反复查
我写 AI 系统、产品构建,以及那些能在你睡觉时继续运转的自动化。
📎 原文信息
原帖链接:https://x.com/sairahul1/status/2058464422306443766
