
适配任何领域知识库,手把手教程。
你好,这是大刘的第 74 篇原创干货~
我一直觉得,装好 WorkBuddy 之后的第一件事,就该是拿它把自己的知识库搭起来。
今天这篇,我就用最简单,最容易理解的方法,教大家用 WorkBuddy + Obsidian 搭一个自己会更新的个人知识库(LLM Wiki)。
当然,如果你是 Claude、Codex 或者任何其他 Agent,逻辑和操作都是一样。
今天我们目标有两个,1。搭个人会自动更新的知识库;2.更重要的是理解在过程中整体的思路和方法。
所以,跟着操作下来,你可以更好理解 WorkBuddy 和其他软件联动的方法和逻辑。
整套流程走下来,算上大模型跑的时间,也就 15 分钟。
但是它能做到:
写方案之前说一句,它把库里相关的观点、案例、数据拢成一份提纲。
两版材料哪儿对不上,它列出来,你拍板。
「新人上手最容易卡在哪几步」这种得翻好几篇才答得上的问题,问一次就有,答案还带依据。
往后新存的资料,它每天自己编好归位,每周自己查一遍错。
接下来我会手把手带你,把这个搭在我自己电脑里的知识库从头跑一遍。核心就四步:存资料、编译、查询、检查。
工作空间:让两个软件共用一个文件夹
首先先把要用的东西备齐,一共三个。
WorkBuddy 本体怎么下载、怎么登录、界面里都有啥,我上一篇《从 0 到用明白,手把手带你上手腾讯 WorkBuddy》已经写过了。这篇默认你装好了。
顺带说一句,新用户注册送 2100 积分,跑这套流程是够的。
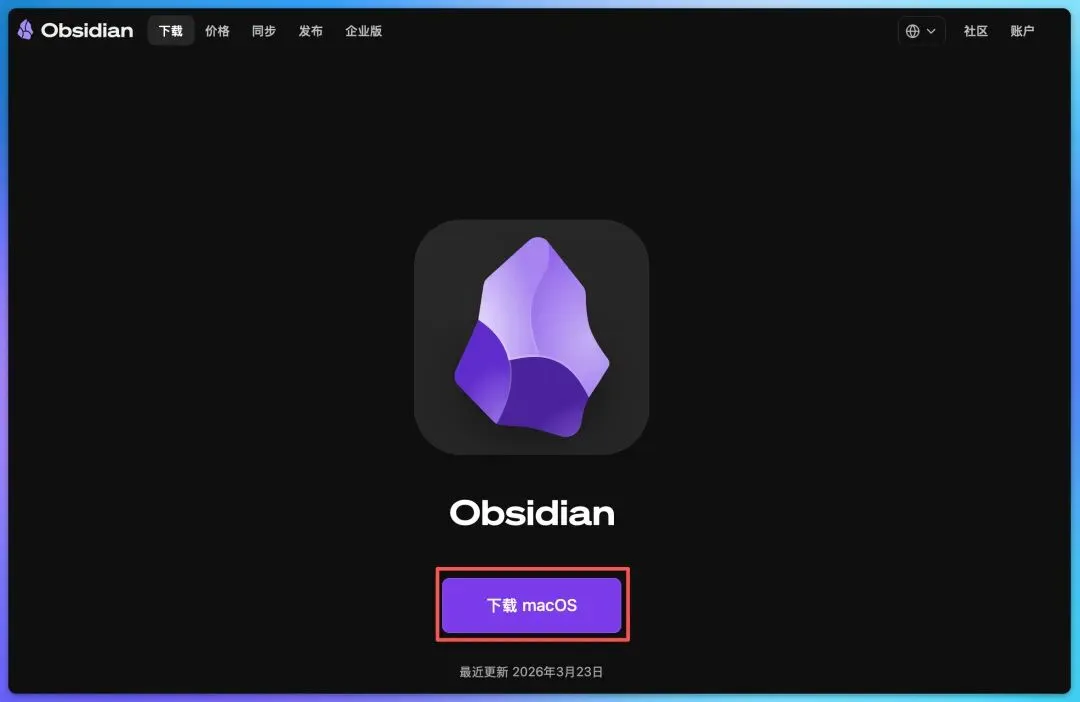
Obsidian 去官网 obsidian.md 下载,免费。
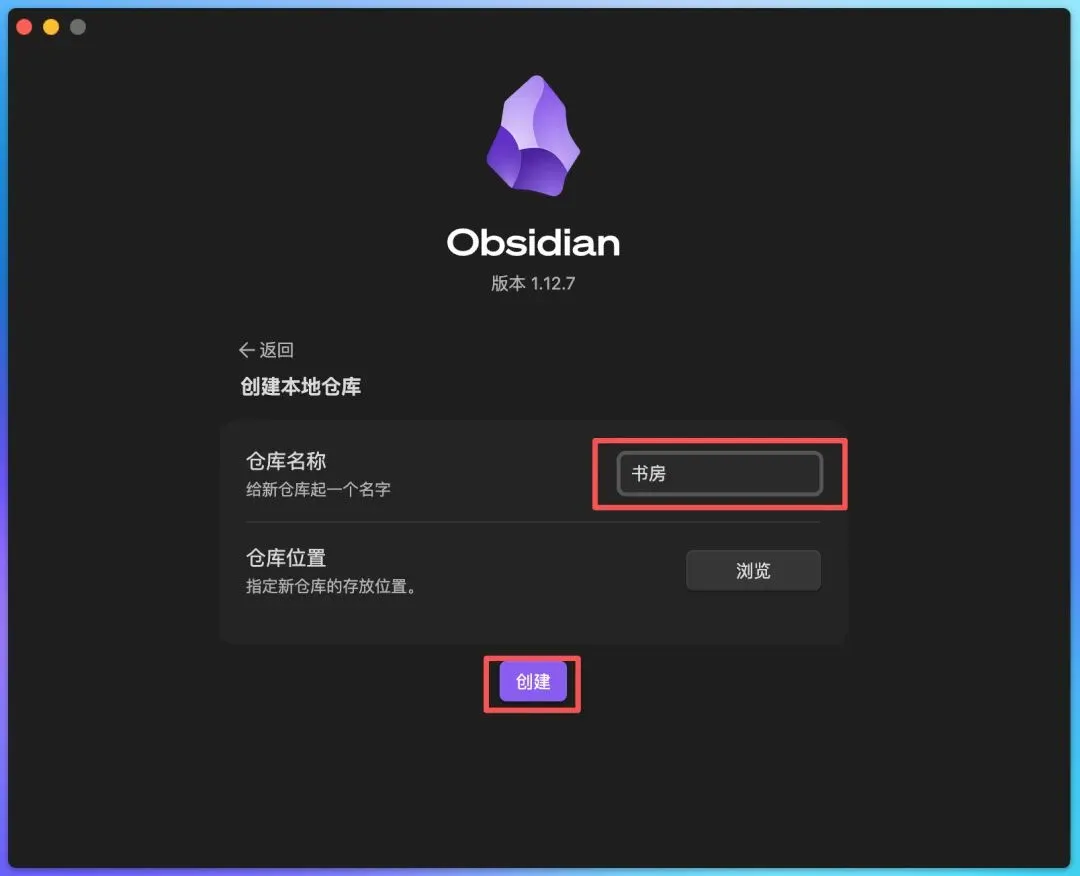
装好之后新建一个仓库。它管仓库叫 vault,你就理解成一个专门放知识库的文件夹。
名字随便起,中文也行,我起的叫「书房」。
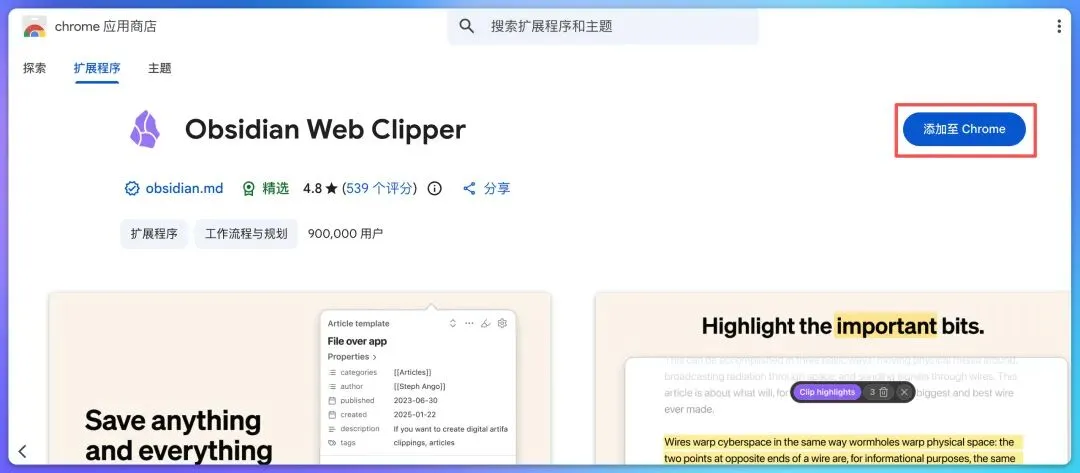
除了上面两个软件,还需要再装一个官方免费浏览器插件,Obsidian Web Clipper。
Chrome 扩展商店里搜就有。待会儿把网上的文章收进库里,全靠它。
然后是最关键的一步,也是全文唯一一个不能出错的操作:
打开 WorkBuddy,新建会话,把工作空间指向你刚建的「书房」文件夹。
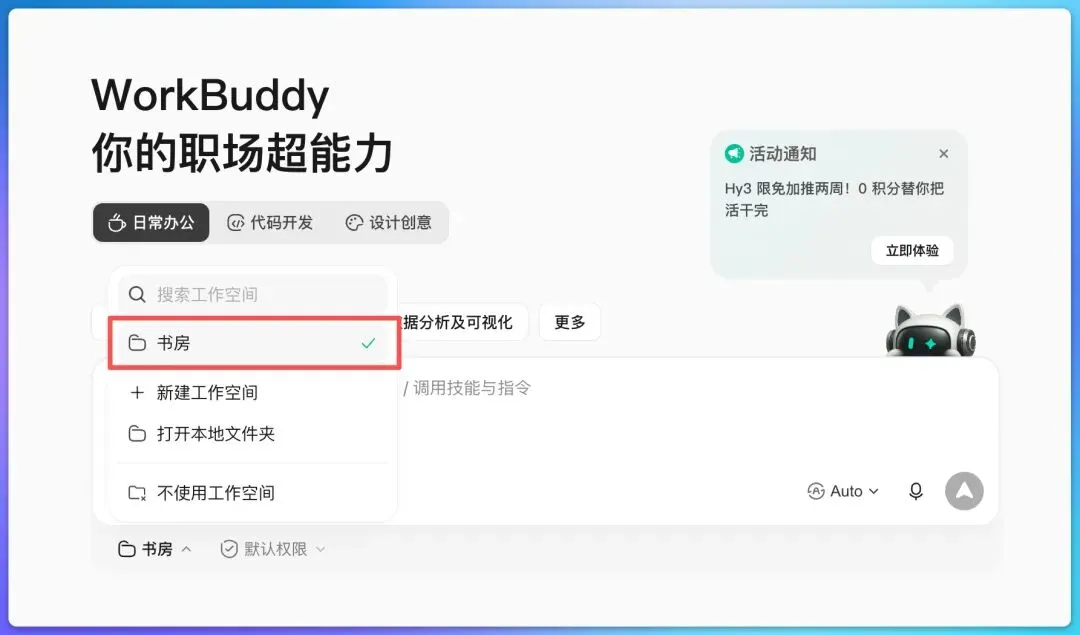
这一下步很重要。通过同一个文件控制两个软件的工作区。
两个软件读写的就是同一个文件夹了,往后 WorkBuddy 在里面写的每一个文件,你在 Obsidian 里实时都能看到,一个写,一个看。
这套组合我很喜欢的一点是,俩软件之间其实没有任何绑定,全靠同一个文件夹接上头,
哪天你想把其中一个换掉,比如换成 Claude Code 或者别的什么 Agent,另一个照常用,资料也一直都在。
接着让它把目录建了。你都不用自己动手,直接在会话里说:
在当前文件夹里帮我把知识库的架子搭起来:建 raw、wiki 两个文件夹,
wiki 下面再分 concepts、entities、sources 三个子文件夹,
根目录建三个空文件:AGENTS.md、index.md、log.md。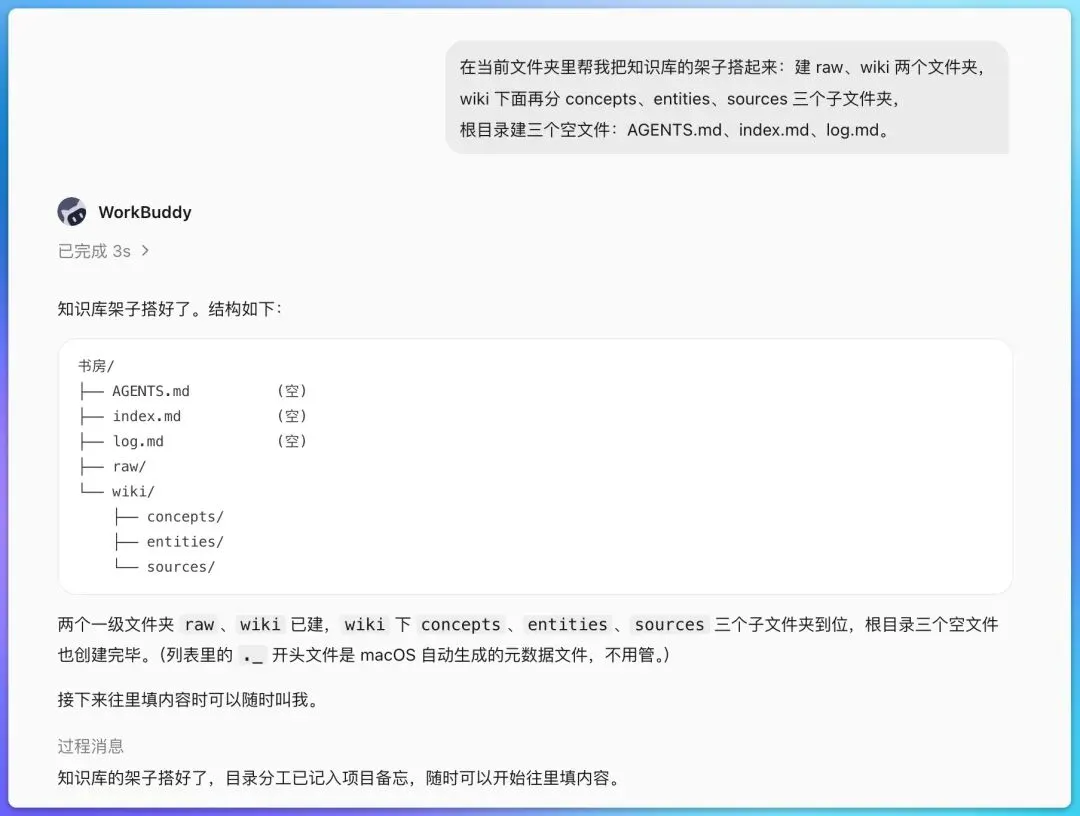
建完长这样:
书房/
├── AGENTS.md ← 给 AI 立的规矩,整个库怎么转全看它
├── index.md ← 全库目录,AI 自己维护
├── log.md ← 干活日志,AI 自己记
├── raw/ ← 原始资料,你只管往里放
└── wiki/ ← AI 写的知识页都归这儿
    ├── concepts/ 概念页
    ├── entities/ 工具页、人物页
    └── sources/ 每篇资料的摘要页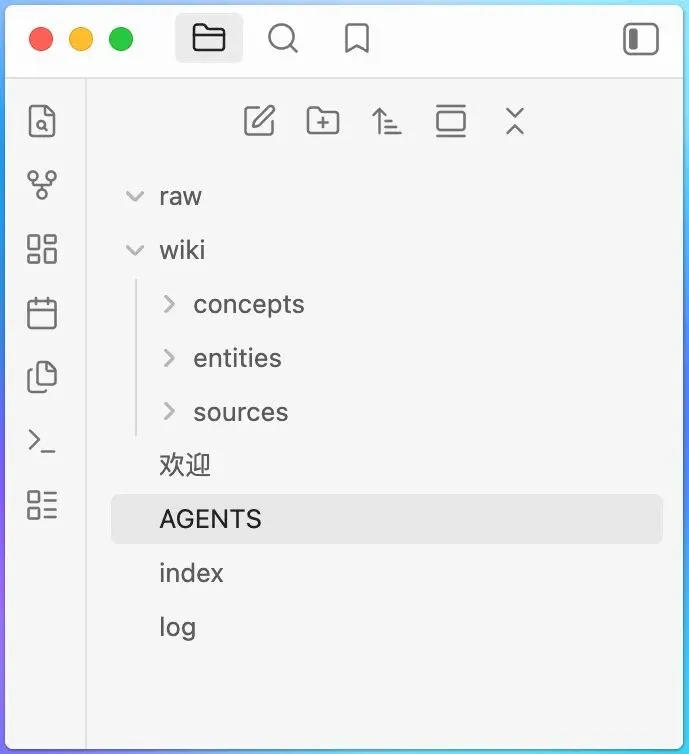
你也可以顺手在访达里打开这个文件夹看一眼。一模一样。
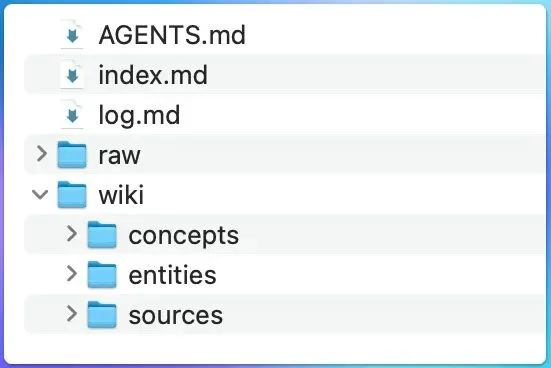
对了,要是你担心数据安全,其实刚才那一眼就是答案:
这个知识库说到底就是你硬盘上一个普通文件夹,几个子目录加几个文本文件,不经过任何人的服务器,哪天你把两个软件都卸了,这堆东西还在原地,换台电脑,整个文件夹拷走接着用。
所以,即使是企业场景,数据也完全安全。
接下来是最重要的一份文件,AGENTS.md。
写它之前,先交代一下来路。
这套玩法叫 LLM Wiki,是 OpenAI 创始成员 Karpathy 今年 4 月提出来的。
他解决的问题就一个。
你平时用的那些“上传文件问 AI”,都是你问一次,它现场去资料堆里扒拉几段沾边的凑个回答,答完就扔,下回再问,再从零读一遍。
Karpathy 把这事倒了过来:别等提问了再理解,提前让 AI 把每份资料读透,整理成一页一页互相链接的知识页面,新资料进来就往上补。
所有的理解都村下来了,你每次提问,它都站在之前全部整理的基础上答你。
我们刚建的那堆文件夹就是照这个思路分的三层:
1. raw/ 放原始资料,AI 只许读不许改
2. wiki/ 放它整理出来的知识页
3. AGENTS.md 写清整理的规矩。
Karpathy 在构想文件里有句原话,我特别喜欢:
Obsidian is the IDE; the LLM is the programmer; the wiki is the codebase.
简而言之就是:Obsidian 是工作台,AI 是程序员,wiki 是他写出来的东西。
AI 干活靠谱不靠谱,基本上就是看负责规范的 AGENTS.md 写得清楚不清楚。
我的这个自用优化的版本可以直接整段复制,之后再按自己的情况慢慢改:
# 这个知识库怎么运转(AGENTS.md)

## 你是谁
你是这个知识库的图书管理员。你的活儿是把 raw/ 里的原始资料,
整理成 wiki/ 里一页一页互相链接的知识页面。全程用中文。

## 地盘规矩
- raw/:只许读,不许改。这里是原始资料,是事实的源头。
- wiki/:你的工作区。概念放 concepts/,工具和人物放 entities/,
  每篇原始资料的摘要放 sources/。
- index.md:全库目录。每次新增或改动页面,都要同步更新它。
- log.md:干活日志。每次编译完,记一笔今天动了什么。

## 编译的规矩
1. 只处理 raw/ 里新增或变过的文件,别把整个库重编一遍。
2. 动手前先查:这份新资料讲的东西,wiki 里有没有现成的页面?
   有就更新那一页,没有再开新页,开新页之前先查重。
3. 两份资料要是说法掐架,谁也别覆盖谁。新旧两说并排放着,
   各自注明出处和日期,再添一行提醒:这里有分歧,等我来裁。
4. 每一页开头用一两句话说清这页讲什么,正文里用 [[双链]] 连到
   相关页面,页尾列出内容来自 raw/ 里的哪几份资料。

## 回答问题的规矩
先翻 index.md 这份目录,圈出跟问题沾边的那几页,只读这几页就够,
不许把整个 wiki 从头到尾翻一遍。回答时说清依据来自哪一页。

## 红线
拿不准的先来问我,别自作主张。资料里没有的东西,不许写进 wiki。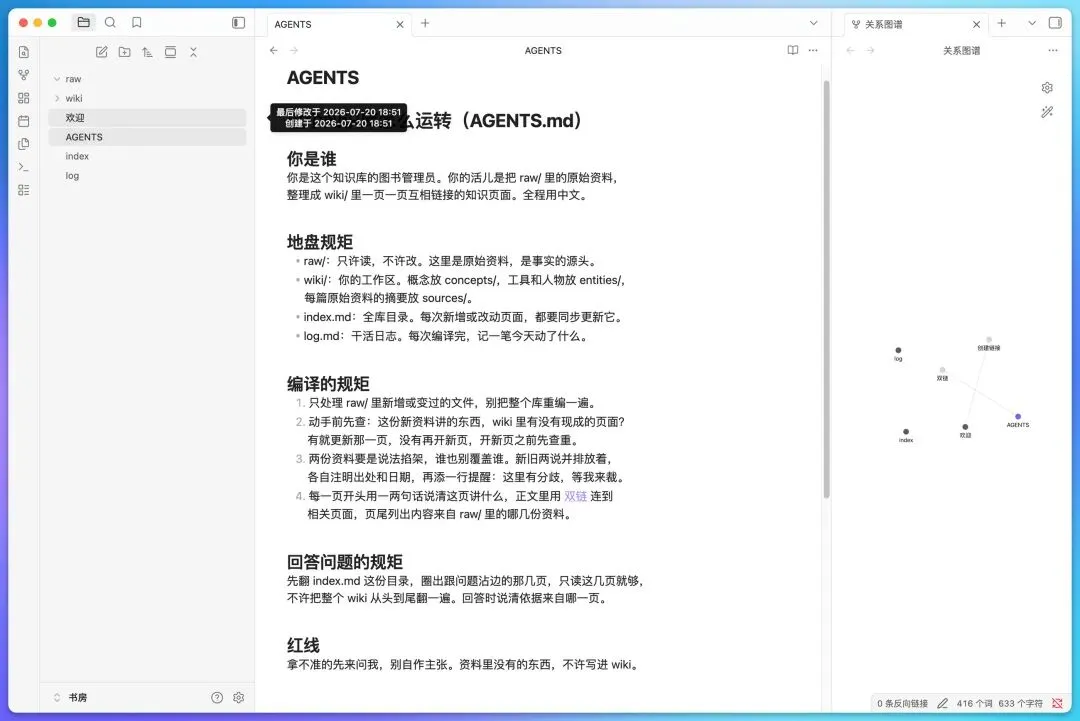
这个 Agents.md 的核心价值就是,未来所有 AI 的操作都要遵循这些规矩。
所以,强烈建议你阅读并理解它。
这里解释一个内容:
里面那个带方括号的 [[双链]],其实就是页面之间互相跳转的链接。编译的时候 AI 自己会打,你认得出它是个链接就行。
待会儿关系图谱里那一根根线,画的就是它。
你甚至可以把上面这段直接发给 WorkBuddy,让它替你写进根目录的 AGENTS.md,连新建文件都省了。
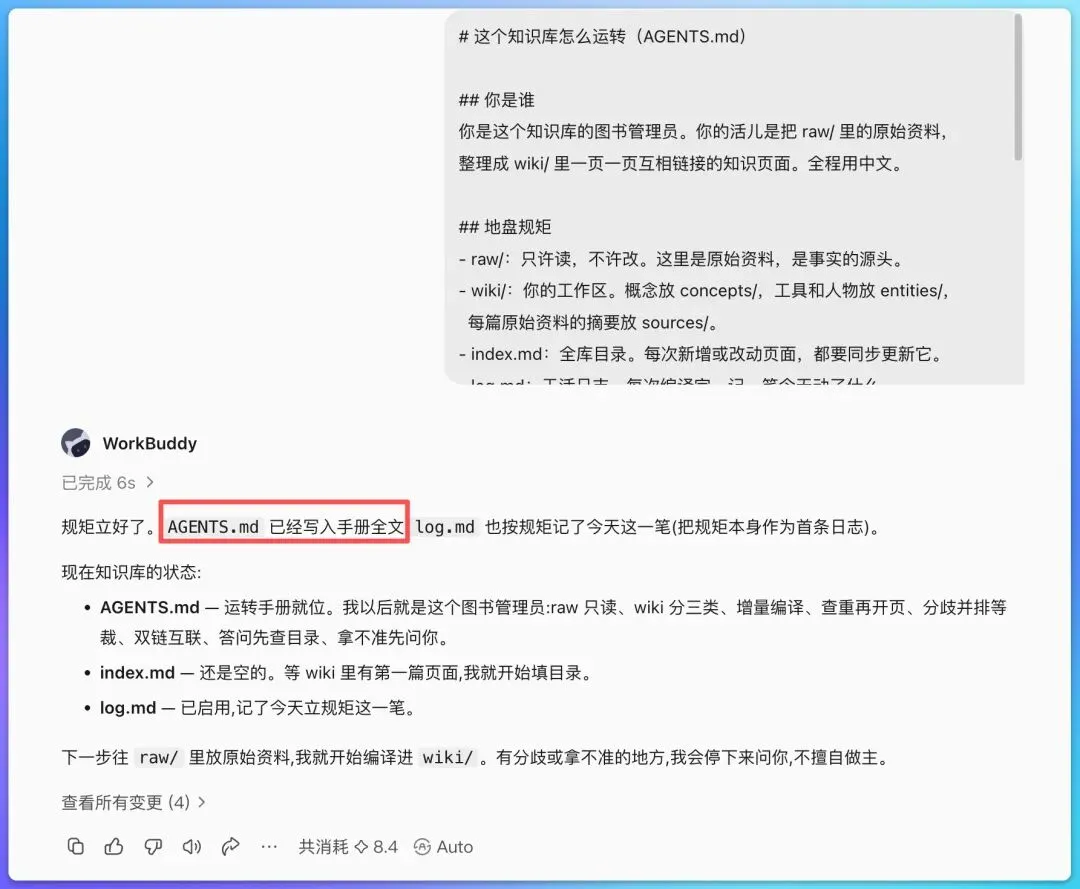
到这,准备工作完成。正式开跑。
第一步:存资料
往知识库库里存资料只有两条路:网上的文章用 Web Clipper 剪,手里的文件直接拖进去。
先说剪藏。看到好文章,浏览器右上角点一下插件,弹窗里会显示它抓到的标题、来源链接和保存路径。确认没问题,点「添加到 Obsidian」。
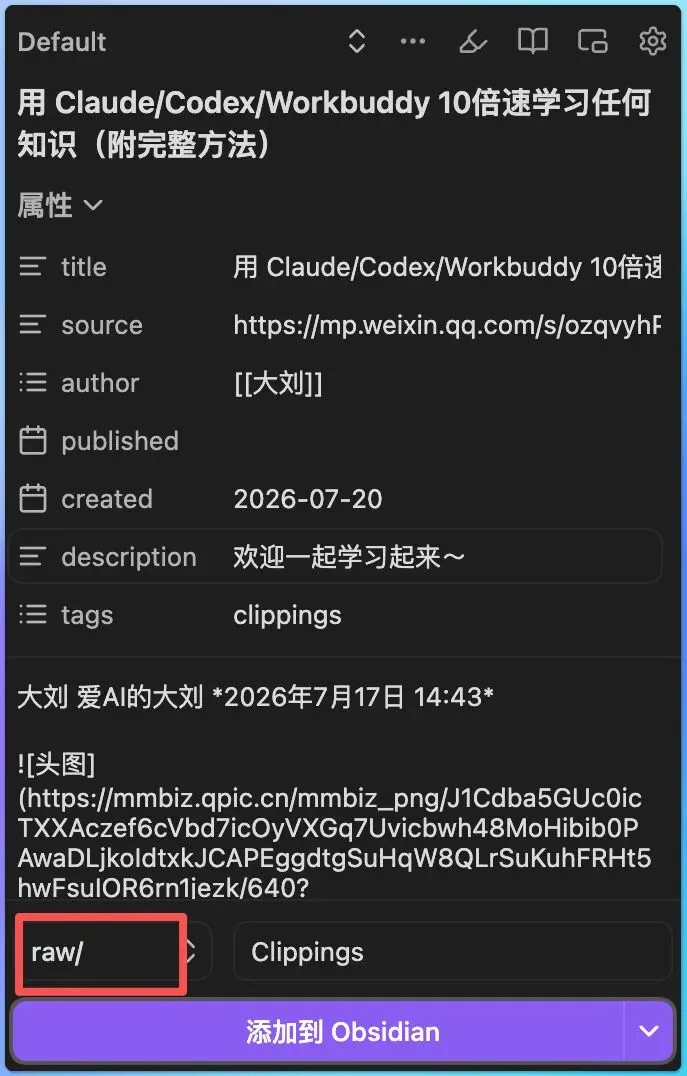
整篇正文就落成一份干净的 Markdown 笔记(一种纯文本的笔记格式,记事本都能打开)。
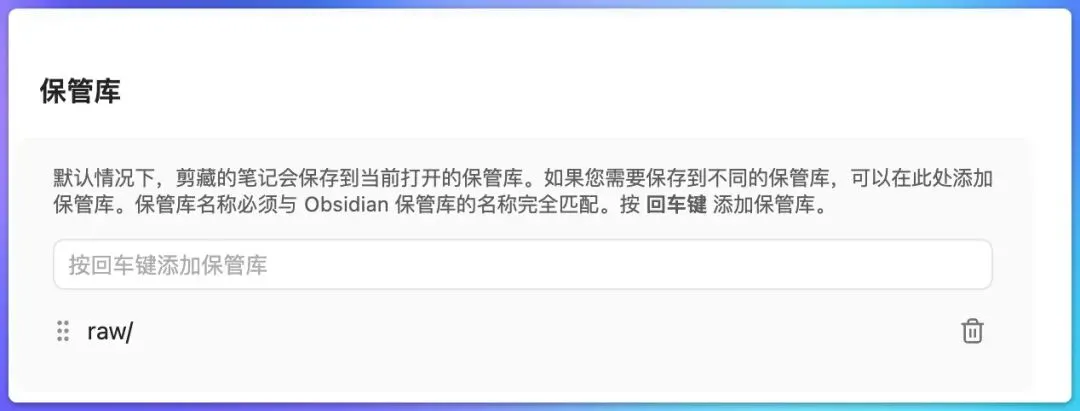
这里有个坑注意一下:设置里那个「保管库」栏,填的是 Obsidian 仓库的名字,也就是「书房」,插件说明里明明白白写着「名称必须与 Obsidian 保管库的名称完全匹配」。而 raw/ 是文件夹,得填在保存路径那一栏。
我第一次把 raw/ 填进了「保管库」,结果怎么剪都进不去。
公众号文章也一样,在电脑浏览器打开链接照剪。
本地文件更省事,不用剪,直接拖进 raw/ 文件夹。我试了几种:PDF、图片、Markdown,扔进去 Obsidian 里都点得开。
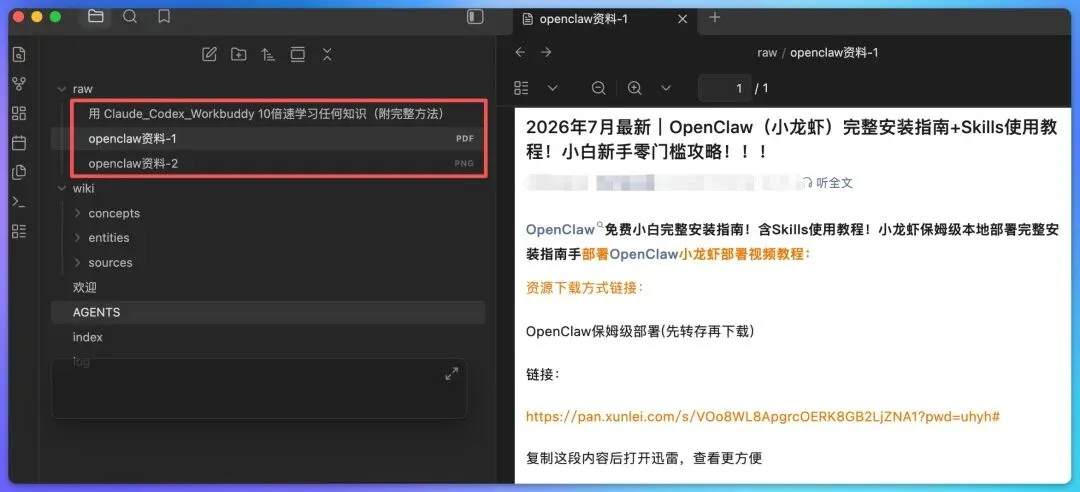
我们第一次使用,可以先弄几个资料就行。
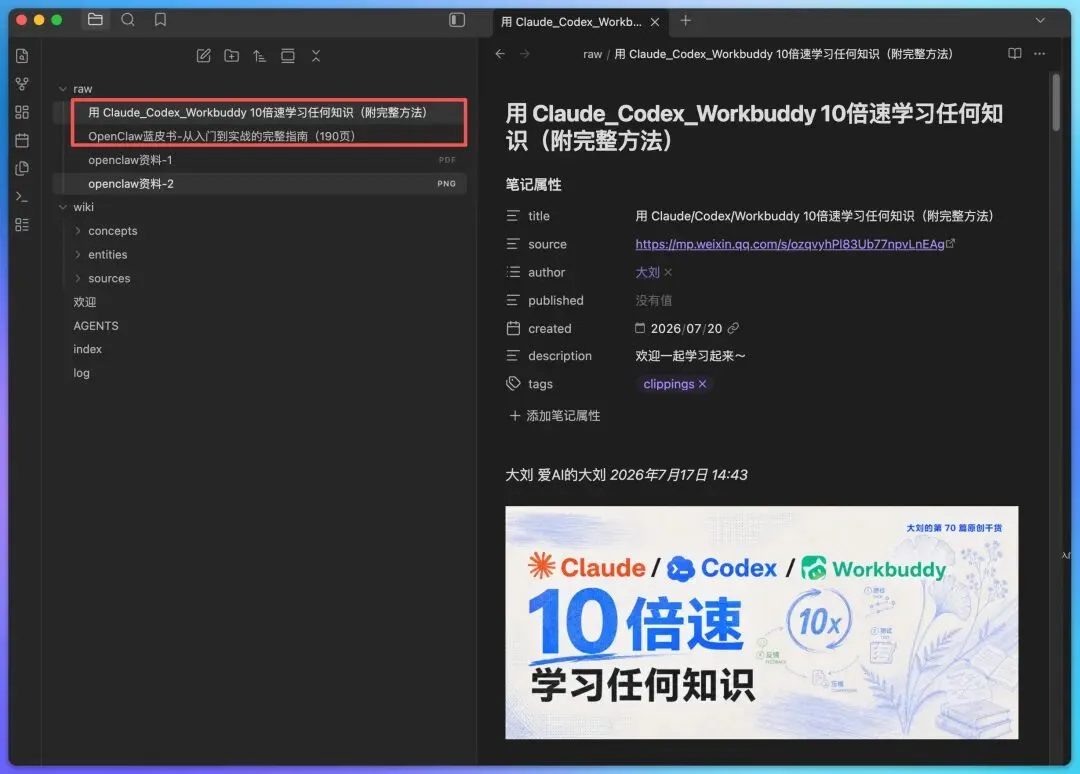
存完对一眼就行。打开 Obsidian 左边的文件树,raw/ 里就是你刚存进去的那一排文件。随便点开一篇,标题正文都齐整,这步就算成了。
第二步:编译
资料存完了,接下来是整套流程里最核心的一步,编译。
这个词其实是程序员的术语,“把人写的代码翻成机器能跑的程序”叫编译,这儿干的是件差不多的事,把我们刚刚放进 raw/ 的原始资料,翻成一套理好了、随时能查的知识页。
做起来就是跟 WorkBuddy 说一句话的事。我发的指令原文在这,直接抄:
AGENTS.md 的规矩你都读过了。去把 raw/ 里新到的那批文章
编进 wiki:该开页开页,该并页并页,收工前把 index.md 和 log.md 也捋顺。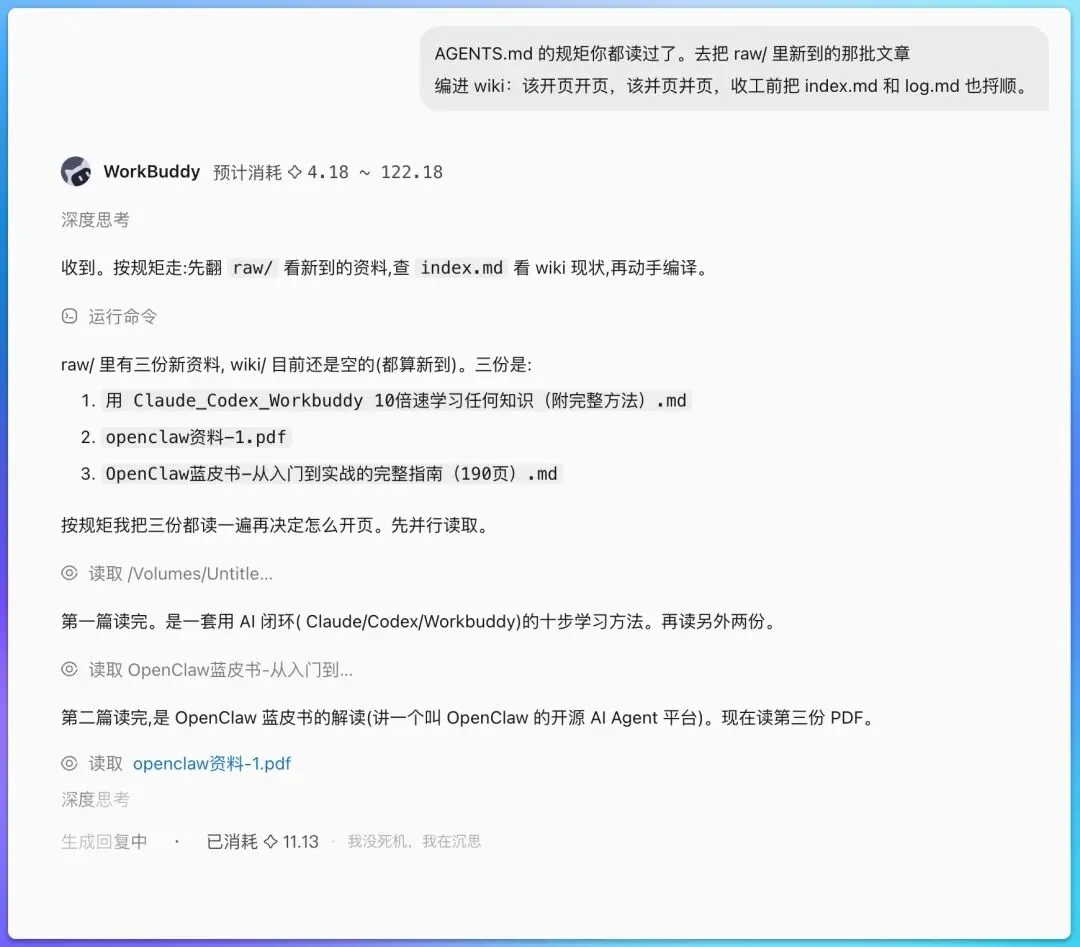
整个过程中,WorkBuddy 自己一篇篇读、一篇篇理解,整理好的结果会直接显示在 Obsidian 里。
概念归了 concepts/,工具和人物归了 entities/,每篇文章的摘要归了 sources/。页跟页之间,它自己打上了 [[双链]]。
新页面也已经一条条登记在 index.md 中了。log.md 里也添上了今天这笔记录。
编译完先别急着问问题,去 Obsidian 里把关系图谱点开看一眼。
它在左边那排小图标里,长得像张小蜘蛛网。
在过程中你会看到这样的,逐步关联生长的过程。
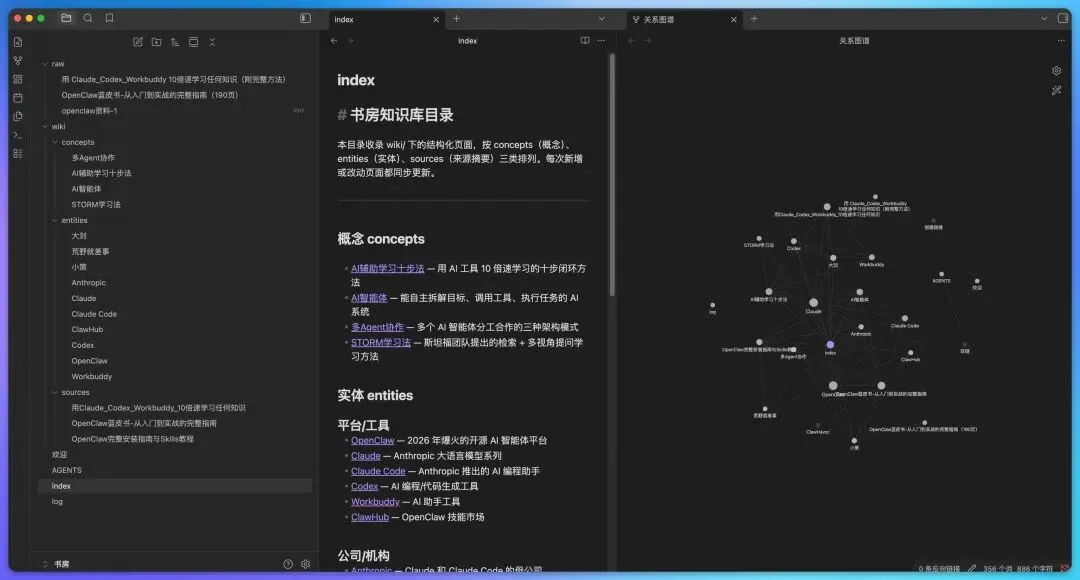
这些线实际上就是 AI 把文章所有内容读了,关联起来了。
这是知识库的“智能”所在。
第三步:查询
到这一步,才轮到爽的部分。
先问个大的。我在 WorkBuddy 里问:
根据 wiki,新手学 Openclaw 最容易卡在哪几步?这里我认为你需要理解下它的逻辑:
它并不是把整个库从头翻到尾。而是先看了眼 index.md,挑出相关的两三页,进去细读。最后给我的回答分了层,末尾还会列出来依据来自哪几页。
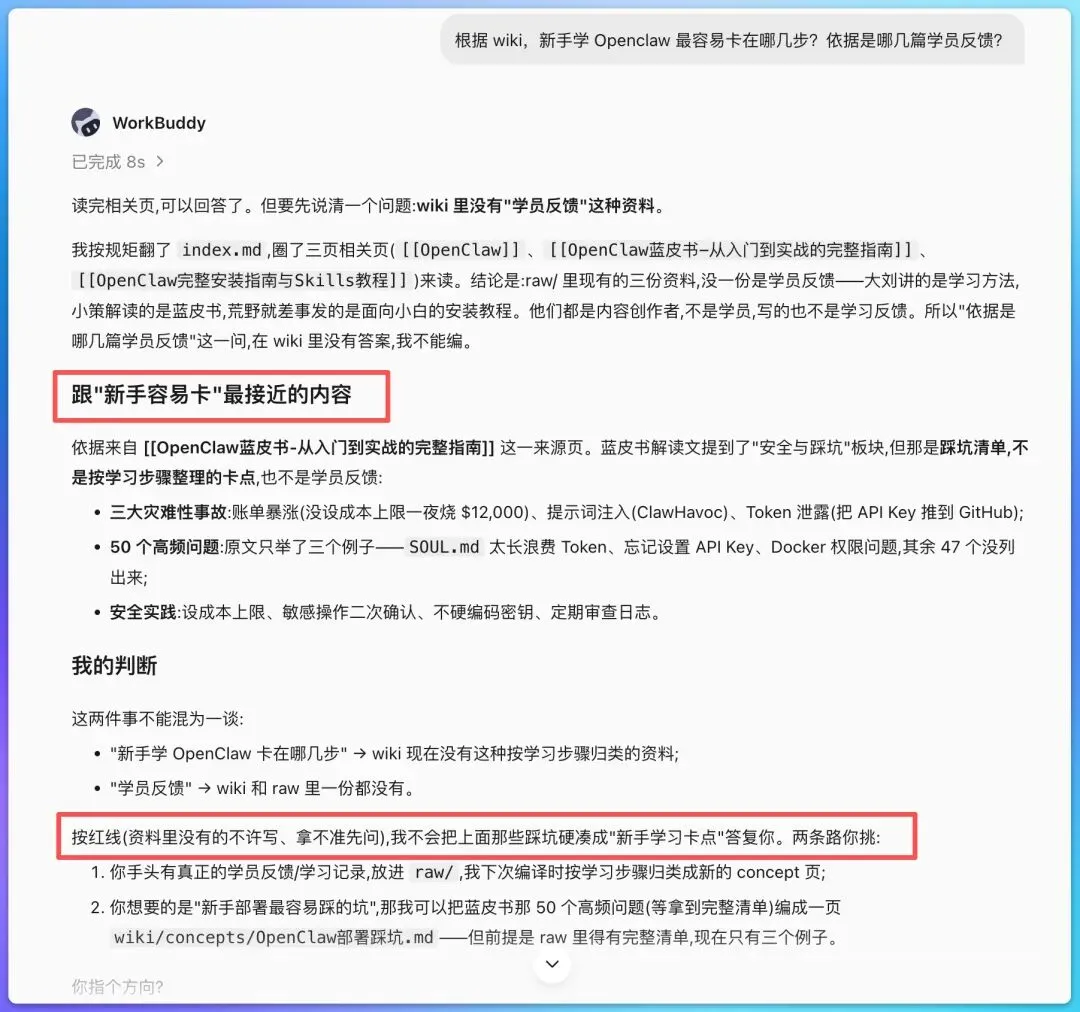
这套“先查目录再翻页”的动作,就是 AGENTS.md 里“回答问题的规矩”那段在起作用。
还有几种问法很常见,我也整理一下。
根据 wiki,X 和 Y 的说法有什么不一样?依据分别是哪几篇?
我印象里存过讲 X 的内容,翻翻是落在哪篇里,把原话给我贴出来。
我要写一篇关于 X 的东西,把 wiki 里相关的观点和案例整理成一份提纲。
每一个你都可以试一试。
第四步:检查
最后一步,很容易忽视,但是非常重要。
知识库用久了都有一个通病就是:有的知识孤零零的谁也不引用,有的链接点过去是空的,还有的,两页说法各执一词,存在冲突。
放着不管,几个月后它就会悄悄退化回一个高级点的收藏夹。
所以我的办法是用 WorkBuddy 的定时任务功能,来给它定个每周体检。
在 WorkBuddy 里说一句:
帮我建个定时任务,每周六晚上九点半跑一次,内容是:
给知识库做一轮体检,重点查三样:哪条双链点过去是空的、
哪一页成了没人引用的知识、哪两页的说法互相对不上。
发现问题先列给我看,我确认了再改,改完记进 log.md。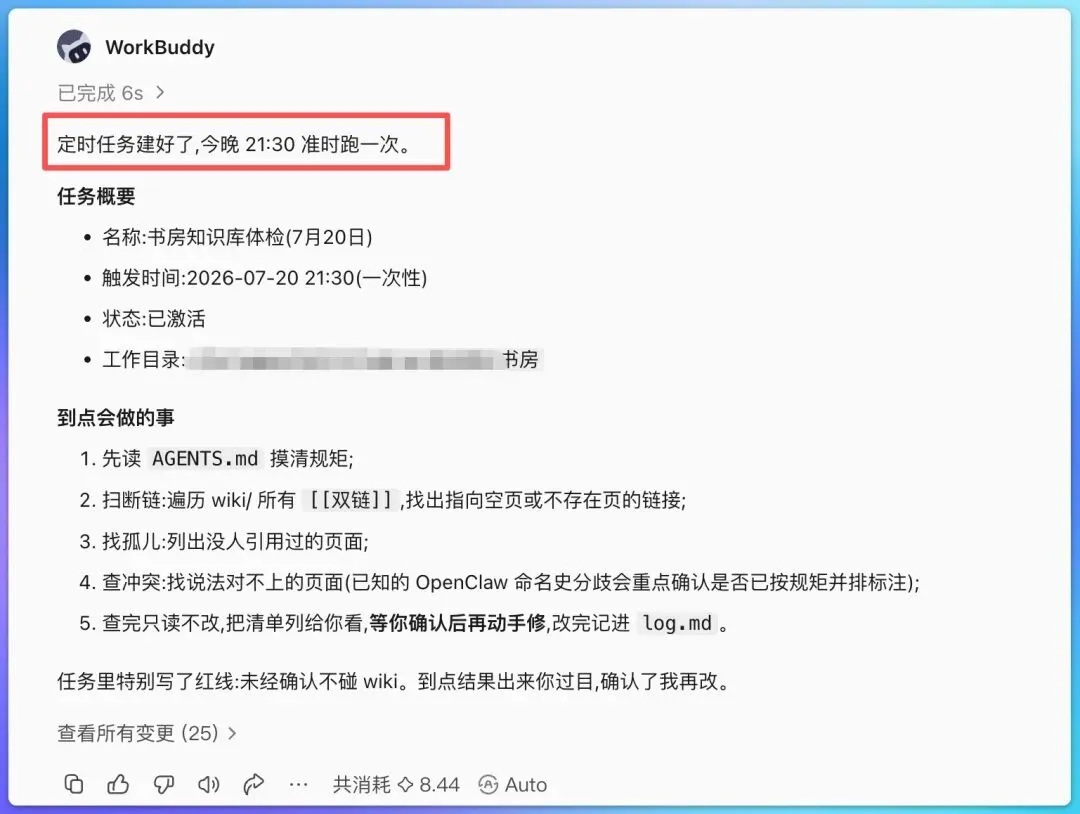
注意我在指令里特意留了一句“先列给我看,我确认了再改”。
平时我们用 AI 做任何的任务,都需要注意冲突的解决。这个判断 AI 替你做不了,也不该替你做,它把问题列出来,剩下的你来定。
你甚至可以再建一个定时任务:每天早上开工前,让它把 raw/ 扫一眼,见着新文件就顺手编译掉。这条也是现成的,搬过去就行:
帮我建个定时任务,每天早上七点半跑一次,内容是:
raw/ 里要是躺着还没编译过的新文件,就按 AGENTS.md 里
定好的章法把它们编进 wiki,index.md 和 log.md 顺手带着更新;
raw/ 里没动静,这天就什么都不用干。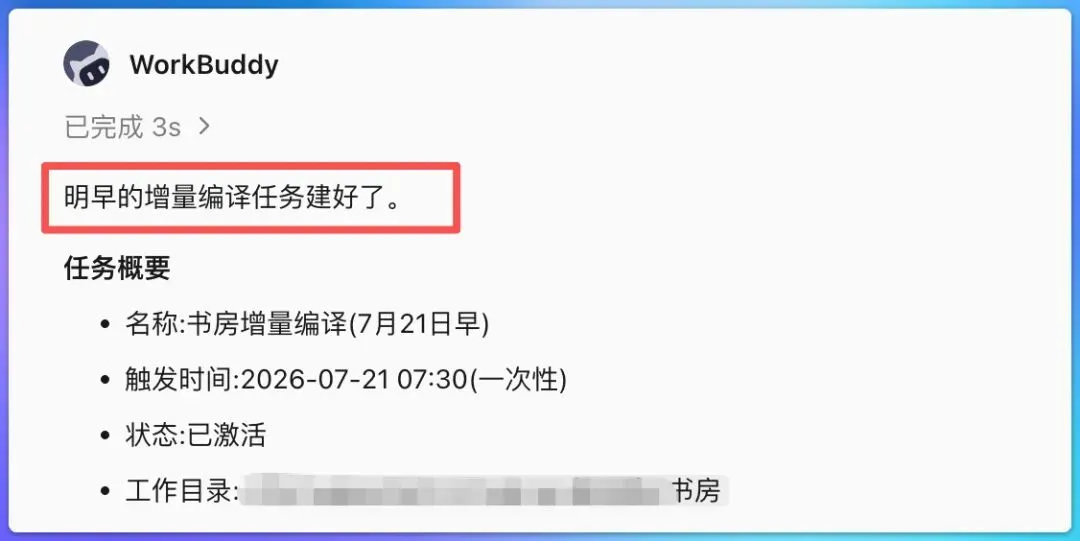
配完这两个任务,这套东西就算自己转起来了。你唯一要干的事,就是往 raw/ 里扔东西。
知识库就真正意义上,自动运转,自动成长起来了。
而且,还定期体检。
到这儿,存资料、编译、查询、检查,四步就全跑通了。
恭喜你,有了自己的专属知识库。
最后。
其实我们发现这四步,真的是够简单的。
AI 真的很简单可以把那些知识管理起来。
但是更重要的其实是,不要被“善于收藏”这个动作骗了。
存下来的,不等于是你的。能随时被你调出来、连得成网、用得上的,才是你的。
所以同理,就像我在这个文章里说的,不仅要存,还需要持续自我输入,也就是学。
当然,你也可以采用一样的方法,用定时技能让 AI 每天给你推一些知识点来学,但是,一定要学,一定要学,一定要学。
我给那个文件夹起名叫「书房」,起的时候没多想,现在觉得起得挺对。
仓库是东西堆进去就不管了,书房不是,书房里的每一本书,都是等着被翻开的。
*希望这篇对你有用。*
以上,既然看到这里了,
如果觉得不错,随手点个赞、在看、转发三连吧,
如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章
你的关注是我持续更新的动力~
我是谁
我是 AI 大刘,北大毕业,大模型研究方向,腾讯犀牛鸟,先后在腾讯、百度的大模型研发部门。现在斜杠青年:给多家国企做 AI 顾问 \ OPC \ 研究员 \ 产品独立开发者 \ Vibe Coder
