
原节目: 播客「AI 炼金术」 0228 余一访谈
分享者: 余一,AI 野生布道师
要点 Key Takeaways
- AI 全自动模式的关键不是提示词,是文件夹结构
- 异步沟通比实时盯着 AI 干活效率高十倍
- 长程任务的本质是让 AI 理解目标而非执行指令
- Skill 不是记录流程,是把能力压缩成可复用的原子
- 审美偏好存成 HTML 样本比写一千字提示词都精确
- 验收标准写进异步沟通文档,AI 自己对齐
- 你的 AI 跟别人的 AI 差在哪——差在你的决策指标
- 与其追求 AI 完美,不如设计好纠错机制
人可以懒到什么地步
余一: 我就说:启动余一的全自动模式。
任鑫: 人类可以懒到什么地步……大家看一下就很荒谬。
任鑫开场就说,她昨天看到余一的屏幕录像时"很震撼"。
震撼的不是 AI 有多聪明,而是人可以懒到什么地步。余一演示了一段完整的工作流:她只说了一句"启动语音的全自动模式",然后 AI 就开始自己干活——读取文件夹里的资料,把所有内容内化之后去做 PPT,同时生成 3 版排版。另一边,因为她有 MiniMax 的 API 和自己的声音克隆(模型从 2.6 升级到了 2.8),AI 用她的声音从脚本到每一页的分享都自己完成。最后把音频完全嵌入 PPT,直接去往下一步生成短视频。
40 分钟,全自动。她只需要站在旁边翻页。
更妖的是,她在分享之前根本不看 AI 做了什么。她说"我把这个 PPT 打开,我说这是 AI 语音做的,先让 AI 余给大家讲一遍"。意思是:连她自己都不知道 PPT 里讲了什么,让 AI 先讲,她再补充人类无法被取代的部分。
这不是在"使用 AI 工具"。这是在管理一个不需要发工资的员工。
异步沟通:不要绑定在谁的状态上
余一: 我现在异步沟通的方式是把需求写在文件里,附上验收标准。她每完成一个任务,必须回去读那个异步沟通文件。
余一和 AI 的日常沟通方式,不是对话框来回打字,而是异步沟通文档。
具体做法是:她把需求写在一个文件里,附上验收标准、参考材料和建议的方法。AI 读取之后开始执行,完成一小步任务就回去读那个异步沟通文档,看有没有更新。
为什么不实时盯着?因为她发现实时沟通有两个问题:第一,你被绑定在 AI 的工作状态上,它干活你就得等着;第二,上下文越多越难找到关键信息,还浪费 Token。
余一说得很直接——"就希望我们俩的工作就是谁也不要绑定谁的状态"。你把需求丢过去,它该完成的都完成。需要你决策的,放到异步沟通文件里,你到时候再接着读就行了。
更有意思的一个细节是:她最近让 AI 语音去改造成视频的那个工作台改造,AI 在过程中有时会自己发现错误——比如字幕位置不对——AI 自己就解决了,甚至不需要打断余一去 check。完成之后她自己去看一看,有些完成了,有些没完成,需要 check 的问题就放到异步沟通文件里面。
这个思路反而比大多数人管真人团队还成熟。
红黄绿灯:给 AI 分级授权
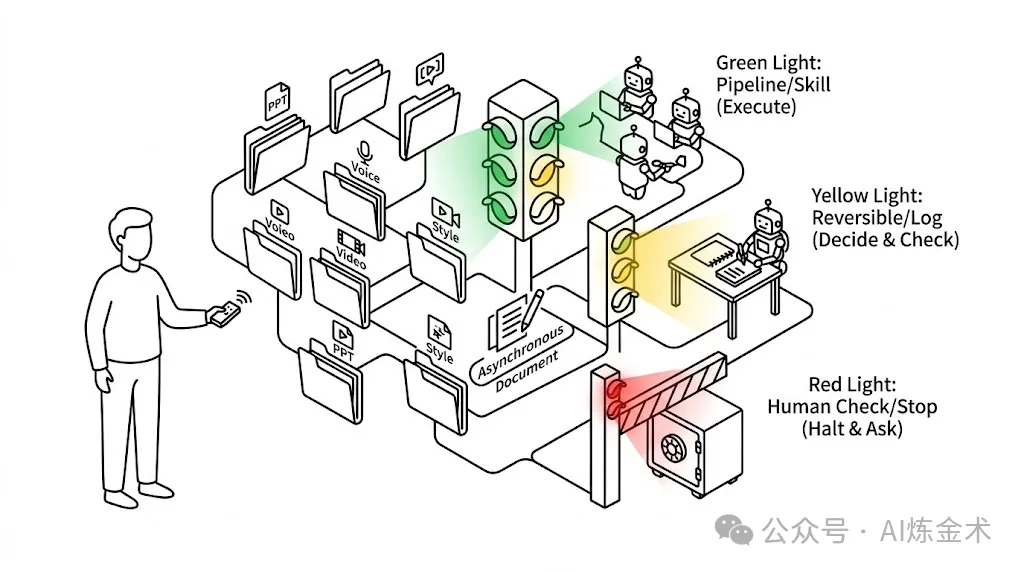
余一: 你看她就会判断说黄灯的角色是可逆操作,所以她就自己安装了。安装完了之后就开始读取、准备视频、读取经验库。绿灯的话材料都已经明确了,流水线逐步推进就好了。
余一给 AI 设计了一套"红黄绿灯"决策机制,这是整个访谈里我最想偷的东西。
绿灯:材料都已经准备好了,流水线逐步推进就好了,完全不需要人决策。AI 自己创建目录、聚焦重点、设定判断标准。这里面完全不需要任何人决策的地方。
黄灯:AI 可以自己做决策,但属于可逆操作。比如安装一个软件、选择一种排版方式。AI 做了就做了,但必须把决策过程写进异步沟通文档里——万一有问题,人可以回溯。
红灯:涉及到钱、涉及到会改底层东西的决策,必须上升到红灯,停下来等人确认。
这套机制的精妙之处在于:它不是限制 AI,而是释放 AI。大多数人用 AI 的问题是什么?要么全程盯着不放心,要么全放手出了事后悔。红黄绿灯让你精确地知道——哪些事可以完全不管,哪些事只需要事后看一眼,哪些事必须亲自拍板。
任鑫听完第一反应是"我要加到我的 CLAUDE.md 里面去"。还要加上一个异步沟通的机制。我建议你也这么做。
长程任务:让 AI 理解目标而不是执行指令
余一: 我对长程任务的理解,不是说它可以完成一个事情完成很长,而是中间它能够基于这件事情的真正目标,自己不断在当中做决策、做验收,甚至妥协之后换给我。
任鑫: 它懂得变通,懂得理解老板的根本诉求。就绕开的点就可以更多了。
余一定义的"长程任务"不是"耗时长的任务",而是 AI 能独立交付、所有决策自己完成的任务。
她举了一个很具体的例子:让 AI 发邮件把文件交给她。AI 先尝试通过常规邮件发送,发现不行。然后 AI 没有停下来问她怎么办,而是自己识别出"你的目的不是让我发邮件,是让你拿到那个文件"。于是 AI 自己去网上找了一个临时网盘,把文件上传,把链接发给余一让她下载。
余一说这就是她期待的长程任务——AI 理解了目标(让你拿到文件),而不是死板地执行指令(发邮件)。当一条路走不通时,它会自己变通、自己找替代方案。它识别出来了:这个任务就是你要这个文件,你希望在异步中看得到。
判断长程任务好不好,不是靠时间长短,而是根据任务的质量评估。 AI 能够独立完成所有决策,你可以把任务独立交给它她可以放心的拿到结果。关键词是"独立"——所有的决策,完全给到了 AI。
Skill 系统:能力的原子化和复用
余一: 你不停的在想说哪些是通用的能力,通用的能力应该是它可以被多个 Skill 调用的。然后就不要把它放在某一个 Skill 里面,要不然所有的 Skill 都变得很大,也会很费 Token。
余一的 AI 工作流里有一个核心概念叫 Skill——不是"技能"这个泛泛的词,而是一种精确的能力封装。
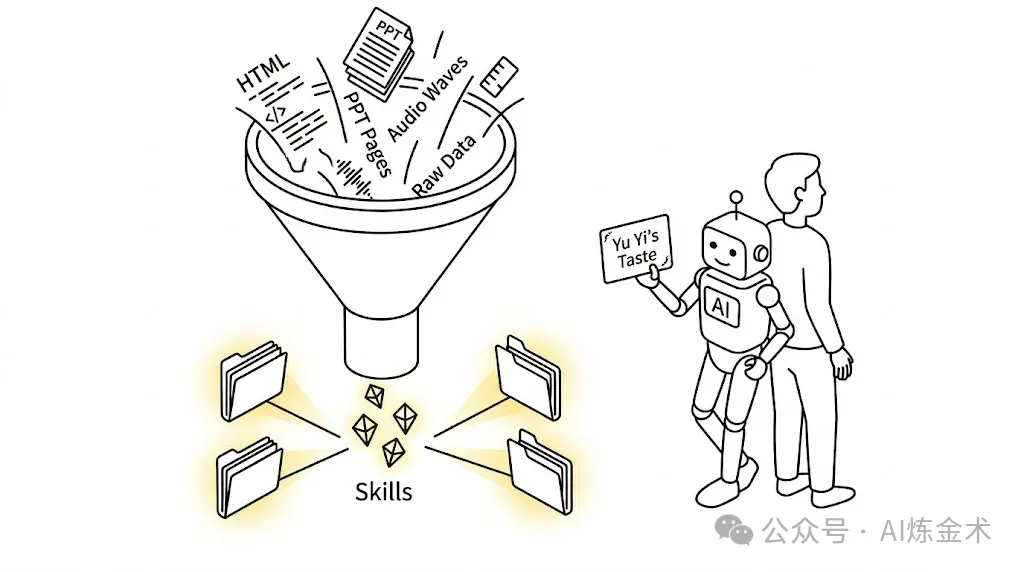
每个 Skill 是一个独立文件夹,里面包含了完成某类任务所需的所有规则、流程和判断标准。比如 TTS(文字转语音)是一个 Skill,做 PPT 是一个 Skill,生成短视频是一个 Skill。AI 在执行长城任务时,会自己判断需要调用哪个 Skill,然后按照里面的规则去执行。
关键洞察是: Skill 不是记录你做了什么,而是压缩你的能力 。余一说她会不断把通用的能力从具体的 Skill 里抽离出来。比如"审美偏好"——如果放在 PPT 的 Skill 里,那做视频的时候就调用不到。所以她单独建了一个审美偏向文件夹,所有涉及到审美和设计的 Skill 都去调用它。
而且不是做成了的事情都要列 Skill。余一说判断标准是:真的会经常使用的,才做 Skill。否则就压缩进去就好了。因为太多了 AI 也很烦。
这个思路本质上是在做什么?是在把"余一这个人的判断力"编码成可被 AI 调用的模块。她的品味、她的决策标准、她对质量的要求,全部变成了文件系统里的一个个节点。
审美文件夹:把品味变成可调用的资产
余一: 对你的审美来说,就是那些你看到比较好的,就让 AI 存一份在里面就好了。文字对于 AI 不是一个很好理解的东西,不如你把它做出来。
大多数人用 AI 的一个痛点是:AI 做出来的东西"不像我"。余一的解法很简单——把你的审美存起来。
她有一个专门的审美偏向文件夹。看到好的设计风格、好的页面排版、好的视觉效果,她就让 AI 直接 copy 成 HTML 存进去。下次 AI 做 PPT 或者做视频的时候,就去那个文件夹里找参考。
她甚至不是给 AI 写提示词描述"我喜欢什么风格",而是直接把实物样本存进去。因为"文字对于 AI 不是一个很好理解的东西,不如你把它做出来"。比如看到一个好的风格,让 AI 直接 copy 下来做成 HTML 存着,比你写一千字的描述都精确。对 AI 而言是一个很快速的能理解这个风格是什么的一个方式。
任鑫说她觉得这个也蛮好的——相当于你把原子化能力都已经准备好了,你她拼这个东西就特别容易。所以我们大部分人缺的,其实是这些原子化的东西还没有准备好。
这也是为什么余一的 AI 做出来的东西越来越像她——不是 AI 变聪明了,而是 AI 可以调用的"余一的品味数据库"越来越丰富了。
100% AI 短视频实验:人不干预任何环节
余一: 我还是坚定的说,我在做一个 AI 百分百的实验,我就不应该在这个环节把我的判断放进去,就是它给了什么我就发什么。
余一在做一个激进的实验:让 AI 100% 独立生成短视频,从标题到封面到内容,人完全不干预。
有一集视频名叫"棉手套"——对,这是 AI 自己取的名字。一个关于余一用 AI 的经验的视频,AI 起了个叫"棉手套"的标题。余一觉得莫名其妙,但还是发了。
她的逻辑是:如果我干预了标题、干预了内容,那我就没法真正测试 AI 的能力边界在哪里。她标注了"这是 AI 百分百生成",然后出了问题就把反馈给 AI,让 AI 自己学习。
数据不太好看。余一自己也知道发出去数据不好看的可能性非常高。但她反而觉得这才是实验的价值——她之前也做了一个有意思的对比:那个同一个短视频里大概 3 分钟,里面有 20 张图,就会有 20 张 PPT。AI 会做视觉检查,但 20 张有一张没检查出来——没过品控这一关。但也已经很强了。
AI 自己也会复盘。它会去读聊天记录,分析决策链,选标题的时候会列出 8 个候选,有具体数字、有比喻、有结果,然后自己选一个。余一说她比较满意的是,AI 甚至开始自己给自己复盘——分析哪些维度影响了数据,包括发布时间、封面平台的算法、话题热度,而不只是标题本身。AI 说这些不在我的范围内,标题只是影响数据的某一个方面。
这个自主性让余一特别满意。
对齐与压缩:你的 AI 跟别人的 AI 差在哪
余一: 如果总结成两点,就是不断的去做压缩和对齐。就是压缩到底 AI 做好某些事情到底要哪些能力,这些能力你怎么给她配齐。
余一: 随着 AI 能力越来越强,大家都要回答一个问题——你的 AI 跟别人的 AI 到底差别在哪?差别在你用什么样的决策指标让它去做决策。
余一把她跟 AI 协作的核心压缩成两个词: 压缩和对齐 。
压缩,是把你的能力、品味、判断标准变成 AI 能读取的格式。不是写一篇长文告诉 AI"你应该这样做",而是把经验变成文件、变成 Skill、变成审美文件夹里的 HTML 样本。压缩得越好,AI 理解得越准,你跟它的沟通成本就越低。
对齐,是让 AI 的决策标准跟你的决策标准一致。余一说了一个很尖锐的问题:"随着 AI 能力越来越强,大家都要回答一个问题——你的 AI 跟别人的 AI 到底差别在哪?"
差别不在模型。差别在你用什么样的决策指标去跟 AI 对齐,以及让 AI 用什么样的指标去做决策。那个指标让你的 AI 跟别人的 AI 不一样——因为毕竟你现在还是在给 AI 打工的老板,AI 还是在给你打工。
她做了一个有意思的类比:就比如说大家都是博士,但是那个博士跟博士的优势、弱点不一样。她有可能做出不一样的决策。然后有一天如果它能甩掉我自己去赚钱,我也能接受。
复利工程:跟 AI 吵架的艺术
余一: 我的复利工程现在都还在迭代,属于说还没有迭代出让我特别满意的版本。我今天下午都还在跟它吵架。
任鑫: 你跟它吵架是因为觉得它做复利工程没做好,是吧?所以其实复利工程的负责人是它。所以你要骂它。
余一管她的整套 AI 协作体系叫"复利工程"(Compound Interest Engineering),而且这个工程的负责人是 AI 自己。
她对复利工程的期待不只是记录流程。她说,"如果只是记那个东西太简单了"。她期待的是 AI 能够把具有通用性的能力压缩出来,主动积累、主动优化。
她甚至会跟 AI 吵架——"我说怎么可以做成这个样子,乱七八糟"。然后 AI 就开始自我改进。任鑫问她"你跟它吵架是因为觉得它做复利工程没做好,是吧?所以复利工程的负责人是它?所以你要骂它。"余一说:"对,我就骂它。"
她的方法是:让 AI 自己去学。看到好的设计风格,让 AI 去做 deep dive,启动语音的全自动模式。看到一篇好论文,先让 AI 自己学完,然后从商业角度重新写一遍。有时候就是给 AI 输入,让它干活,再让它出东西。
花 50 块钱的代价和"活着就行"的哲学
余一: 大不了我就付出代价。付出了代价之后,它没做好,我就说说它,然后它只要能改进,我们俩合作的效率就越来越高。这个事情永远绑定在我身上,啥时候是个头。无非是它做错了,那我也就是付出十几块钱的 Token 费用而已。代价很小。
任鑫: 懂得放手的人先享受世界。
余一对 AI 犯错的态度非常务实:代价无非就是十几块钱的 Token。
她不追求 AI 不犯错,而是设计好纠错机制。AI 做错了?花 50 块钱重跑一遍就好了。而且在套餐里面的话还不花钱。她说如果她一直盯着 AI 干活,她的时薪可不止 50 块。
这背后是一个非常清醒的经济账: 人的时间成本远远高于 Token 成本。与其花时间事前预防每一个可能的错误,不如让 AI 放手去做,出了错再纠正。 代价是几十块钱的 Token,收益是你不再被绑定在任何人的工作状态上。
任鑫总结得精准—— "懂得放手的人先享受世界" 。余一回了一句更直接的:"经常以一种活着就行的状态对待我和我的 AI。"
结语 Closing Thoughts
余一让我重新想了一个问题:大多数人还在讨论"我能用 AI 做什么",但真正领先的人已经在设计"怎么让 AI 自己做"。
区别不在于你用了多高级的模型,而在于你有没有把自己的判断力、品味和决策标准编码成 AI 可以调用的系统。文件夹结构、Skill 系统、异步沟通文档、红黄绿灯决策机制——这些看起来很"笨"的基础设施,反而是让 AI 真正独立工作的前提。
余一说她现在的复利工程还在迭代,还在跟 AI 吵架。但有一个方向是确定的: 压缩和对齐。把你的能力压缩成 AI 能读的格式,让 AI 的决策标准跟你对齐。做好这两件事,你的 AI 就不只是一个工具,而是一个能独立交付的团队成员 。
有没有可能,未来衡量一个人的能力,不是看她自己能做多少事,而是看她能让 AI 独立完成多少事?
