
01 前言
今年上半年收藏了很多碎片在 cubox 里,还没时间整理。收藏的时候一心想着 周末再看 ,真正到了周末,新的内容又进来了,旧的那批还躺在收藏夹里。🐒
小编原本有一套自己的整理习惯,以往的做法是:
- 看到好文章
- 丢到微信的 cubox 助手
- cubox 助手帮忙转存到客户端
- 周末去客户端读内容,内化成自己的知识
- 把读的内容给存放到飞书多维表格里
- 写联想化思考
- 定期复盘、发社媒
但这里会出现个问题是,只要哪个周末一忙起来,这套流程立马就断了。内容还在源源不断地涌进来,而真正被读完、写下联想、重新拿去创作的,却没多少。
02 把 Cubox 接入 Codex
而这次,我们做了个新尝试:把 Cubox-cli 接进 Codex ,让 Codex 直接读取我已经保存下来的内容,再继续操作 飞书多维表格 和 知识库 。工欲善其事,必先利其器。先来安装下 Cubox-cli 👇🏻:
●●○CODE
npm install -g cubox-clicubox-cli auth logincubox-cli auth status登录的时候要注意,Cubox 的 API 扩展链接只需要粘贴到终端里即可,别发到聊天窗口。
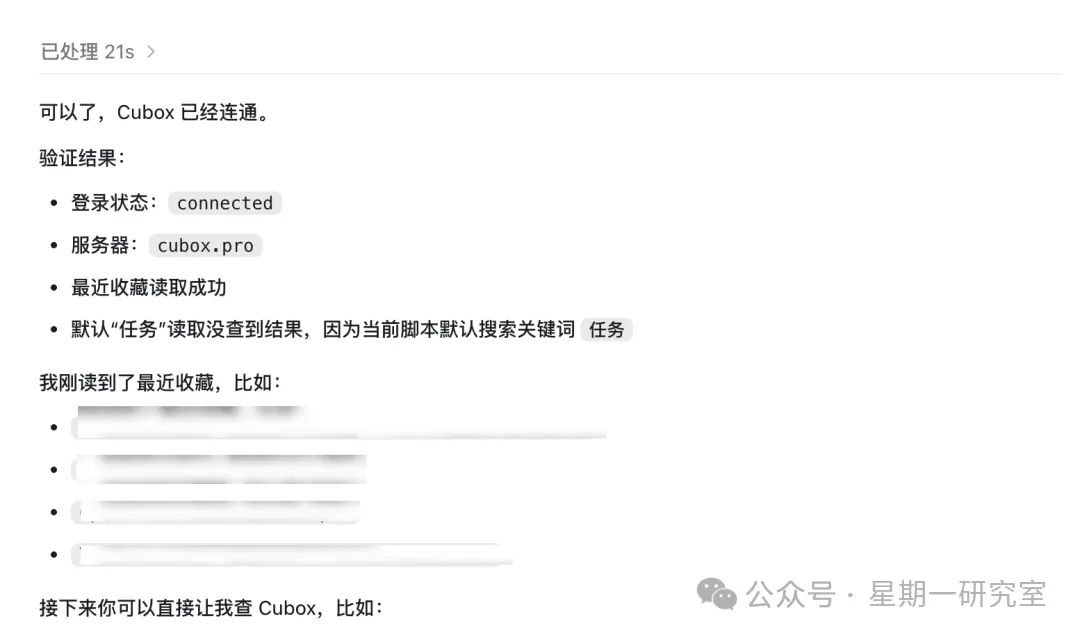
Cubox 连接完成
❝
这里附上更详细的接入方式,可以直接参考: https://help.cubox.pro/ai/agents/
03 那些年在收藏夹吃灰的文章
平日里的收藏习惯是,看到值得保存的内容,会顺手丢给微信里的 Cubox 助手;遇到报告或白皮书,也直接把 PDF 给存进去。
但收藏过后,麻烦的是 在收藏之后 才冒出来的。内容分散在文章、播客、图片和文件里,等真正想用的时候,脑子里往往只剩下一句「我好像看过」,具体存在哪儿早就想不起来了。
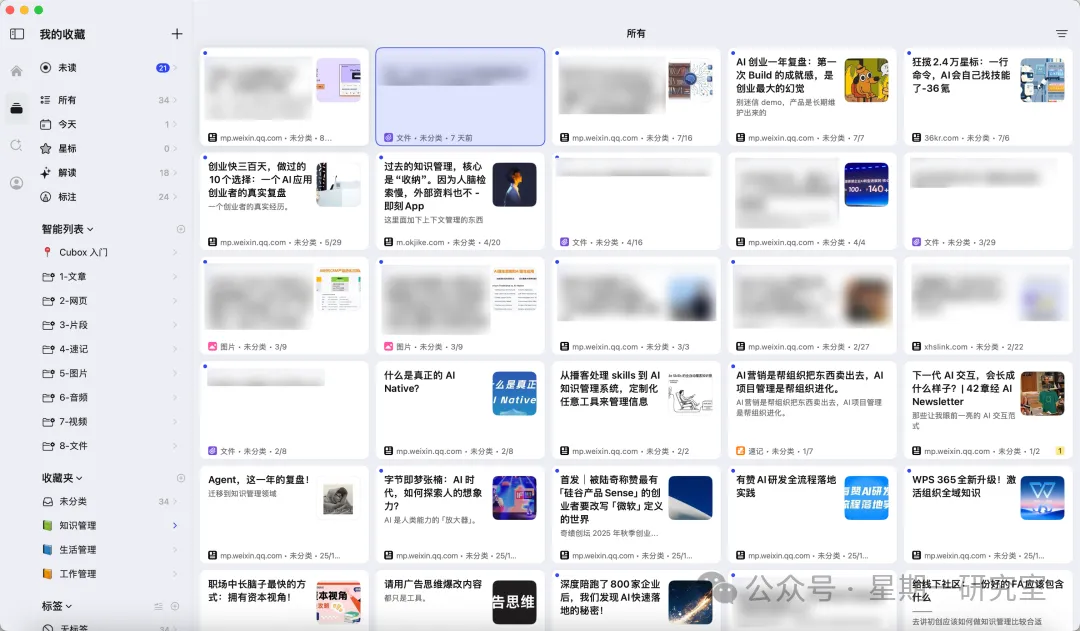
Cubox 收藏①
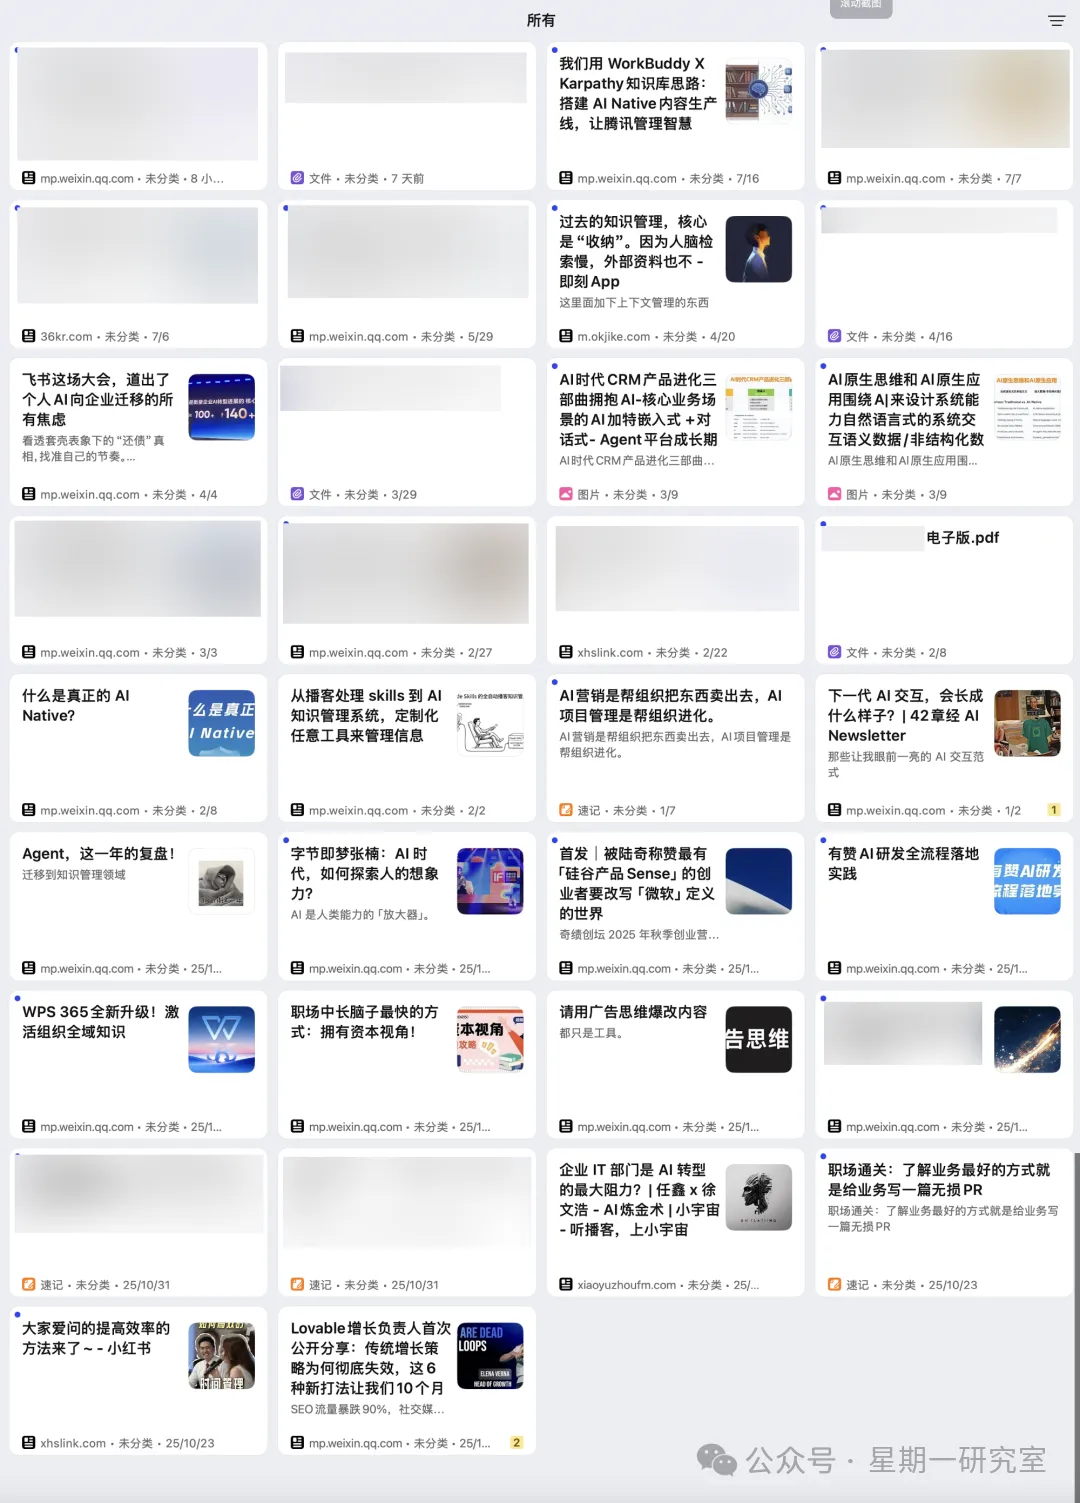
Cubox 收藏②
因此,这件事情,就交给「Codex × cubox-cli」来解决咯~
接入之后,我先让 Codex 按 时间范围 把内容拉出来,再根据需要打开 全文 、 批注 或 PDF 。如果只是简单的日常读取,用下面这几条命令基本就可以覆盖到:
●●○CODE
cubox-cli card list --start-time today --end-time today // 读取今天保存到cubox的信息cubox-cli card detail --id CARD_ID // 读取某篇文章的详细细节cubox-cli card rag --query "我最近收藏的企业AI转型内容" // 阅读最近收藏过的内容这一步先不急着分类,重点是把自己之前存了些什么内容,以及相关文章的类型,给捋清楚。后面的多维表格、知识库和复盘,我们都从这份清单继续往下走。
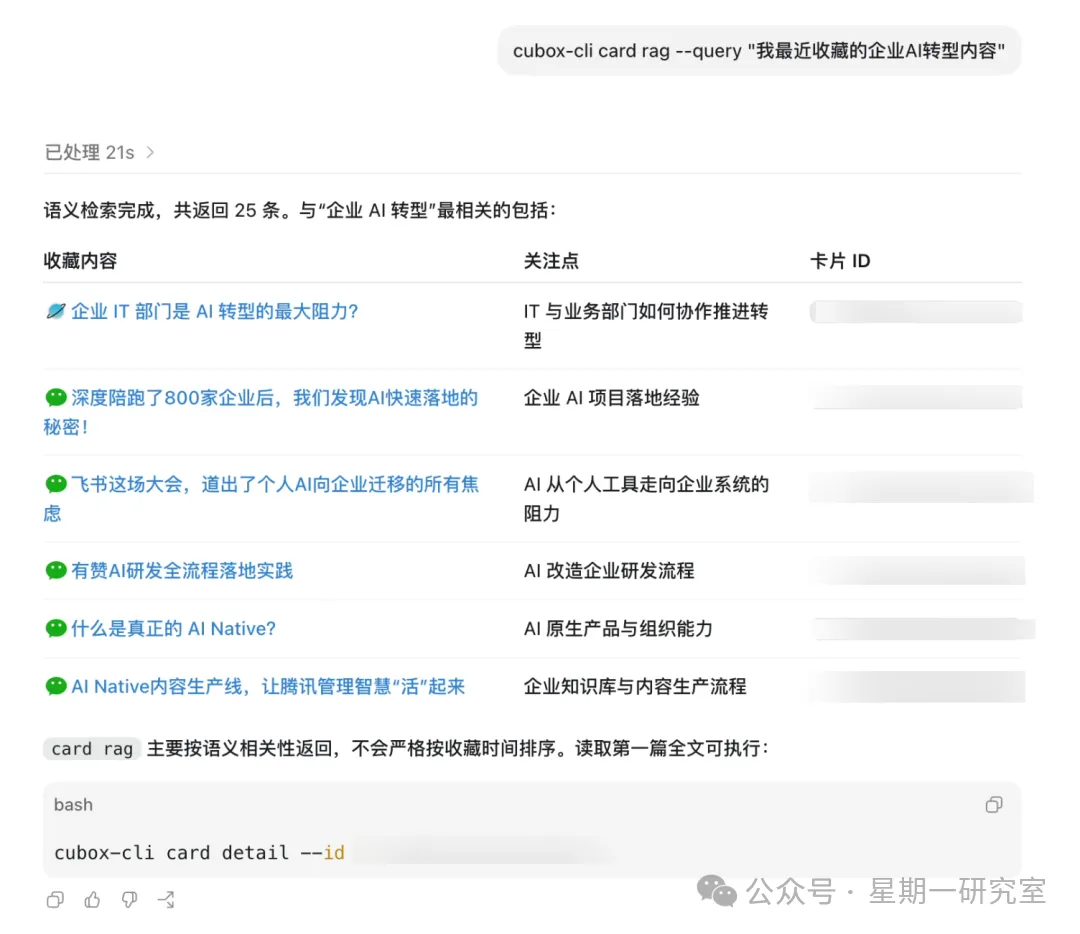
Cubox 返回相关类型的文章
04 用多维表格建立内容索引
当你阅读了很多文章,并且有了一些思考之后,接下来要做的,是把这些内容,分门别类地给整理到表格里面。
我让 Codex 读取了未归档过的文章,把每条记录的 标题 、 链接 、 来源 、 收录时间 和 内容类型 ,统一给写进一张飞书多维表格。
目前保留了下面这些字段:
| 字段 | 用途 |
|---|---|
| 原文主题 | 保留文章、播客或 PDF 的原始标题 |
| 原文链接 | 用标题作为可点击文本,随时回到原文 |
| 来源 | 区分公众号、小红书、小宇宙、即刻、Cubox 等平台 |
| Date / Month | 按收录时间查看每月关注内容 |
| 附件 | 存放需要长期保留的 PDF |
| 联想思考内化 | 记录这条内容和自己工作、选题之间的联系 |
来源这一栏,让 codex 根据 原文链接 来判断;如果是那种 Cubox 深链、又找不到更早出处的内容,就让 Codex 给标记为 Cubox 类型。
原文链接也统一改成了标题可点击的形式,表格里不会再铺满一长串网址,看着清爽很多。
Prompt 指令附上:
●●○CODE
读取我指定时间范围内保存到 Cubox 的内容,提取原文标题、链接、来源、创建时间和内容类型,并写入飞书多维表格。已有记录不要重复创建;来源不明确时保留为空,不要猜测。原文链接请显示为文章标题。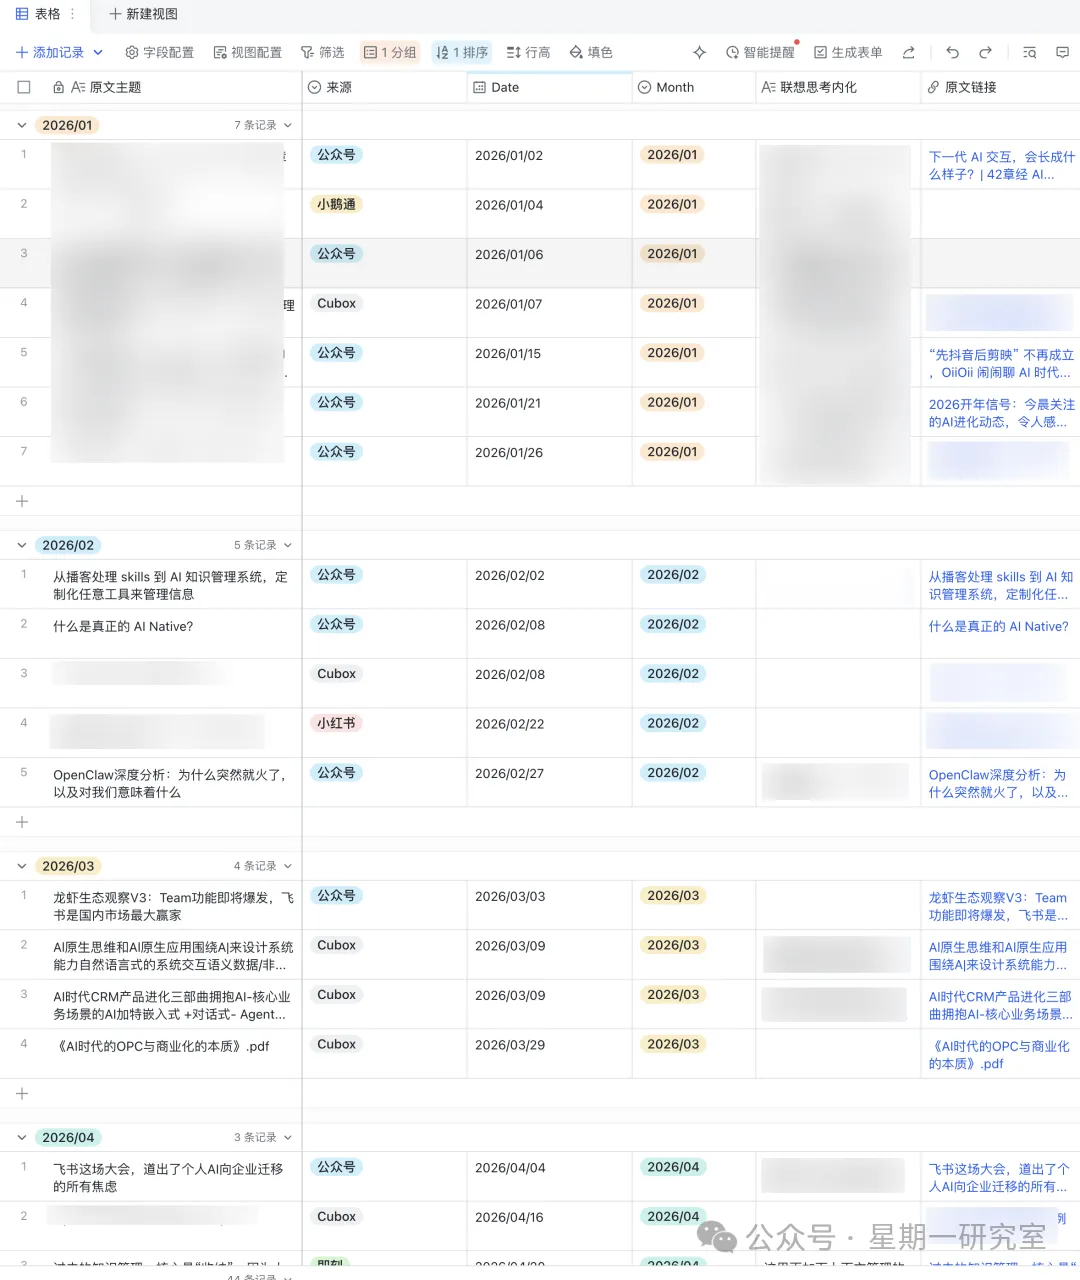
把数据按月份,存进表里,并分别打标签
05 把 PDF 存放到附件里
整理完之后我发现,有一些我收藏的 pdf ,并没有在表格里。
这个时候我就想着,飞书多维表格有 附件字段 ,能不能来一招愚公移山,把 cubox 每条记录对应的附件,也存放到多维表格里,对应记录里的附件字段里。
这样,我就不用再一直两个软件切换,一边阅读,一边写联想化思考了。
因此,我跟 Codex 说:
●●○CODE
帮忙把目前所有未读的内容,按照收录时间,给填充到这张表里面。https://my.feishu.cn/wiki/xxxxx如果有附件,直接把附件放到表格的附件字段里。你猜怎么着,它就水灵灵地,完成了这项工作:
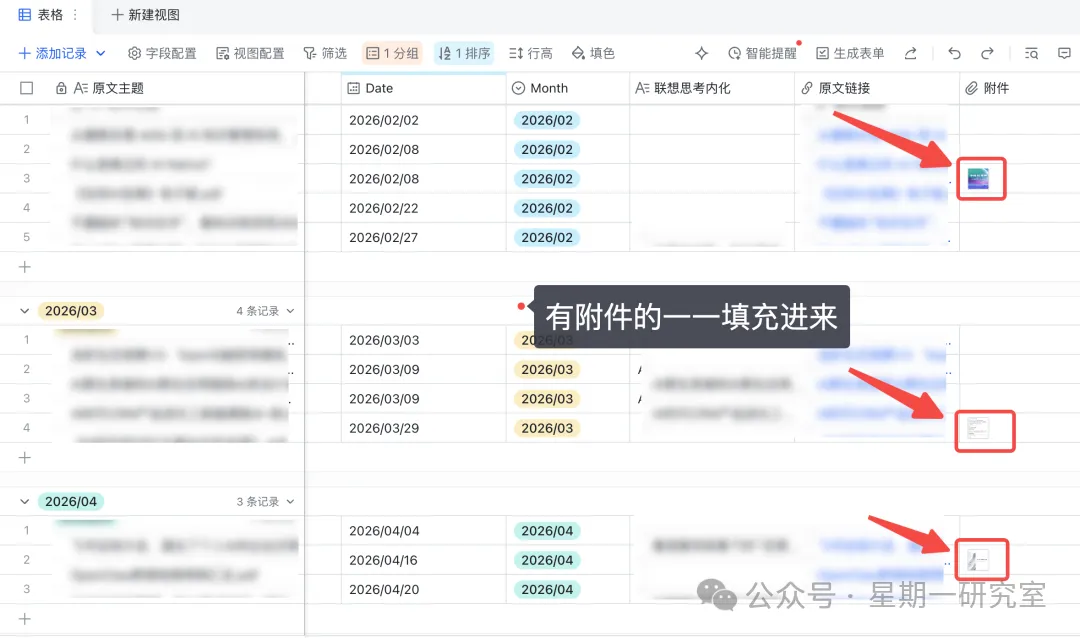
把 cubox 的附件,上传到多维表格里
06 把文章一一创建到知识库里
当然,有些小伙伴可能觉得,在多维表格里面看,可能还不过瘾。
那有没有可能把上半年攒下的所有内容,按月份,按目录,把文章对应的内容,给整理进了 知识库 。
想深度阅读的时候,随时打开知识库,点开对应月份收录的文章就能快速阅读,这样好像还更快一些。
于是,我跟 Codex 说:
●●○CODE
帮忙把未读的内容,按照时间,分别建立一个文档,然后在知识库以目录的形式,展示出来。|—— 月份1 |—— 碎片1 |—— 碎片2 |—— 碎片3|—— 月份2 |—— 碎片1 |—— 碎片2 |—— 碎片3Codex 开始吭哧吭哧地干活:
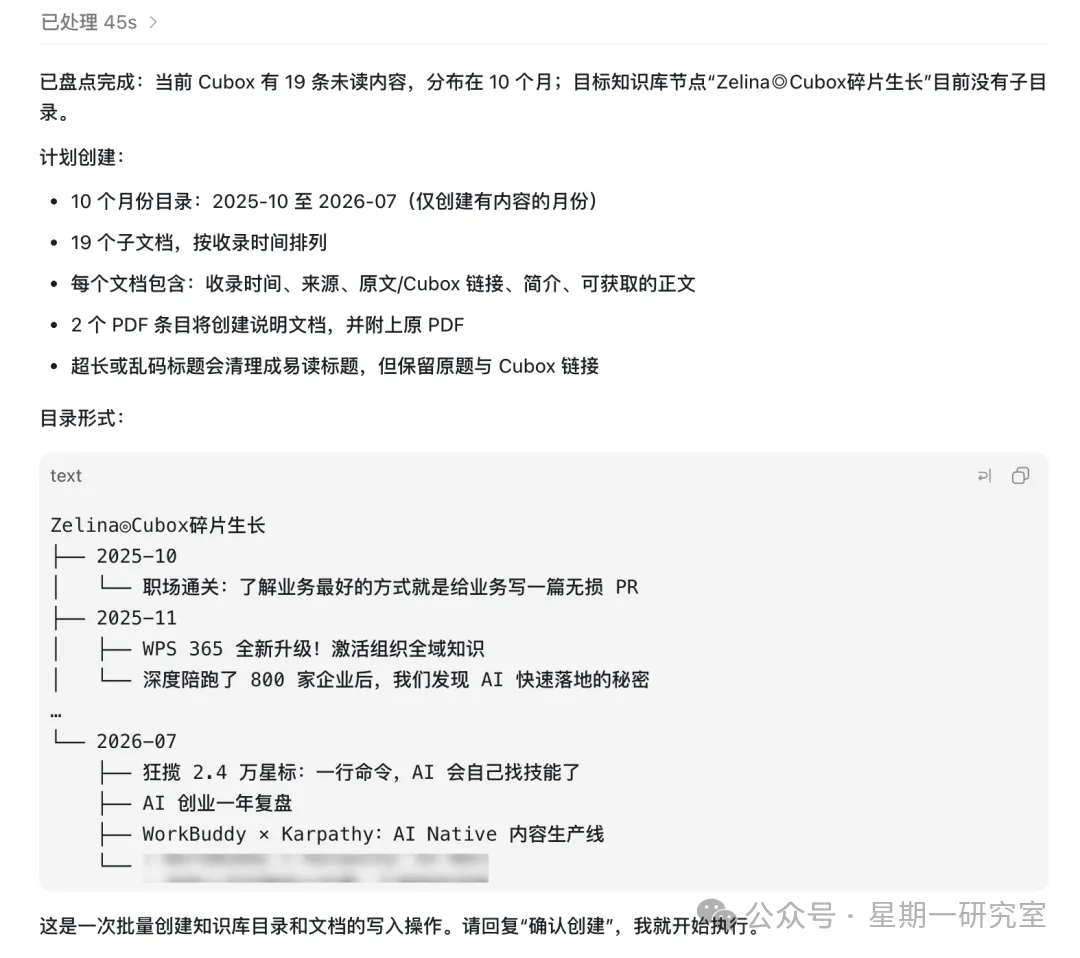
先帮我整理了目录结构
最终,Codex 出色地帮我把碎片给整理到知识库里:
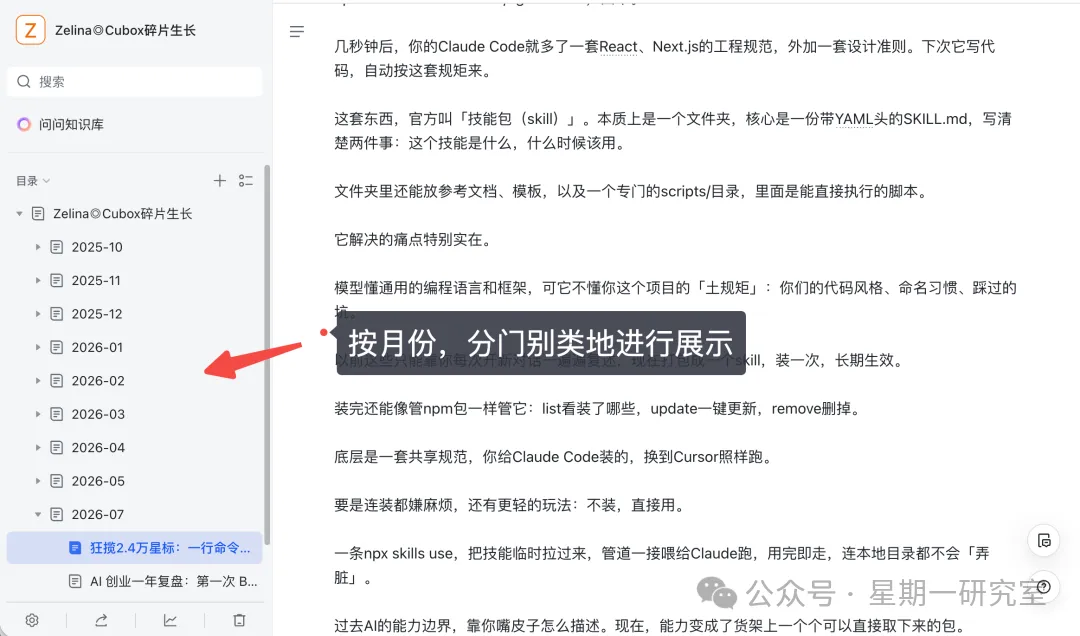
按月份整理的知识库目录
可以发现, 多维表格 负责 索引 , 知识库 负责 正文 。按月份打开目录,一眼就能看到那段时间自己都读了什么。
07 一条收藏如何长成新的思考
到这里,收藏已经从 Cubox 搬进了表格和知识库。但只是把内容整理得更整齐,还不算真正消化。下一步,是让其中一条收藏继续往前走,长成一条属于自己的思考。
拿《企业 IT 部门是 AI 转型的最大阻力?》这条小宇宙收录举个例子,我先让 Codex 还原一下 这期节目 讨论了什么,再继续追问:
●●○CODE
结合这期节目的观点,帮我分析业务同学和 IT 部门应该怎么配合,并整理成一段可以继续写作的思考。它最后帮我提炼出了一条很实用的分工:
❝
业务负责定义价值和验收标准,IT 负责数据、权限和工程边界。
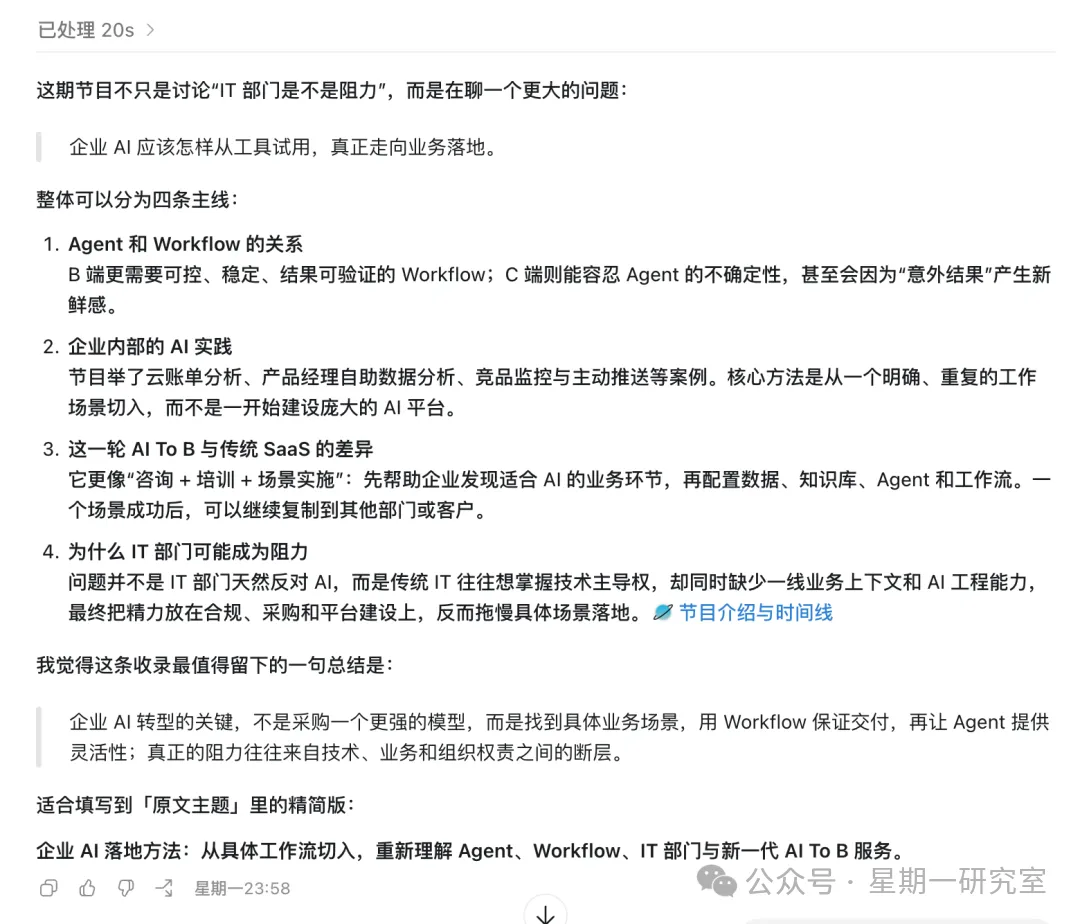
让 Codex 帮你衍生出,你想了解的方向,进而变成选题
原本静静躺在收藏夹里的一期播客,就这样变成了一条可以继续展开的选题。
当一条收藏可以这样被重新激活,接下来的问题就变成了:能不能让这件事不只偶尔发生一次,而是 每天 、 每周 、 每月 持续发生?
08 每日、每周、每月自动复盘
于是,我把这套流程又往前推了一步。存量内容整理完以后,让 Codex 每天读取当天新增的收藏,每周找出反复出现的主题,每月再生成一份关注轨迹和候选选题。
等 Prompt 打磨稳定了,再把它放进 Codex 的自动化任务里。这样,收藏后的整理、回看和提炼就不再全靠临时想起,变成了一套可以持续运转的复盘机制。
我先分别准备了三条 Prompt。第一次可以直接手动运行,确认输出符合预期后,再设置成对应周期的自动化任务。
设计了一套「每月复盘 Prompt」,方便大家直接食用:
●●○CODE
读取我本月新增到 Cubox 的全部收藏,并生成一份「月度关注轨迹报告」。如果可以读取上个月的数据,请同时进行对比。请完成以下内容:1. 统计本月收藏总数,并按内容类型、来源和主题进行归类。2. 总结本月最主要的 5 个关注主题,分别列出代表内容、核心观点和出现频率。3. 与上个月相比,分析哪些主题在升温、降温或首次出现;无法比较时直接说明。4. 找出不同收藏之间能够互相印证的观点,以及彼此冲突的判断。5. 判断我本月的关注轨迹发生了什么变化,并提炼 3 条值得长期保留的个人洞察。6. 生成 5 个下月候选选题,每个选题包含:标题、写作角度、支撑材料、仍需验证的问题。7. 给出下个月值得主动关注的 3 个方向,但不要为了凑数推荐与现有收藏无关的话题。输出结构:本月概览 → 主题地图 → 环比变化 → 交叉洞察 → 候选选题 → 下月关注方向。引用收藏时保留标题和原文链接,事实与推断分开表达。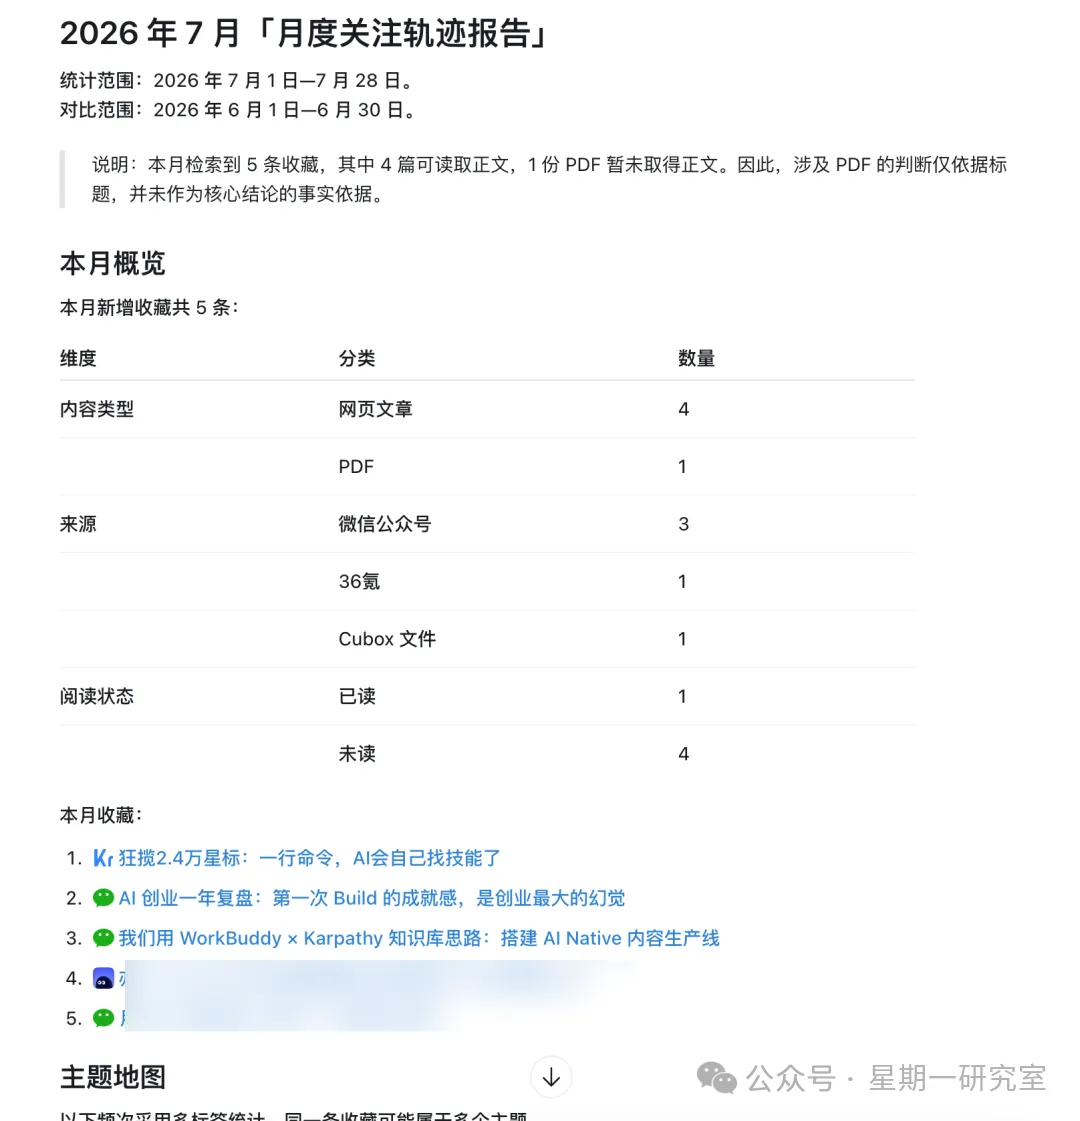
月度关注轨迹报告
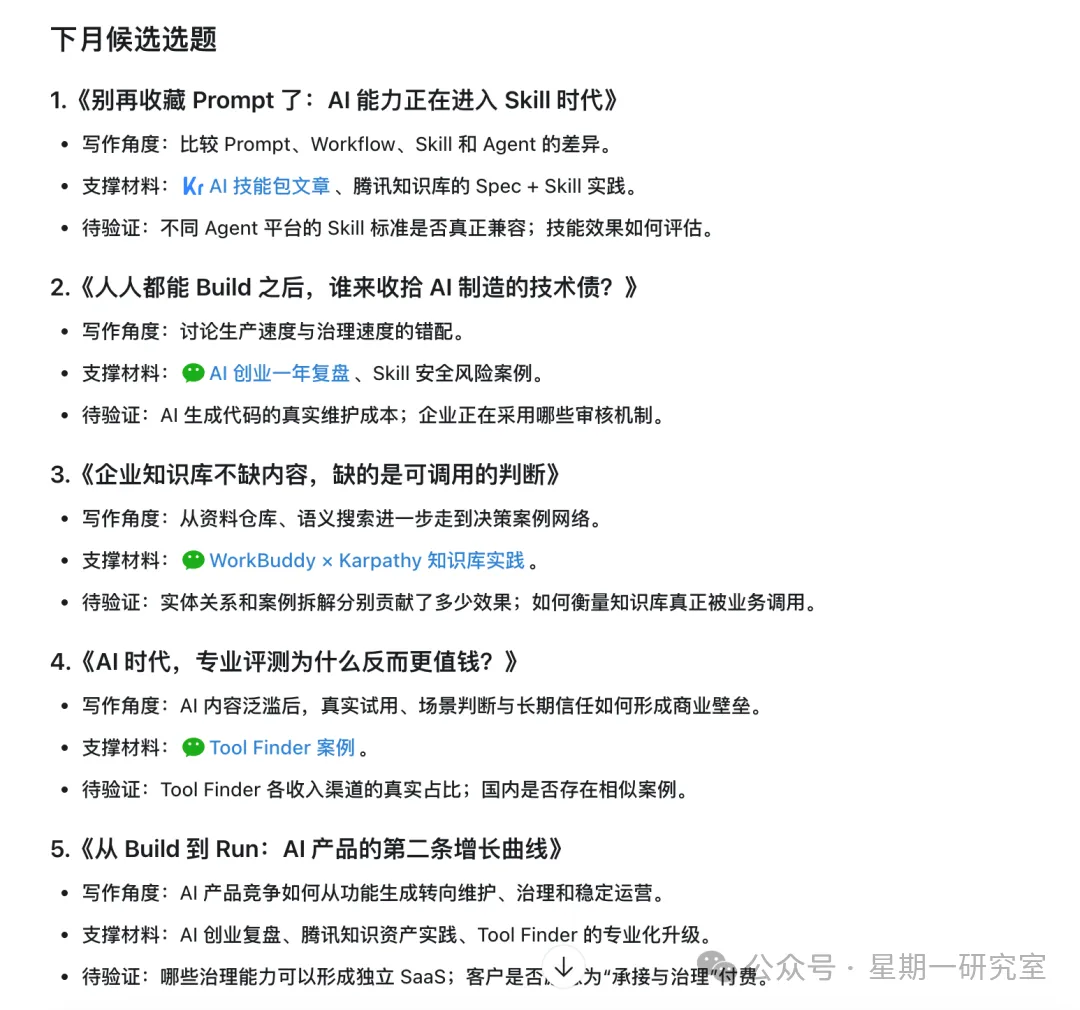
下个月候选选题
09 摊开碎片,洞见关注轨迹
当这套复盘机制跑过几个周期以后,更有意思的东西开始出现了。把这些碎片摊开来看,我们发现,过去半年内反复收藏的内容一直集中在某几个领域:项目管理、知识管理、企业 AI 落地,还有个人工作流落地。
以前它们只是几十条看起来互不相关的收藏,放进同一套索引以后,才开始看清了自己的关注轨迹,也更容易知道下一篇内容该怎么作为素材,来被二次利用。
这也是在跑完整套流程之后,让我较为触动的地方。除了 清空了收藏夹 以外,还把 零散输入 慢慢连成了一条可以回看的思考轨迹。
以后看到 好内容 ,我大概还是会顺手丢进 Cubox ,只是这一次,我很清楚它不会再一直躺在那儿吃灰了。
白天的收藏习惯几乎一点没变,只是把后面那堆整理的活儿,甩给了 Codex 。
以上就是本文的全部内容,我们下期见🧚🏻♀️🧚🏻♀️ 🧚🏻♀️
内容策划 | 周一同学
内容编辑 | 周一同学
排版视觉 | 周一同学
