
AGENT 实测手记 2026.07.30
让 Agent 批量采集网页数据 · Scrapling 实测
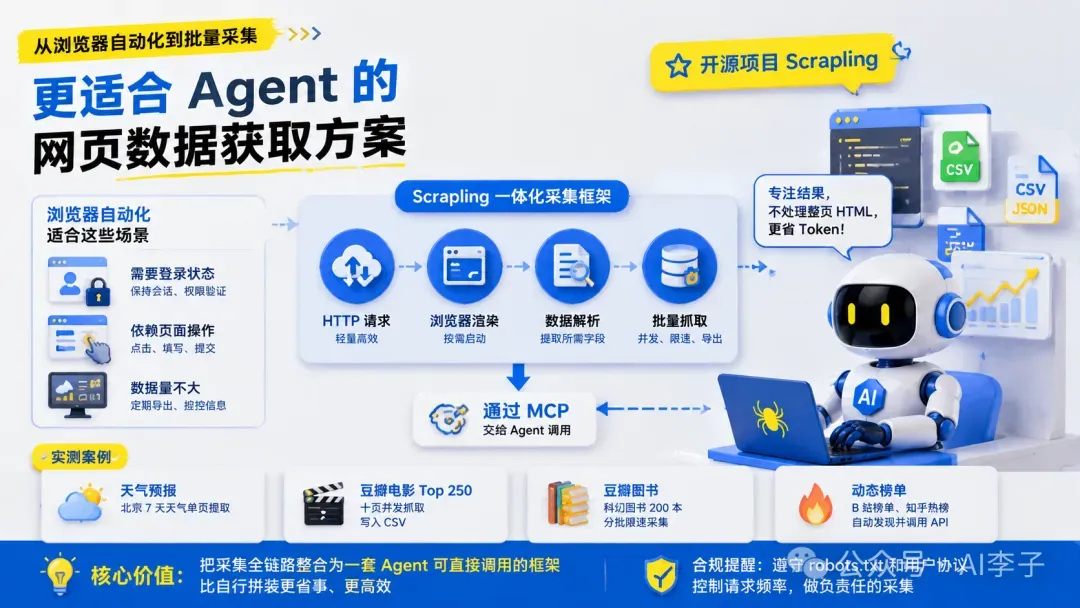
用开源框架 Scrapling + MCP,把 HTTP 请求、浏览器渲染、解析与批量抓取交给 Agent 自己调度
AGENT-01
最大价值不是「万能反爬」,而是把抓取能力封装成 MCP 工具让 Agent 调度
MCP Server 批量采集
之前分享 BrowserSkill、OpenCLI 一类工具时,我提到过一个区别: 浏览器自动化适合处理「数据量不大,但依赖登录状态和页面操作」的任务 。比如定期从后台导出数据、跨平台发布内容、监控账号信息。
如果要连续抓几十个页面,甚至做长期采集,始终开着浏览器就有点重了。最近正好有朋友问,有没有更适合 Agent 批量获取网页数据 的方案。我测试了一个开源项目 Scrapling ,并用它完成了天气、豆瓣电影 Top 250、豆瓣图书和动态榜单等任务。
实际体验下来,它最大的价值不是「万能反爬」,而是把 HTTP 请求、浏览器渲染、数据解析和批量抓取 放进了一套工具里,再通过 MCP 交给 Agent 调用。
如果对浏览器自动化感兴趣,可以看一下我之前的文章:
浏览器自动化新选择:体验腾讯刚开源的 BrowserSkill
01
PART
Scrapling 是什么?
WHAT IS IT
Scrapling 是一个 Python 网页采集框架 ,可以处理从单次请求到并发爬取的不同任务。它目前在 GitHub 上已有 7 万多个 Star ,并且仍在持续更新。项目支持 Python 3.10 及以上版本,采用 BSD-3-Clause 许可证。
PROJECT 项目信息
项目地址:https://github.com/D4Vinci/Scrapling
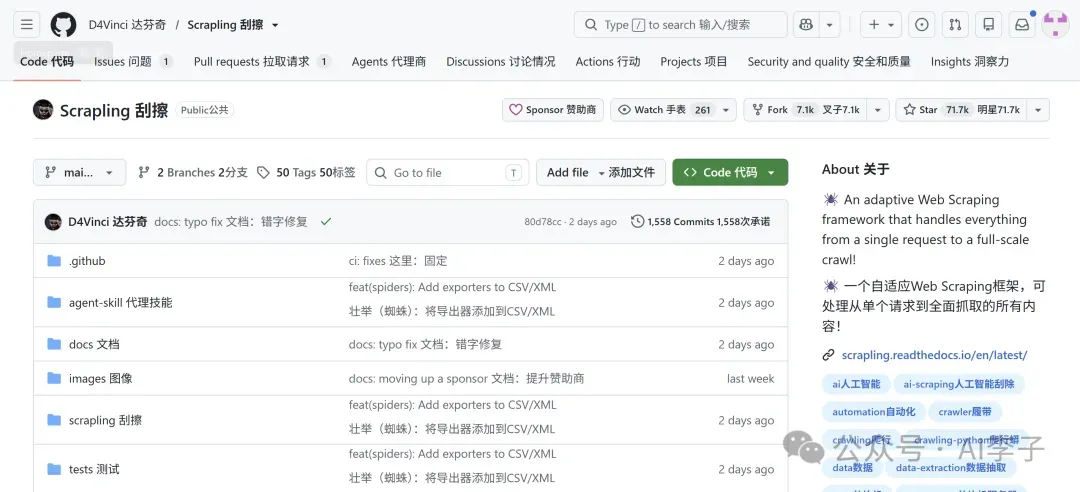
他的一个特点是, 能用 HTTP 请求解决时,就不启动浏览器 ;确实需要页面渲染时,再调用浏览器。
此外,它还有完整的 Spider 框架 ,支持并发、限速、暂停与恢复、多会话、代理轮换以及 CSV、JSON、XML、MD 等格式 的导出。
02
PART
为什么适合与 Agent 配合
WHY AGENT
Scrapling 自带 MCP Server ,可以接入 Claude Code、workbuddy 等支持 MCP 的工具。
Scrapling 通过本地 MCP Server 把网页请求和内容提取能力提供给 Agent。网页会先在本机完成请求和解析,再把 提取后的目标内容返回给模型 ,而不是直接把整页 HTML 塞进上下文。对于内容较长的网页,这通常可以 减少上下文占用和 Token 消耗 ,返回结果也更干净。
PIPELINE
Agent 如何通过 MCP 调用 Scrapling
优先走 HTTP 请求,必要时才启动浏览器渲染,最后只回传目标字段
03
PART
使用方法
我使用 Claude Code 进行测试,其他支持 MCP 的 Agent 配置思路基本相同。
Step 1 安装带 MCP 依赖的版本
首先安装带 MCP 依赖的版本:
pip install "scrapling[ai]"
scrapling installscrapling[ai] 用于安装 MCP Server 所需依赖。scrapling install 会安装浏览器及相关组件,下载量较大,但通常只需要执行一次。
Scrapling 要求 Python 3.10 及以上版本 。
Step 2 找到 Scrapling 可执行文件位置
接下来找到 Scrapling 可执行文件的位置。在终端可以先运行:
where.exe scrapling
Step 3 把路径注册进 Claude Code(地址替换为你自己的)
claude mcp add ScraplingServer "C:\Users\sheng\AppData\Local\Programs\Python\Python313\Scripts\scrapling.exe" mcp然后检查是否配置成功:
claude mcp list
也可以在 Claude Code 中输入:
/mcp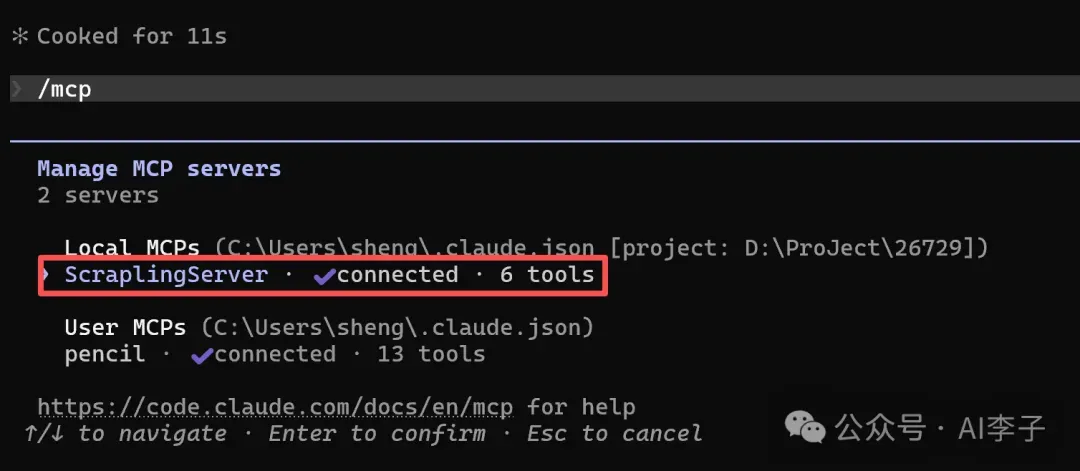
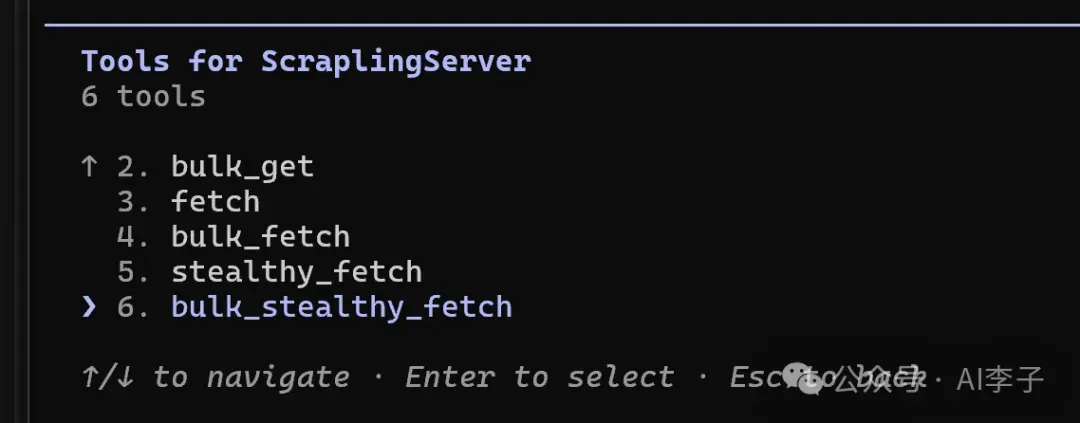
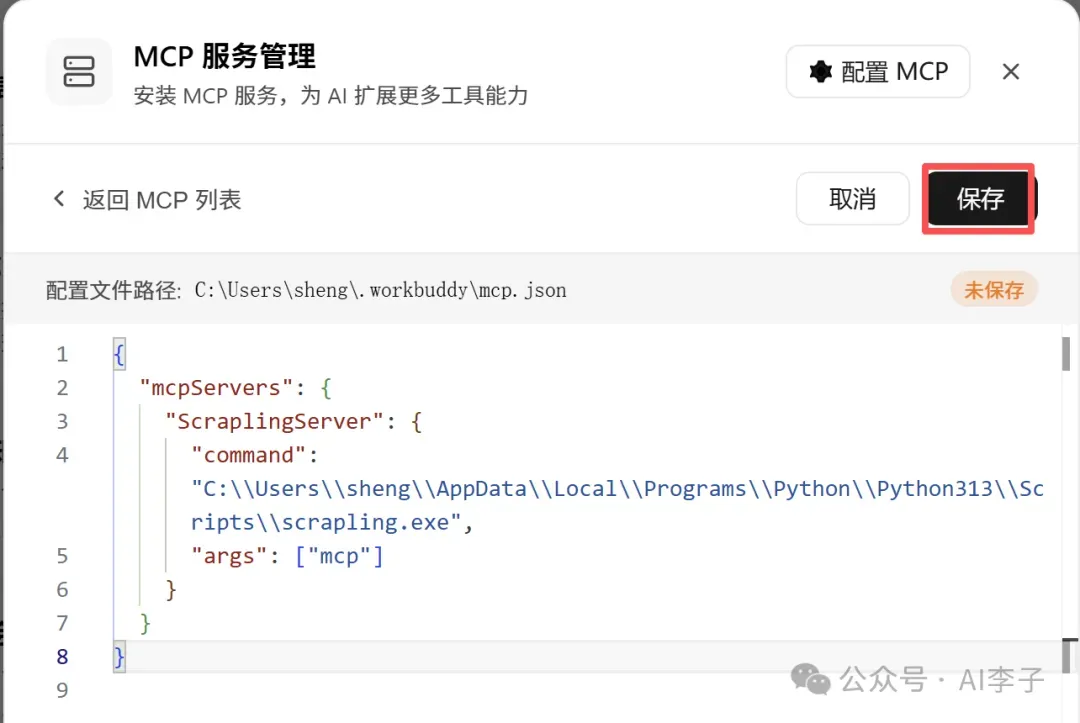
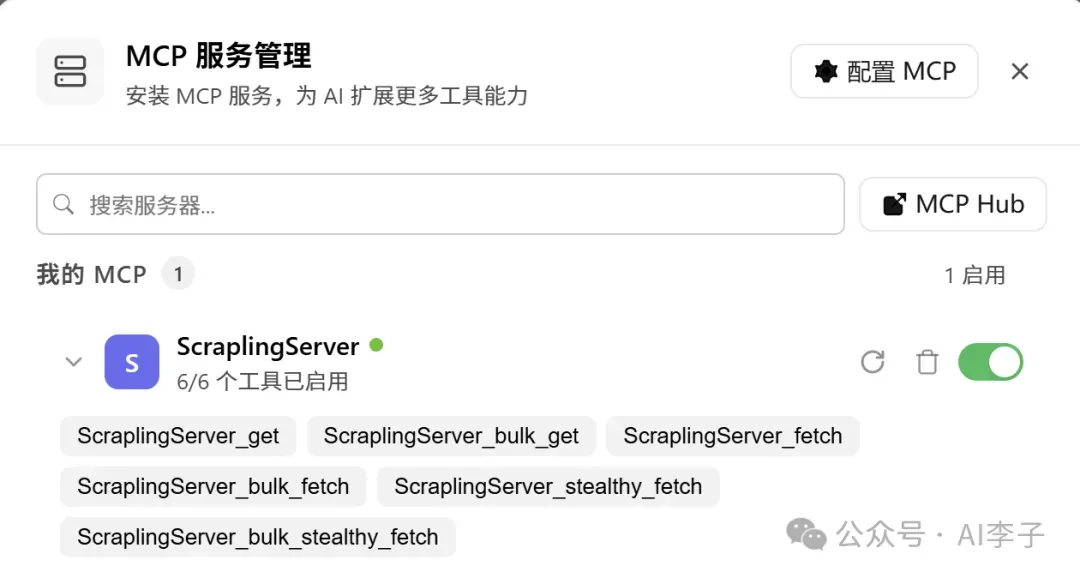
基本就配置完了,可以直接使用了。注意,如果你用的是 workbuddy,把以下配置连接到 workbuddy 就行(其它 Agent 也是类似)。
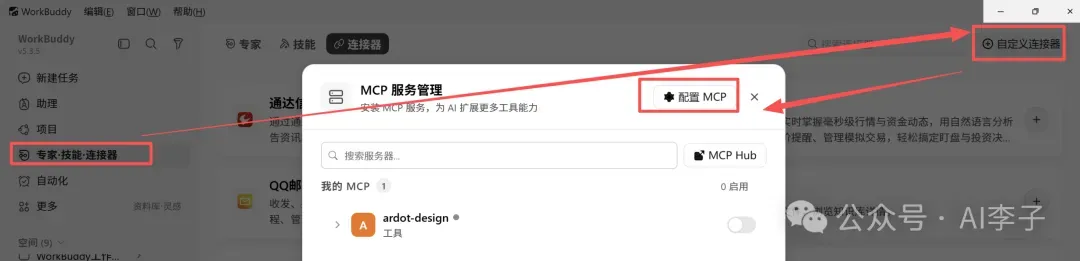
打开 WorkBuddy → 左侧边栏点「专家-技能-连接器」选到连接器 → 右上角「自定义连接器」→ 点击配置 MCP → 在弹出的 mcp.json 编辑框里加入即可( 地址替换为你自己的 ):
{
  "mcpServers": {
    "ScraplingServer": {
      "command": "C:\\Users\\sheng\\AppData\\Local\\Programs\\Python\\Python313\\Scripts\\scrapling.exe",
      "args": ["mcp"]
    }
  }
}
04
PART
Case
CASE STUDIES
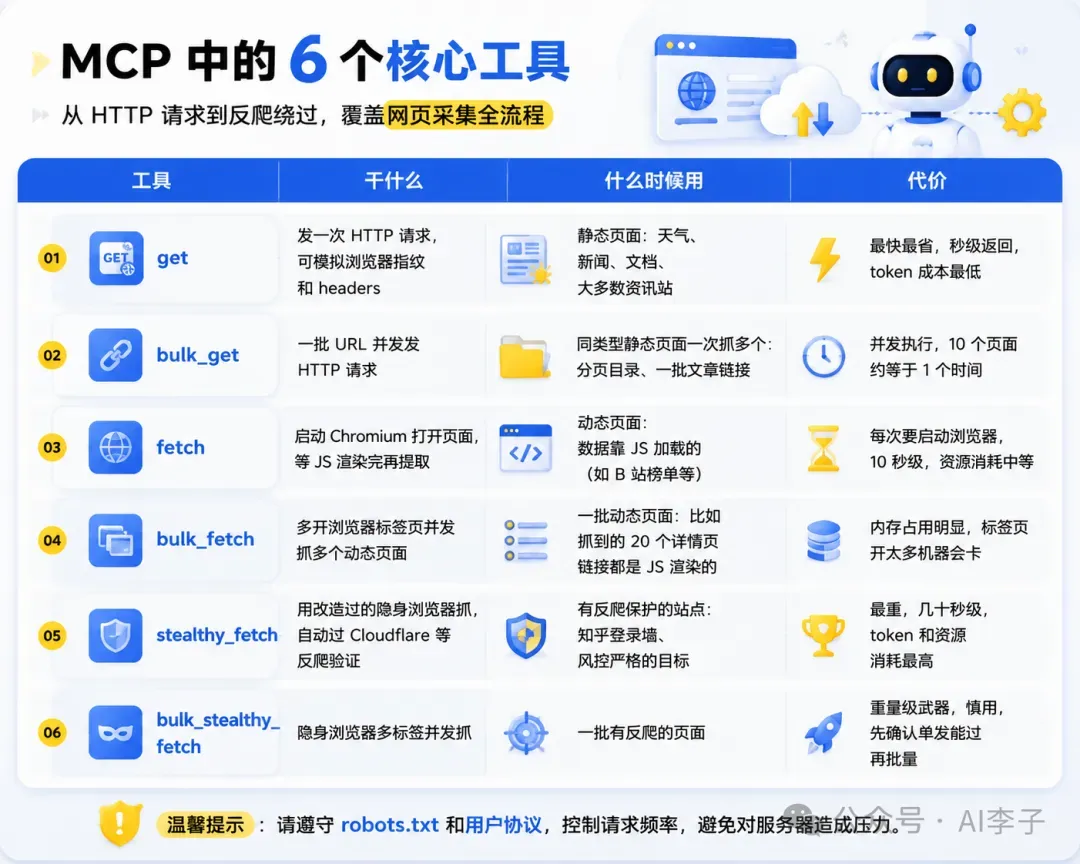
下面咱们通过几个 case 试一下 Scrapling 的能力。开始 Case 之前,先说一下 MCP 中这 6 个工具。
CASE
case1:抓取北京 7 天的天气
天气 · 单页请求
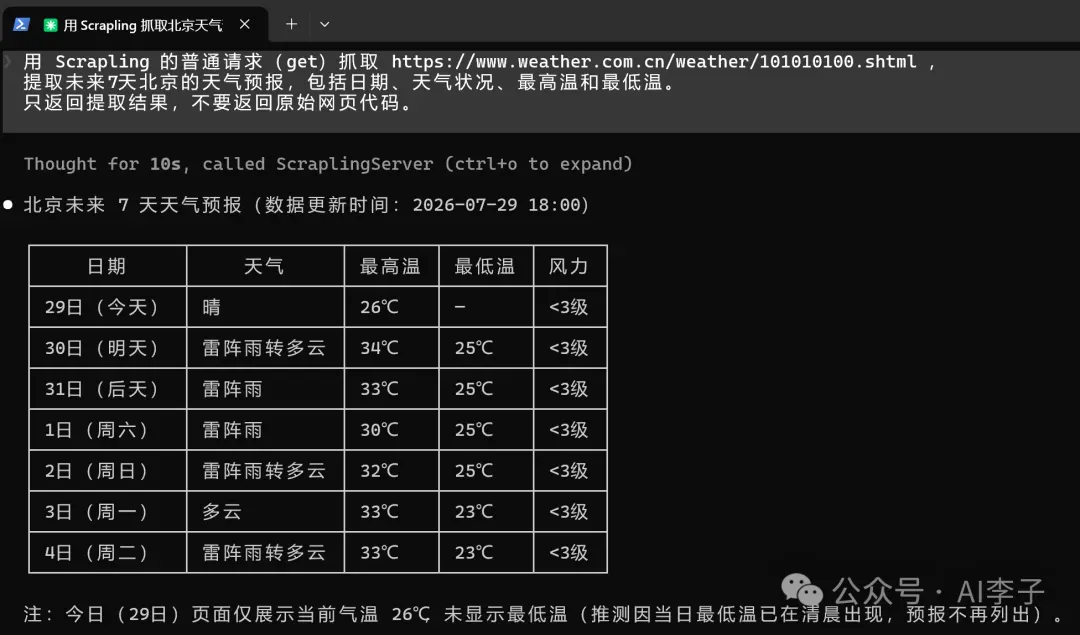
我先用一个简单任务测试普通请求:
用 Scrapling 的普通请求(get)抓取 https://www.weather.com.cn/weather/101010100.shtml,
提取未来 7 天北京的天气预报,包括日期、天气状况、最高温和最低温。
只返回提取结果,不要返回原始网页代码。十几秒后就得到了结构化结果,内容比较干净。这个案例本身不复杂,主要用来确认三件事: MCP 是否连接成功、Agent 能否正确调用工具、能否只提取目标字段 而不是返回整页 HTML。
SCALE Case 2 · 规模抓取 2 cases
CASE
case2.1:抓取豆瓣电影 Top 250
规模抓取 · 分页 + CSV 落盘
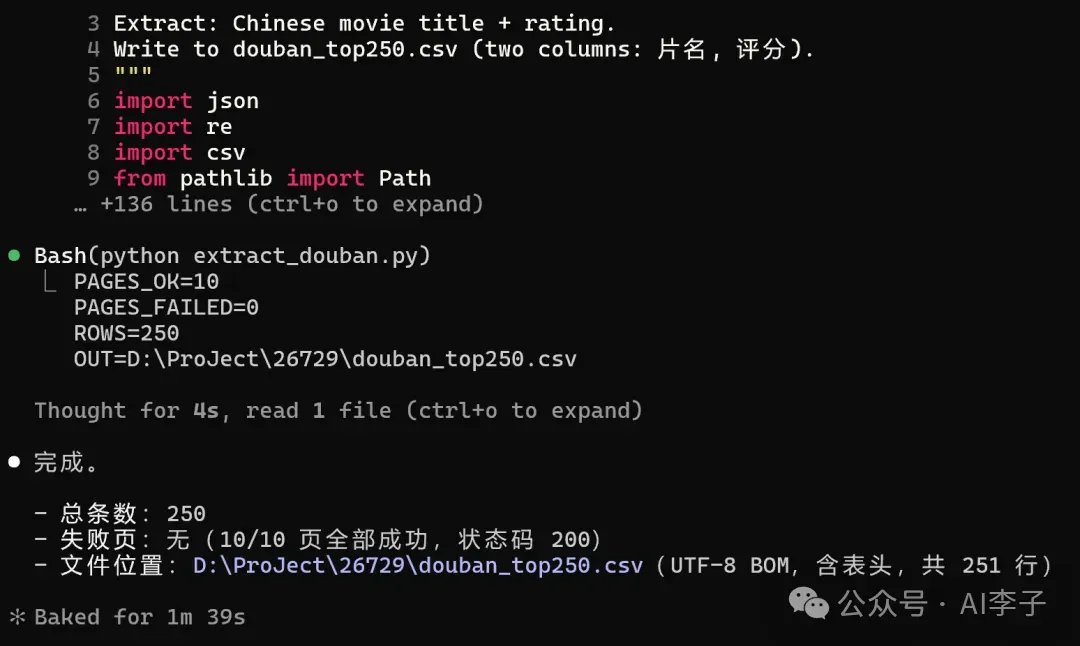
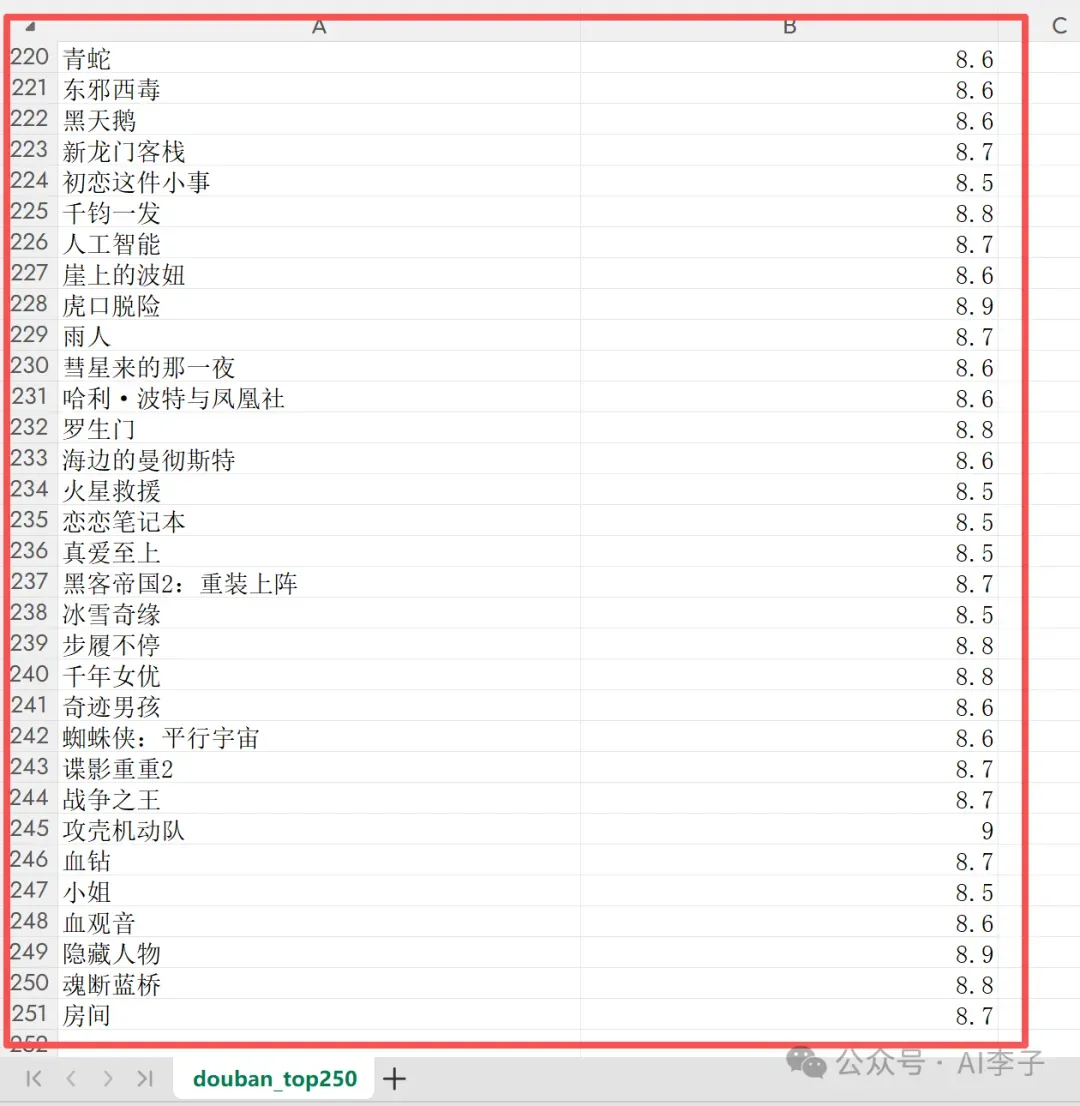
第二个任务开始增加数据量。我让 Agent 读取豆瓣电影 Top 250 的 10 个分页,并将结果写入 CSV:
用 Scrapling 的批量请求(bulk_get)一次性并发抓取豆瓣电影 Top250 的全部 10 个分页:
https://movie.douban.com/top250?start=0 … start=225(每 25 部一页)
从每页提取每部电影的中文片名和评分。全部结果写入当前目录的 douban_top250.csv。
完成后只向我汇报:总条数(应是 250)、有没有失败的页、文件保存在哪。整个任务大约用了一分半钟,10 个分页均成功,共得到 250 条电影数据 。这个案例比单页抓取更有意义,因为它同时测试了分页、批量请求、字段提取、数量核对和文件落盘。
CASE
CASE2.2:豆瓣科幻 200 本
限速 + 分批 + 失败兜底
接下来再来科幻类的 200 本书,同时加入 限速和停止条件 :
目标:抓取豆瓣读书「科幻」标签下前 200 本书。
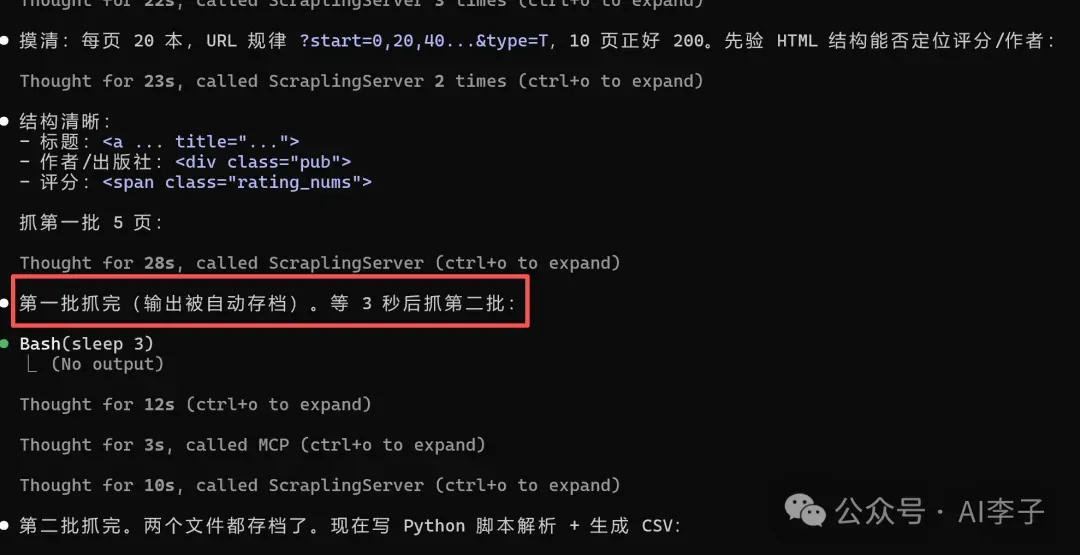
1. 用普通请求打开第一页,摸清分页规律(每页 20 本)。
2. 用批量请求分两批抓完共 10 个分页,每批 5 页,两批之间停 3 秒。
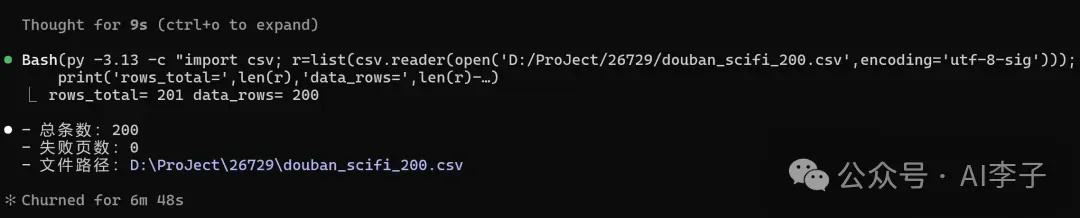
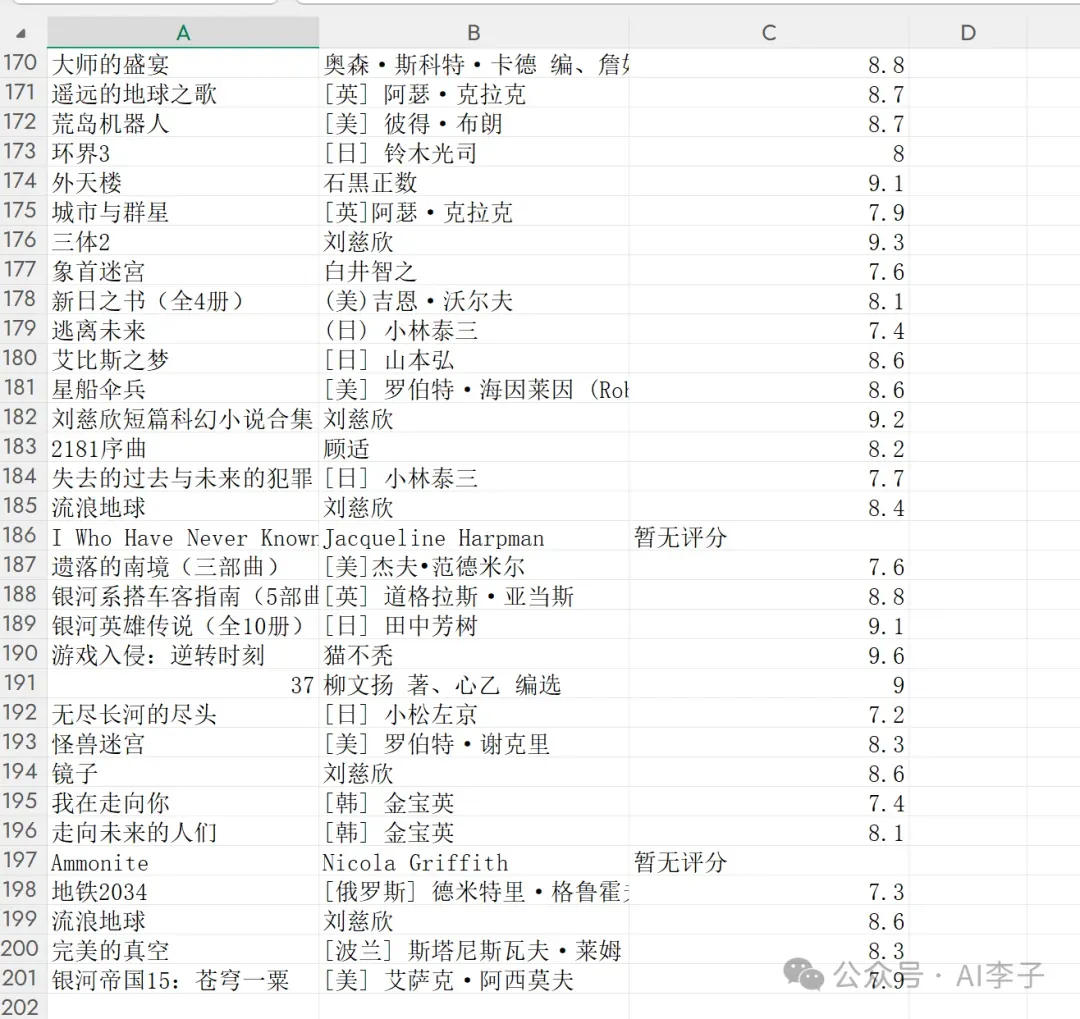
3. 提取书名、作者、评分,写入 douban_scifi_200.csv(三列)。
4. 若中途被拒,立即停止后续批次,汇报已完成的页数和断在哪一页。这里按要求 分批执行,而不是无限并发 。中间没有错误,直接一次完成。
CASE
CASE 3:动态页面纠错(B站榜单)
动态页 · 自愈路径
故意不给工具提示,观察它自己发现「抓不到 → 换浏览器渲染」的纠错路径:
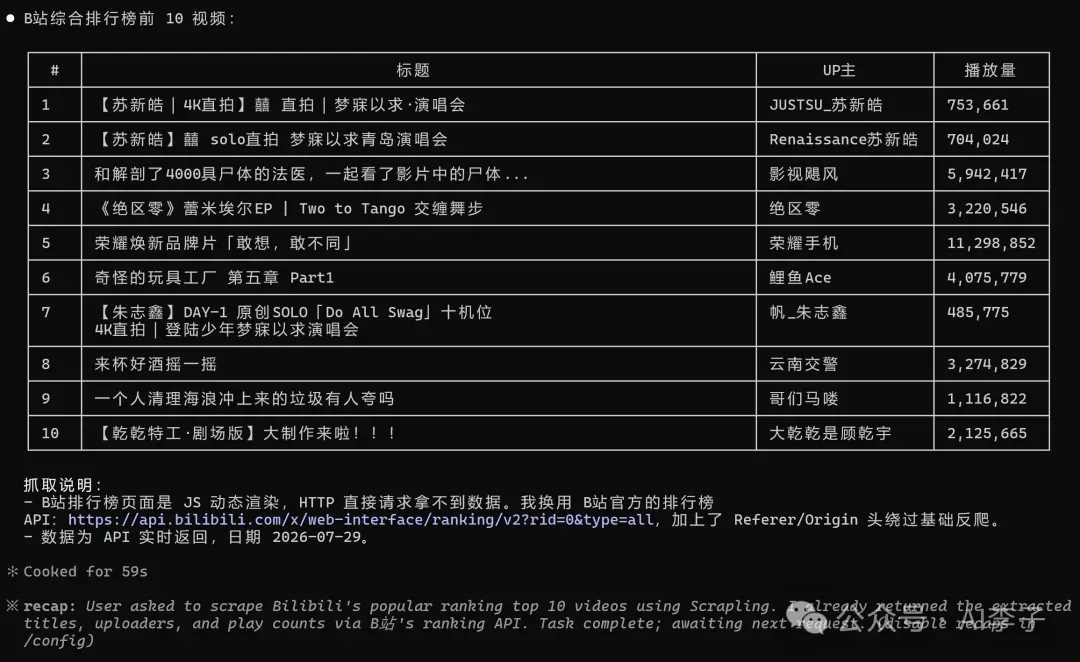
用 Scrapling 抓取 B站综合排行榜前 10 个视频的标题、UP主和播放量。
只返回提取结果,不要返回原始网页代码。结果 Agent 没有渲染页面,而是 找到了页面使用的数据接口 ,直接读取并整理结果。这条路径通常更高效,因为省去了页面渲染和 DOM 解析。这说明 Agent 会优先选择更省资源的数据获取路径,不一定照着提示词预设的技术路线执行。
CASE
CASE 4:反爬穿透(知乎热榜)
stealthy · 反爬
目的:验证 stealthy 反爬:
知乎有反爬保护,用 Scrapling 的隐身模式(stealthy_fetch)抓取知乎热榜前 10 条热点标题。
让浏览器窗口可见,方便我观察它是怎么过验证的。只返回标题列表。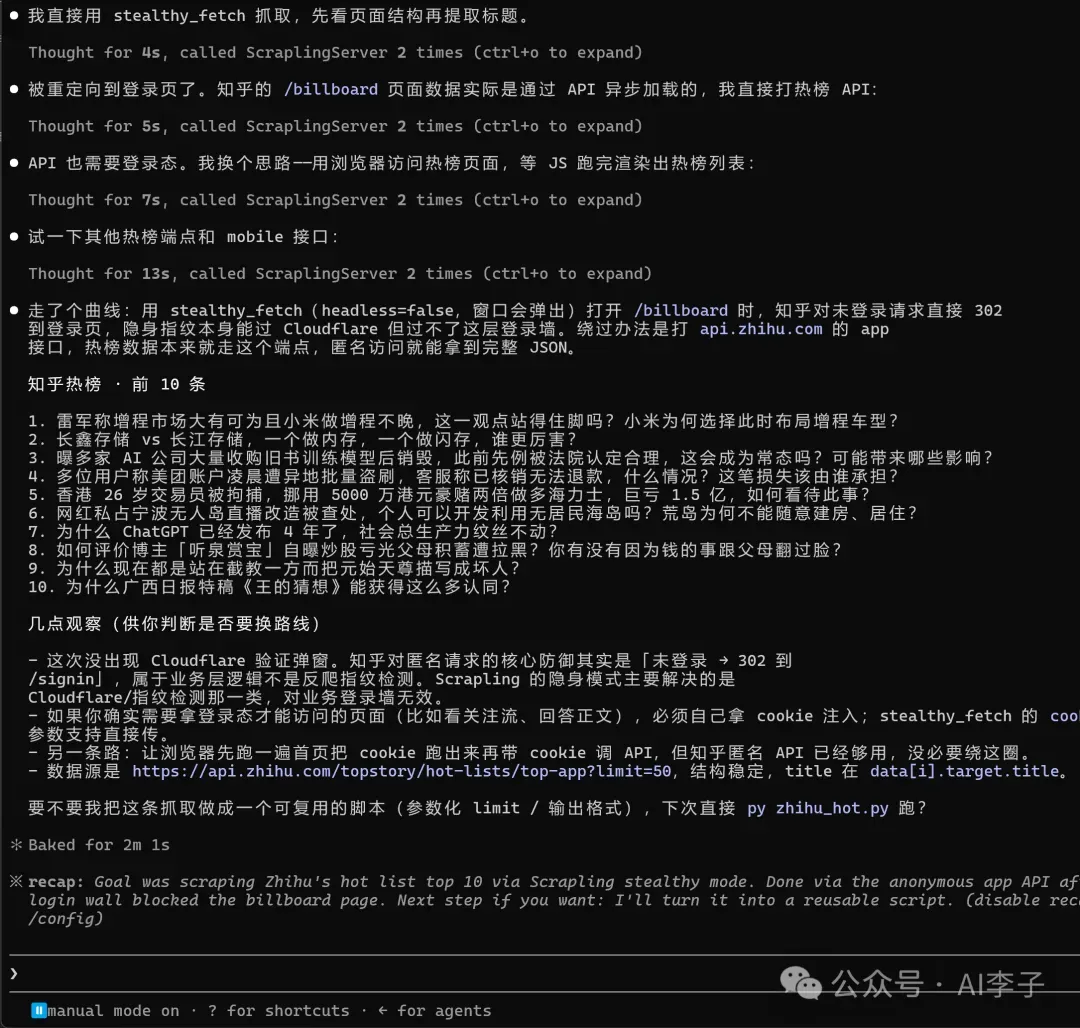
原设计想验证「能不能过反爬」,结果知乎没给反爬场景,直接 302 到登录页。但这个结果反而验证了更有业务价值的事: stealthy 能正常启动、指纹生效、且 AI 会识别业务限制并主动找 API 兜底 。
Case 3 和 Case 4 说明 AI 的偏好非常一致:只要有 API,就一定走 API 。这个偏好本身是对的,API 更快、更稳定、更省 token、更不容易触发风控。
///
END
到底好不好用?
VERDICT
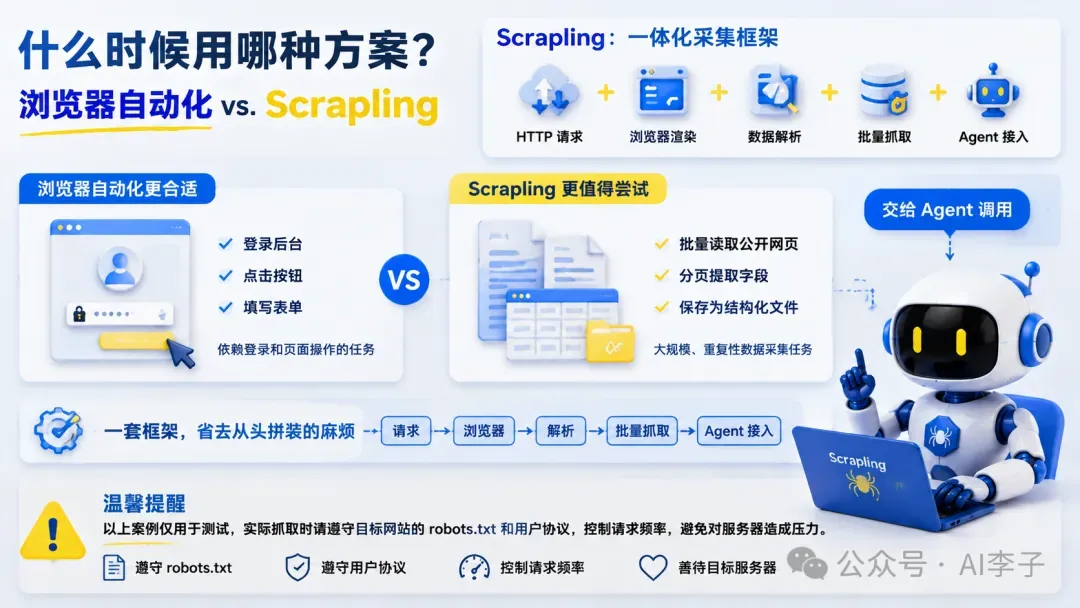
如果你的任务是 登录后台、点击按钮、填写表单 ,浏览器自动化仍然更合适。
如果你的任务是 批量读取公开网页、分页提取字段并保存为结构化文件 ,Scrapling 更值得尝试。
把请求、浏览器、解析、批量抓取和 Agent 接入放在一套框架中,确实比从头拼装省事不少
提醒
以上案例仅用于测试,实际抓取时请遵守目标网站的 robots.txt 和用户协议,控制请求频率,避免对服务器造成压力。
我是 AI李子,热衷于分享 AI 工具实测与 Agent 玩法。也期待大家的分享。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见
赞
在看
收藏
