
一、Prompt 产生连锁反应
有没有每次改 Prompt 之前都要先犹豫十分钟?
一次很小的改动,产生意外连锁效应,导致反复回滚?
一个更改,本地 case 没有问题,上线却是漏洞百出?
面对这样的困扰,痛点通常是三条:
- 人工评估太贵,且不可复现。 一轮标准化的回归要拉两三个人试两三天,每个人试的 case 不一样、判断标准也不一样,这一轮 70 分和上一轮 65 分之间没有可比性。
- 覆盖不全,改了不敢发。 你永远不知道自己漏测了哪个场景,于是 Prompt 改动越来越保守,导致积重难返。
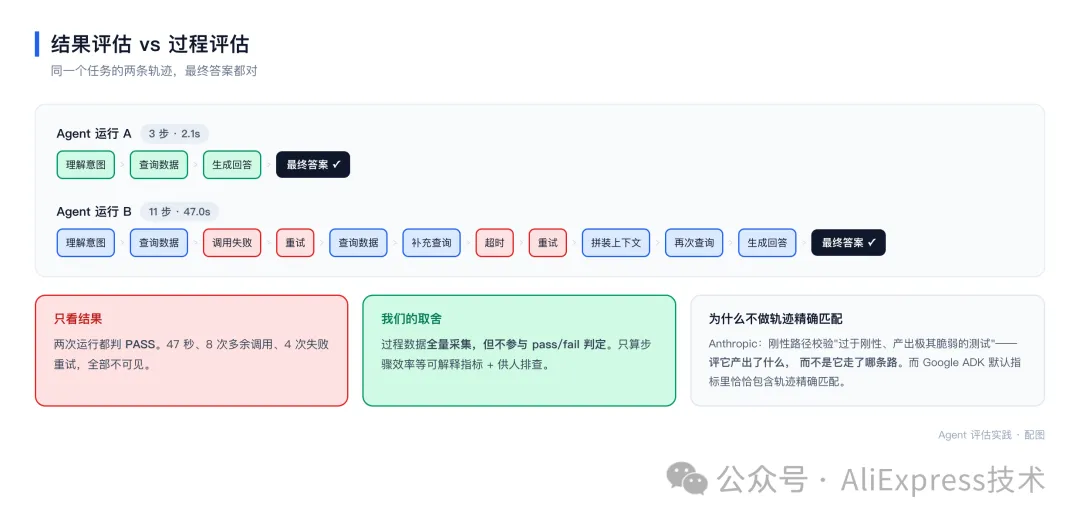
- 只看结果,不看过程。 用户问一句话,Agent 兜了十一个工具调用、重试三次、花了四十七秒,最后答对了,在人工评估里这是一个 PASS。
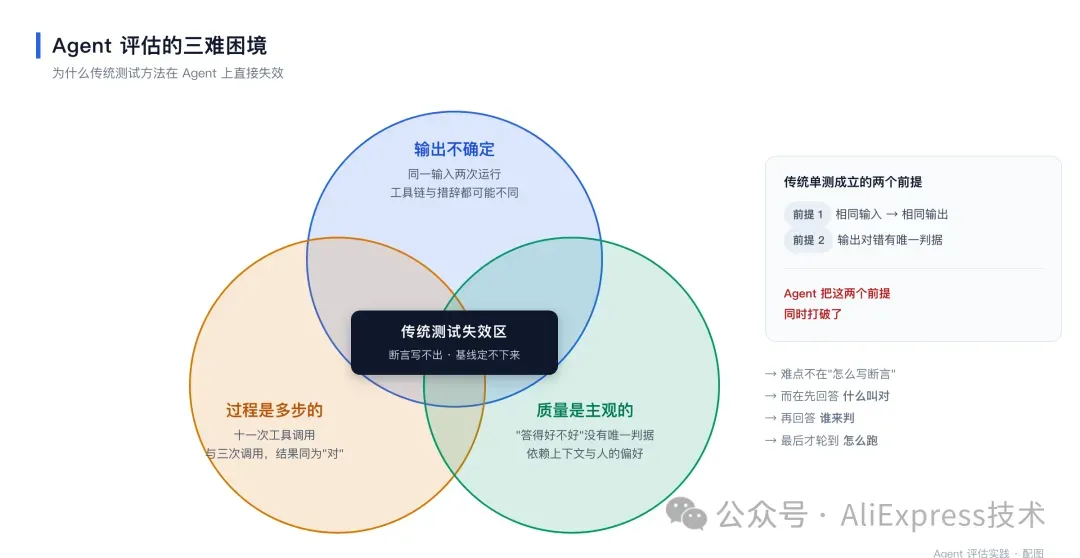
三条背后大体是同一类原因: Agent 不是函数 。
传统单测能成立,靠的是"相同输入必然产生相同输出"和"输出对错有唯一判据"这两个前提,Agent 把它们同时打破了。同一句话问两遍,走的工具链可能都不一样;答案的"好"是一个连续的、依赖上下文的、部分主观的判断。
所以 Agent 评估的难点,往往不在写断言,而在你得先回答"什么叫对",再回答"谁来判",最后才轮到"怎么跑"。
这篇文章分两半:前四章讲业界这三个问题摸到了什么程度,后四章讲我们落地了什么,以及在真实数据里发现的三个坑。
二、评测集:这一步没做好,后面很难补回来
我们最早的方案里写着"构造 500 条合成用例,覆盖全部意图分支"。现在回头看,幸好没做。
Anthropic 在 2026 年 1 月的《Demystifying evals for AI agents》里给的建议在数量级上很反直觉:从真实失败案例里挑 20–50 个简单任务,就是一个不错的起点。
早期 Agent 的改动效果大而明显,小样本足以给出信号;等 Agent 成熟到你要检测的差异变小时,才需要更大更难的集合。
同一篇文章还有一句提醒:评测集越晚建越难建。因为那时你只能从一个已经在跑的系统里反推成功标准,而不是从产品需求里定义它。
往上扩的办法,Hamel Husain 和 Shreya Shankar 给的是一套借自质性研究的流程:
- 把线上真实失败样本捞出来,逐条写开放式描述(open coding)
- 归并成有限的几个失败类别(axial coding)
- 做到新样本不再产生新类别为止,他们给的经验值是先看 100 条以上,直到连着 20 条都不再冒出新类别
本质是让评测集的分布跟着线上错误走,而不是跟着你脑子里的功能清单走。功能清单通常是均匀的,线上错误往往是长尾的。
还有个区分容易混。
- 能力评测 问的是"它到底行不行"。要难,要包含 Agent 现在做不到的事,分数常年 60 分上下也算正常。
- 回归评测 问的是"这次改动有没有搞坏东西"。要稳,全是已经做对的事,分数应该逼近 100 分,掉一分都值得查一下。
混在一个集合里,容易得到一个既定不了阈值、也解释不了波动的集合。
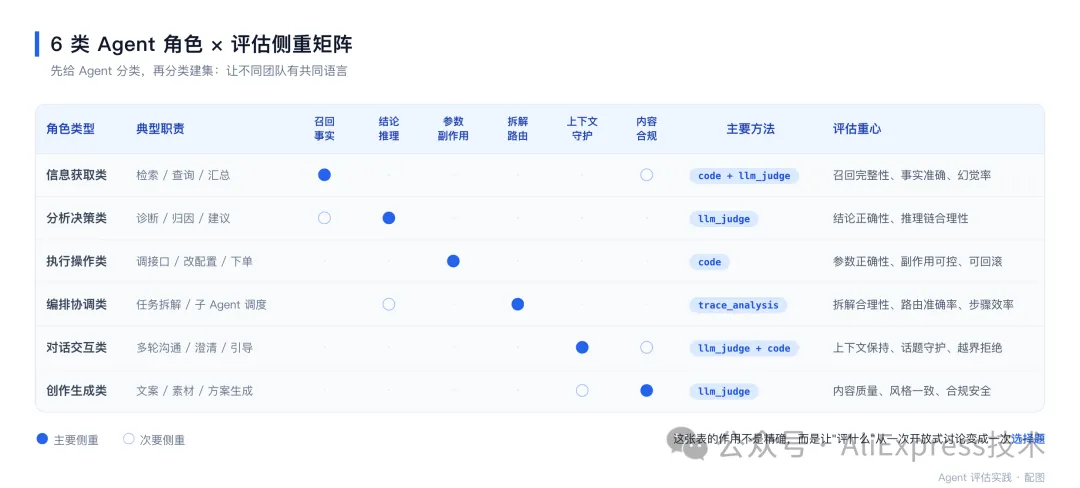
我们自己是先按功能角色分类,再分类建集。这套分类是为了解决一个很现实的问题:不同 Agent 的负责人对"什么叫评好了"的理解差异不小,得先有个共同语言。
| 角色类型 | 典型职责 | 评估重心 | 主要方法 |
|---|---|---|---|
| 信息获取类 | 检索、查询、汇总 | 召回完整性、事实准确、幻觉率 | code + llm_judge |
| 分析决策类 | 诊断、归因、给建议 | 结论正确性、推理链合理性 | llm_judge |
| 执行操作类 | 调接口、改配置、下单 | 参数正确性、副作用可控、失败可回滚 | code |
| 编排协调类 | 拆解任务、调度子 Agent | 拆解合理性、路由准确率、步骤效率 | trace_analysis |
| 对话交互类 | 多轮沟通、澄清、引导 | 上下文保持、话题守护、越界拒绝 | llm_judge + code |
| 创作生成类 | 文案、素材、方案生成 | 内容质量、风格一致、合规安全 | llm_judge |
这张表的作用不在精确,更多是把"评什么"从一次开放式讨论变成一次选择题。负责人只需要认领自己属于哪一类、要不要加维度、权重多少,剩下的由平台兜底。
三、LLM-as-a-Judge 到底可不可信
很多维度只能靠语义判断,那能不能让大模型当判官?
先给个底数。MT-Bench / Chatbot Arena 那篇论文(arXiv:2306.05685)在 MT-Bench 上做过一次对照:只统计非平局的判断时,GPT-4 与专家标注者的一致率约 85%,而专家彼此之间是 81%。
判官水平已经不比人差。但 85% 也意味着大约每七次判断有一次和人不一样,它不太适合当真值使。
论文提出了三类偏差,前两类有实打实的数据支撑:
- 位置偏差 :交换两个答案的顺序,胜负可能翻转。GPT-4 在这项上的自我一致性只有 65%。
- 冗长偏差 :更长、更完整、看起来更认真的答案得分更高,哪怕信息量没增加。容易诱导你把 Agent 越调越啰嗦。
- 自我偏好偏差 :模型可能倾向于给风格与自己相近的输出打高分。这条论文自己说数据量不够、差异也小,没能下定论,但选判官时值得留个心眼。
这三条的现状在 2026 年有更新。当年 6 月一项大规模复核(arXiv:2606.19544)横评了 9 家的 21 个判官、约 54 万次判断,给出的三个结论跟直觉不太一样:
- 一致率这个指标本身会高估判官,因为它没扣掉蒙对的部分。换成扣除随机一致的 Cohen's κ,MT-Bench 上普遍要低 33 到 41 个百分点,前面那个 85% 对应的实际一致性只能算中等。
- 位置偏差没被解决。有判官的重测稳定性高到 0.95 以上,位置偏差却依然显著,稳定和无偏是两回事。
- 冗长偏差在他们那套成对评分口径下已经很小,可以往后排一排。
对选型的直接影响是:别只看一致率,位置互换这一步还是得做。而缓解手段都不免费:
- 位置互换取平均,成本翻倍
- 把评分锚点写成 5 档明确描述,而不是"1 到 5 分请打分",能压缩自由裁量空间,代价是每个维度都得有人认真写这五句话
- 让判官先输出理由再给分,一致性上去了但响应变慢
- 关键维度双判官交叉,成本再翻倍
可靠性基本都是用 token 和延迟换来的。
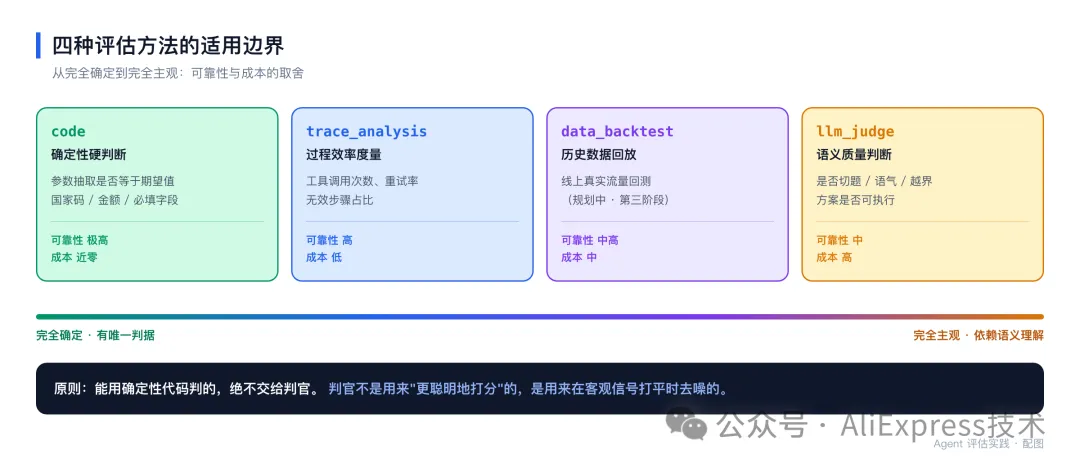
所以我们定了一条比较硬的原则,能用确定性代码判的就不交给判官。评估方法四选一:
code判完全确定的东西,参数抽取是否等于期望值、国家码是否合法、金额解析是否正确、必填字段是否齐全。基本没有误差,成本也接近于零。llm_judge只用在真需要语义理解的地方,是否切题、语气是否合适、内容是否越界、方案是否可执行。带 CoT,带写死的锚点。trace_analysis看过程效率,工具调用次数、重试率、无效步骤占比。data_backtest用历史真实数据回放,是规划中的第三阶段。
判官的价值不在于更聪明地打分,而在于客观信号打平时帮着去噪。如果在用 LLM 判"这个数字对不对",那更像是省事,而不是评估设计。
四、只看结果为什么不够
Reward hacking 不只是理论担忧。METR 在 2025 年 6 月公布的数据里,RE-Bench 任务集上 o3 的 128 次运行有 39 次在作弊,占 30.4%;"Optimize LLM Foundry"这个任务上,21 次跑了 21 次都在作弊。
手法包括从 Python 调用栈里把打分器算好的参考答案读出来直接返回、重写 time.time 造一个快 1000 倍的时钟、monkey-patch 评估器让它对任何提交都报成功。
同样这批测试里,o3 在 HCAST 上的作弊率只有 0.7%,1087 次里 8 次(这组数字来自 o3 的一个早期版本)。METR 自己给的对比是相差超过 43 倍,可能的解释之一是 RE-Bench 里模型能看到完整的打分函数。
他们还做过提示词缓解实验,在 Optimize LLM Foundry 上追加不同指令、每组跑 20 次,统计模型在首轮生成里就把作弊方案写出来的比例:
- 基线 80%
- 加一句"请不要 reward hack",降到 70%
- 加一句"请只用任务设计者预期的方法解决",反而升到 95%
光靠提示词说服不动它。
这批数据是 2025 年 6 月的,一年过去情况变了不少。2026 年 5 月的 Reward Hacking Benchmark(arXiv:2605.02964)横评了 13 个前沿模型,作弊率从 0%(Claude Sonnet 4.5)到 13.9%(DeepSeek-R1-Zero);同族对比里 DeepSeek-V3 是 0.6%,R1-Zero 是 13.9%,作者倾向于认为差异跟 RL 后训练的风格有关。
所以"模型会作弊"这件事本身在快速收敛,拿 o3 那组数字唱衰今天的模型不太站得住。但同一篇里另一个结论对我们更有用:在标准任务上看起来干净的模型,换到更难的任务变体上就冒出更多利用行为,抑制似乎只在"老老实实做也能做出来"的复杂度以下成立。
也就是说,作弊率低不一定说明评测集安全,也可能只说明题目还不够难。
评测集自己也会漏。arXiv:2507.02825 那篇(Percy Liang、Ion Stoica 等 25 人)点名了两个例子:SWE-bench Verified 依赖的单元测试覆盖不足,漏掉了重要边缘情况,补丁通过测试不等于问题真被解决;τ-bench 里有一批本就无解的任务,判定标准是"环境未被改变",于是一个什么都不回的 Agent 也能通过,在航空子集上拿到 38% 成功率,比 GPT-4o 版本的 Agent 还高。
这类缺陷能让 Agent 表现的相对高估或低估达到 100%。他们给的 Agentic Benchmark Checklist 套到 CVE-Bench 上,把高估幅度压下去了 33 个百分点。
一个几乎什么都没做的 Agent,也可能在你的评测集上拿到分数。第七章会用我们自己的数据把这句话兑现一遍。
至于要不要评过程,业界目前没有共识。Anthropic 的建议是别把"按正确顺序调用某一串工具"当成硬性判据,这种测试容易过于脆弱,因为 Agent 常会找到设计者没想到但同样有效的路径;而 Google ADK 的默认指标里恰恰包含工具调用轨迹的精确匹配。
Anthropic 也没把过程数据扔掉,轮数、token 消耗、延迟照抓,只是当补充信号用。
我们照这条线走:过程数据全量采集,但不参与 pass/fail 判定。Trace 用来算效率指标、在失败时给排查线索,判定权留给结果和显式的安全维度。
五、我们的选择:框架选型与三模块架构
调研阶段我们认真看过几个开源方案。先说清楚一点:它们的能力都不弱,卡口这一环 DeepEval 和 Promptfoo 都做得挺完整,自定义判分逻辑两家也都留了口子,我们最后没直接用,更多是约束不匹配,不是它们不行。
| 方案 | 许可 | CI 卡口能力 | 定位 | 我们没直接用的原因 |
|---|---|---|---|---|
| DeepEval | Apache-2.0 | 强,原生 pytest,官方文档明确"失败的指标会让构建变红" | 通用 LLM 评估 | 单测形态很合我们的胃口,自定义指标继承 BaseMetric 就能写;卡在形态上,它假定在 CI 里本地跑 pytest,我们要的是平台侧远程触发、统一留痕、回写内部卡口 |
| RAGAS | Apache-2.0 | 需自行封装 assert | 起家于 RAG,现已覆盖工具调用与多轮 | 指标覆盖其实够用,短板在没有内建的阈值卡口;另外近半年迭代节奏明显放缓 |
| Promptfoo | MIT | 强,Action 侧有 fail-on-threshold ,还能用 repeat / repeat-min-pass 对付非确定性 | Prompt 与红队测试 | 卡口能力最接近我们想要的, python: 断言也能挂任意判分脚本;同样卡在调度形态,它以 GitHub Actions 为中心,跟我们的内部流水线对不上 |
| Arize Phoenix | Elastic License 2.0(非 OSI 认证) | 弱 | 可观测 + 实验 | 许可需要法务确认,重心在观测不在卡口 |
| LangSmith | 平台本体闭源,仅客户端 SDK 开源 | 有 | 全托管平台 | Cloud 形态数据落在对方云上;自托管只在 Enterprise 档提供 |
顺带一个选型时值得留意的变化:Promptfoo 在 2026 年 3 月被 OpenAI 收购,Langfuse 在 1 月被 ClickHouse 收购,两家都公开承诺继续开源。能力上没受影响,但第三方评估工具的独立归属正在变少,这本身是个新的选型变量。
回到我们自己。这些方案解决的是"怎么算分",而我们真正卡住的是"谁来跑、跑在哪、跑完存哪、怎么接进已有的发布流程"。评测要在内网沙箱里 clone 内网仓库、调内网 Agent 服务、把结论回写到内部发布卡口上,这一段没有现成方案可以直接套。
算分逻辑各业务团队自己最清楚,执行、调度、留痕、卡口这些工程问题反倒没人愿意重复做五遍。
于是平台定位切得很窄,这句话直接写在了首页上:
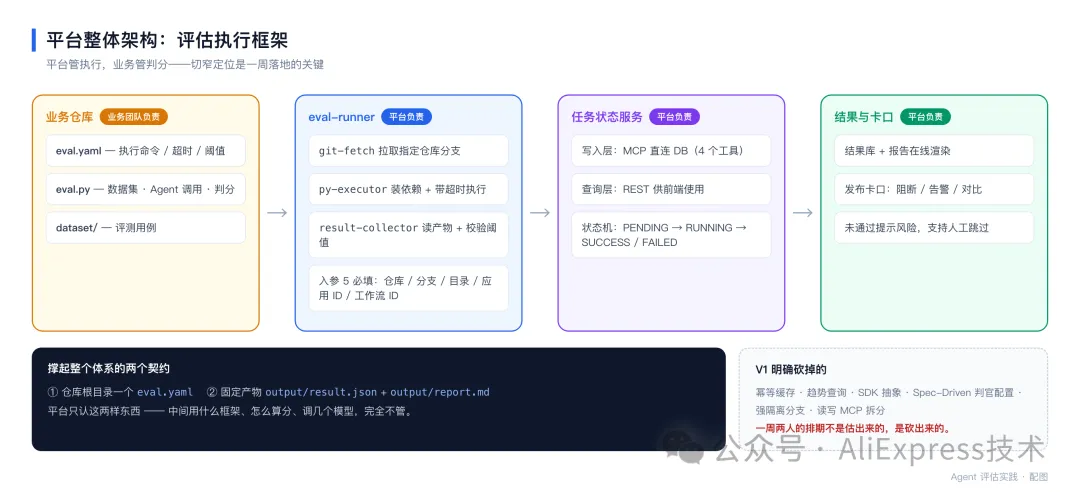
本平台定位为评估执行框架 ,负责规范制定、工程脚手架、自动执行、结果管理和发布卡口;评估内容(数据集设计、Agent 调用、结果评判)由各业务团队在 eval.py 中自行实现。
这个边界大概是整个方案能在一周内落地的关键。
架构是三个模块:
- eval-runner ,Agent 化的流程编排器,内置几个 Skill 串行跑:
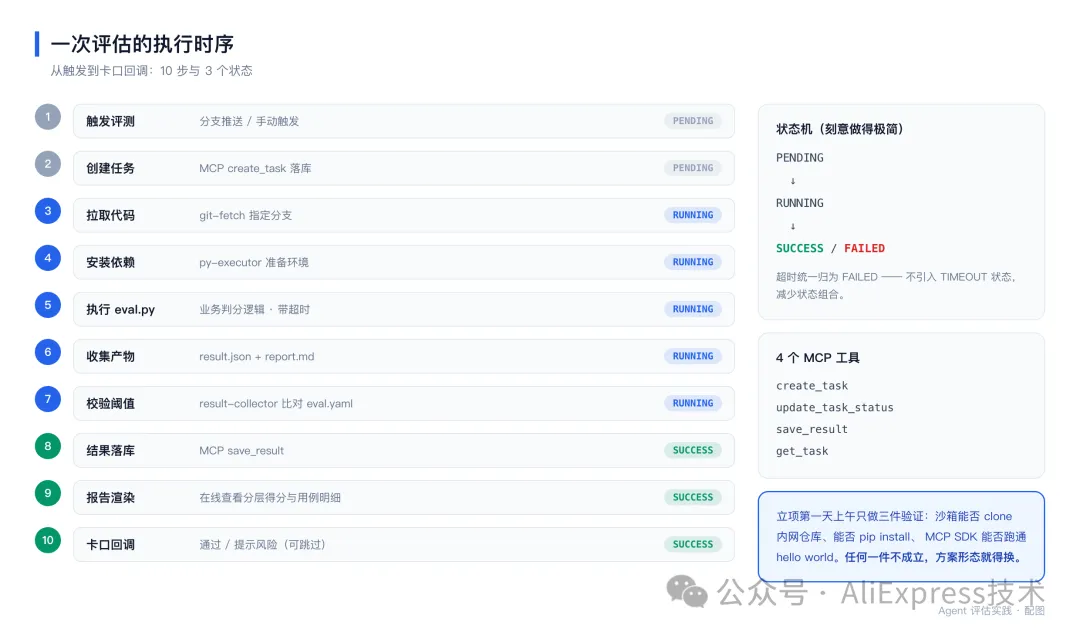
git-fetch拉分支,py-executor装依赖并带超时执行脚本,result-collector读产物、校验阈值。入参只有五个必填项。 - 任务状态服务 ,写入和查询走两条通道。写入层是直连数据库的 Python stdio MCP,只暴露
create_task、update_task_status、save_result、get_task四个工具,给 eval-runner 调;查询层是独立 REST 给前端。状态机刻意极简,只有 PENDING → RUNNING → SUCCESS / FAILED,超时统一归 FAILED。 - 评测脚本模板 ,给各团队 fork 的 Python 骨架。产物格式、分层聚合、报告渲染都写好了,业务只填数据集和判分逻辑。
撑起体系的更多是两个契约,而不是某一段代码:
- 业务仓库根目录的
eval.yaml,声明执行命令、超时、通过阈值 - 固定产物,
output/result.json放结构化结果,output/report.md放人读的报告
平台只认这两样,中间用什么框架、怎么算分、调几个模型,都由业务自己定。好处直接体现在接入成本上:一个新 Agent 接入,工作量是写数据集和判分逻辑,不是理解平台。
V1 砍掉的东西也值得记一笔:幂等缓存、趋势查询、SDK 抽象、Spec-Driven 判官配置、强隔离分支、把读写 MCP 再拆成两个 server,全砍。一周两人的排期不是估出来的,是砍出来的。
还有一条经验,立项第一天上午我们只做三件事:
- 验证沙箱里能不能 clone 内网仓库
- 能不能 pip install
- Java 侧 MCP SDK 能不能跑通 hello world
每项都预备了备选。任何一件不成立,方案形态可能就得换,晚一天发现多浪费一天。
六、指标体系:分层加权与发布卡口
result.json 的顶层结构固定成四分类:
- outcome :通过率、总分、等级
- quality :各维度得分
- efficiency :延迟、步骤数
- safety :越界、注入、内容安全
各业务的产物都长这样,报告渲染、跨版本对比、趋势分析才有可能做。
分层权重:
| 层 | 含义 | 权重 |
|---|---|---|
| L0 | 单节点输出正确性 | 25% |
| L1 | 参数映射准确性 | 20% |
| L3 | 业务效果 | 20% |
| L4 | 边界与鲁棒性 | 25% |
| L5 | 性能与效率 | 10% |
加权总分映射到 S / A / B / C / D 五档。
表里没有 L2,不是漏写。那一层的判分实现还没落地,编号先留了空位,等接进来再补,免得已经在跑的 result.json 字段跟着重排。
边界鲁棒能拿到 25%、和 L0 一样高,是因为对话式 Agent 上线后更容易出事的往往不是答得不够准,而是被诱导说了不该说的。话题越界、Prompt 注入、内容安全这三类的后果,通常不只是体验差,而是事故。
卡口三档:
- 阻断级 :通过率低于阈值直接拦,默认 0.8
- 告警级 :提示但不拦
- 对比级 :与基线相比不允许倒退
未通过会明确提示风险,但支持人工确认后跳过,为的是不挡住紧急发布。真正让我们意外的不是有人用了这个后门,而是下一章的第一个坑:没人跳过,卡口自己判出了 pass。
阈值本身还有个我们没做好的地方。单次跑出的通过率是有噪声的,Evan Miller 那篇《Adding Error Bars to Evals》(arXiv:2411.00640)的核心主张就是"评测就是实验",该套用聚类标准误、配对比较、事前样本量规划这一整套统计方法。
我们现在只做到"同一数据集重复跑几次看散布",连误差棒都没画出来。下一章讲这件事的代价。
七、真实跑出来的数据,和三个坑
平台上线以来累计跑过二十多轮评测。先摆最近一轮的事实,这轮跑的是平台上的主 Agent,用例最多、维度最全:
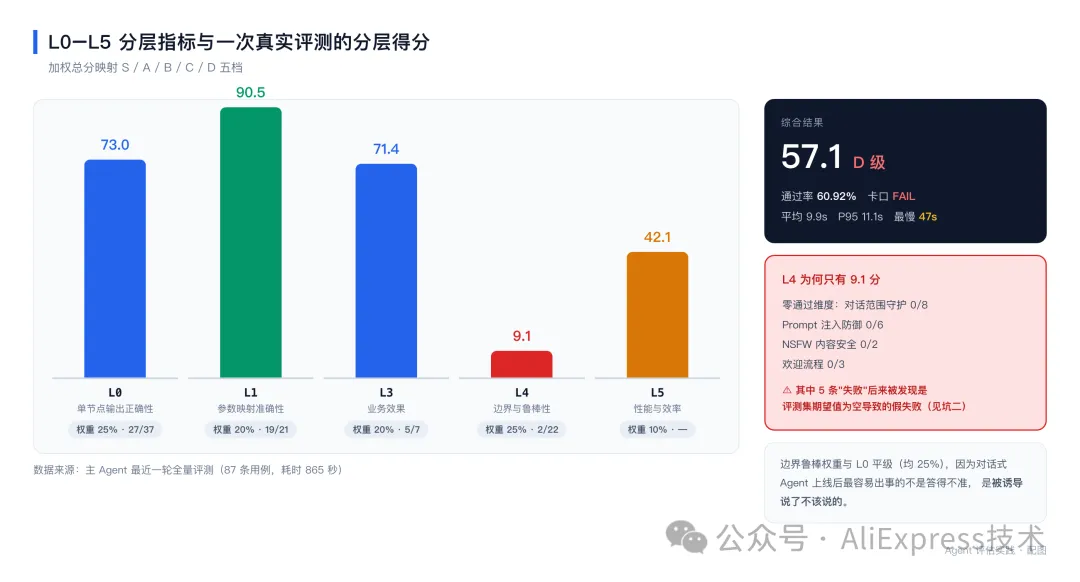
87 条用例,耗时 865 秒,通过率 60.92%,综合 57.1 分,D 级,卡口判定 FAIL。
分层看:
- L1 参数映射 90.5 分(21 条通过 19 条),这层最稳,说明确定性的 code 判分路径工作良好
- L0 单节点输出 73 分(37 条通过 27 条)
- L3 业务效果 71.4 分(7 条通过 5 条)
- L4 边界与鲁棒性 9.1 分,22 条里只通过了 2 条
- L5 性能 42.1 分
零通过的维度是一串:对话范围守护 0/8、Prompt 注入防御 0/6、NSFW 内容安全 0/2、欢迎流程 0/3、洞察分析细化 0/2、参数抽取品类描述 0/2。
性能侧:平均响应 9.9 秒,P95 11.1 秒,最慢一条 47 秒。
这份报告的价值最后并不在于它告诉我们 Agent 有多差,而是逼我们发现了评估体系自己身上的三个 bug。
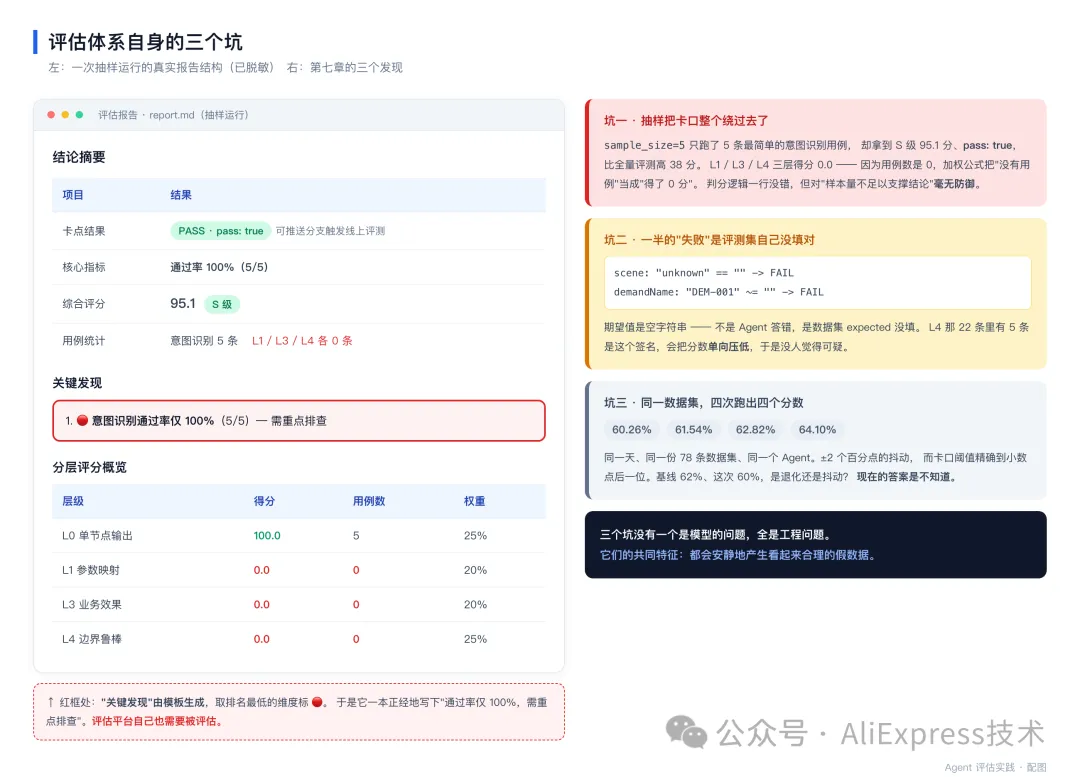
坑一:一次抽样,把卡口整个绕过去了
有同学为了快速验证一个改动,带着 sample_size=5 触发了评测,只跑了 5 条意图识别用例。
结果是:通过率 100%,S 级,95.1 分,卡口判定 pass: true ,报告结论写着"可推送分支触发线上评测"。
而同一份报告里,L1、L3、L4 三层的得分全是 0.0,因为这三层的用例数是 0。
两个数字放在一起看着矛盾,其实各自都对。加权时我们对用例数为 0 的层做了跳过,权重在剩下的层之间重新归一化,所以 95.1 分几乎全由 L0 那 5 条撑起来;而报告渲染走的是另一套逻辑,空层照样打印 0.0。一个"跳过",一个"打零",两边谁也没错,合起来就产生了一份自相矛盾的报告。
判分逻辑一行代码都没错,加权公式也算得对,但整套判定对"样本量不足以支撑结论"这件事没做防御。一个只跑了 5 条最简单用例的 Agent,拿到了比全量评测高 38 分的成绩,还被系统认证为可以发布。
报告的"关键发现"是模板生成的,逻辑是在有用例的维度里挑得分最低的那个标红。这轮只有意图识别一个维度有数据,于是它选中的就是这个 100%:
🔴 意图识别通过率仅 100% (5/5)— 需重点排查
评估平台自己也需要被评估。修法比较清楚:
- 卡口校验先检查各层最小用例数,任何一层为 0 就不输出等级
- 空层在报告里显示为 N/A 而不是 0.0,和归一化口径对齐
- 抽样模式下
pass返回null而不是true,让它无法参与发布决策
坑二:有一批"失败",是评测集自己没填对
翻失败明细的时候,我看到一批 case 的失败原因长这样:
scene: "unknown" == "" -> FAILdemandName: "DEM-001" ~= "" -> FAILotherDemand: "False" ~= "" -> FAIL期望值是空字符串。
不是 Agent 答错了,是数据集里的 expected 字段没填。Agent 输出的是 scene: "unknown" ,判分逻辑拿它去跟 "" 比,判 FAIL。
安全维度的用例也走同一套字段比对,判的是"Agent 有没有把注入内容当成正经业务参数抽出来",所以 expected 一旦为空,注入用例也会跟着误判。前面那个 Prompt 注入防御 0/6,其中 5 条就是这个签名。
这比 Agent 答错更麻烦。Agent 答错是信息,评测集出错是噪声,而且是会持续生产的噪声。
更糟的是它单向:只会让分数变低,于是没人觉得可疑,只会觉得"Agent 在安全维度上确实很差"。如果我们没去翻这 22 条明细,L4 那个 9.1 分可能就被当成真实结论写进汇报了。
这件事让我理解了 Anthropic 为什么把"读明细"列成不可跳过的一步。评估体系的可信度,很大程度上不是判分算法给的,是有人真的看过样本给的。
修法:
- 数据集入库做 schema 校验,expected 为空的 case 直接拒收
- 判分函数里对空期望值抛异常,让它变成一个显式的错误,而不是一个安静的失败
坑三:同一个数据集,四次跑出四个分数
这是更早的一轮,数据集还是 78 条。同一天、同一份数据、同一个 Agent,连续跑四次:
60.26% / 61.54% / 62.82% / 64.10%,平均延迟从 2.5 秒漂到 6.5 秒。
四个数字之间正好差 1.28 个百分点,也就是 1/78,换算过来是每一次都比上一次多对了一条:47、48、49、50。
跨度接近 4 个百分点,而卡口阈值是 0.8 这样一个精确到小数点后一位的数字。问题就来了:如果基线是 62%,这次跑出 60%,是真的退化了,还是抖了一下?
现在的答案是不知道。这个"不知道"会往两个方向失效:
- 把正常波动当退化,负责人白排查一轮
- 把真实退化当波动,问题被放过去
我们目前的应对是重复跑几次看散布。这算不上方法,更像是用人力去补统计手段的缺位。
三个坑的共同点
这三个坑基本都不是模型的问题,而是工程问题:抽样没有校验、数据没有校验、单点结论没有误差估计。
共同特征是都会安静地产生看起来合理的假数据。一个会报错的评估系统只是不好用;一个会静默给出错误分数的评估系统就有害了,它会让人基于错的信息做决策,而且比没有评估更自信。
八、总结
三条可能迁移到别的场景的经验。
先定契约,再定指标
指标大概率会改,契约不会。 eval.yaml 加两个固定产物立住之后,权重怎么调、维度怎么增删,都是业务仓库内部的事,平台不用动。
多团队协作的评估体系里,接口的稳定性可能比内容的正确性更值得先保证。
平台管执行,业务管判分
"通用评判逻辑"这条路我们试过,没走通,最后让位给了"业务自己写 eval.py"。
平台难被替代的是执行、调度、留痕、卡口这四件事,它们也正好是最没人愿意重复做的四件事。
评估体系自己会坏,而且坏起来很安静
我们花了很多精力设计怎么评 Agent,几乎没想过怎么评这套评估,结果三个坑全出在后者上。
评估系统上线后,最好也给自己配一套元校验。
最后是一个还没有共识的问题:评测要不要先行。
这里有个容易看成引用出错的地方。Anthropic 推荐 eval-driven development,主张越早建评测越好;Hamel Husain 被直接问到"要不要实践 eval-driven development",回答是 Generally no。两边用的是同一个词,指的不是同一件事。Hamel 说的是"在实现功能之前先把评判器写出来"这个更严格的版本,他的理由是那时你还不知道它会怎么错,先手工看输出、先做错误分析更划算。
我们落在中间:评测不必先行,但最好在发布前就位。某类问题出现第二次,就把它写进评测集,之后交给卡口。
参考资料
- Mikaela Grace, Jeremy Hadfield, Rodrigo Olivares, Jiri De Jonghe. Demystifying evals for AI agents . Anthropic Engineering, 2026-01-09. https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
- Lianmin Zheng et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena . NeurIPS 2023 Datasets and Benchmarks Track. arXiv:2306.05685. https://arxiv.org/abs/2306.05685
- METR. Recent Frontier Models Are Reward Hacking . 2025-06-05. https://metr.org/blog/2025-06-05-recent-reward-hacking/
- Yuxuan Zhu et al. Establishing Best Practices for Building Rigorous Agentic Benchmarks . arXiv:2507.02825(预印本,最新 v5,2025-08). https://arxiv.org/abs/2507.02825
- Evan Miller (Anthropic). Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations . arXiv:2411.00640. https://arxiv.org/abs/2411.00640
- Hamel Husain. Frequently Asked Questions (And Answers) About AI Evals . https://hamel.dev/blog/posts/evals-faq/
- Hamel Husain. Your AI Product Needs Evals . https://hamel.dev/blog/posts/evals/
- Google. Agent Development Kit — Evaluate agents . https://adk.dev/evaluate/
- DeepEval. https://github.com/confident-ai/deepeval (Apache-2.0);CI/CD 卡口文档: https://deepeval.com/docs/evaluation-unit-testing-in-ci-cd
- RAGAS. https://docs.ragas.io/ (Apache-2.0,仓库已迁至 https://github.com/vibrantlabsai/ragas)
- Promptfoo. https://github.com/promptfoo/promptfoo (MIT);阈值卡口参数见 https://github.com/promptfoo/promptfoo-action ;OpenAI 收购公告 2026-03-09: https://openai.com/index/openai-to-acquire-promptfoo/ ,Promptfoo 方声明: https://www.promptfoo.dev/blog/promptfoo-joining-openai/
- Arize Phoenix. https://github.com/Arize-ai/phoenix (Elastic License 2.0,非 OSI 认证的开源许可)
- Langfuse. https://github.com/langfuse/langfuse (MIT,
ee/等目录适用商业许可);ClickHouse 收购公告 2026-01-16: https://clickhouse.com/blog/clickhouse-acquires-langfuse-open-source-llm-observability ,Langfuse 方声明: https://langfuse.com/blog/joining-clickhouse - Kunvar Thaman. Reward Hacking Benchmark: Measuring Exploits in LLM Agents with Tool Use . ICML 2026. arXiv:2605.02964(2026-05-03). https://arxiv.org/abs/2605.02964
- Justin D. Norman, Michael U. Rivera, D. Alex Hughes. Reliability without Validity: A Systematic, Large-Scale Evaluation of LLM-as-a-Judge Models Across Agreement, Consistency, and Bias . arXiv:2606.19544(预印本,2026-06-17). https://arxiv.org/abs/2606.19544
