
做 AI / ML 并不需要数学博士学位。你只需要掌握足够的线性代数,这样在打开论文或 PyTorch 文档时,不会总觉得自己在迷雾里打转。这份路线图会按正确顺序告诉你该学什么,以及为什么它重要。
我们直接开始。
为什么偏偏是线性代数?
在开始罗列知识点之前,我先解释一下,为什么这门课在 ML 里这么重要。
机器学习里的一切,本质上都是数字。图像是数字网格。文本在 tokenization 之后会变成数字。音频则是一串按时间采样得到的数字。当你把所有数据都转成数字之后,你就需要一套方法来:
- 高效存储这些数字
- 对它们执行快速运算
- 把它们从一种形式变换成另一种形式
线性代数本身就是完成这三件事的语言。神经网络?本质上就是矩阵乘法,再撒上一点非线性函数。主成分分析?本质是特征向量。推荐系统?本质是矩阵分解。词向量?本质是高维空间中的向量。
你绕不开它。
但你完全可以理解它。
继续往下。
Phase 1:绝对基础
这是所有人都应该开始的地方,就算你觉得自己已经会了也一样。相信我,回来重新过一遍。
1. 标量、向量、矩阵、张量
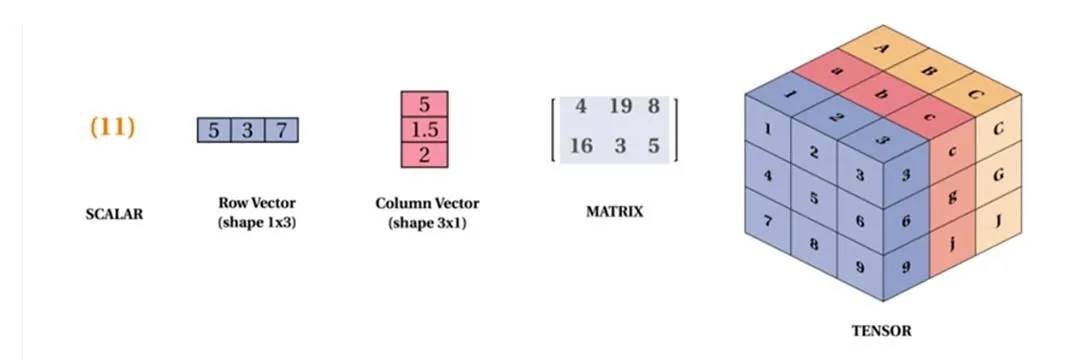
先从这里开始,理解它们的层级关系。
- 标量 就是一个数字,比如 5 或 3.14。
- 向量 是一串数字,比如
[2, 4, 7]。 - 矩阵 是一个二维数字网格,本质上就是行和列。
- 张量 是更一般化的形式,可以是 3D、4D 甚至更高维。在深度学习里,一批图像通常就是 4D 张量(batch、channel、height、width)。
为什么这很重要:你写的每一个 PyTorch 或 TensorFlow 程序都会用到这些。如果你不知道自己数据的 shape,你会在 debug 上浪费大量时间。
2. 向量运算
你要学会:
- 两个向量相加
- 向量与标量相乘
- 求向量的长度,也就是 magnitude 或 norm
- 理解它的几何意义,也就是向量在空间中指向某个方向
norm 这个概念会一遍又一遍出现。L1 norm、L2 norm,它们会出现在 regularization 和 loss function 里。
3. 点积
这一项非常关键。点积告诉你两个向量有多相似。它是 cosine similarity 的基础,而 cosine similarity 从搜索引擎、推荐系统,到 Transformer 里的 attention,几乎无处不在。
练到你闭着眼都能算点积。
4. 矩阵运算
- 矩阵加法
- 矩阵上的标量乘法
- 矩阵乘法(这一项最关键)
- 矩阵转置
矩阵乘法不是逐元素乘法。这里会卡住非常多初学者。你应该在这部分多花点时间。真正理解为什么维度必须匹配,也就是为什么 (m x n) 乘 (n x p) 才能得到 (m x p)。
Phase 2:你真正会用到的构件
现在我们进入那些会在真实 ML 代码里出现的东西。
5. 特殊矩阵
下面这些名字要认识:
- 单位矩阵:矩阵世界里的数字 1
- 对角矩阵:只有主对角线有值,其余位置都是 0
- 对称矩阵:等于它自己的转置
- 正交矩阵:它的转置等于它的逆
你会在 covariance matrices、attention masks 和旋转操作里不断看到它们。
6. 矩阵逆
不是每个矩阵都有逆。没有逆的矩阵叫 singular matrix。在 ML 里,我们很少直接去算逆,因为它又慢又不稳定。但理解这个概念,可以帮你读懂论文里的公式。
你需要知道 determinant 是什么,以及为什么 determinant 为 0 意味着没有逆。
7. 线性无关与秩
如果你有一组向量,其中有些向量本质上只是别的向量的重复表达,那这就是线性无关要回答的问题。矩阵的 rank 则告诉你,它到底有多少个真正独立的方向。
这在 PCA 中很重要,也会帮助你理解人们常说的那句“数据位于一个更低维的流形上”。rank 就藏在这句听起来很高级的话背后。
8. Span、Basis 和 Subspaces
你可以把 basis 理解成:描述一个空间所需的最小向量集合。就像在地图上,你只需要“南北”和“东西”两个方向,就能描述任意位置。
理解这一点之后,你在看 embeddings 时会更清楚。一个维度为 768 的词向量,本质上就是把每个词放进一个 768 维空间里,而这个空间是由一组 basis 定义出来的。
Phase 3:ML 里真正重要的部分
现在开始进入真正驱动 ML 算法的核心部分。
9. 特征值与特征向量
我知道,这个名字听起来有点吓人。但核心思想其实很简单。
当你把一个矩阵作用在一个向量上时,通常这个向量会同时被拉伸和旋转。特征向量则是那些特殊的向量,它们只会被拉伸,不会被旋转。拉伸的倍数就是特征值。
为什么你要关心它:
- PCA(降维)用到了 covariance matrix 的特征向量
- PageRank(Google 早期算法)本质上是一个特征向量问题
- Spectral clustering 用到了特征分解
- 理解神经网络训练稳定性时,会涉及 Hessian 的特征值
这部分值得你认真投入时间。去看 3Blue1Brown 的视频吧。免费的,而且真的是网上最好的资源之一。
10. 奇异值分解(SVD)
如果要我只选一个“应用线性代数里对 ML 最重要的概念”,我会选 SVD。它可以把任意一个矩阵,不管形状、不管大小,都拆成三个更简单的矩阵。
它在 ML 中的用途包括:
- 低秩近似,也就是矩阵压缩
- 推荐系统(Netflix Prize 时代的很多算法都在用)
- 数据去噪
- 理解大语言模型微调中的 LoRA
- 伪逆计算
如果说特征分解已经很酷,那么 SVD 更酷,因为它适用于所有矩阵,而不仅仅是方阵。
11. 矩阵分解
它和 SVD 有关,但范围更广。核心思想是把一个大矩阵拆成几个更小的矩阵,这些小矩阵相乘之后,可以近似恢复原矩阵。
这正是 collaborative filtering 的基础。它同样也会出现在 LoRA 里:我们把权重更新近似成两个更小矩阵的乘积,从而在 fine-tuning 时节省显存。
12. 再看 Norm
这时你应该对 norm 再深入一些:
- L1 norm(绝对值之和),在 Lasso regression 中用来鼓励稀疏性
- L2 norm(通常说的长度),在 Ridge regression 和 weight decay 中很常见
- 矩阵的 Frobenius norm
- Infinity norm
它们各自拥有不同的性质,而这些性质会直接影响 optimization 和 regularization。
Phase 4:微积分与线性代数之间的桥梁
ML 真正发生的地方就在这里。单独的线性代数并不能训练模型,但它一旦和微积分结合起来,就会变成 gradient descent。
13. 梯度与 Jacobian
gradient 是偏导数组成的向量。Jacobian 是向量值函数的偏导数组成的矩阵。神经网络中的 backpropagation,本质上就是一连串 Jacobian-vector product。
你不一定需要手推这些东西,PyTorch 会通过 autograd 帮你算好,但你必须知道它们在表示什么。
14. Hessian 矩阵
这是由二阶导数组成的矩阵。它的特征值会告诉你 loss landscape 的曲率。二阶优化方法,比如 Newton’s method,会直接用到它。深度学习里我们通常只做近似,因为完整 Hessian 的计算成本太高。
15. 矩阵形式的链式法则
Backprop 本质上就是把 chain rule 用在矩阵上。一旦你看清这一点,神经网络就不再神秘,它不过是“作用在矩阵上的微积分”。
Phase 5:进阶主题(按需学习)
在真正碰到它们之前,不必给自己太大压力。但知道它们的存在,会很有帮助。
16. 张量运算
- Broadcasting,也就是 NumPy 和 PyTorch 如何处理 shape mismatch
- Einstein summation,也就是
einsum,学会之后你会写出更干净的代码 - Contractions 和 reshape
说真的,einsum 基本算是一种超能力。去学它。
17. 矩阵微积分恒等式
对常见矩阵表达式求导时,有一批非常经典的恒等式。准备一份 cheat sheet 很有用。《The Matrix Cookbook》这份免费 PDF 一直都是经典参考。
18. 正定矩阵
这类矩阵满足:对所有非零向量 x,都有 x^T A x > 0。它们会出现在:
- covariance matrices(总是 positive semi-definite)
- Gaussian processes
- convex optimization
- kernel methods
19. 数值线性代数
当规模变大之后,计算机究竟是如何执行这些计算的,也会变得重要。比如:
- condition number,也就是你的计算稳定性如何
- LU 和 QR 分解
- 迭代方法
只有当你在做重度优化工作,或者自己写线性代数底层代码时,才需要往这里深钻。
Phase 6:它们究竟在 ML 的哪里出现
我把每个主题和真实 ML 任务做个映射,这样你会更清楚学完之后到底能用在哪里。
线性回归:矩阵乘法、矩阵逆(或通过 SVD 得到的伪逆)、用于 regularization 的 norm。
逻辑回归与神经网络:每一层都在做矩阵乘法,通过 Jacobian 得到梯度,用 norm 做 weight decay。
PCA:covariance matrix 的特征向量,或者等价地说,数据矩阵的 SVD。
Transformer 与 Attention:大量矩阵乘法、用于 attention score 的点积,以及在这些分数上的 softmax。
扩散模型:线性变换与噪声结合,稳定性分析里会出现特征值。
推荐系统:矩阵分解、SVD、低秩近似。
图神经网络:邻接矩阵、Laplacian 矩阵、特征分解(spectral methods)。
LoRA 微调:低秩分解。你实际上是在学习两个小矩阵 A 和 B,使它们的乘积可以近似一个权重更新。
到底该怎么学
光看是不够的。你需要:
- 自己写代码。 用 Python 从零实现矩阵乘法。对一张小图片做 SVD,再用更少的成分把它重建出来。亲眼看着降维在你面前发生。
- 先手算,再放大规模。 一个手推的
2x2矩阵计算,教给你的东西,比一百次np.matmul调用都更多。 - 可视化。 3Blue1Brown 的《Essence of Linear Algebra》系列是必看内容。我不是开玩笑,真的去看。
- 把它放进项目里。 做一个简单推荐系统,对某个数据集做 PCA,从零训练一个小型神经网络。只有理论、没有实践,一周内你就会忘掉。
- 去读带数学公式的论文。 从简单一点的开始。逼着自己不要跳过公式。把公式写下来,试着理解每个符号到底代表什么。
真正值得看的资源
- 3Blue1Brown 的 Essence of Linear Algebra(YouTube,免费):视觉直觉这块,几乎无人能敌。
- Gilbert Strang 的 MIT OCW 课程:传奇本人授课。比较花时间,但确实是黄金标准。
- Deisenroth、Faisal 和 Ong 的《Mathematics for Machine Learning》:网上有免费 PDF,而且就是专门为 ML 写的。
除非你真的很享受那种纯理论、没有 ML 语境的内容,否则尽量避开那类书。时间是有限的。
最后的建议
不要试图一口气把这些全学完。真的,不要。你会很快 burnout,然后从此讨厌数学。
更好的方式是:先把 Phase 1 和 Phase 2 学扎实,再去碰任何 ML。然后开始做一个简单的 ML 项目,比如从零实现 linear regression。当你碰到自己不理解的地方时,再回来学 Phase 3 或 Phase 4。然后重复这个过程。
目标不是背定理。
目标是当你写下 model.forward(x) 时,真正知道内部发生了什么。 线性代数会给你这种“X 光视角”。
另外,如果你要花上几个月才吃透这些,也完全不用自责。我自己有些内容也是花了很多年才真正理解。到现在我也还会 Google。大家都会。
如果你一时想不起来 Jacobian 是什么,这不代表你笨,只是你有一阵子没用到它而已。
继续学下去。继续做东西。继续把东西搞坏。再把它修好。
这就是唯一的路径。
