
10亿Token,100篇论文,10+开源项目,我尝试搞清楚,什么他妈的叫他妈的人味
一、引言:从《联邦党人文集》到我们的问题
1787 至 1788 年间,亚历山大·汉密尔顿、詹姆斯·麦迪逊和约翰·杰伊以笔名“Publius”发表了 85 篇论文,力促纽约州批准新宪法。
这是《联邦党人文集》。
其中 12 篇的作者身份一直存有争议,汉密尔顿和麦迪逊都声称自己写了它们。
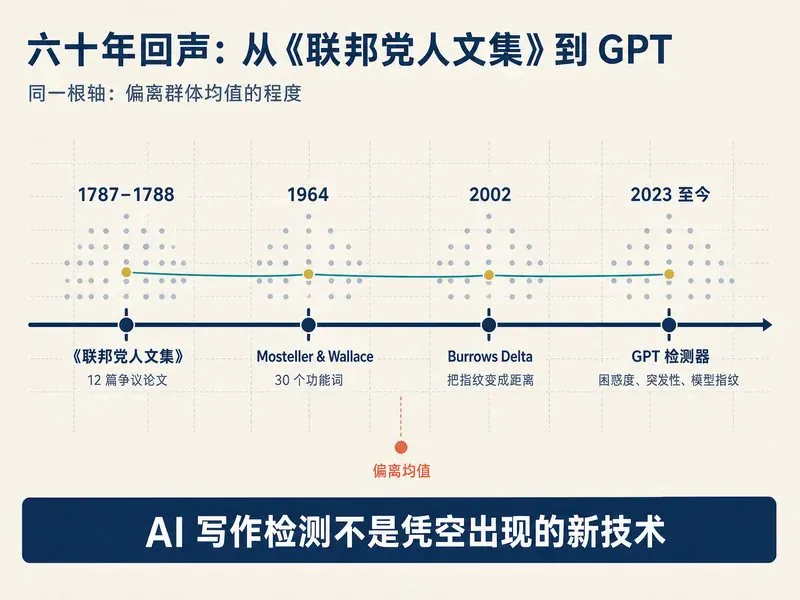
1964 年,哈佛统计学家 Frederick Mosteller 和 David Wallace 用一种前所未有的方法解决了这个谜题。
他们没有分析论文的观点、论据或修辞,因为这些太容易受主题影响。
他们盯上了 30 个看似无足轻重的功能词:upon、by、to、whilst、enough……这些词与写作内容无关,使用频率却因人而异、跨主题稳定,且作者自己几乎意识不到自己在用它们。
通过贝叶斯推断,Mosteller 和 Wallace 将 12 篇争议论文全部判给了麦迪逊,其中证据最弱的第 55 篇在主分析中仍然显示数百比一的优势比(Mosteller & Wallace, 1964)。
这项工作奠定了一个关键洞察:你写了什么不重要,你怎么使用虚词才重要。
功能词之所以能当指纹,恰恰因为它们是无意识的、话题中立的、难以伪造的。
你可以刻意换一个比喻,但你很难刻意、稳定地改变自己使用“的”“了”“而”的相对频率。
六十年后,同一把尺子量向了一个截然不同的问题。
1950 年,图灵问:机器能不能像人?
2023 年起,问题彻底翻转了:我们不再试图让机器像人,而是拼命想证明一段文字不是机器写的。
当 GPTZero 上线后的第一个学期,美国数十所大学的教务部门就把它接入了作业提交系统;
腾讯朱雀宣称可识别十余种主流大模型生成的文本(其检测算法未公开);
中国知网的 AIGC 检测模块已在数百所高校部署(周濛,2024)。
检测产业的逻辑清晰而诱人:
如果 AI 写作有统计可辨的痕迹,那就量化这些痕迹、设个阈值、超过就标红。
但“统计可辨的痕迹”到底是什么?
追问这个问题,你会发现 AI 检测器测的那些东西,如困惑度、句长方差、功能词频率、词汇多样性,并非 2023 年的新发明。
从困惑度到功能词分布,从句长方差到 surprisal 曲线,检测器在用六十年前发明的尺子量一个六十年前发现的维度:
语言使用中,你偏离群体均值的模式。
三个互不引用的传统——民间去 AI 味工具、商业检测器、学术文体计量——在过去两年里独立走向了同一组参数。
这个收敛本身就是最重要的发现:AI 味不是玄学,它有精确的信息论对应物。
但收敛的另一面是一个深刻的悖论。
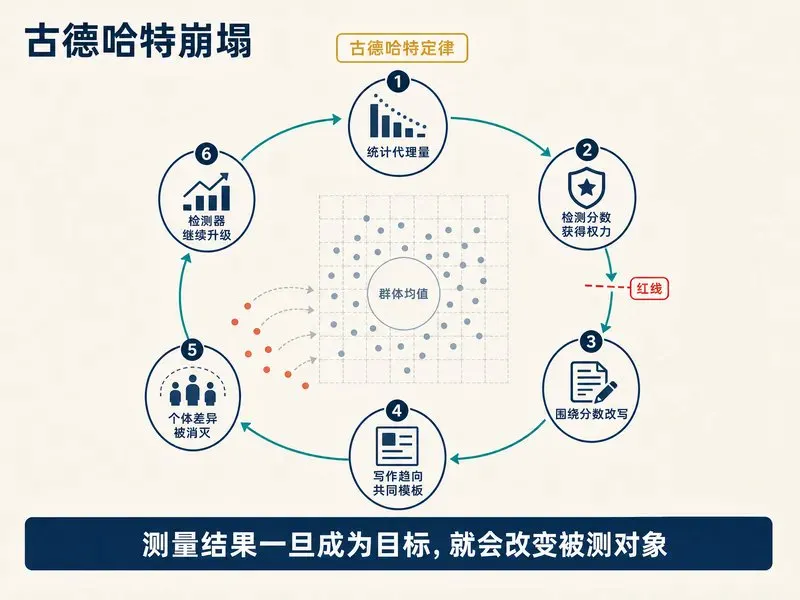
当一个测量制度化为目标,当检测分数决定论文能否通过、作文能否及格,它就不再是好测量了。
经济学家查尔斯·古德哈特在 1975 年为这个规律命了名(Goodhart, 1984)。
本文试图论证:人味可以诊断,却无法优化。
任何试图把“像人”当作优化目标的系统,终点都是古德哈特崩塌:
检测器以维护人味之名,系统性地消灭人味的来源。
以下六节,我们将依次拆解检测器的五组信号、回溯文体计量的六十年回声、区分“减法”与“加法”两条去 AI 味的路线、提出一个跨四层的“结构化离群”统一框架,直面检测器正在反噬人类写作的证据,最终回到那个翻转后的图灵问题:人味可以测量吗?
二、检测器的五个旋钮
想象一个调音台。AI 写作检测器不管品牌、不论中英,本质上都在监听同一批信号,只是每家调音台上旋钮的名字不一样。拆开来看,所有信号可以归为五组。
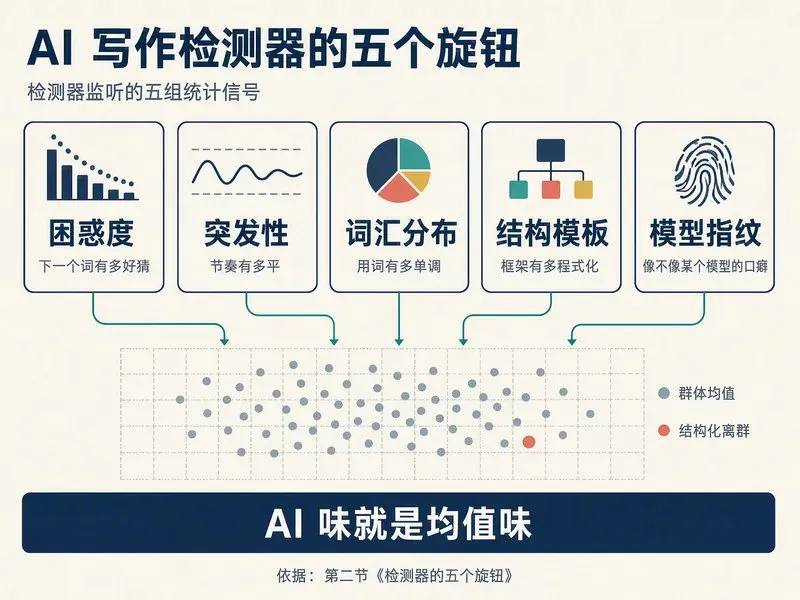
2.1 旋钮一:困惑度——下一个词有多好猜
困惑度(perplexity)是信息论的基础概念:给定前文,模型对下一个词的预测越准确,困惑度越低。
大语言模型天生倾向于挑选概率最高的词,这是其训练目标的直接后果。
所以 AI 文本在参考语言模型面前呈现出低困惑度,
而人类写作充满了模型“猜不到”的选择:一个意外的比喻、一个领域黑话、一个私人的具体细节。
GPTZero 用一个微调过的 GPT-2 模型计算每句话的困惑度,然后汇总全文。
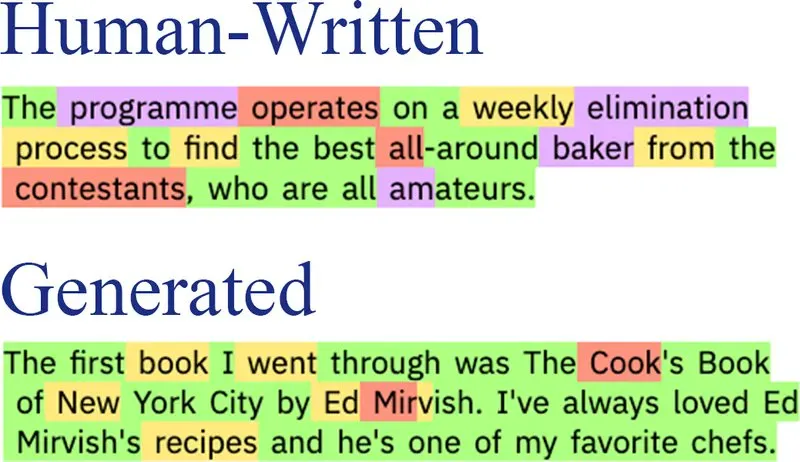
GLTR(Gehrmann et al., 2019)更直观:它把每个词在模型预测分布中的排名用颜色标出:绿色是 top-10 高概率词,红色是模型根本猜不到的词。AI 文本几乎一片绿黄,人类文本频繁闪红。
2.2 旋钮二:突发性——节奏有多平
如果说困惑度是信号的“平均水平”,突发性(burstiness)就是它的“波动幅度”。
GPTZero 的定义是逐句困惑度的标准差(社区里常简化为“句长标准差”,但那只是一个粗略近似)。
人类写作的突发性天然较高:
你会在平铺直叙的段落里突然插入一句炸裂的判断,在技术论述中穿插一个私人经历,在长句之后跟一个斩钉截铁的短句。
这种节奏起伏对应着 surprisal 曲线上的尖峰与低谷。
AI 文本则倾向于处处均匀,每句话都维持差不多的信息密度,像一台恒温恒湿的空调。
DetectGPT(Mitchell et al., 2023)走了另一条路:
它不直接看困惑度数值,而是看概率曲率:对文本做微小扰动后,AI 文本的对数概率会明显下跌(因为它本来就在局部最优点),人类文本则波动不大。这印证了同一个特征:AI 总是停在概率曲面的最高点,一扰动就下坡。
2.3 旋钮三:词汇分布——用词有多单调
大语言模型在一次输出中倾向于反复使用同一批词汇。
这体现在两个层面:词汇多样性(TTR)偏低,以及功能词的使用模式。
那些与内容无关的虚词,如“的”“了”“然而”“此外”,呈现出高度同质化的分布。
Kobak 等人(2025)的 Science Advances 论文提供了一个生动的例子:他们分析了 PubMed 上 1510 万篇生物医学摘要,发现“delves”这个词在 2024 年的使用频率飙升了 28 倍。这不是因为“delves”是个坏词,而是因为它恰好是大模型训练分布的众数——AI 输出的“均值味”的标本。
2.4 旋钮四:结构模板——框架有多程式化
“首先……其次……最后……综上所述”——这种总分总的论述结构、过渡词密度过高的行文方式、段落之间过于“逻辑严密”的连接,都是 AI 文本的结构指纹。
中国知网的 AIGC 检测系统据报道已将“综上所述”“值得注意的是”等过渡短语的密度纳入检测维度。
这些短语本身没有错,但 AI 堆砌它们的频率远超人类。
人类写作允许逻辑的留白、容忍节奏的断裂、偶尔跑题再回收。
2.5 旋钮五:模型指纹——像不像某个模型的口癖
每个模型家族都有自己的“口癖”,如特定的词序组合、偏好的句法结构,形成一种可辨识的统计指纹。McGovern 等人(2025)证实,仅凭 n-gram 和词性特征上的简单分类器就能有效区分不同 LLM 的输出。EQ-Bench 创意写作排行榜的 Slop Score 将这种口癖量化为一份 1648 条目的词表,涵盖 tapestry、vibrant、ethereal 等 AI 高频词乃至 AI 偏爱的幻想人名。
人类写作的命中率约 6.90 次/千词,多数模型在 10 到 40 次之间(Paech, 2024)。
朱雀等商业检测系统宣称可覆盖十余种主流大模型,但其具体算法从未在同行评审论文中公开。
Kirchenbauer 等人(2023)的水印方案走了另一条路:在生成时主动植入统计信号(绿/红名单机制),使得模型输出在不影响可读性的前提下,携带可检测的隐形标记。
五个旋钮的共同指向
把五组信号并排看,一个统一的画面浮现出来:
所有检测器,测的都是同一件事:待检文本与训练分布均值之间的距离。
困惑度低 = 选词太接近均值;
突发性低 = 节奏太接近均值;
词汇单调 = 用词分布太接近均值;
结构模板化 = 篇章组织太接近均值;模型指纹重合 = 整体模式太接近均值。
换一种说法:AI 味就是均值味。
这个洞察将贯穿全文:它既是检测器的工作原理,也是检测器的根本局限,更是我们理解“人味”的关键入口。
三、六十年回声:从 Delta 到 GPT
第一节讲述了 Mosteller 和 Wallace 如何用 30 个虚词判定了《联邦党人文集》的作者。
但他们的方法依赖贝叶斯推断,需要预设少数几个候选者。面对海量文本、未知作者的情况呢?
3.1 Burrows Delta:把指纹变成距离
2002 年,John Burrows 把 Mosteller-Wallace 的思路发展成了一个优雅的通用算法。
Delta 的计算分四步:取全语料最高频的若干词(Burrows 原文用前 150 个,绝大多数是功能词);对每个词,在整个语料上算出均值和标准差;把目标文本中该词的频率转化为 z 分数(标准化后的偏离值);最后算目标文本与候选作者之间所有词的 z 分数之差的绝对值的平均,这个平均距离就是 Delta(Burrows, 2002)。
用词模式越接近,越可能是同一个作者。
本质上,Delta 度量的是:你在高频词这张多维地图上,站在哪个位置?
每个人都有自己的位置,自己的 z 向量。AI 也有。
3.2 回声:检测器在重新发明文体计量
现在,把 Burrows Delta 和 GPTZero 的工作原理放在一起看:
一个用功能词的 z 分数距离度量“这是不是你写的”,另一个用逐句 surprisal 的标准差度量“这是不是 AI 写的”。
不同的名词,同一根轴:偏离群体均值的程度。
2025 年的实证验证了这个类比不只是修辞。
Zhu 和 Lei(2025)在 Digital Scholarship in the Humanities 上发表的研究表明,Burrows Delta 在仅有 100 到 550 个词的短文本上,就能以超过 80% 的准确率区分人类与 AI 写作。
O‘Sullivan(2025)在 Nature Portfolio 旗下的期刊上报告了更尖锐的发现:用 Delta 做聚类分析时,多个 LLM 的输出聚成紧密的簇,而人类文本则分散得多。每个人有自己的位置,但所有 AI 都挤在一起。
这意味着什么?
AI 润色最大的伤害,不是给你的文章加了几个破折号或删了几个“此外”。
它是把你在功能词地图上的独特位置,悄悄推向了模型的中心。
研究证据支持这个判断的方向,但也校正了它的强度:
Sourati 等人(2024)的 Secret Keepers 研究用 GPT-3.5、Llama 2 和 Gemini 改写人类文本后,测量了改写前后从语言模式预测作者个人特征(性别、年龄、政治倾向等六项)的能力变化:所有六项都下降了,但多数残余指纹仍在随机水平之上。
AI 改写并非均匀地抹掉你的特征,而是用模型自己的分布覆盖你的分布,编辑强度越大,你的风格就越接近模型的中心。
所以“去 AI 味”的正确框架,不是“擦掉 AI 痕迹”,而是“别让 AI 覆盖掉你自己的分布”。
四、减法与加法:去 AI 味的两条路
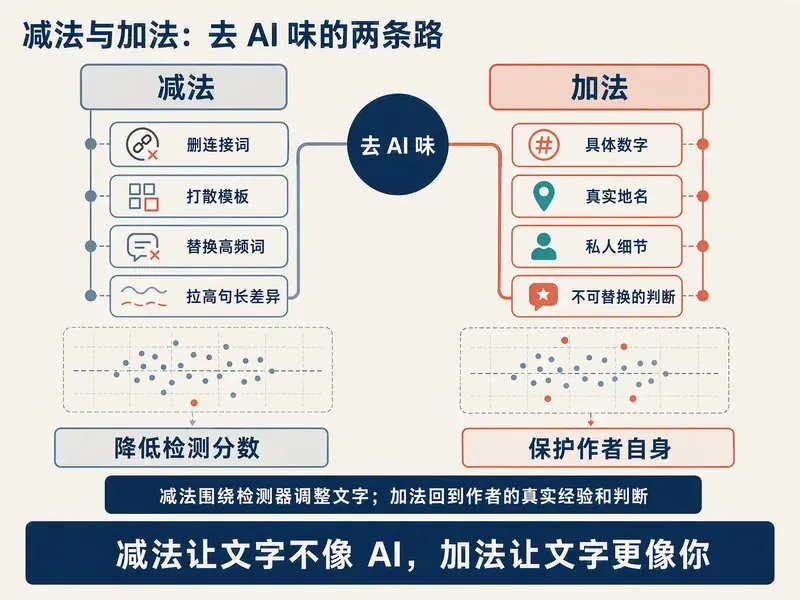
打开任何一个“去 AI 味”工具,无论是中文的降 AI 率插件还是英文的 humanizer 服务,你会发现它们做的几乎都是同一件事:
删。
删掉破折号、删掉“此外”“然而”、删掉总分总结构、拉高句长方差。这是“减法”路线。
先把身份说清楚:这些工具不是检测器,是优化器。区别不在测什么,在测量结果交给谁。
检测器把“像不像 AI”的判定交给第三方作裁决;优化器把同一类测量接进自己的改写循环,改到过线为止。
它们并非不做测量:humanizer 和 stop-slop 给自己装了 50 分制的门槛,总分不到 35 就整篇重写;
有的带命中即不通过的机器检查器;ai-flavor-remover 干脆把外部检测器的分数当成效指标。
优化器等于一台私有检测器焊上一个改写循环,这正是古德哈特机器的最小实现。
而第七章要造的诊断器走第三条路:测量结果只交还作者本人,不设及格线。
4.1 减法:一条走到尽头的路
减法的逻辑简单直接:检测器标记什么为 AI 特征,就反向操作消除它。
砍连接词密度、打散模板结构、替换高频 AI 词汇、刻意制造句长变化——这些操作确实能降低检测分数。
但减法有三个致命问题。
第一,它已经饱和了。 全世界所有的去 AI 味 skill 和工具,几乎都在做减法的排列组合。可客观计数的减法参数,如破折号数、否定排比、AI 词表命中率、结构信号密度,总共不超过二十个。这是一片极度拥挤的红海。
第二,它终将过期。
Krishna 等人(2023)证明,仅仅用一个 110 亿参数的改写模型做一遍释义,就能让 DetectGPT 的检测率从 70.3% 暴跌到 4.6%。
Sadasivan 等人(2025)的不可能性定理从理论上封死了这条路的天花板:最优检测器的 AUROC 受限于人机分布之间的总变差距离,当 AI 输出越来越接近人类分布,检测必然趋近抛硬币。
2025 年的对抗性释义研究进一步显示,检测器引导的通用改写方案平均降低检测率约 88%,对 Fast-DetectGPT 的降幅更达到 99%(Cheng et al., 2025)。
但检测方也在追,检索防御、强化学习对抗都在路上,所以减法注定是一场永不停歇的军备竞赛。
第三,也是最深层的问题:减法的终点不是“文章变好”,而是“检测器失效”。 把检测分从 70% 压到 17% 之后呢?文章有没有变得更值得读?没有任何指标回答这个问题。减法只能让你的文字不像 AI,不能让它更像你。
4.2 加法:几乎没人走的路
与减法的拥挤形成鲜明对比的是加法的空旷。
加法问的不是“怎么删掉 AI 痕迹”,而是“什么让文字更好、更像一个具体的人写的”。
这个问题的答案,其实在语言学里有成熟的学术对应,只是去 AI 味生态几乎没人接入。
具体度。 心理语言学早已为“词有多具体”建好了量尺。
Brysbaert 等人(2014)在 Behavior Research Methods 上发表了约四万个英文词条的具体度评分(1–5 分制),中文方面则有 Xu 和 Li(2020)的 MELD-SCH 数据库(9877 个双字词)。
AI 文本的一个跨研究一致的特征是:名词化更多,比如英文里从 operate 变成 operation,把具体的动作转化为抽象的概念,在语义上系统性地远离具体端。具体的数字、真实的地名、精确的细节,这些是 AI 最不擅长生造的东西,因为它们本质上是低概率的语义锚点。
判断浓度。 Hyland(2005)的元话语框架把作者的立场拆解为四类标记:
模糊限制语、增强语、态度标记和自我提及。Martin 和 White(2005)的评价理论进一步细分为三个子系统:态度(涵盖情感、判断、鉴赏)、介入(独白与多声的区分)、级差(强度与聚焦的调节)。
这些框架给了“判断浓度”可操作的标注维度,不是简单的“有没有观点”,而是可以数的:每百字有多少个增强语、多少个态度标记、单声断言与多声让步的比例是多少。
但这里有一个微妙的张力:同一个“也许”,作为 AI 的填充词是需要删的噪音,作为作者对不确定性的诚实承诺则是判断的一部分。
区分二者不能靠词表,必须靠语境,这正是“判断浓度需要独立判官而非自动计数”的硬道理。
在场感。 在场感是四个加法参数中“最测不出”的一个。
有一个诱人的捷径:数第一人称代词的频率。
但 Jakesch 等人(2023)在 PNAS 上发表的实验彻底堵死了这条路。
他们发现,人类误以为“有‘我’、提家人、讲个人经历”就是人写的标志,据此判断的准确率降到了接近随机的 50%–52%,因为这些特征 AI 同样能轻松生造。
真正的在场感不是“有没有用第一人称”,而是不可替换性:把作者换成任何人,这句话还成立吗?
“我昨天在杭州被这个 bug 坑了三小时”里的地点、时间和代价把它锚定到了一个具体的人;
“我认为这很重要”换谁都成立,是假在场。
在场感的本质是具体度的一个私人化子集——不可替换性来自只有你会知道、会这么说的具体锚点。
4.3 不对称性
加法和减法之间存在一个关键的不对称性:加法对检测器天然免疫。
检测器能测困惑度、能数连接词、能比对 n-gram 指纹,但它测不出一个判断是不是不可外包的、一个细节是不是私人的、一段论述有没有承诺。
加法参数不是统计模式,是语义行为——它们在检测器的五旋钮调音台上根本没有对应的推杆。
这意味着:减法的每一招都有保质期(检测方会追上来),但加法本质上不参加这场猫鼠游戏。
你不需要骗过任何检测器,你只需要写得具体、写出判断、留下只有你才能留下的锚点。
五、统一理论:四层离群与信息节奏
到目前为止,我们沿着两条线索行走。一条是检测器和文体计量的历史线,它告诉我们 AI 味的本质是“太接近均值”;另一条是减法与加法的实践线,它告诉我们去 AI 味有两种截然不同的策略。现在该把这两条线索拧成一根绳了。
5.1 信息节奏:比句长方差更根本的人味
第二节提到,人类写作的突发性高于 AI。但“方差大就是人味”这个直觉太粗了,刻意乱写也能拉高方差。信息论给出了更精确的图景。
2007 年,Levy 和 Jaeger 在 NIPS 会议上提出了均匀信息密度假说(UID):在容量受限的通信信道上,说话人倾向于让单位时间的信息传输率保持稳定,信息密度高的地方放慢(加冗余),低的地方加速(压缩),使 surprisal 趋于均匀(Levy & Jaeger, 2007)。Jaeger(2010)用英语补语从句中“that”的省略规律为 UID 提供了经典证据。
这个假说一度简化成了一个整洁的叙事:人 = 宏观均匀 + 局部尖峰,AI = 处处均匀。
但 2024–2025 年的新研究推翻了这个简化。
Tsipidi 等人(2024)在 EMNLP 上提出了结构化语境假说:说话人不是简单地追求均匀,而是按其在层级化语篇结构中的位置来调制信息率。surprisal 的波动不是噪声,是有意为之,为了维持兴趣、遵循写作惯例、构建论证。他们 2025 年发表于 ACL 主会的后续工作走得更远,发现信息轮廓存在周期性的谐波结构,就像音乐有和弦进行一样,好的写作在信息密度上也有内在的节奏模式(Tsipidi et al., 2025)。
Gwak 等人(2026)从另一个角度提供了佐证:在大模型推理链中,成功的推理路径呈现出“局部高均匀、全局低均匀“的特征:局部足够平滑以保持连贯,全局足够起伏以体现思维的转折与推进。全局过度均匀的推理链往往冗长、重复、最终答错。
这些发现有一个直接的工程后果:“方差越大越好”是错的。
真正的人味节奏不是简单的“忽高忽低”,而是在正确的位置高、正确的位置低——按语篇结构调制的有意识起伏。
2026 年发表于 TMLR 的 DivEye 检测器(Basani & Chen, 2026)直接利用了这个洞察:它不看困惑度的均值,而是看 surprisal 序列的多样性特征(高阶统计量),发现人类文本的 surprisal 分布尾部更重、离散度更高。
这等于从检测端实证确认了:人味的信息论本体不是“高方差”,而是“结构化的多样性”。
5.2 四层离群模型
有了信息节奏这个最底层的理论支撑,我们可以把前面所有的线索收拢成一个统一的框架。
分别从虚词、信息论、语义和社会四个学科出发的研究,独立地走向了同一个结论:
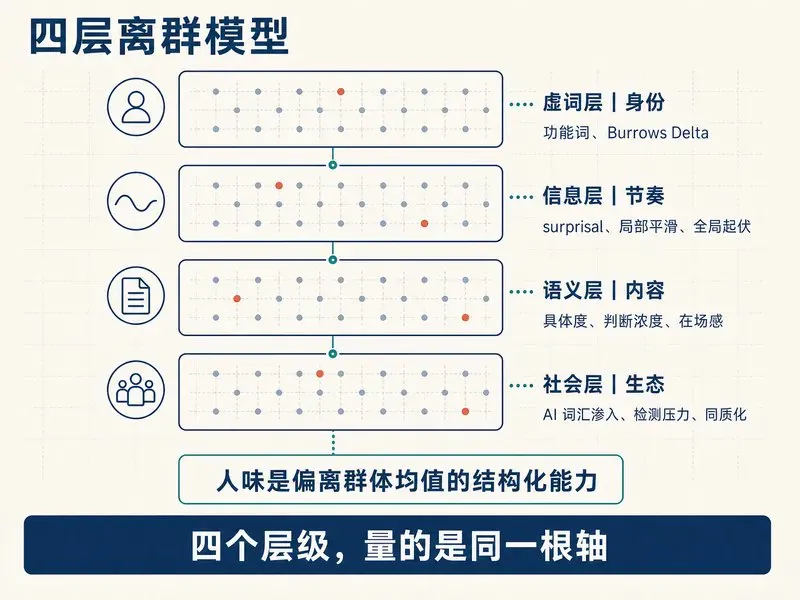
人味是偏离群体均值的结构化能力。
以下四层框架是本文基于上述收敛提出的综合模型,而非既有的学科共识。它的价值在于把分散的实证线索串联成一根可追溯的逻辑链。四个学科测的是同一根轴在四个层级的投影:
- 虚词层(身份): Burrows Delta 字面上就在计算每个功能词偏离语料中心多远。你的 z 向量是你在功能词地图上的位置——独一无二、跨主题稳定、难以伪造。AI 润色把你推向模型的中心,就是把你的身份信号抹向均值。
- 信息层(节奏): surprisal 序列的形态——局部平滑、全局起伏、按语篇结构调制的谐波节奏。GPTZero 的 burstiness 量的就是这一层。AI 文本处处可预测、全局过均匀,缺少信息密度的有意起伏。
- 语义层(内容): 具体度、判断浓度、在场感,都是低概率的语义锚点。一个精确的数字、一个不可外包的判断、一段只有你才说得出的经历,在语料空间中都是离群点。AI 的默认行为是输出最大似然的、中性的、可替换的表述——语义层的均值。
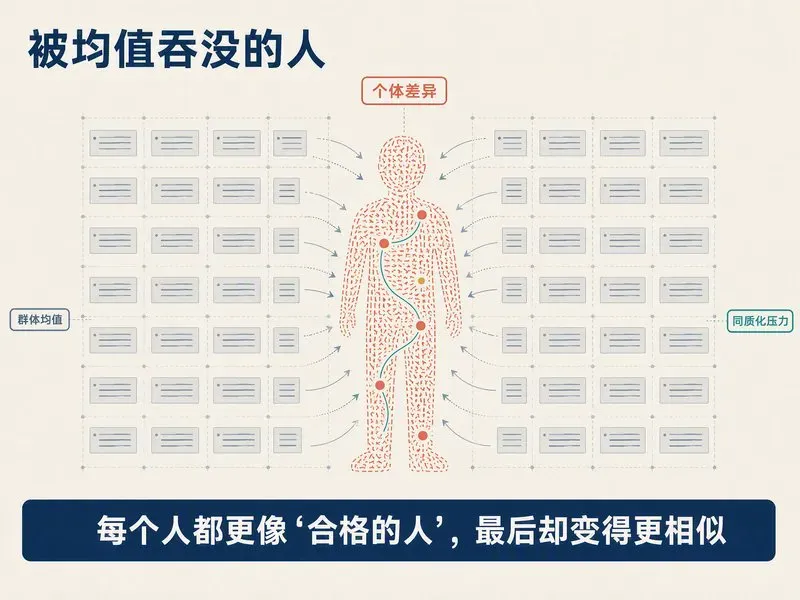
- 社会层(生态): 两个方向正在同时挤压前三层的离群:AI 词汇渗入人类文本,构成同质化推力;人为过检测而删词,构成自我审查拉力。检测器认可的“人味模板”正在成为这场挤压的终点。
这不是四个话题,是同一个量在四个层级的投影。四把不同学科的尺子,量的是同一根轴。
5.3 认识论陷阱:检测侧 ≠ 生产侧
在这个框架里,必须设一道防火墙。
检测器用来抓 AI 的特征,不能直接反过来当“写得像人”的目标。
这个区分贯穿了前面的每一层:
在虚词层,“能不能区分人 vs AI”(检测侧问题)和“你的指纹还在不在”(生产侧问题)是两回事;
在信息层,burstiness 是检测侧统计量,UID 是生产侧假说;
在语义层,“有没有用第一人称”是 Jakesch 已证伪的检测启发式,“不可替换性”才是生产侧的真正标准。
忽略这道防火墙,会导致一种普遍的错误:把检测器的相关物(破折号少、句长方差高、第一人称多)当作人味的生产配方来优化。
这不仅无效,因为它们只是粗糙的代理,而且有害,因为一旦成为目标,就立即掉入下一节要讨论的古德哈特陷阱。
六、反噬:当检测器定义人味
“任何被用于控制目的的统计规律性,一旦承受压力就会趋于崩塌。”——查尔斯·古德哈特,1975(Goodhart, 1984)
6.1 误判:检测器测的不是人味,是语言复杂度
Liang 等人(2023)把 91 篇托福作文送入 7 个主流检测器,平均 61.3% 判定为 AI 生成,至少触发一个检测器的比例高达 97.8%。
对照实验更说明问题:用“提升词汇丰富度”的提示改写后,假阳性率从 61.3% 骤降到 11.6%;反过来简化母语学生的用词,误判率显著上升。
检测器判的不是“人 vs 机器”,而是“语言复杂度高 vs 低”。
用词简单、句式规整的人类写作,在检测器眼里与 AI 输出无异。
同样的机制波及自闭症和 ADHD 群体:其结构化、重复用词的写作特征恰恰命中检测器的判据。
James Zou 教授的结论直截了当:“应当极其谨慎、甚至尽量避免使用这些检测器。”
6.2 同质化:每个人都更有创意,但所有人都更相似
Doshi 和 Hauser(2024)在 Science Advances 上报告了一个悖论:AI 辅助的写作者,其作品获评更有创意,但作品之间的相似度也显著提高。每个人觉得自己写得更好,汇总起来,创意版图在收窄。Moon 等人(2024)量化了这个差距:人类文书对集体语义多样性的贡献是 GPT-4 文书的 2 到 8 倍。
渗透的速度超出预期。Kobak 等人(2025)在 PubMed 1510 万篇摘要中检测到至少 13.5% 经过 LLM 处理;后续研究(Holzwarth et al., 2026)扩展到全文,发现到 2025 年底约 89% 显示 LLM 词汇痕迹。中文文学创作(Ma et al., 2026)和辩论领域也出现了同样的趋势:人类辩手的论点有 65.3% 是独特的,LLM 辩手仅 3.4%(Kim et al., 2026)。观点的坍缩比词汇的同质化更深层。
机制并不复杂:与模型共写,模型贡献的文本本身更少样,把每个人都拉向同一个中心(Padmakumar & He, 2024)。
连写作质量的评估也未能幸免:EQ-Bench 创意写作排行榜始终使用 Claude 担任裁判,Anthropic 模型在前 15 名中占 6 席,基准维护者承认“我们没有控制裁判可能偏好自己输出的问题”(Paech, 2024)。
6.3 制度后果:检测器从工具变成了规范
范德堡大学 2023 年停用了 Turnitin AI 检测器(Vanderbilt University, 2023)。理由是一道简单的算术:Turnitin 声称假阳性率低于 1%(Chechitelli, 2023),但全年 75,000 篇论文中 1% 就意味着约 750 篇错误标记。多所美国大学随后跟进。
继续使用检测器的院校中,学生们开始主动“写差”以躲避标记:简化词汇、删掉有力的段落、故意加入错别字。英国一项调查显示,75% 的学生担心检测器将自己误判为抄袭(Studiosity/YouGov, 2026)。
这种自我审查往往产出更弱的文章,而质量忽高忽低反而更容易触发检测器。
6.4 古德哈特崩塌
把前三节叠在一起看:检测器测的是统计代理量,代理量与语言复杂度混淆,制度化的检测分数成了事实上的写作规范。人们不再问“这样写好不好”,而问“这样写过不过”。
检测器以维护人味之名,系统性地消灭人味的来源。
这不是检测器的特例。回看第五节的四层模型,每一层都独立地撞到了同一堵墙:
- surprisal 曲线只能当诊断,一旦当优化目标就死于 Sadasivan 的不可能性定理:终点是检测器失效,不是文章变好。
- 功能词指纹只能当门禁,一旦强迫模型匹配某组 z 分数,“保护”就退化成另一种参数游戏。
- 具体度分只能当诊断信号,一旦当放行凭证就激励堆砌细节:形式上的具体但内容上空洞。
Sourati 等人(2026)的“放大悖论”从理论上封住了最后一个出口:个体层面的能力放大在群体层面导致多样性坍缩。人味可以诊断,却无法优化。
两股力量正在同时挤压人类写作:
AI 词汇渗入把写作拉向训练分布的均值,检测器驱动的自我审查把写作惩罚回均值。
两个方向都在消灭方差,而方差正是人味的本体。
当一个不完美的测量获得了惩罚权力,它就不可避免地成为规范本身。
6.5 一次预注册实验:洗掉的人味救不回来
以上还都是推论,我们用一次预注册实验做了检验:
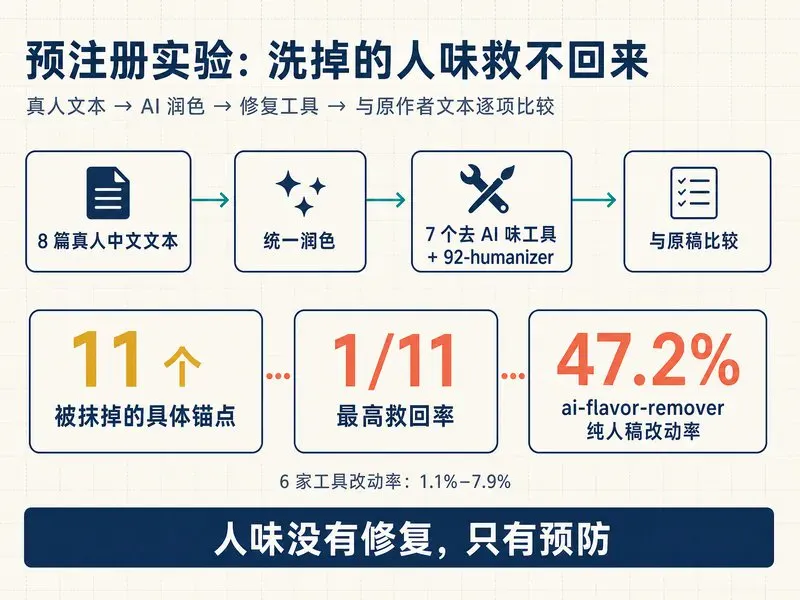
选 8 篇确定出自人类之手的中文文本,让大模型统一执行一次最常见的操作,“润色得更通顺、更专业”,制造损伤;
再让 7 个开源去 AI 味工具(ai-flavor-remover、De-AI-Prompt-Enhancer、humanizer、Humanizer-zh、rn-renhua、shuorenhua、stop-slop)和我们自己写的诊断工具 92-humanizer 分别修复,以原作者为真值逐项对比。
92-humanizer 的修复方式与七家优化器不同:它不自动改写,只向一个手握原稿的模拟作者提问,把答回的真锚点织回损伤稿。
假设、指标、排除规则在开跑前全部写死存档;三篇百科和费率类文本因为模型靠通用知识就能重建内容,预筛阶段剔除(实验协议与全部原始产物随本文仓库公开)。
损伤先给了一个下马威:
第一,同一条润色指令,对百科和医学文本只挪动了十几个功能词的频率,对口语声口最浓的三篇,漂移平均高出近八成。越有人味的文本,润色的杀伤越大。
第二个发现:润色总共抹掉了 11 个具体锚点:年龄、数字、口语细节。八个工具里,救回率最高的只有 1/11,包括我们自己那个专门为“要回真锚点”设计的工具。
它守住了不生造的底线,却没有问出正确的问题。洗掉的人味,没有任何工具找得回来。
七、结论:镜子,不是靶子
如果人味可以诊断却无法优化,那么工具应该长什么样?
答案藏在诊断与优化的区别里。
诊断工具告诉你“这里塌了”:你的功能词分布在这次润色中漂移了多少、你的 surprisal 曲线在哪几段过于平坦、你的具体度在哪些段落掉到了抽象均值、你的判断在哪里外包给了中性表述。它照镜子,不设靶子。它呈现剖面,不输出分数。
这张剖面不是一个数字,而是一个跨四层的图谱:
- 虚词层: 对原稿和润色稿分别算 Burrows Delta,列出漂移最大的功能词,回答“这次润色覆盖了我多少身份”。零机器学习,可解释,今天就能做。
- 信息层: 用一个固定的开源语言模型算逐字 surprisal,画出曲线,标红过平段落,回答“哪里节奏塌了”。不报单一方差(旧叙事已不成立),而是分别报全局起伏度和局部平滑度。
- 语义层: 具体度可以纯机器计算(接中文 concreteness 常模查表),判断浓度和在场感需要独立判官。
- 红线: 整张剖面只呈现给作者做诊断,绝不接自动改写去优化任何一层,否则工具本身就变成了新的同质化引擎。
这最后一条红线是最重要的设计原则。在第六节论证的古德哈特崩塌面前,它是唯一的防线。
一旦把诊断结果接入“自动修复”流水线,自动提高具体度、自动注入信息尖峰、自动模仿用户的功能词分布,工具就从镜子变成了靶子,从照亮变成了规训,从帮你认识自己变成了帮你变成另一个别人。
同一套机械,测量结果只交还作者就是镜子,接回改写循环就是第八个优化器,中间只隔着这条红线。
红线之外还有一条服务边界。想要凭空造出人味的需求真实存在:编一段亲历、造一个数字、加一点“生活气息”,市面上服务这种需求的工具从来不缺。
但诊断工具不该做这门生意。把编造的细节冒充作者的亲历,不是帮作者找回自己,而是替作者向读者撒谎。
一面诚实的镜子,可以照出你缺什么,不能替你长出你没有的东西。
回到那个翻转后的图灵问题。
图灵问的是:机器能不能像人?
我们这一代面对的问题是:人的写作还像不像人?
答案取决于我们把“人味”当成什么:一个可以量化、优化、达标的指标,还是一面只能照、不能射的镜子。
减法擦掉均值味,加法加回你自己。
而“你自己”的定义,就是你在这四层上偏离均值的那部分:你下意识的虚词分布、你不自觉的信息节奏、你落在低概率处的具体锚点与不可外包的判断。
这些东西看得见,却瞄不准。
人味可以测量吗?可以。但测量的结果只能是一面镜子,永远不该成为一个靶子。
写作方法声明
本文由作者李韭二与 Claude(Anthropic 的大语言模型)协作完成。
文责由李韭二承担。
分工如下:研究检索、评测代码与执行、数据统计由 AI 承担;
选题、结构、观点、边界与每一处最终取舍由作者决定;
初稿与修订在人机之间往复多轮。
我们不掩饰这一点,理由就写在第六章里:
该反对的从来不是使用 AI,而是用工具伪装人味、把编造的细节冒充亲历。
所以本文接受了自己主张的检验:发布前,配套工具 92-humanizer 的独立判官(与写作过程隔离的另一个模型实例)对全文做了诊断,给出六条标注与一份提问清单,诊断报告与全部实验产物一起随本文仓库公开。
哪些标注要改、哪些保留原文,由作者逐条决定,工具无权代劳。
这段声明本身,就是“镜子,不是靶子”的用法示范。
参考文献
Basani, A. R., & Chen, P.-Y. (2026). Diversity boosts AI-generated text detection. Transactions on Machine Learning Research. https://arxiv.org/abs/2509.18880
Brysbaert, M., Warriner, A. B., & Kuperman, V. (2014). Concreteness ratings for 40 thousand generally known English word lemmas. Behavior Research Methods, 46(3), 904–911. https://doi.org/10.3758/s13428-013-0403-5
Burrows, J. (2002). “Delta”: A measure of stylistic difference and a guide to likely authorship. Literary and Linguistic Computing, 17(3), 267–287. https://doi.org/10.1093/llc/17.3.267
Chechitelli, A. (2023, June 1). AI writing detection update from Turnitin's Chief Product Officer. Turnitin Blog. https://www.turnitin.com/blog/ai-writing-detection-update-from-turnitins-chief-product-officer
Cheng, Y., Sadasivan, V. S., Saberi, M., Saha, S., & Feizi, S. (2025). Adversarial paraphrasing: A universal attack for humanizing AI-generated text. arXiv preprint, arXiv:2506.07001. https://arxiv.org/abs/2506.07001
Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. https://doi.org/10.1126/sciadv.adn5290
Goodhart, C. A. E. (1984). Problems of monetary management: The UK experience. In A. S. Courakis (Ed.), Monetary theory and practice: The UK experience (pp. 91–121). Macmillan. (Original work presented 1975)
Gehrmann, S., Strobelt, H., & Rush, A. M. (2019). GLTR: Statistical detection and visualization of generated text. In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics: System Demonstrations (pp. 111–116). https://doi.org/10.18653/v1/P19-3019
Gwak, M., Son, G., & Kim, J. (2026). Revisiting the uniform information density hypothesis in LLM reasoning. In Findings of the Association for Computational Linguistics: ACL 2026. https://arxiv.org/abs/2510.06953
Holzwarth, L., González-Márquez, R., & Kobak, D. (2026). Most biomedical publications show signs of LLM-assisted writing. arXiv preprint, arXiv:2608.10715. https://arxiv.org/abs/2608.10715
Hyland, K. (2005). Stance and engagement: A model of interaction in academic discourse. Discourse Studies, 7(2), 173–192. https://doi.org/10.1177/1461445605050365
Jaeger, T. F. (2010). Redundancy and reduction: Speakers manage syntactic information density. Cognitive Psychology, 61(1), 23–62. https://doi.org/10.1016/j.cogpsych.2010.02.002
Jakesch, M., Hancock, J. T., & Naaman, M. (2023). Human heuristics for AI-generated language are flawed. Proceedings of the National Academy of Sciences, 120(11), e2208839120. https://doi.org/10.1073/pnas.2208839120
Kim, Y., Chang, Y., Pham, C. M., & Iyyer, M. (2026). Argument collapse: LLMs flatten long-form public debate. arXiv preprint, arXiv:2606.01736. https://arxiv.org/abs/2606.01736
Kirchenbauer, J., Geiping, J., Wen, Y., Katz, J., Miers, I., & Goldstein, T. (2023). A watermark for large language models. In Proceedings of the 40th International Conference on Machine Learning (Vol. 202, pp. 17061–17084). PMLR.
Kobak, D., González-Márquez, R., Horvát, E.-Á., & Lause, J. (2025). Delving into LLM-assisted writing in biomedical publications through excess vocabulary. Science Advances, 11(27), eadt3813. https://doi.org/10.1126/sciadv.adt3813
Krishna, K., Song, Y., Karpinska, M., Wieting, J., & Iyyer, M. (2023). Paraphrasing evades detectors of AI-generated text, but retrieval is an effective defense. In Advances in Neural Information Processing Systems 36.
Levy, R., & Jaeger, T. F. (2007). Speakers optimize information density through syntactic reduction. In Advances in Neural Information Processing Systems (Vol. 19, pp. 849–856). MIT Press.
Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779. https://doi.org/10.1016/j.patter.2023.100779
Ma, Y., Shi, K., He, H., Zhang, Z., Lei, Z., Qiu, Z., Hu, R., & Liu, J. (2026). Creative convergence or imitation? Genre-specific homogeneity in LLM-generated Chinese literature. arXiv preprint, arXiv:2603.14430. https://arxiv.org/abs/2603.14430
Martin, J. R., & White, P. R. R. (2005). The language of evaluation: Appraisal in English. Palgrave Macmillan. https://doi.org/10.1057/9780230511910
McGovern, H., Stureborg, R., Suhara, Y., & Alikaniotis, D. (2025). Your large language models are leaving fingerprints. In Proceedings of the 1st Workshop on GenAI Content Detection (GenAIDetect) (pp. 85–95). Association for Computational Linguistics. https://aclanthology.org/2025.genaidetect-1.6/
Mitchell, E., Lee, Y., Khazatsky, A., Manning, C. D., & Finn, C. (2023). DetectGPT: Zero-shot machine-generated text detection using probability curvature. In Proceedings of the 40th International Conference on Machine Learning (Vol. 202, pp. 24950–24962). PMLR.
Moon, K., Green, A., & Kushlev, K. (2024). Homogenizing effect of large language models on creative diversity: An empirical comparison of human and ChatGPT writing. Computers in Human Behavior: Artificial Humans.
Mosteller, F., & Wallace, D. L. (1964). Inference and disputed authorship: The Federalist. Addison–Wesley.
O'Sullivan, J. (2025). Stylometric comparisons of human versus AI-generated creative writing. Humanities and Social Sciences Communications, 12, 1708.
Paech, S. (2024). EQ-Bench creative writing leaderboard. https://eqbench.com/creative_writing.html
Padmakumar, V., & He, H. (2024). Does writing with language models reduce content diversity? In Proceedings of the 12th International Conference on Learning Representations (ICLR).
Sadasivan, V. S., Kumar, A., Balasubramanian, S., Wang, W., & Feizi, S. (2025). Can AI-generated text be reliably detected? Stress testing AI text detectors under various attacks. Transactions on Machine Learning Research. https://arxiv.org/abs/2303.11156
Sourati, Z., Ozcan, M., McDaniel, C., Ziabari, A., Wen, N., Tak, A., Morstatter, F., & Dehghani, M. (2024). Secret keepers: The impact of LLMs on linguistic markers of personal traits. arXiv preprint, arXiv:2404.00267
Sourati, Z., Ziabari, A. S., & Dehghani, M. (2026). The homogenizing effect of large language models on human expression and thought. Trends in Cognitive Sciences. https://arxiv.org/abs/2508.01491
Studiosity/YouGov. (2026, February 23). [YouGov survey of 2,373 UK university students on AI use, commissioned by Studiosity]. Times Higher Education. https://www.timeshighereducation.com/news/fear-being-flagged-ai-detectors-drives-stress-among-students
Tsipidi, E., Nowak, F., Cotterell, R., Wilcox, E., Giulianelli, M., & Warstadt, A. (2024). Surprise! Uniform information density isn't the whole story: Predicting surprisal contours in long-form discourse. In Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (pp. 18820–18836). https://doi.org/10.18653/v1/2024.emnlp-main.1047
Tsipidi, E., Kiegeland, S., Nowak, F., Xu, T., Wilcox, E., Warstadt, A., Cotterell, R., & Giulianelli, M. (2025). The harmonic structure of information contours. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics. https://aclanthology.org/2025.acl-long.1527/
Vanderbilt University. (2023, August 16). Guidance on AI detection and why we're disabling Turnitin's AI detector. Vanderbilt Brightspace. https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/
Xu, X., & Li, J. (2020). Concreteness/abstractness ratings for two-character Chinese words. PLOS ONE, 15(6), e0232133. https://doi.org/10.1371/journal.pone.0232133
Zhu, H., & Lei, L. (2025). Detecting authorship between generative AI models and humans: A Burrows's Delta approach. Digital Scholarship in the Humanities, 40(3), 1064–1075.
周濛。(2024)。AIGC 论文检测系统的技术缺陷与学术期刊因应。《出版与印刷》,(4),20–30。https://doi.org/10.19619/j.issn.1007-1938.2024.00.027
| 工具 | GitHub | 语言 / 形态 | 评测表现 (摘要) |
|---|---|---|---|
| ai‑flavor‑remover | https://github.com/hylarucoder/ai‑flavor‑remover | 中文・Gemini prompt | 以把朱雀检测分从 70% 压到 17% 为核心卖点;误杀最重 (纯人稿改动率 47.2%),事实保真最低 |
| De‑AI‑Prompt‑Enhancer | https://github.com/OUBIGFA/De‑AI‑Prompt‑Enhancer‑Writer‑Booster‑SKILL | 中文・SKILL + 可执行 linter | 12 条含数值阈值的硬门槛;误杀 7.9%,但改写注入了更多模板标记 (表层密度 +30%) |
| humanizer | https://github.com/blader/humanizer | 英文・SKILL (33 类痕迹) | 唯一系统定义假阳性边界 (簇判定);事实零丢失,表层降 35% |
| Humanizer‑zh | https://github.com/op7418/Humanizer‑zh | 中文・SKILL (24 类痕迹) | 表层清洁最狠 (密度 ‑68%);误杀 1.5% |
| rn‑renhua(rnskill) | https://github.com/Pluviobyte/rnskill | 中文技术写作・SKILL | Hard Bans 词表化;误杀 3.1% |
| shuorenhua | https://github.com/MrGeDiao/shuorenhua | 中文・SKILL (80 用例评测体系) | 误杀纪律全场第一 (改动率 1.1%),字数留存达自设标准;场景 ×scope 设计经受住检验 |
| stop‑slop | https://github.com/hardikpandya/stop‑slop | 英文・SKILL (8 规则) | 副词全删最激进;表层降 48%,事实零丢失 |
