
你为减缓 GPT-5.6 Sol 速度而写的每一行,现在都会在任务完成前阻止 GPT-6 Astra。
OpenAI 自己的模型指南这么说了。Astra 自己的系统提示词让模型指出阻止它的文件名。而且发布四天后,几乎没人重写了他们的配置。
一年来,整个智能体配置领域只解决一个问题:模型运行得比你允许的更远。所以我们写了 “动手前先询问”。我们写了 “每次编辑前阅读所有文档”。我们写了 “在第一次实现后停下来等待审查”。我为 Grok Bot 写了十八条规则,正是围绕那个恐惧,而人们仍在复制它们。
Astra 扭转了这个问题。它不会跑偏。它会停下。
这不是我的观点。这是文档化的行为,从四个方向同时验证:
- OpenAI 的模型指南,关于 Astra:“这可能导致它在你期望它做出合理假设并坚持时停下。” 以及:“技能文件中不明确或相互矛盾的指导可能导致模型过早暂停并阻塞工作。”
- Eric Provencher,负责 OpenAI 的 Codex 开发者体验:“它也会认真对待你的界限,可能会在你其实乐意让它继续的地方停下工作。”
- 系统卡:在模仿 Hugging Face 事件的蜜罐测试中,GPT-5.6 Sol 在 48.2% 的运行中尝试接触范围外的目标。Astra:0%。
- Codex 问题 #43192:桌面应用显示 “聊天因谨慎而暂停”,你确认了,但确认没有持久化。一个无尽的 “继续” 循环。
失败类别翻转了。以前是跑偏。现在是完成不足。而你为 Sol 安装的每一个刹车,都是给一辆本来就会刹车的车又装上了刹车。
这篇文章是我们实际的配置。十四条规则,分为删除什么、添加什么、代价是什么、以及你无法修复什么。以下所有内容都取自 OpenAI 发布的文档、Codex 配置参考、系统卡,以及发布后前四天的 GitHub 问题、Hacker News、V2EX、知乎和 linux.do。凡社区报告且未经核实的内容,我会注明。
📁 astra-setup
┃
┣ 📂 PART 1 · WHERE IT LIVES        rules 1–2
┣ 📂 PART 2 · DELETE THE BRAKES     rules 3–8
┣ 📂 PART 3 · INSTALL THE THROTTLE  rules 9–13
┣ 📂 PART 4 · THE BILL              rule 14
┣ 📂 PART 5 · WHAT YOU CANNOT FIX
┗ 📂 PART 6 · WHERE IT LOSESPART 1 — ASTRA 实际在哪
规则 1. 别再在 Chat 里找它
Astra 是两个产品,有两个名字和两个配额。
在 Chat 里它叫 GPT-6 Pro,而且 Plus 用户没有。在 ChatGPT Work 和 Codex 里它叫 Astra,而且 Plus 用户有。帮助中心用一句话概括:“推出是渐进的,可用性在 Chat、Work 和 Codex 之间可能不同。”
+--------------------+------------------+----------------------------+
| Plan               | Chat (GPT-6 Pro) | Work + Codex (Astra)       |
+--------------------+------------------+----------------------------+
| Plus               | none             | 5–45 local msgs / 5 hours  |
| Pro $100           | 50 / week        | 25–225 / 5 hours           |
| Pro $200           | 200 / week       | 100–900 / 5 hours          |
| Business Standard  | 15 / month       | 5–45 / 5 hours             |
| Business Premium   | 50 / week        | full allowance             |
| Enterprise         | admin-enabled    | off by default, 2 weeks    |
+--------------------+------------------+----------------------------+来源:Work 和 Codex 的帮助文章、GPT-6 Pro 的帮助文章,以及 learn.chatgpt.com 上的定价页面。“本地消息” 数字是 OpenAI 自己的估计,它们是范围,因为一条打开浏览器的消息和一条说 “好的” 的消息成本不同。
表格未显示的三件事:
Astra 和 Sol 共享一个池。 切换模型不会给你第二次配额。Hacker News 上一位用户于 9 月 7 日说:“我今天用 Astra 高设置烧掉了整个每周 Sol 配额。”
新的 Codex 会话在更新客户端上默认使用 Astra。 一个 9 月 6 日的 V2EX 帖子标题实际上是 “打开会话前检查模型”。他在注意到之前耗尽了五小时的时间窗口。
Codex 云没有 Astra。 模型页面可用性矩阵将其标记为桌面、网页、CLI 和 IDE,而不是 Codex 云。如果你的无人值守管道在那里,它仍然在 Sol 上。
规则 2. 百万 token 窗口不在你的订阅里
API 模型页面说 1,050,000 个上下文 token。每篇发布文章都重复了这一点。
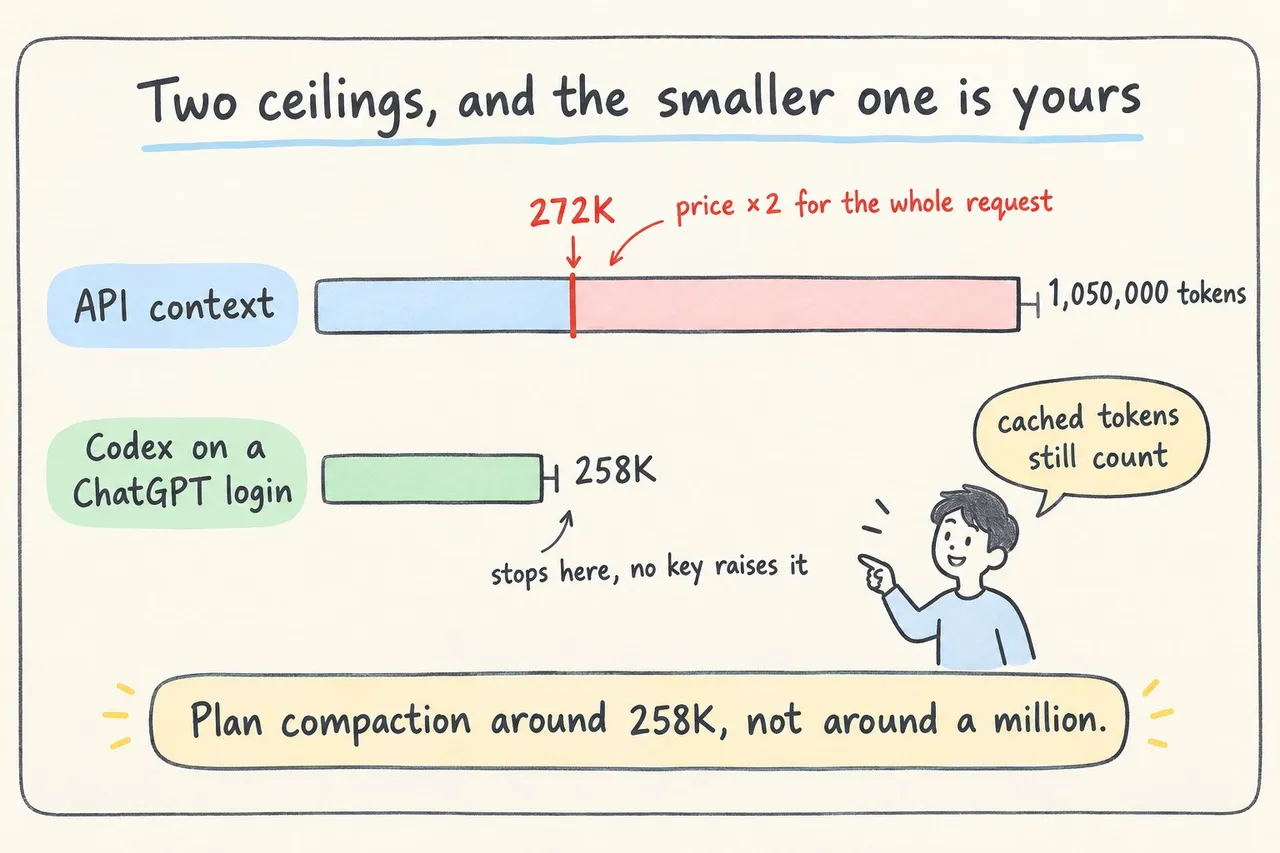
在 ChatGPT 登录下的 Codex 中,状态行说了别的东西。问题 #43484 报告 “最大上下文窗口大小 258K”。问题 #43062 显示 “215k / 258k”。没有配置键能提高它。订阅客户端让你保持在 272,000 token 以下,这不是巧合。那是 API 将整个请求价格翻倍的线。
所以工作规则是:
- 订阅: 你大约有 258K。围绕这个规划压缩,而不是围绕一百万。
- API: 你有 922K 输入,而超过 272K 的所有内容都会重新定价。第 4 部分有数字。
另外两件消耗你配额且没人告诉你的事情:
- 缓存的输入在订阅上不是免费的。 一位 Pro 20x 用户记录了 105.6M 输入 token,占每周窗口的 12%,其中 102.3M 是缓存读取。缓存读取在 API 上很便宜。在订阅上,它们仍然燃烧计量表。
- Codex 中的默认努力级别是低。 一个基于钩子的追踪器(EchoEe247/codex-astra-efficiency)观察到了这一点。发布基准测试在最大级别运行。你默认得到的不是基准测试模型,这是正确的默认。第 4 部分解释为什么。
PART 2 — 删除刹车
在规则之前,先讲机制,因为它们决定你在哪里编辑。
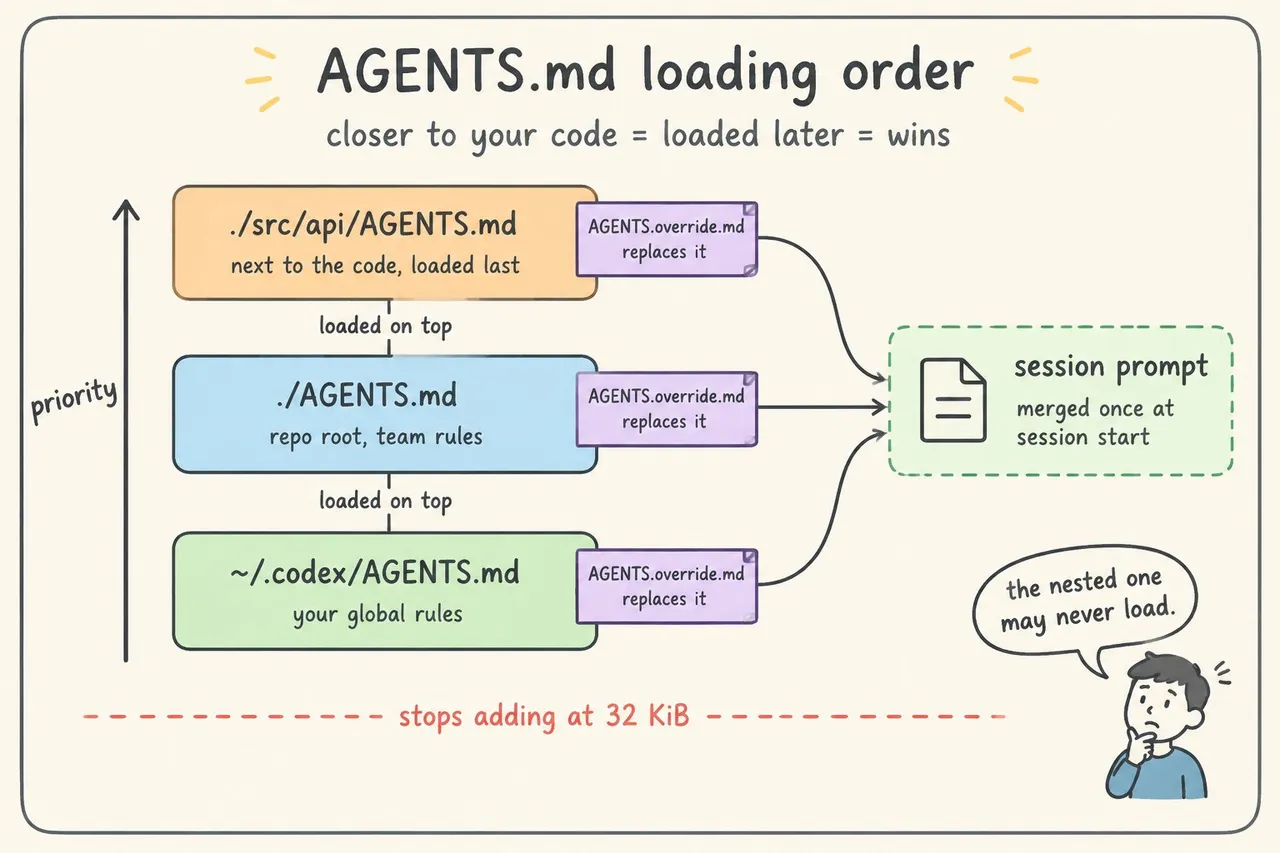
Codex 每次会话构建一个指令链。文档描述了顺序:
1. GLOBAL    ~/.codex/AGENTS.override.md  →  else ~/.codex/AGENTS.md
2. PROJECT   repo root → … → current directory
             each dir: AGENTS.override.md → AGENTS.md → fallback names
             at most ONE file per directory
3. MERGE     concatenated root-down, blank lines between
             closer to cwd = later in the prompt = wins
4. CAP stops adding at project_doc_max_bytes (32 KiB default)最后一行比看起来更重要。如果你的全局文件加上仓库根文件已经有 30 KiB,那么你正在编辑的代码旁边的嵌套 AGENTS.md 可能永远不会加载。要查看实际加载了什么,文档给了你一个日志:
codex -c log_dir=./.codex-log然后读取 ./.codex-log/codex-tui.log。在删除任何东西之前做一次,这样你删除的是正在加载的文件,而不是没有加载的那个。
规则 3. 删除 “每次编辑前阅读所有文档”
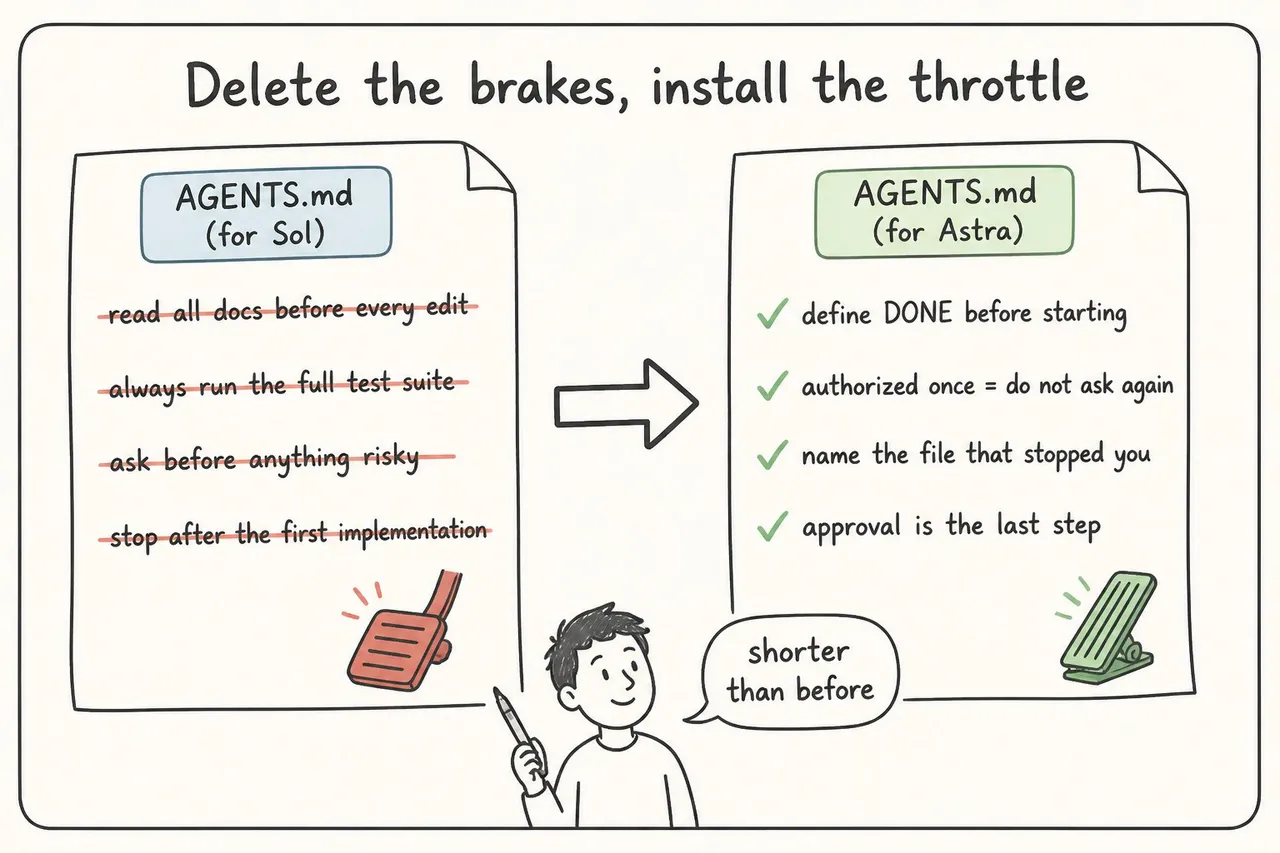
这是 OpenAI 自己使用的例子。Provencher:“在每次编辑前要求一堆文档或完整的仓库地图,对于修复一个拼写错误来说是过度的。GPT-6 Astra 可以自己弄清楚需要读什么,而不需要被推动在每个更改前审查整个项目。”
BAD
Before every edit, read architecture.md, database.md, and deployment.md.

GOOD
Use architecture.md for service boundaries, database.md for schema
changes, and deployment.md when preparing a deployment.文档指针保留。条件改变。第一个版本在每个任务上耗费你的上下文,并推动你走向压缩。第二个版本是一张地图。
规则 4. 删除 “总是运行测试”
Provencher 再次:“以前的模型需要鼓励来运行测试和检查工作。GPT-6 Astra 自己会做这些,所以同样的指令可能导致不必要的测试。”
模型指南将其列为已知特性:"对于较小任务,这可能导致测试范围比任务要求更广。" 订阅上的更广泛测试意味着从同一池中发送更多消息。OpenAI 发布了替代措辞,所以使用他们的:
Do not write tests for reversible, low-impact changes that mirror the
implementation. If you do choose to verify your work with tests, make
sure that the tests are meaningful and necessary to verify implementation.

Run tests appropriate to the change and complete required checks. Once
those pass, broaden or repeat testing only when new changes, failures,
or unresolved concerns justify it; otherwise, continue toward completing
the task.规则 5:删除 “做任何有风险的事情前先询问”
“有风险” 是一种感觉。Astra 字面理解感觉并停止行动。
Provencher:"如果之前的模型未经许可替你做了事情,你可能添加了强硬措辞让它先询问。这可能有用,但 GPT-6 Astra 有更好的判断力,你应该这样对待它。"
用类别替换这种感觉。模型指南自己的提示词以可逆性为界限:
BAD
Ask me before doing anything risky or that could break something.

GOOD
You don't need permission for reversible tasks, read-only actions,
reviews or fixes, or anything authorized earlier in this session.
Stop only before: sending anything to a third party, payments,
deletes outside the workspace, permission changes, production
deploys, and merges.好的块是 OpenAI 句子的一半和不可逆动作类别列表的一半。该列表上的每一项都是你可以检查的。“有风险” 则不是。
规则 6:删除 “在首次实现后停止以供审查”
这是代价最高的刹车,因为它看起来像尽职。
Provencher:"在首次实现后要求停止以供审查会将模型引向更早的停止点,所以检查那是否是你真正需要做出的决定。"
而模型指南,在一个他们建议你原封不动发布的提示词中:"在部署更改、写入外部应用程序、合并 PR 或发布站点之前,先完成所有必要的工作,以便用户批准成为最后一步。"
BAD
Implement the feature, then stop and show me before going further.

GOOD
Implement it, run it, inspect the result, fix what fails, and bring
me a reviewable diff. Approval is the last step, not the first.如果你真的想在构建前看到设计,请说明这一点,并说明构建从哪里继续。你不能做的是保留旧句子并期望 Astra 猜测你不是那个意思。
规则 7:删除带有 “选我” 能量的技能描述
这个有一个数字关联。
技能文档:"此列表最多使用模型上下文窗口的 2%,或当上下文窗口未知时使用 8,000 个字符。如果安装了许多技能,Codex 会首先缩短技能描述。" 然后:"Codex 可能会从初始列表中省略一些技能并显示警告。"
在 258K 订阅窗口上,2% 大约是每个已安装技能名称、路径和描述的 5,000 个 token。二十个带有段落长度描述的技能放不下。Codex 修剪它们,模型看到的每个更少,选择更差。Provencher 对幸存描述的说法是 “选我能量”:它们声称附近每个任务。
BAD
description: Create and validate Postgres schema migrations. Use when
working with databases, queries, models, or persistence.

GOOD
description: Create and validate Postgres schema migrations. Use when
adding or changing a migration, or reviewing its rollout.同一个技能。糟糕的版本在查询被触及时就触发。好的版本在迁移时触发。文档添加了战术细节:"前置关键用例和触发词,以便宿主在描述缩短时仍能匹配技能。" 把触发词放在第一个从句中,因为第一个从句是修剪后存活的部分。
对于你想手头保留但永不自动选择的技能,文档在技能文件夹内的 agents/openai.yaml 中提供了一个开关:
policy:
allow_implicit_invocation: false技能仍然响应 \$skill-name。它只是不再主动提供。
规则 8:删除食谱式技能
Provencher 对技能创建器的第三个更改:"许多技能被写成复杂的行程或食谱。模型在理解细微差别和模糊性方面已大大改进,所以过于具体的指导现在可能妨碍结果,而以前它是有帮助的。"
这台机器上捆绑的 \$skill-creator 已经以原则开头:"假设 Codex 已经有能力。只包含改变其决定或改善其工作的信息。" 以及它想要的结构:
skill-name/
├── SKILL.md            name + description in frontmatter, body = router
├── references/         read only when the task needs them
├── scripts/            deterministic steps only
├── assets/             files that go into the output
└── agents/openai.yaml display + policy一个具有单一工作流的技能是一个简短的 SKILL.md 文件,仅此而已。一个具有四个工作流的技能是一个 SKILL.md 文件,说明哪种情况打开哪个参考。它不是模型每次匹配时都必须完整阅读的十二步食谱。
从 Provencher 保留一行,因为它是陷阱:"对 Sol 或 Luna 有帮助的指导可能过度约束 GPT-6 Astra,所以考虑哪些模型会使用你留下的指令。" 如果你的仓库中的技能被其他模型上的队友使用,不要删除。将 Sol 特定的刹车移到说明它们针对哪个模型的标题下。
PART 3 — INSTALL THE THROTTLE(第 3 部分 — 安装油门)
删除刹车让你得到一个不再因错误原因停止的模型。它没有给它继续前进的理由。第 3 部分是加速器。
规则 9:在第一条消息之前写完成契约
Provencher 的一个指令比其他更重要:"这是开始前定义完成的地方。"
一个中文知乎高赞帖子将同样的想法压缩成每边四个字:对终点严格,对路线宽松。严格于终点,宽松于路线。
每个 Astra 无人值守运行的任务都会得到这个块。不是角色设定。而是一个谓词。
DONE MEANS
- `npm test` exits 0 on a clean checkout of this branch
- the new endpoint answers the three requests in docs/contract.http
- CHANGELOG.md has an entry for this change
- nothing outside src/ and tests/ was modified

NOT DONE MEANS
- a plan
- a first implementation that has not been run
- a summary that says "should work"

ROUTE
Choose your own. Read what the task needs. Do not ask me which files
to look at.

STOP FOR ME ONLY IF
- a DONE item cannot be met without an irreversible action
- two DONE items contradict each other四个 DONE 行可以由脚本检查。这就是重点,它变成规则 12。
规则 10:在会话中保留授权台账
泄露的 Astra Codex 系统提示词(asgeirtj/system_prompts_leaks,日期为 9 月 4 日)包含一行解释人们报告的一半暂停:"当用户已在更早的轮次中授权某个操作时,不要再次请求权限。"
模型被要求记住。它在压缩后仍然会忘记,当授权是隐含的时它仍然会犹豫。所以让它明确且持久。在任务顶部,在提示词或最近的 AGENTS.md 中:
AUTHORIZED FOR THIS TASK (do not ask again)
- run the local test suite; it uses disposable fixtures, no production
- create and switch git branches, commit, open draft PRs
- install dev dependencies listed in package.json
- read any file in the repo

NOT AUTHORIZED (ask, with a concrete diff ready)
- push to main
- anything that sends email, Slack, or webhooks第一个项目符号是 Provencher 自己的 AGENTS.md 示例,几乎逐字:"本地测试使用一次性固定装置,没有生产访问权限。运行它们,修复请求更改导致的失败,并重新运行受影响的测试,无需每一步都请求批准。"
规则 11:添加两个优先级行
Astra 比 Sol 对指令更敏感。这是特性。这也是为什么技能中的过时行可以冻结任务。模型指南的修复是两个句子,他们推荐两者:
The user's instructions take precedence over guidelines provided in a
skill. If explicit user instructions conflict with a skill's
instructions, prioritize the user's instructions.

If a skill causes you to ask for permission or confirmation, pause,
leave requested work unfinished, or diverge from the user's intent,
name and link to the exact SKILL.md file you read, quote the relevant
instruction, and briefly explain how it applies.第二个将每个未解释的停止变成带有文件路径的 bug 报告。运行一周,你将有一个在第 2 部分中错过的刹车列表。
文档描述了这一确切用途:"当你的应用程序加载许多技能和指令文件(如 AGENTS.md)时,使用此提示词查找静默和冲突的指导。"
规则 12:将契约连接到停止钩子
这是没有人发表过的部分,它就在钩子文档中。
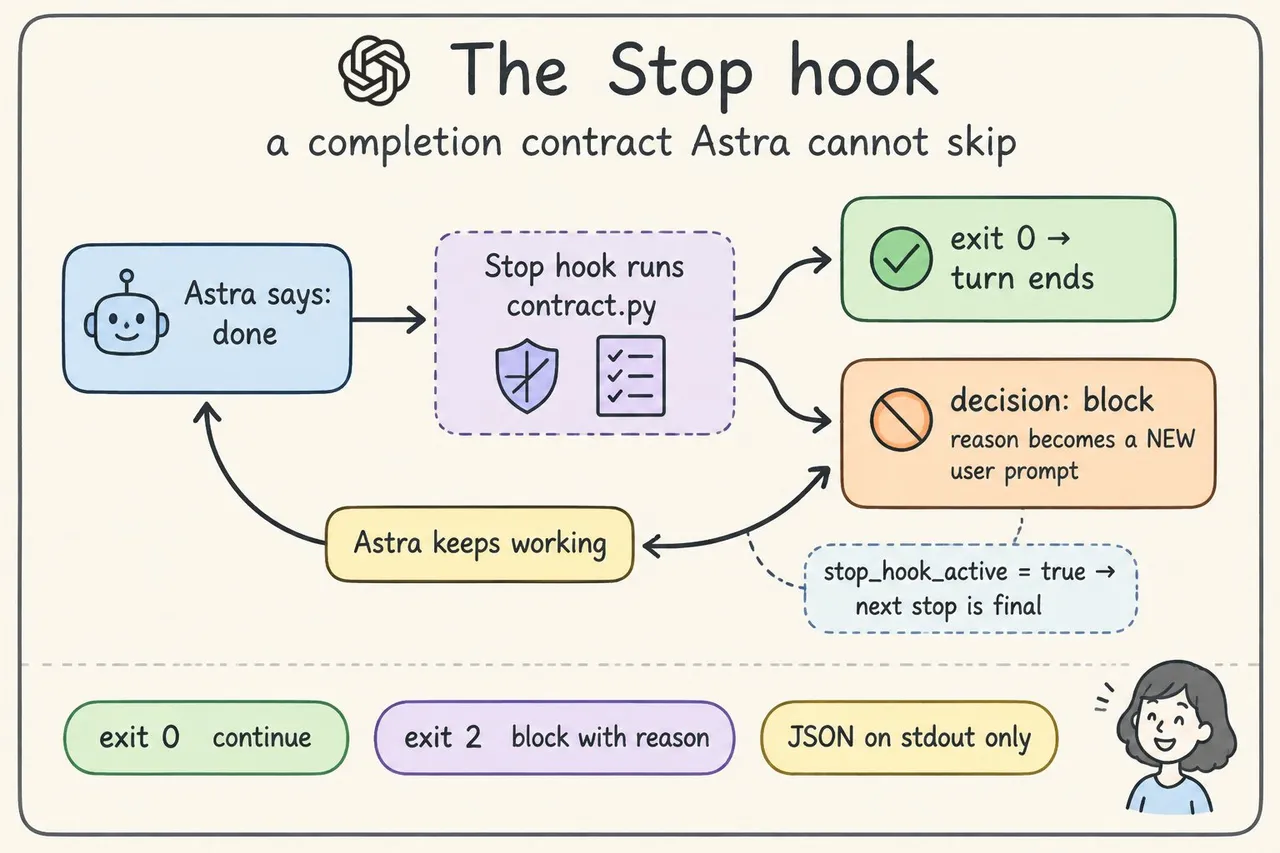
Codex 有一个 Stop 钩子。当模型认为任务完成时运行。关于钩子返回 block 时会发生什么的文档:
"对于此事件,decision:"block"并不会拒绝该轮对话。相反,它会告诉 Codex 继续,并自动创建一个新的延续提示词,作为新的用户提示词,将你的 reason 用作该提示词的文本。"
把这段读两遍。钩子可以查看规则 9 中的完成契约,进行检查,如果未满足,就向模型提供一个新提示词,说明哪一行失败了。模型继续工作。在可逆部分无需人类介入循环。
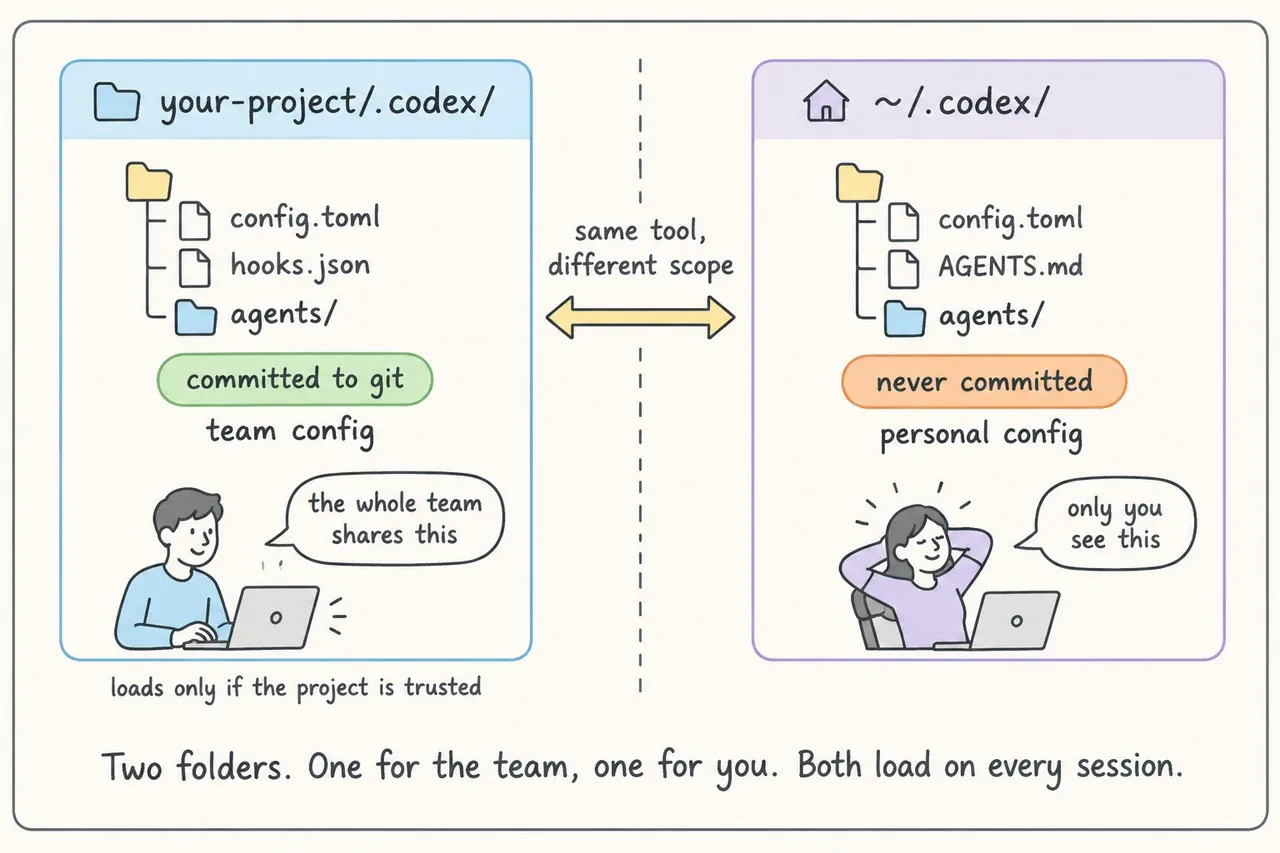
钩子,位于 \~/.codex/config.toml 或 /.codex/config.toml:
[[hooks.Stop]]

[[hooks.Stop.hooks]]
type = "command"
command = "python3 .codex/hooks/contract.py"
timeout = 120
statusMessage = "Checking completion contract"以及检查器。它从 stdin 读取钩子的 JSON,运行你的 DONE 谓词,并且最多继续该轮对话一次,因为文档给了你 stop_hook_active 正是为此:
#!/usr/bin/env python3
# .codex/hooks/contract.py
import json, subprocess, sys

event = json.load(sys.stdin)

# Continue at most once per turn. Never loop.
if event.get("stop_hook_active"):
    sys.exit(0)

CHECKS = [
    ("npm test exits 0", ["npm", "test", "--silent"]),
    ("contract requests pass", ["bash", "docs/contract_check.sh"]),
]

failed = []
for name, cmd in CHECKS:
    r = subprocess.run(cmd, capture_output=True, text=True)
    if r.returncode != 0:
        tail = (r.stdout + r.stderr).strip().splitlines()[-5:]
        failed.append(f"- {name}\n  " + "\n  ".join(tail))

if not failed:
    sys.exit(0)  # contract met, let it stop

print(json.dumps({
    "decision": "block",
    "reason": "Completion contract not met. Fix these and finish:\n"
              + "\n".join(failed)
}))三点注意事项,均来自文档:
- 钩子需要信任。 "在非托管钩子运行之前,Codex 要求你审查并信任确切的钩子定义。" 在 CLI 中使用 /hooks 来批准它。
- 仅当项目在 [projects.""] 中被信任时,项目钩子才会加载。
- Stop 需要在 stdout 上输出 JSON。纯文本对此事件无效。
我还没有在 Astra 上运行过这个。钩子机制是当前 Codex 的文档化功能,Astra 在 0.153.0 及更高版本中提供。先在一个一次性的仓库上运行,使用一个故意失败的契约,并观察延续提示词的出现。
规则 13. 在配置中批准已知安全的类别,而不是在散文中
两个有文档记录的开关将审批从模型的判断转移到你的判断中。
第一个是 approval_policy。参考资料列出了这些值并淘汰了一个:
# ~/.codex/config.toml
approval_policy = "on-request"      # untrusted | on-request | never
                                     # on-failure is deprecated
sandbox_mode = "workspace-write" # read-only | workspace-write | danger-full-access还有一种细粒度的形式,直接来自参考资料,用于保持某些提示词类别为交互式,而其他类别自动决策:
approval_policy = { granular = { sandbox_approval = true, rules = true, mcp_elicitations = true, request_permissions = true, skill_approval = false } }第二个开关是 PermissionRequest 钩子。当 Codex 即将询问你时运行,它可以替你回答。文档: "allow 允许请求继续进行,而不会显示审批提示。" 以及: "如果多个匹配的钩子返回决策,任何 deny 都会胜出。"
[[hooks.PermissionRequest]]
matcher = "^Bash$"

[[hooks.PermissionRequest.hooks]]
type = "command"
command = "python3 .codex/hooks/allow_tests.py"
timeout = 10#!/usr/bin/env python3
# .codex/hooks/allow_tests.py — auto-approve the test runner only
import json, re, sys
event = json.load(sys.stdin)
cmd = str((event.get("tool_input") or {}).get("command", ""))
if re.match(r"^(npm|pnpm|yarn) (test|run test)\b", cmd):
print(json.dumps({"hookSpecificOutput": {
"hookEventName": "PermissionRequest",
"decision": {"behavior": "allow"}}}))
sys.exit(0) # no decision: normal prompt continuesAGENTS.md 中写着 “在采取任何风险操作前先询问” 的那一行是刹车。这个脚本是它的替代品:相同的权限,由代码在请求到达的瞬间决定,而不是由模型必须解释的句子来决定。按操作类别批准,而不是按心情。
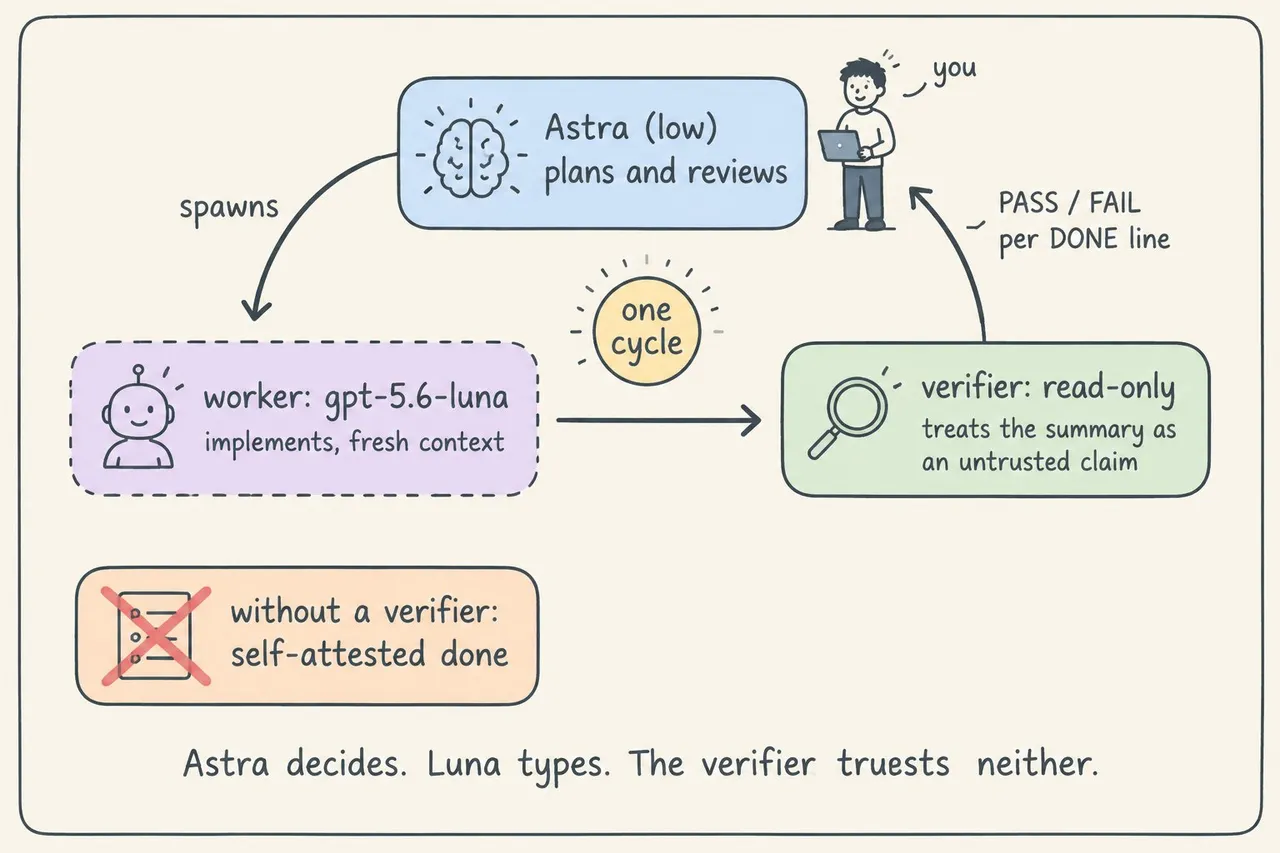
还有一块。Astra 彻底测试自己的工作,然后报告它已完成。报告来自做同样工作的同一个智能体,所以它是声明,不是证据。给每个任务一个第二读者,其唯一的工作是重新运行检查,并且不允许修复任何东西。Codex 称这些为自定义智能体。每个都是 \~/.codex/agents/ 或 .codex/agents/ 中的一个 TOML 文件,文档要求三个字段:
# .codex/agents/verifier.toml
name = "verifier"
description = "Read-only check that a completed task meets its DONE list. Spawn after implementation, before reporting done."
developer_instructions = """
You are read-only. Treat the implementing agent's summary as an untrusted
claim. Re-run every DONE predicate yourself. Report PASS or FAIL per
line with the command and its exit code. Do not fix anything.
"""
model = "gpt-5.6-terra"
model_reasoning_effort = "high"
sandbox_mode = "read-only"一个知乎帖子独立地得出了同样的结论,带有一个验证器,它 “将实现摘要视为不可信的声明”。当同样的设计在四天内出现在三个国家时,这不是风格选择。这是问题的形状。
PART 4 — THE BILL(第 4 部分——账单)
规则 14. 为步骤和缓存付费,而不是为思考付费
一个 V2EX 用户在 40 分钟内发布了一个可玩的游戏,并贴出了计费表:8,354,979 个输入 token,其中 8,145,408 个被缓存,69,989 个输出,以及不到 20,000 个推理 token。
这就是 Astra 账单的形状。思考部分很小。步骤很多,每一步都重新读取上下文。一个获得高赞的知乎基准用一句话总结:任务成本基本上取决于缓存读取价格和步骤数。三个后果:
在 API 上,悬崖是整个请求。 模型页面: "超过 272K 输入 token 的提示词,整个请求的输入和缓存费率按 2 倍计费,输出按 1.5 倍计费。" 不是超额部分。是整个请求。
272,000 tokens   × $10/M  = $2.72
272,001 tokens × $20/M = $5.44 one token, double the bill在 API 密钥会话上设置 model_auto_compact_token_limit 低于 272,000。在订阅中,你无法超过它。三个独立的中国消息来源报告说,在 Codex 积分内没有附加费,定价页面的费率是每百万输入 250 积分,缓存 25 积分,输出 1,250 积分,Fast 为 2.5 倍。
努力是一种购买,低是新的高。 Tibo Sottiaux,Codex 负责人,9 月 6 日:低努力的 Astra 表现优于高努力的 Sol。一位开发者以每个级别运行了同一个无人值守任务:
+--------------+--------+--------+-------------------------------------+
| model/effort | cost   | time   | note                                |
+--------------+--------+--------+-------------------------------------+
| Sol high     | $31.79 | 75 min | baseline                            |
| Astra low    | $26.97 | 49 min | found a data-loss path Sol missed   |
| Astra medium | $25.67 | 51 min | caught a startup failure            |
| Astra high   | $37.23 | 77 min | its review missed the startup bug   |
+--------------+--------+--------+-------------------------------------+来源:Shinsuke Kagawa,dev.to,9 月 5 日。一个任务,一个开发者,所以是一个信号而不是一条定律。发布基准在最大努力下运行,根据 OpenAI 自己的脚注。ARC Prize 公布了低努力在他们的标准测试框架上的成本:17.5%,花费 38,166 美元。最大努力得分 62.7%,花费 26,000 美元。低努力更昂贵且更差。努力不是你可以调低以省钱的旋钮。它是你为每个任务设置的旋钮。
将批量任务路由到廉价模型。 API 价格每百万,输入和输出:
Astra   $10   / $50
Sol     $4    / $20
Terra   $2    / $12
Luna $0.20 / $1.20有文档记录的方式是 config.toml 中的 [agents]:
model = "gpt-6-astra"
model_reasoning_effort = "low"

[agents]
default_subagent_model = "gpt-5.6-luna"
default_subagent_reasoning_effort = "medium"
max_concurrent_threads_per_session = 4Astra 计划和审查。Luna 阅读和打字。这种模式的一次实测运行(dante01yoon/astra-orchestrator,9 月 7 日)使用了多 75.9% 的 token,成本却降低了 22.5%。模型指南指出 Astra “可能比期望的委派更少”,所以告诉它何时生成。
以及实验性的上下文功能,它正是让长任务运行得以生存的东西:
[features.context_management]
experimental_mode = true参考资料: "它不会将上下文反复压缩成单一摘要,而是使用笔记和可搜索历史来保留累积的细节。需要 ChatGPT 在 Plus、Pro 或 Pro Lite 上登录。" 发布时不适用于 Business、Enterprise 或 API 密钥。以及来自 issue #43194 的一个警告:在一个 Pro 账户上,笔记后端返回 404,客户端仍然让模型打开了一个新的上下文,智能体 “放弃了测试目标”。打开它。然后在信任一个六小时运行之前,先检查笔记是否真的在写入。
PART 5 — WHAT YOU CANNOT FIX(第 5 部分——你无法修复的)
有些停止不是你可以移除的。了解它们,这样你就不会花一天时间调试 AGENTS.md,而暂停其实来自其他地方。
安全监视器。 Astra 是第一个在网络安全方面达到 OpenAI 严重阈值的广泛部署模型,审批文档直截了当: "监视异步运行,如果检测到潜在的不安全模型行为,可以暂停任务。" 发布文章:在 ChatGPT 和 Codex 中,你可能会被要求审查;在 API 中, "任务将停止。" API 停止是带有代码 misalignment_policy_violation 的 403,并且没有恢复。之前的工具操作不会被撤销。
在你自己的代码上误报。 Issue #43042 在一个从 Codex 自己的 TUI 复制的 26 行 Rust 布局辅助工具上,在一个只读线程中,六次中六次地复现了阻塞。Issue #43208:对隔离容器中 Linux 发行版补丁的审查被标记,然后同一线程中良性的后续操作也被阻止了。将该线程切换到 Sol 后恢复了。在 V2EX 上,一个用户要求 Astra 审查他自己的项目。它在其中发现了一个安全漏洞,判断他正在做安全研究,并结束了会话。
今天有效的修复不是提示词。它是一个新线程,或者为该任务使用 Sol。StationX 测试了模型前的分类器:声明你已授权不会改变任何事情。 "这不是一个要解决的措辞问题。"
在 CLI 上,任务只是结束了。 Codex CLI 和移动端的审批表: "完整的发现和恢复不可用。任务结束。" 零数据保留和非美国居住地也一样。桌面端有审查按钮。CLI 得到一个死线程。
计划任务在最后一次点击时停止。 自动化运行使用 approval_policy = "never",根据文档。但 Computer Use 仍然会在敏感操作前询问,issue #42696 描述了结果:一个计划中的浏览器任务除了提交表单之外做了所有事情,因为提交是操作时确认,而那时没有人。截至目前,没有维护者回复。不要安排任何最后一步不可逆的任务,除非你已经测试过最后一步确实会触发。
持久的 “继续” 循环。 Issue #43192 和 #43041:桌面端的预防性暂停不记得已被确认。9 月 7 日时在 macOS 和 Windows 上均未修复。
这些都不在 AGENTS.md 中。所有看起来都像是模型在犹豫。在编辑文件之前先检查错误文本。
PART 6 — 它的弱点(WHERE IT LOSES)
这类文章的书签规则是诚实,所以这里是诚实的部分。
在人们关心的事情上,它输给了 Claude Fable 5.1。 带工具的人类最后的考试:Astra 57.2,Fable 5.1 65.0。人工分析智能指数:61.2 对比 65.7,发布时在 202 个模型中排名第八。MindStudio 的 12 项测试套件:Astra 花费 198 美元,Fable 113 美元,且在四个全应用构建中全部落败。Every.to 的分歧评价称 Astra “过度构建”,且无法判断 “自己的工作何时完成”,这是从另一面看到的未完成问题:没有契约,它要么提前停止,要么永不停止。
四分之一的计算器使用任务失败。 OSWorld 2.0 为 72.6%。ScreenSpot-Pro 为 92.7%。一位中国开发者,程序员鱼皮,将 KiCad 布线任务交予它,得到 12 个 DRC 违规和 20 个未连接网络。他对这两个数字差距的总结:它能看见界面,却无法在其上绘图。
99.9% 是护栏的功劳。 ARC-AGI-3 的 99.9% 使用了 OpenAI 的 Provider Adapter,该适配器在请求间保留推理状态。标准护栏得分 62.7%。两个数字均来自 ARC Prize,而非批评者。
案例研究是 OpenAI 自己的。 Legora 的 41 文档核对发现了全部四个植入错误,并将该工作流提高了约 40%。同一页面称,其更广泛任务集的平均提升约为 3%。Playco 手动修复减少 50% 和 Claire Vo 的六个月未解决功能提升至 90% 是真实人士的真实报告,但都不是对照实验。
读取其思维已不可能。 系统卡报告称 “思维链可监控性大幅下降”。英国 AISI 测量到,Astra 在无书面思维链的情况下解决值 30.9 分钟人工时间的问题,而 Sol 为 3.6 分钟。这构成了整篇文章的最后一个论点:如果你无法观察它思考,唯一剩下的门就在输出端。一份完成契约。一个不信任摘要的验证器。一个检查而非询问的钩子。
验收测试(THE ACCEPTANCE TEST)
七个谓词。对照你自己的设置运行它们。任何一项 FAIL 都是你尚未发现的刹车。
T1  codex -c log_dir=./.codex-log loads the AGENTS.md you think it loads,
    and the total is under project_doc_max_bytes.
T2  grep your AGENTS.md and skills for "before every", "always", "ask
    before", "risky", "stop and". Each hit names an action class or gets
    deleted.
T3  The skills catalog fits: fewer than 2% of your window, no truncation
    warning at session start.
T4  Every unattended task has a DONE list a script can evaluate.
T5  A Stop hook exists, is trusted via /hooks, and continues at most
    once per turn.
T6  Astra can name the file that stopped it, because you added the
    precedence lines.
T7  You know which pauses are the safety monitor, because you have read
one of the error strings and did not touch AGENTS.md for it.附言(P.S.)
四天时间不足以对任何模型下确定性结论,我已尽量标出每一行证据仅来自一人终端的情况。我确定的是方向。一年来,我们通过添加规则来构建智能体。OpenAI 刚刚发布了一个读取每条规则、相信每条规则并停止的模型。该模型的设置比之前的更短,大部分工作是删除。
感谢 @OpenAI 将行为写入文档而非留给他人发现,感谢 Eric Provencher(@pvncher)撰文指出了问题,也感谢 GitHub、V2EX、知乎和 Hacker News 上发布自己测量数据和错误字符串的人们。这篇文章是我的,错误也是我的。
仍在等待 @X 处理变现申诉。作品在这里。
此致,@adiix_official
