技能介绍
Summarize 是一个从 URL、文件和媒体中快速生成摘要的工具,由 Peter Steinberger 制作,可在终端、Chrome 侧边栏和 Firefox 侧边栏中使用。
它要解决的问题很直接:一键生成网页与视频的精炼摘要,并自动提取关键幻灯片。通过浏览器侧边栏或命令行,你可以快速获取网页、YouTube 视频、播客及各类文件的智能摘要与幻灯片提取。
适用场景
- 看到一个长网页,想先拿到核心要点再决定要不要细读。
- 看 YouTube 视频或本地视频时,需要摘要以及关键画面的幻灯片截图。
- 处理 PDF、音频、视频等文件,希望自动转写并摘要。
- 订阅了播客 RSS、Apple Podcasts 或 Spotify 单集,想快速读完最新一期。
- 在终端里把摘要串进脚本:需要机器可读的 JSON 输出与指标。
核心能力
- Chrome 侧边栏聊天:在侧边栏内提供流式智能体对话和历史记录。
- 视频幻灯片:为 YouTube、直接视频 URL 和本地视频文件提供截图 + OCR + 字幕卡片。
- 媒体感知摘要:自动检测视频/音频与页面内容。
- 编码 CLI 后端:支持 Codex、Claude、Gemini、Cursor Agent、OpenClaw、OpenCode、GitHub Copilot、Antigravity、pi。
- 流式 Markdown:包含指标和缓存状态。
- CLI 支持:URL、文件、播客、YouTube、音频/视频、PDF。
输出长度:--length 控制要求输出的量(指导性,并非硬性限制),内置默认值为 long,可在 ~/.summarize/config.json 中通过 output.length 设置。预设值为 short|medium|long|xl|xxl;当提取到的内容短于请求长度时,CLI 会原样返回内容,可用 --force-summary 覆盖并强制运行 LLM;--length 数值必须 >= 10 个字符,--max-output-tokens 必须 >= 16。各预设的目标字符数(来源 packages/core/src/prompts/summary-lengths.ts):short 约 900(600-1,200)、medium 约 1,800(1,200-2,500)、long 约 4,200(2,500-6,000)、xl 约 9,000(6,000-14,000)、xxl 约 17,000(14,000-22,000)。
支持的文件类型(尽力而为,取决于提供商):text/* 与常见结构化文本(.txt、.md、.json、.yaml、.xml 等);PDF;图片 image/jpeg、image/png、image/webp、image/gif;音频/视频 audio/*、video/*(本地音视频在模型支持时会自动转写)。如果提供商拒绝某种媒体类型,CLI 会快速失败并显示友好消息;xAI 模型不支持通过 AI SDK 附加通用文件(如 PDF),这些情况请使用 Google/OpenAI/Anthropic。
限制:超过 10 MB 的文本输入在分词前会被拒绝;文本提示会针对模型输入限制(LiteLLM 目录)进行预检查,使用 GPT 分词器。
效果预览
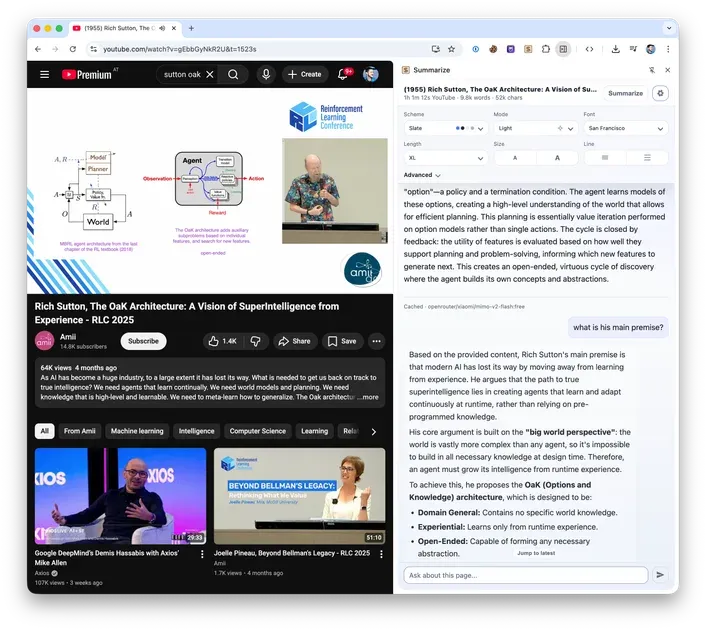
Chrome 扩展:一键总结当前标签页,Chrome 侧边栏 + Firefox 侧边栏 + 本地守护进程,支持流式 Markdown。
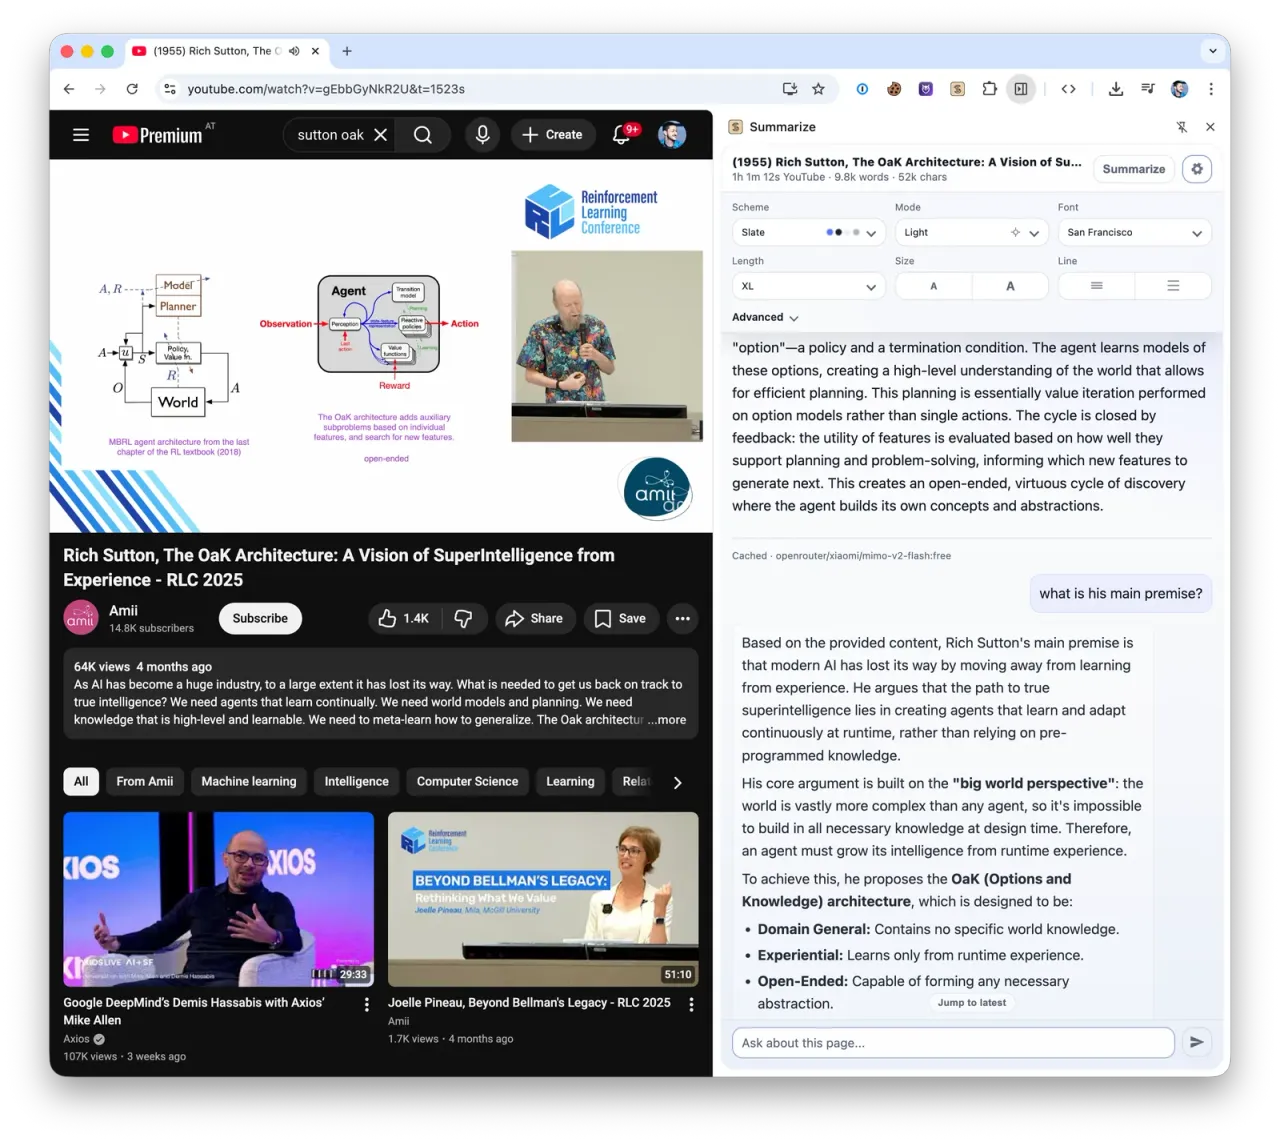
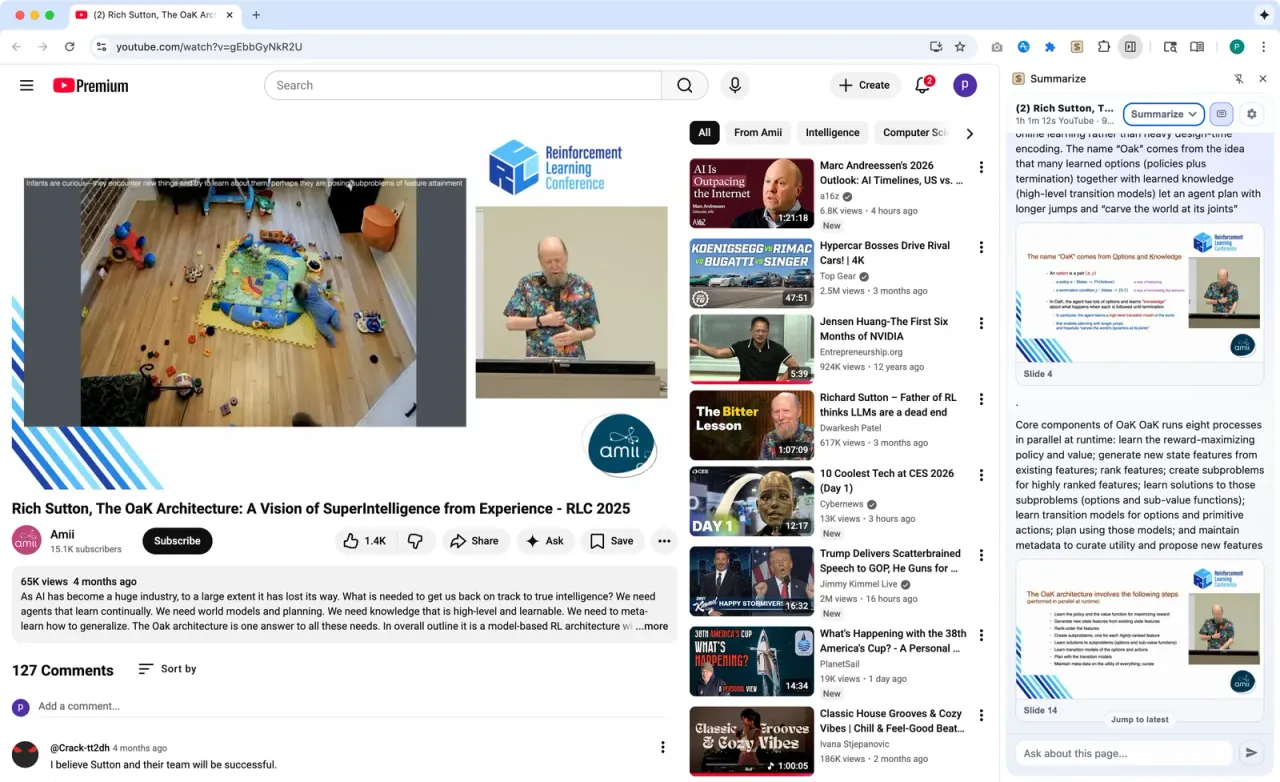
YouTube 幻灯片截图(来自浏览器):
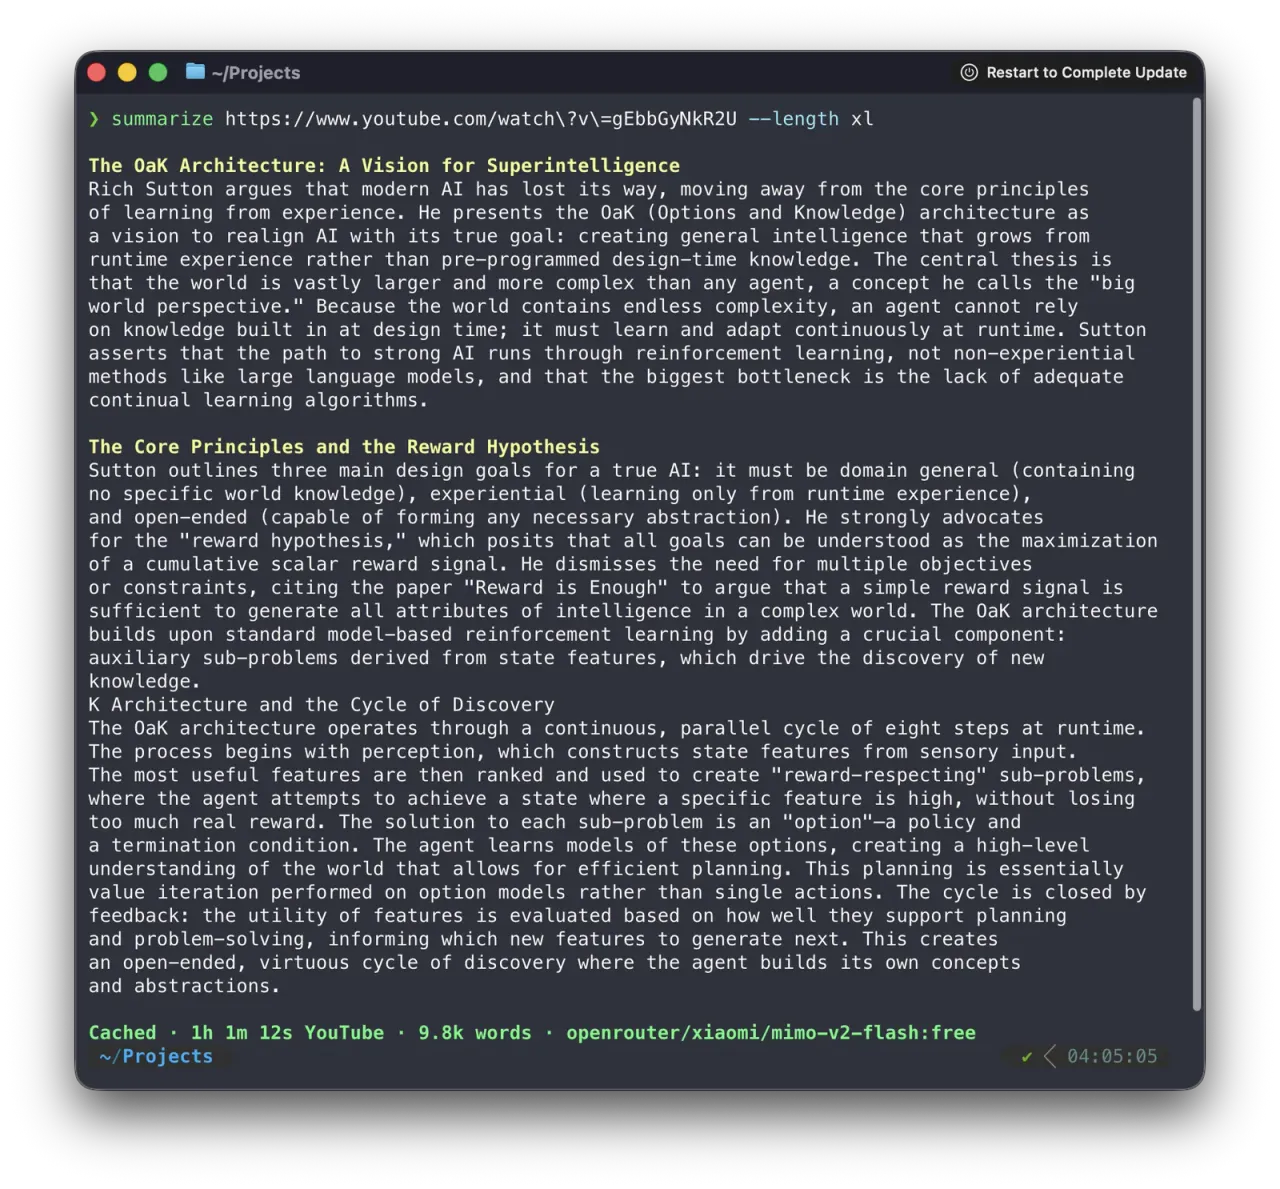
CLI:
工作方式
浏览器扩展的入门流程是:安装扩展并打开侧边栏;选择 Direct 或 Daemon——Direct 模式在未配置提供商密钥时默认使用 Gemini Nano,或从 Chrome 调用你选择的提供商;再选择浏览器媒体以进行无守护进程的转录/幻灯片。可选:安装 CLI 并配对守护进程,以获得原生工具、CLI 模型回退、OCR 和更广泛的媒体支持。
扩展的几点约束:仅当侧边栏打开时才进行摘要;自动模式会在导航(包括 SPA)时自动总结,否则使用按钮;守护进程仅限本地主机,需要共享令牌;自动启动支持 macOS(launchd)、Linux(systemd 用户)、Windows(计划任务)。
幻灯片:在 Summarize 选择器中选择 Video + Slides,幻灯片在顶部渲染,可展开为带时间戳的全宽卡片;点击幻灯片可跳转到视频对应位置;当 OCR 显著时可切换 Transcript/OCR。浏览器模式使用 MediaBunny,通过原生 WebCodecs 和范围网络读取来获取可获取的视频,当源或编解码器不可用时回退到可见标签页捕获;守护进程模式额外提供 yt-dlp、原生 ffmpeg 和可选的 tesseract OCR。
CLI 侧的媒体处理链路:非 YouTube URL 会经过 fetch -> extract 管道,当直接 fetch/extract 被阻止或内容太少时,--firecrawl auto 可以回退到 Firecrawl(如果已配置)。--youtube auto 首先尝试尽力而为的网页字幕端点,字幕不可用时依次回退到 yt-dlp + Whisper、Android VR 直接音频 + 配置的转写链、Apify。本地音频/视频文件先被转写再摘要;--video-mode transcript 强制直接媒体 URL 先经过 Whisper。自动模式在配置时首先尝试 Groq,然后尝试本地 ONNX/whisper.cpp,再尝试云端回退。
自动模型排序:--model auto 根据内置规则(或你的 model.rules 覆盖)构建候选尝试;当设置了 cli.enabled 或隐式自动选择处于活动状态时,CLI 尝试会被前置。默认回退行为:仅当未配置 API 密钥时,顺序为 claude, gemini, codex, agent, openclaw, opencode, copilot,并记住/优先使用最后一个成功的提供商(~/.summarize/cli-state.json)。
你需要提供
- Node 24+。
- 与你选择的
--model匹配的 API 密钥(例如OPENAI_API_KEY、GEMINI_API_KEY、ANTHROPIC_API_KEY、XAI_API_KEY、Z_AI_API_KEY、NVIDIA_API_KEY、MINIMAX_API_KEY)。 - 可选的本地依赖:
ffmpeg(可选的原生加速器,支持更广泛的编解码器;回退使用内置 WebAssembly 版本)、yt-dlp(YouTube 幻灯片提取和某些远程媒体流程需要)、tesseract(可选,用于--slides-ocr)。
macOS(Homebrew)安装可选依赖:
brew install ffmpeg yt-dlp
brew install tesseract # 可选,用于 --slides-ocr配置集中在 ~/.summarize/config.json,运行 summarize status 可检查有效默认模型、配置的预设和模型提供商。优先级为:--model > SUMMARIZE_MODEL > ~/.summarize/config.json > 默认值(auto)。配置以宽松方式解析(JSON5),但不允许注释,未知键将被忽略。
你会获得
- 网页、文件、视频、播客的摘要(流式 Markdown,带指标与缓存状态)。
- 视频幻灯片截图、可选的 OCR 结果与带说话人标签的字幕(
--diarize)。 - 提取到的原始内容(
--extract会打印提取内容并退出)。 - 机器可读输出:
--json提供诊断信息、提示、metrics和可选的摘要。 - 幻灯片提取场景下,图像写入
./slides/(或--slides-dir),OCR 结果包含在 JSON 输出中并存储在slides.json。
使用示例
快速开始:
summarize "https://example.com"检查有效模型配置:
summarize status
summarize status --verbose
summarize status --probe
summarize status --json各类输入:
summarize "/path/to/file.pdf" --model google/gemini-3-flash
summarize "https://example.com/report.pdf" --model google/gemini-3-flash
summarize "/path/to/audio.mp3"
summarize "/path/to/video.mp4"标准输入(使用 - 管道输入):
echo "content" | summarize -
pbpaste | summarize -YouTube(支持 youtube.com 和 youtu.be):
summarize "https://youtu.be/dQw4w9WgXcQ" --youtube auto播客 RSS(转写最新一集):
summarize "https://feeds.npr.org/500005/podcast.xml"Apple Podcasts 单集页面:
summarize "https://podcasts.apple.com/us/podcast/2424-jelly-roll/id360084272?i=1000740717432"Spotify 单集页面(尽力而为,独家内容可能失败):
summarize "https://open.spotify.com/episode/5auotqWAXhhKyb9ymCuBJY"HLS 播放列表:
summarize "https://example.com/master.m3u8"幻灯片提取:
summarize "https://www.youtube.com/watch?v=..." --slides
summarize "https://www.youtube.com/watch?v=..." --slides --slides-ocr
summarize "/path/to/video.webm" --slidesOpenAI 快速模式与思考模式(它们是请求选项,不是模型 ID):
summarize "https://example.com" --model openai/gpt-5.5 --fast --thinking medium
summarize "https://example.com" --model openai/gpt-5.4 --service-tier fast --thinking low常用标志(摘要):--model auto 自动选择模型 + 回退(默认);--timeout(30s、2m、5000ms,默认 2m);--retries(超时或临时 API 失败后的 LLM 重试次数,默认 1);--length short|medium|long|xl|xxl|s|m|l|;--language, --lang(auto = 匹配源语言);--cli [provider](支持 claude、gemini、codex、agent、openclaw、opencode、copilot、agy、pi);--stream auto|on|off;--plain;--no-color;--theme(aurora、ember、moss、mono);--format md|text;--markdown-mode off|auto|llm|readability;--extract;--slides、--no-slides、--slides-ocr、--no-slides-ocr、--slides-dir、--slides-max(默认 6);--json;--verbose;--metrics off|on|detailed(默认 on)。
编码 CLI 作为本地模型后端(要求二进制已安装并在 PATH 中、提供商已认证):codex -> --cli codex;claude -> --cli claude;gemini -> --cli gemini;agent(Cursor Agent CLI)-> --cli agent;copilot(GitHub Copilot CLI)-> --cli copilot;pi(Pi Coding Agent)-> --cli pi。内置预设 --model codex-fast 使用 GPT-5.5 Fast 模式运行 Codex,需要 codex login。
如果 --model free(一组默认的 OpenRouter :free 模型)停止工作,运行:
summarize refresh-free模型 ID 使用网关风格。示例:openai/gpt-5.4、openai/gpt-5-mini、github-copilot/gpt-5.4、anthropic/claude-sonnet-4-5、xai/grok-4-fast-non-reasoning、google/gemini-3-flash、zai/glm-4.7、minimax/MiniMax-M3、openrouter/openai/gpt-5-mini。
安装到 Cola:安装到 Cola
遇到问题时的排查要点:
- "Receiving end does not exist":Chrome 尚未注入内容脚本。扩展详情 -> 站点访问 -> 在所有站点上(或允许此域名)。重新加载标签页一次。
- "Failed to fetch" / 守护进程无法访问:运行
summarize daemon status;对于非默认端口,确认 Options → Runtime → Daemon → Port 与守护进程配置一致;日志在~/.summarize/logs/daemon.err.log。