
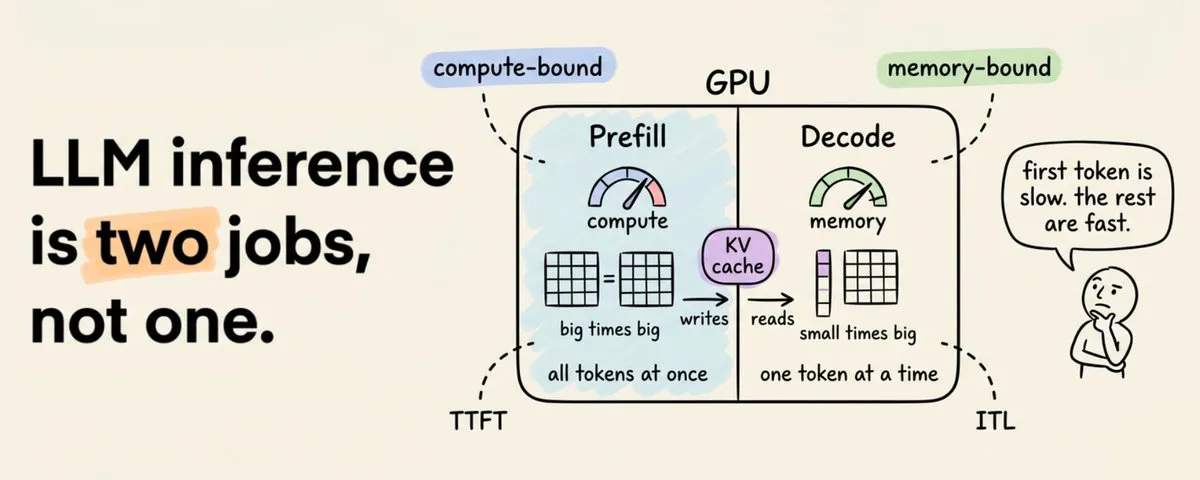
一篇从第一性原理出发的梳理,带你看清从输入 prompt 到流式输出响应之间到底发生了什么:tokenization、embeddings、attention、prefill / decode 两阶段拆分、KV caching,以及 quantization。
你输入一个 prompt。几百毫秒后,文字开始一个 token 一个 token 地流回到你眼前。看起来很简单,其实完全不是。
从你敲下按键到第一个 token 出现之间,经历的是现代计算里一条被精心打磨到极致的处理流水线。而最反直觉的地方在于:模型为了回答你,实际上在同一次请求、同一块 GPU 上,完成了两种完全不同的工作,而且它们各自有完全不同的瓶颈。
一旦你看明白这一点,你就再也不会用同样的眼光看待一次 generate() 调用了。
心智模型
LLM 本质上是一个“预测下一个 token”的神经网络。一次只预测一个 token。然后把这个 token 接到你的 prompt 末尾,再预测下一个。然后不断重复。
就这么简单。整个循环本质上就是这样。
真正有意思的问题是:它到底是怎么预测出下一个 token 的?以及,为什么第二个 token会比第一个 token出来得快得多?
第一步:你的文本先变成数字
神经网络并不“读懂”英语,它处理的是向量。所以 prompt 进入系统后的第一步,是 tokenization:把文本切成若干片段,并给每一段分配一个整数 ID。
现代 LLM 大多使用一种叫 Byte Pair Encoding 的方案。核心思路是:先从原始字符开始,然后不断把最常出现的相邻字符对合并,直到形成一个大约 5 万条目的词表。像 the 这样的高频词可能只占一个 token;像 unhappiness 这样的低频词,则可能会被拆成 un + happi + ness 这样的几段。
prompt = "How does inference work?"
ids = tokenizer.encode(prompt)
# ids -> [2437, 1374, 32278, 670, 30]
这一步的重要性常常被低估。那些在 tokenizer 训练语料里代表性不足的语言,往往会被切成更多片段,这就意味着更多 token、更高成本,以及同一句话更慢的响应速度。
第二步:每个 token 变成一个向量
每个整数 ID 接下来都会去一张巨大的矩阵里查表,这张矩阵叫 embedding table。假设模型词表大小是 50K,hidden dimension 是 4096,那么这张表的形状就是 [50000, 4096]。你取出其中一行,就得到一个向量。
# embedding_table has shape [vocab_size, hidden_dim]
vectors = embedding_table[ids]   # shape: [num_tokens, 4096]
这些向量并不是随机的。训练过程中,模型会不断调整它们的位置,让语义接近的 token 在这个 4096 维空间里彼此更靠近。king 和 queen 会比较接近;python 和 snake 可能沿某个方向接近,而 python 和 javascript 又会沿另一个方向接近。
embedding layer 也是 position information 注入的位置,因为 attention 本身并不知道哪个 token 在前、哪个在后。现代模型通常会使用像 RoPE 这样的方案,根据 token 在序列中的位置对向量做旋转编码。
第三步:注意力层次
接下来才是真正的计算开始。你的向量序列会被送入一叠 transformer layers,通常至少 32 层,一层接一层往下走。每一层大致都做两件事:
- 通过 self-attention 在 token 与 token 之间交换信息。
- 通过 feed-forward network 在每个 token 内部进一步加工信息。
self-attention 是最值得真正理解的部分。对于每个 token,这一层都会通过三组已学习的权重矩阵,生成三个新向量:
# x is the input to this layer, shape [num_tokens, hidden_dim]
Q = x @ Wq # queries
K = x @ Wk # keys
V = x @ Wv # values
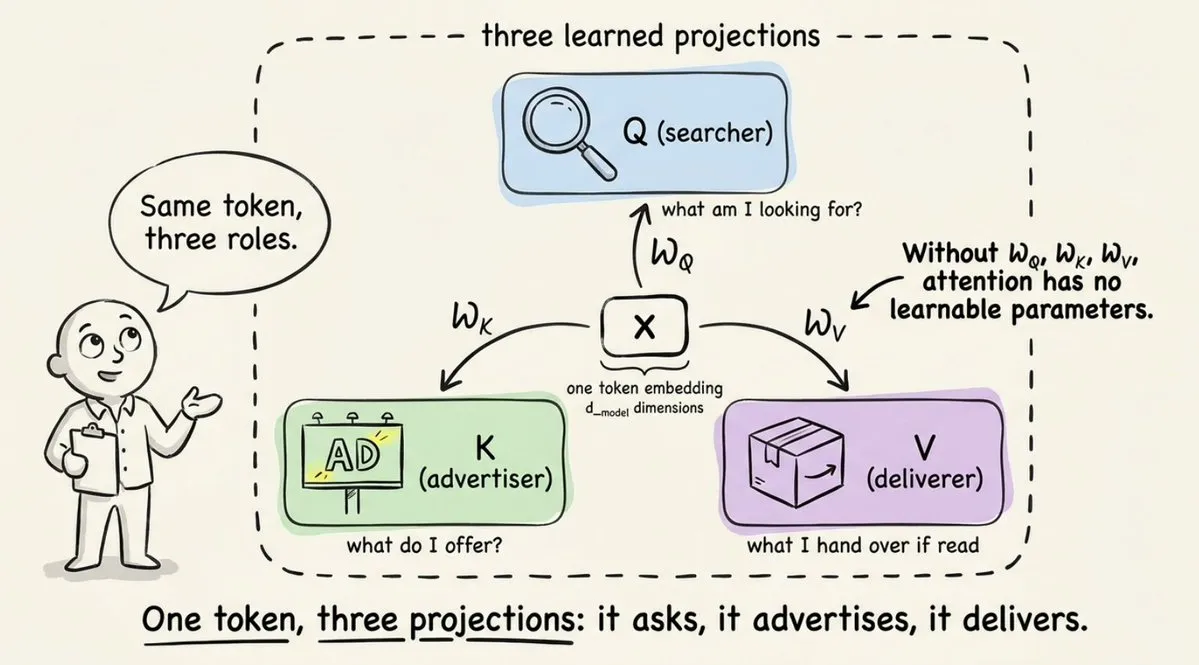
这样,每个 token 就拥有了三种“视角”。关键操作是:每个 token 用自己的 query 去匹配其他 token 的 key,匹配得越强,就越多地吸收对方的 value。
# scores: how much each token attends to every other token
raw     = Q @ K.T
scaled  = raw / sqrt(hidden_dim) # keeps softmax stable
weights = softmax(scaled) # one row per token, sums to 1
attention_output  = weights @ V
上面这个过程可以用下面这张图来直观看:
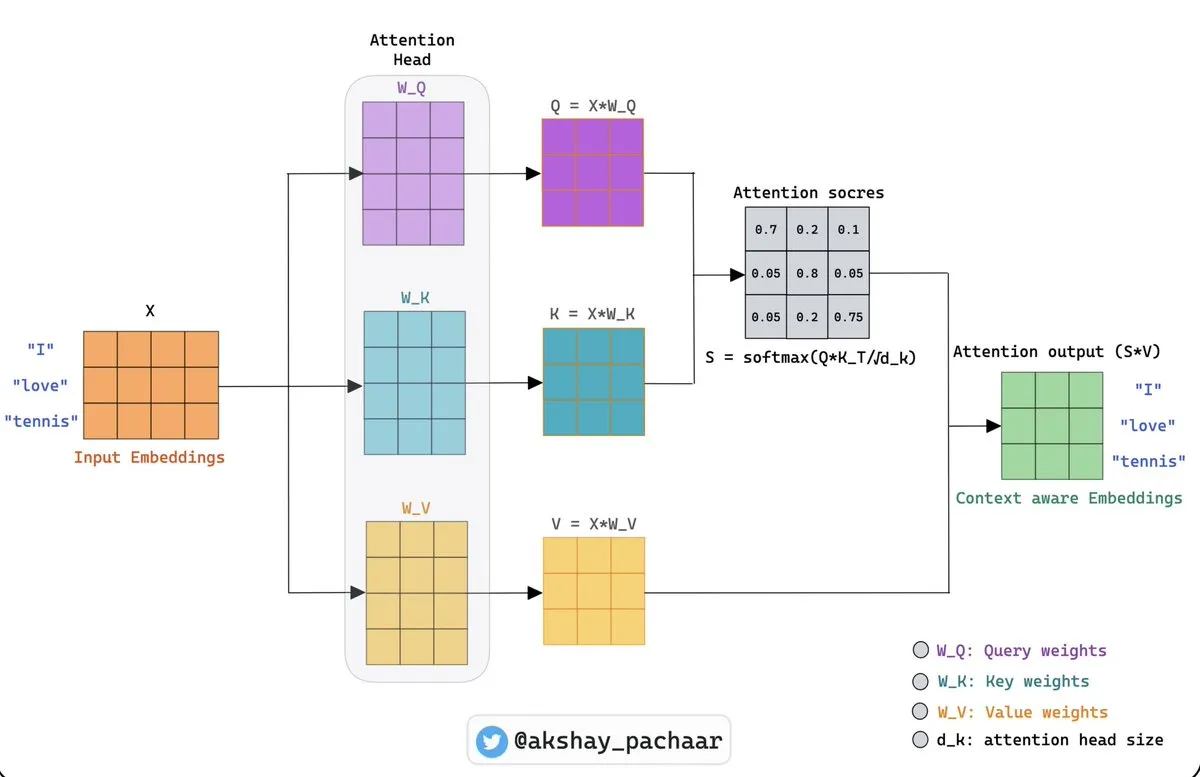
这就是 attention 的魔力。一个 token 会主动决定自己需要哪些上下文,然后在整段序列里去找对自己最有用的信息。把这套机制叠上 32 层之后,模型就能追踪跨越数千 token 的引用关系。
在 attention 之后,每个 token 的向量还会经过一个小型的两层 feed-forward network,而模型真正的大量“知识”其实主要就藏在这里。attention 负责搬运信息,feed-forward network 负责加工信息。
第四步:预测下一个 token
到了最后一层,模型会取出最后一个位置对应的向量,把它投影回整个词表大小,再做 softmax,从而得到“所有可能的下一个 token”的概率分布。然后从这个分布里采样,你就得到第一个生成出的 token。
接下来才是真正有意思的部分。
很少有人认真告诉你的两个阶段
生成一段 200 token 的回答,并不是一件统一的事情。它其实是两种底层行为完全不同的任务。
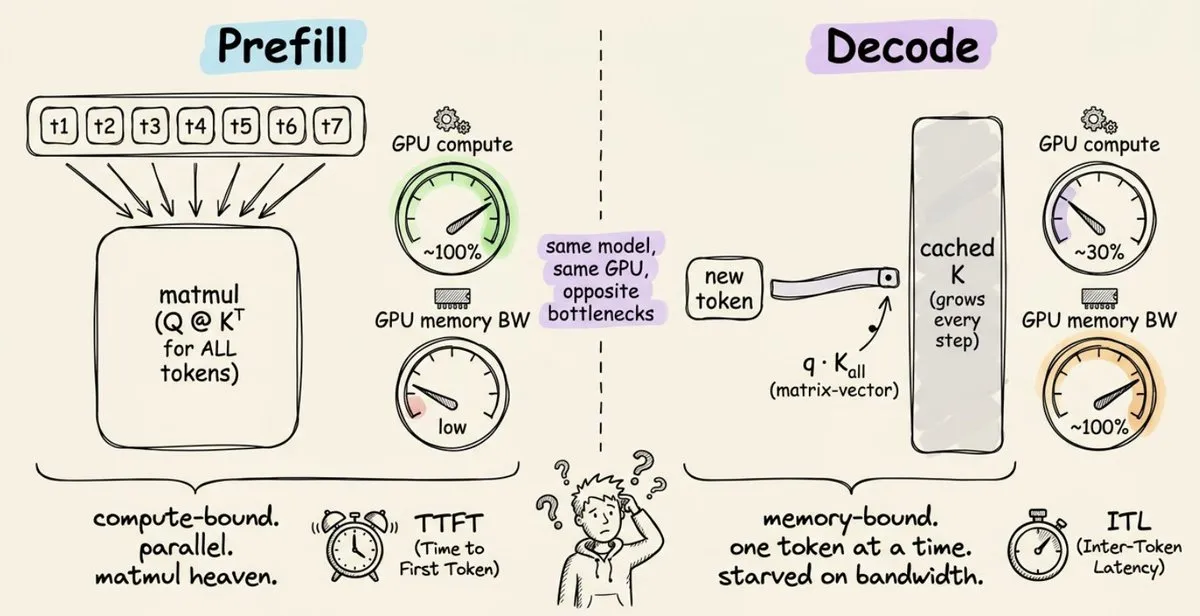
阶段一:Prefill
当你提交一个 prompt 时,模型必须先把你输入的所有 token 全部处理完,才能开始生成。好消息是:这一步可以并行完成。每个 token 的 Q、K、V 都会同时算出来,attention 也会表现为一次大规模 matrix-by-matrix multiplication。
GPU 非常擅长做这件事。矩阵乘法本来就是 GPU 的主战场。所以这个阶段的瓶颈是纯算力吞吐:GPU 往往会被打到很高利用率,尽可能快地做数学计算。
这个阶段最重要的指标是 Time to First Token(TTFT),也就是在第一句话开始出现在屏幕上之前,那段完全静默的等待时间。
# Prefill: process the whole prompt in one shot
hidden = embed(prompt_tokens) + positions
for layer in model.layers:
    Q, K, V = project(hidden)             # for ALL tokens at once
    hidden  = attention(Q, K, V) + hidden
    hidden  = feedforward(hidden) + hidden
    cache_kv(layer, K, V)                 # save for later
first_token = sample(project_to_vocab(hidden[-1]))
阶段二:Decode
第一个 token 一旦出来,模型就会切换工作模式。比如要生成第 51 个 token,它只需要为这一个 token 重新计算 Q、K、V。前面那 50 个 token 呢?它们的 K 和 V 根本没变,重新算完全是浪费。
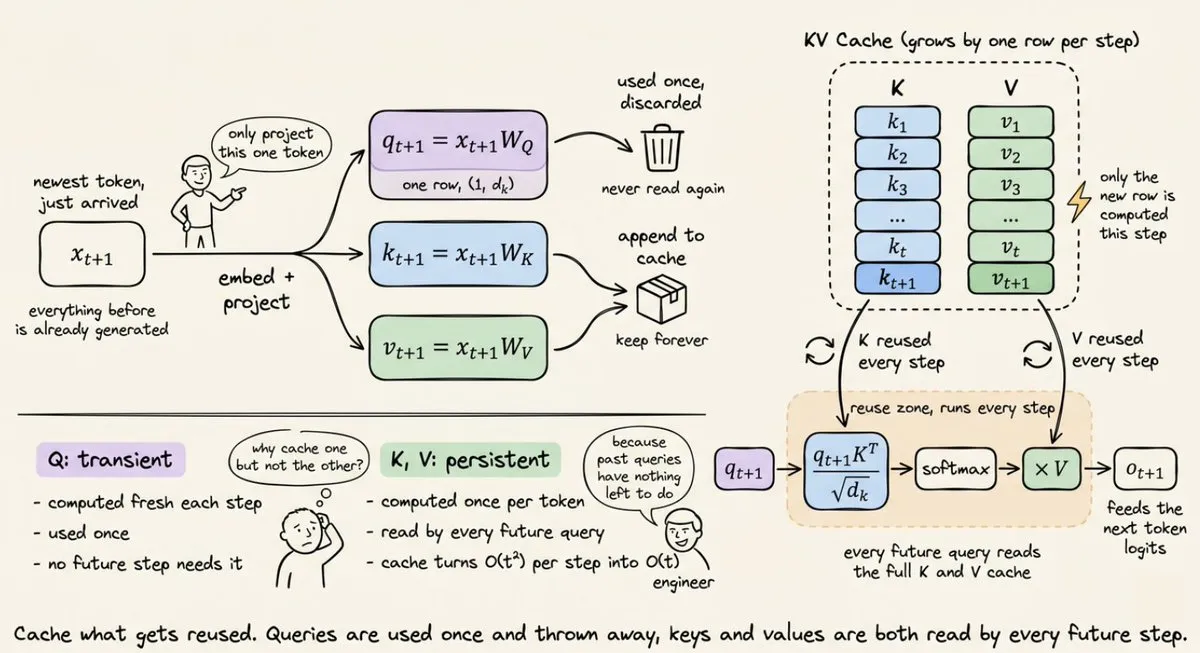
所以模型会进入这样一个循环,一次一个 token:
# Decode: one token per iteration
token = first_token
steps = 0
while token != STOP and steps < MAX_STEPS:
    x = embed(token) + position(steps)
    for layer in model.layers:
        q, k, v = project(x)
        K_all, V_all = caches[layer].append(k, v) # cached history + new
        x = layer.forward(q, K_all, V_all, x)  # attention + FFN, residuals
    token = sample(project_to_vocab(x))
    steps += 1
    yield token
注意这里发生了什么变化。之前是“一个 query 矩阵”去乘“一个 key 矩阵”;现在变成“一个 query 向量”去乘“一整个 key 矩阵”。数学量一下子小了很多。
但 GPU 仍然必须把每一层的权重矩阵、以及所有缓存下来的 K 和 V,从显存里搬出来,才能完成这点小计算。于是瓶颈就翻转了:芯片本身并不缺算力,它只是卡在等内存把下一批数据送到位。
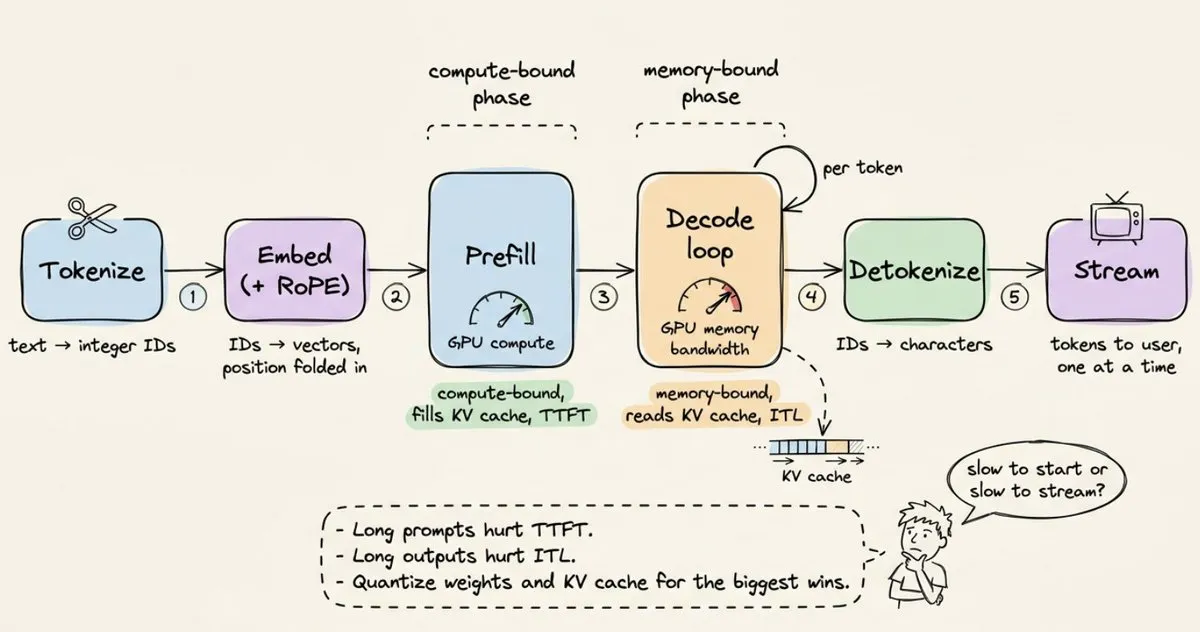
这就是为什么 decode 是 memory-bound,而 prefill 是 compute-bound。明明是同一个模型、同一块硬件,但性能特征却完全不同。
这个阶段最重要的指标是 Inter-Token Latency(ITL),也就是连续两个 token 流出之间的时间间隔。ITL 越低,模型就越“有速度感”。
KV cache:让这一切真正可行的关键优化
上面那行 append_to_cache,其实承担了最关键的工作。没有它的话,生成一个 1000 token 的回答,就意味着模型在每一步都要对不断变长的整个序列重新计算一次 attention。复杂度直接失控,速度会慢得难以接受。
有了 KV cache 之后,K 和 V 矩阵只需计算一次,之后一直复用。大致结构像这样:
# One KVCache per transformer layer
class KVCache:
    def __init__(self):
        self.K = None # all keys seen so far,   shape [tokens, dim]
        self.V = None # all values seen so far, shape [tokens, dim]

    def append(self, k_new, v_new):
        if self.K is None:
            self.K, self.V = k_new, v_new # first token
        else:
            self.K = concat([self.K, k_new], axis=token_axis)
            self.V = concat([self.V, v_new], axis=token_axis)
        return self.K, self.V # full history so far
这带来的提速非常大。对长文本生成来说,5 倍甚至更高的加速都很常见。但代价也很真实:这个 cache 必须常驻 GPU memory,而且会随着 token 数量不断增长。每一层都要维护自己的一组 K 和 V tensor。对一个 13B 模型来说,粗略估算下来,每增加一个 token,大约就要多占 1 MB 的缓存。一个 4K token 的上下文,仅 cache 就会吃掉大约 4 GB 的显存。
这也是为什么长上下文总是又慢又贵。不是模型“大脑不够用”,而是 cache “放不下”了。
为了解决这个问题,业界做了很多非常巧妙的优化:把 cache 量化成 INT8 或 INT4;丢掉 sliding window 之外的老 token;在多个 attention heads 之间共享 K 和 V(grouped-query attention);或者像操作系统分页那样去管理 cache(PagedAttention,也就是 vLLM 背后的关键技巧)。
前沿研究:直接缩小 cache 本身
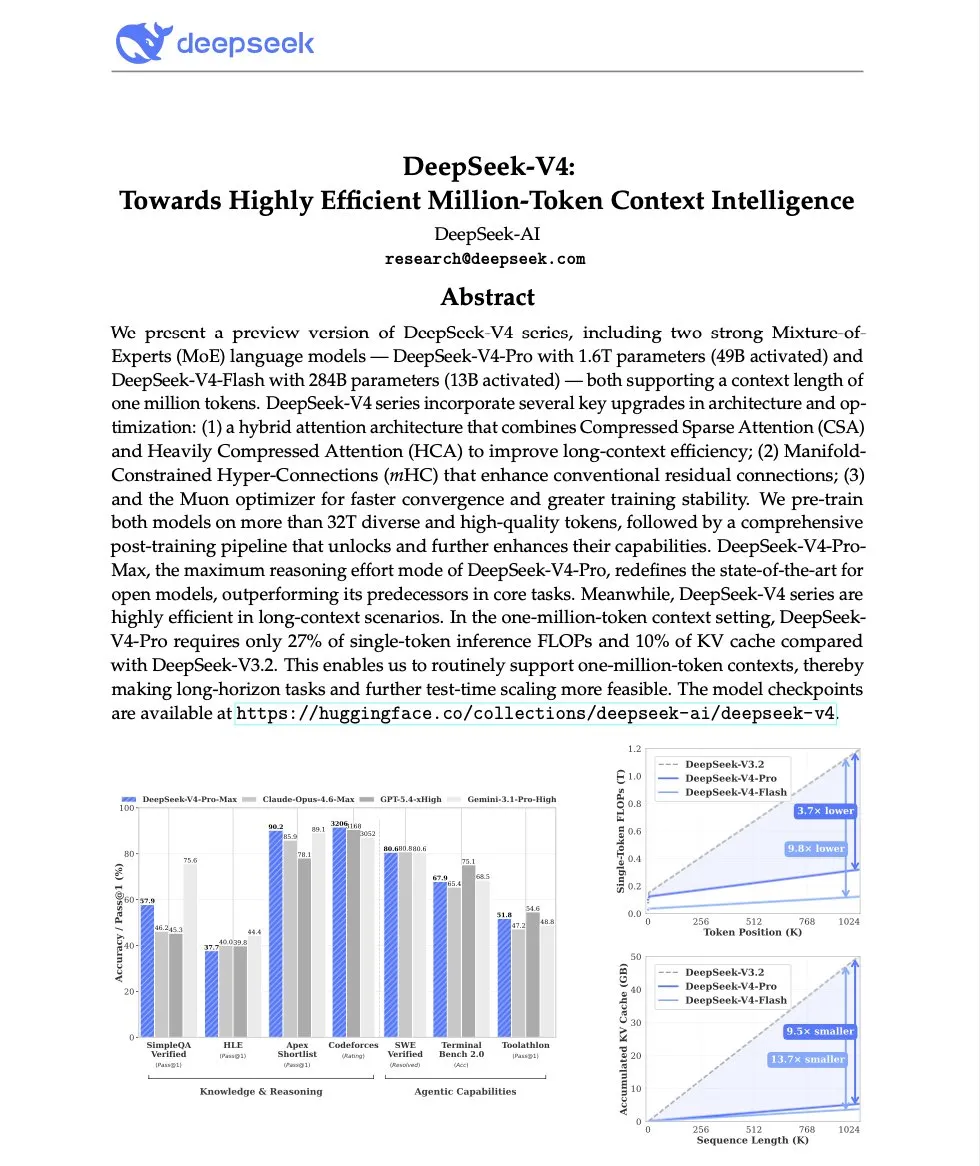
量化和分页,默认把 cache 当作一项固定成本来处理。而 DeepSeek 在 2025 年末预览的 V4 系列,则走得更激进:它试图从 attention 结构本身下手,让 cache 一开始就更小。
它们的 hybrid 方案结合了两类压缩 attention 机制:一种偏 sparse,一种偏 dense,两者都运行在高度压缩过的 KV 流上。按照 V4-Pro 报告,在 100 万 token 上下文下,它的 cache 大小大约只有前一代的 10%,而每个 token 的计算量大约只有前一代的 27%。
重点并不只是那套具体架构本身,而是这个趋势:KV cache 已经成为整个领域正在围绕着优化的核心瓶颈。当 attention 本身都在被重新设计,只为了减少 cache,你就知道限制条件已经变了。
如果你想看长上下文 inference 接下来会往哪里走,这部分很值得读。完整技术报告在这里:
量化:用 bit 数换速度
训练需要高精度。推理不一定。
大多数生产部署会使用 FP16 或 BF16,而不是 FP32。这样可以把显存占用减半,同时在 Tensor Cores 上通常也能把吞吐大致翻倍。更激进的部署还会继续往下走,把权重量化到 INT8,甚至 INT4。
这笔账其实很直观。一个 7B 参数模型大约需要:
- FP32:28 GB
- FP16:14 GB
- INT8:7 GB
- INT4:3.5 GB
最后这个数字,也正是为什么 7B 模型可以跑在笔记本 GPU 上。像 GPTQ、AWQ 这样的技术,会为不同 channel 选择不同的缩放因子,让这种有损压缩尽量少伤害模型质量。做得足够好的时候,INT4 在多数 benchmark 上只会比原模型低不到一个百分点。
把整个过程串起来
下面是一个 prompt 从头到尾的完整旅程:
- Tokenize。文本变成整数 ID。
- Embed。ID 变成向量,位置信息被一并注入。
- Prefill。每一层并行处理全部输入 token。这个阶段是 compute-bound。KV cache 在这里被建立。第一个输出 token 从这里产生。
- Decode loop。后面的每个新 token:只为新 token 投影 Q,对缓存里的 K 和 V 做 attention,经过 feed-forward network,再采样;然后把新的 K 和 V 追加进 cache。这个阶段是 memory-bound。
- Detokenize。token ID 再被映射回字符,并流式输出到你的屏幕上。
像 vLLM、TensorRT-LLM 和 Text Generation Inference 这样的现代 serving framework,会在这条主循环外再包上一整层工程优化:包括 continuous batching(多个用户的 token 会交错在同一块 GPU 上一起跑)、speculative decoding(小模型先草拟,大模型再验证),以及各种精巧的 memory management。这也就是为什么一块 GPU 可以同时服务几十个并发用户。
这应该如何改变你看问题的方式
当这整幅图真正建立起来之后,会带来几个很实用的判断:
- 长 prompt 主要拖慢的是 TTFT,长输出主要拖慢的是 ITL。它们压的不是同一个瓶颈。你应该优先优化用户真正能感知到的那个。
- 上下文长度从来都不是免费的。它不只是把计算量翻倍,更会让 KV cache 膨胀,并压缩你能开的 batch size。
- Quantization 是你手里杠杆最高的旋钮之一。很多场景下,从 FP16 降到 INT8,就能在几乎不损失质量的前提下,把延迟砍掉一半。
- GPU utilization 很容易误导人。一个模型在 prefill 阶段把 GPU 打满,并不代表 decode 阶段也快。decode 阶段可能只有 30% 利用率。此时问题不是“算力不够”,而是“内存太慢”或者“cache 太大”。
Transformer architecture 往往最容易吸引注意力,但 inference 的真实性能生死线,很多时候其实落在那些看似“枯燥”的工程细节上:memory layout、cache management、bit width。真正的艺术,是把你手头这块硬件榨出最大的产出。
下次再有人告诉你“模型很慢”,你首先该问的就会是:它是启动慢,还是流输出慢?
如果你喜欢这篇文章,欢迎在评论区告诉我。
这会给我一个信号,说明我应该继续做更多这样的内容。
