
国产模型每有一次大的更新,新闻里总少不了那个熟悉的说法,又一颗核弹落下来了。
GLM-5.3 发布以后,我照例先去看代码能力。结果这次还没等我把几个项目完全做完,它的 API 也已经正式上线了。
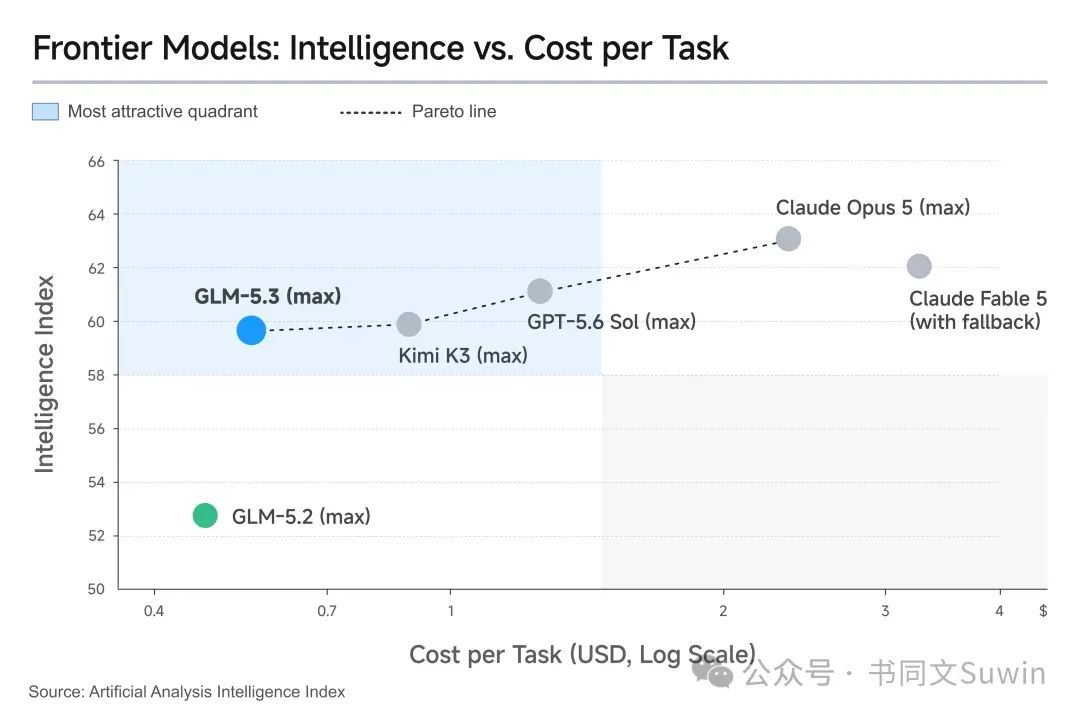
与此同时,Artificial Analysis 更新了最新一版 Intelligence Index。GLM-5.3 拿到了 60 分 。而 Claude Opus 5 是 63 分,Claude Fable 5 是 62 分,GPT-5.6 Sol 是 61 分,GLM-5.3 和 Kimi K3 都是 60 分。
也就是说,GLM-5.3 这一代已经进入全球前沿模型最密集的能力区间,并且和 Kimi K3 并列当前开源模型的第一档。它距离最前面的几个闭源旗舰仍然有一两分的差距,但已经挤进了同一小段分数带里。
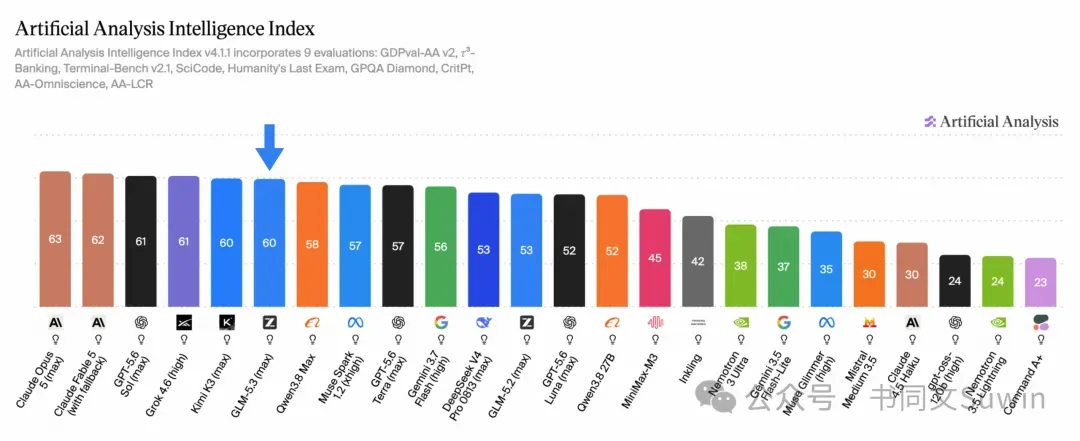
Artificial Analysis 把知识、推理、Coding、智能体和复杂任务执行等多个维度合在一起,最后得到这个综合智能指数。
GLM-5.3 维持着 60 分这一档的综合能力,还把单任务成本压到了更低的位置。
我忽然生出一个念头。既然大家总喜欢拿核弹来形容模型,这一次不妨真的从核弹开始。
于是我把一个在脑子里放了很久的核物理学习网站交给了它。
然后我还做了第二个项目,我让它拆开一台洗烘一体机,把直排、冷凝、热泵三种烘干方式装进同一套三维仿真里。
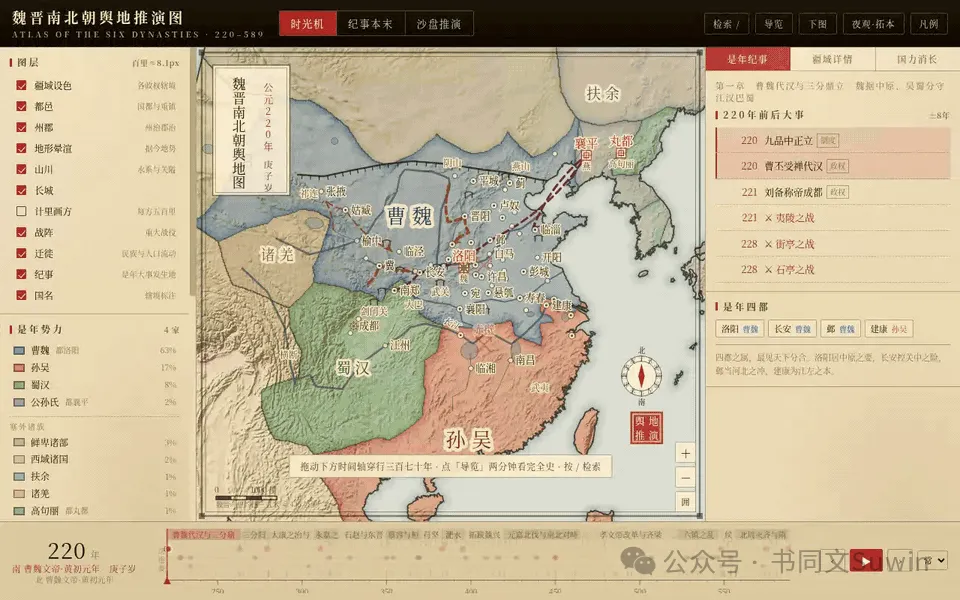
第三个项目又换了一个方向,我把魏晋南北朝三百多年的分分合合铺到一张地图上,让疆域、都城、战役和迁徙随着年代流动起来。
三个项目看起来毫不相干,一个讲核物理,一个讲洗衣机,一个讲中国中古史。它们摆在一起,恰好能够看清 GLM-5.3 的 Coding 能力究竟到了哪一步。它面对的已经不只是几个函数、几个页面,而是一整套彼此牵连的内容、数据、状态和交互。项目做起来以后还要不停修改,而每一次修改,都不能把前面已经完成的东西破坏掉。最后留下来的,还得是一件真正能够打开、操作和继续维护的东西。
01 既然都说核弹,我就真做了一个核物理学习网站
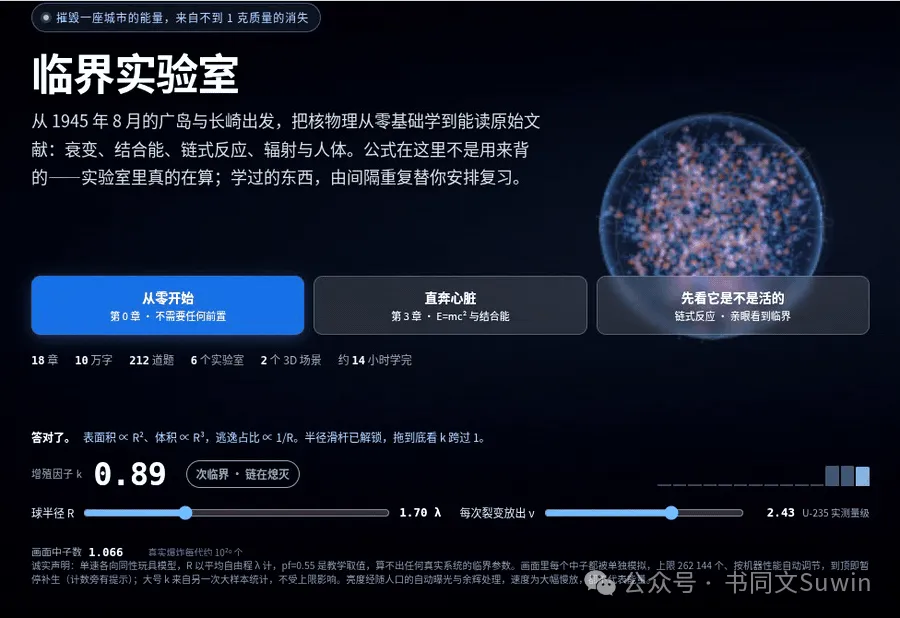
整个过程从 1945 年 8 月的广岛和长崎开始。沿着这条线往前追,会碰到原子核的发现、放射性、结合能、中子、裂变和链式反应;再继续往后,又会进入辐射剂量、人体影响、幸存者研究、不确定度以及原始文献。现在这个版本一共有 18 章,约 10 万字,212 道题,6 个能够实际运行的实验室和 2 个三维场景。完整走一遍,大约需要 14 个小时。
最先做的,是首页里那颗不断运动的球。
刚进入页面的时候,很多东西其实还不能动。系统先抛出一个很简单的问题。球体半径变大以后,逃出去的中子究竟会变多,还是变少?只有完成这个判断,控制半径的滑杆才会完全解锁。
球还很小的时候,中子很容易跑出去,增殖因子 k 低于 1,链式反应一代一代衰减下去,最后归于沉寂。随着半径继续增加,能够逃逸的中子越来越少,k 逐渐逼近 1,又越过 1。到了这个时候,球腔里的中子开始一代接一代地增加。画面中的每一颗中子都有自己的运动轨迹,裂变发生时会亮起闪光,计数随之改变,旁边的状态文字也同时更新。
后面还有半经验质量公式实验、随机衰变实验、核素谷三维场景,以及机器判分、间隔重复、划线批注、笔记、章节 Markdown 导出和带上下文的提问包。
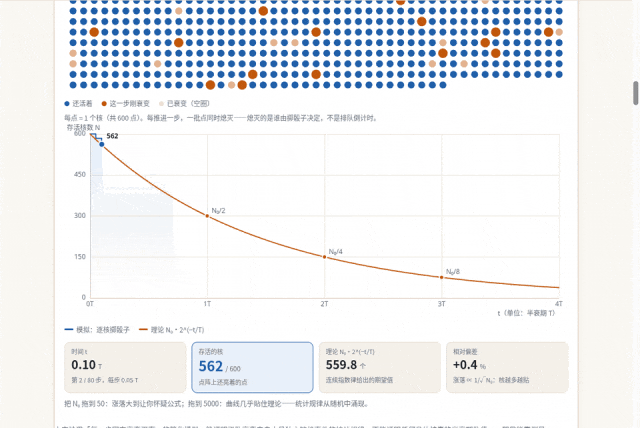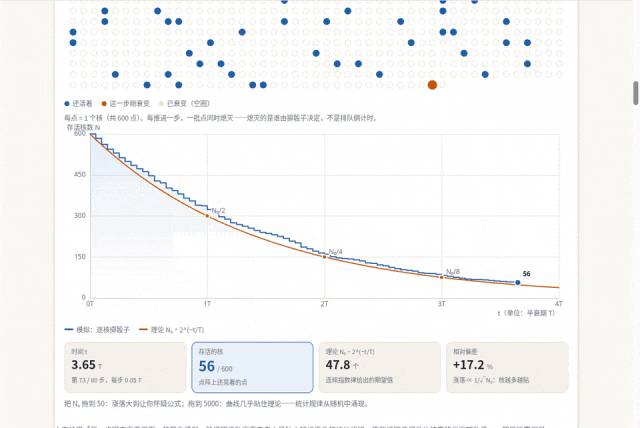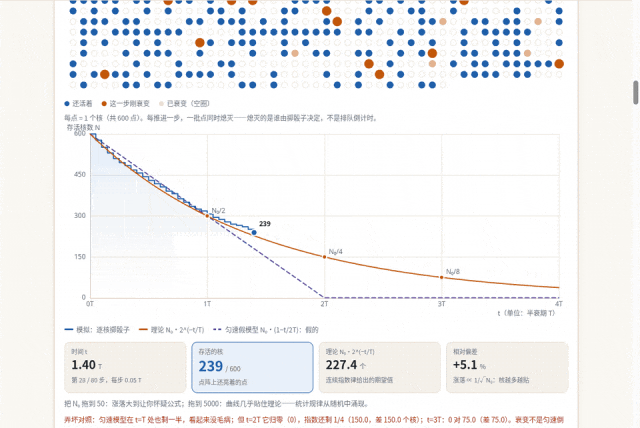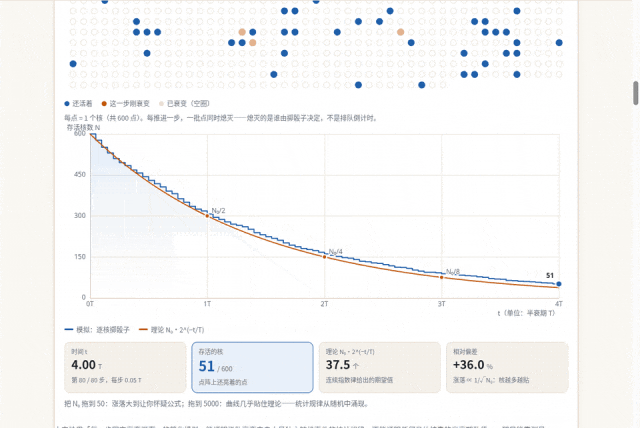
半衰期实验里,随机点阵逐步衰变并长出指数曲线
把几百个原子核当成一次次独立掷骰子,随机结果会在波动中逐渐贴近指数衰变;切换匀速假模型以后,两条路径很快分开。
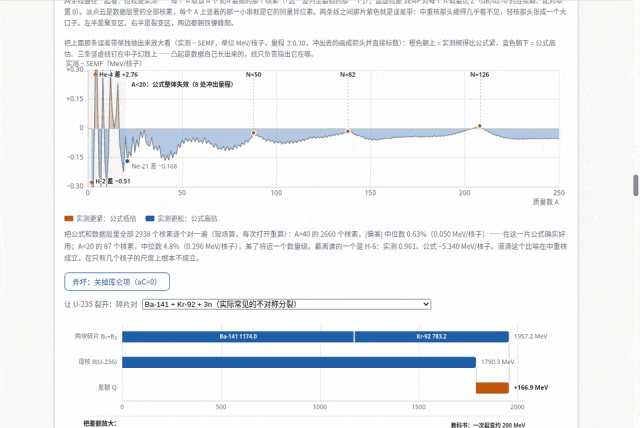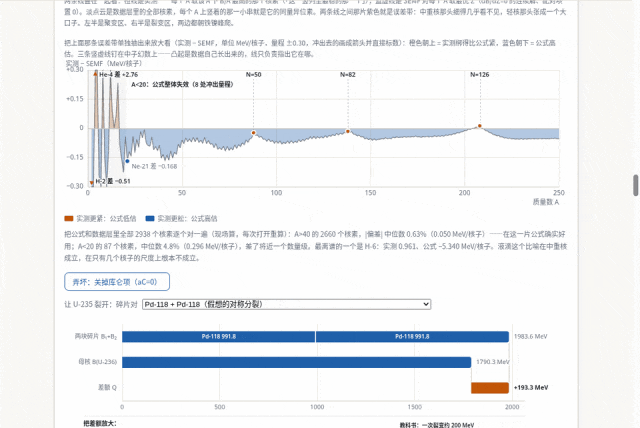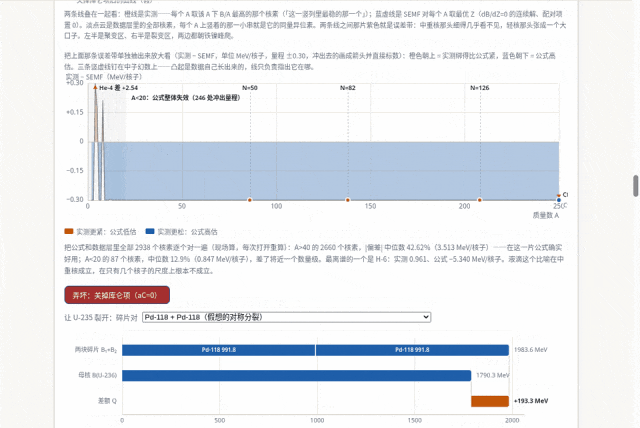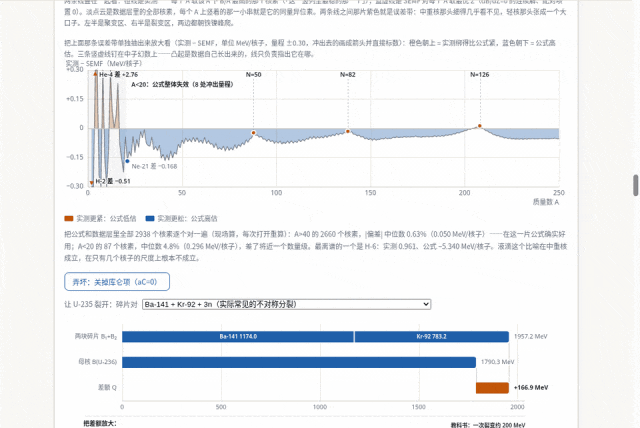
结合能曲线、公式残差与裂变放能的实时计算
切换液滴模型中的不同项,再改变裂变碎片组合,曲线、残差与释放能量会同步重算。
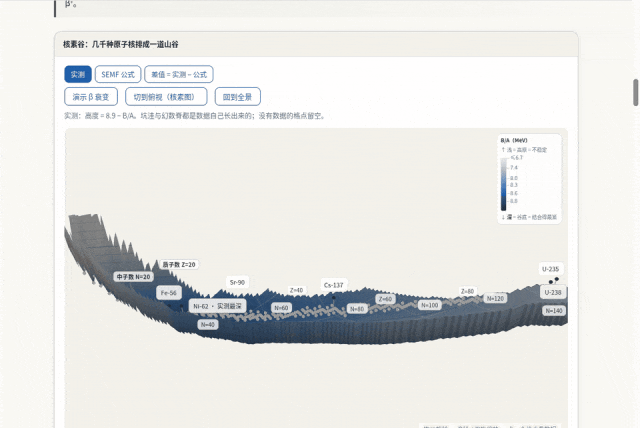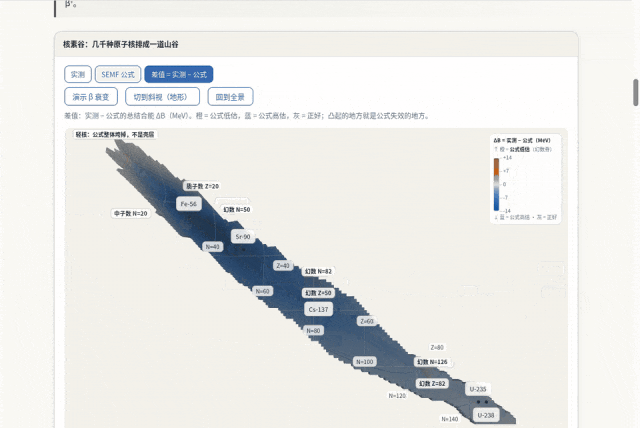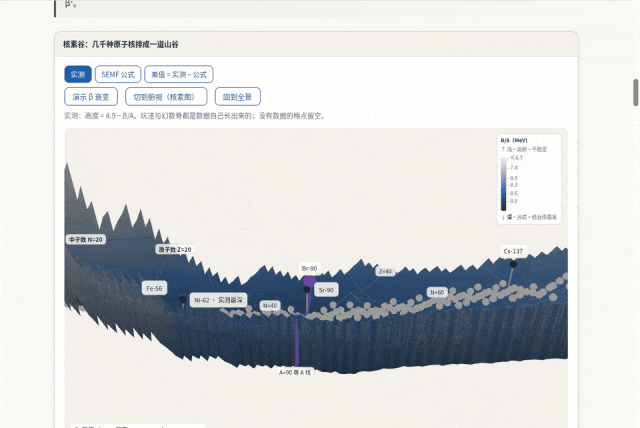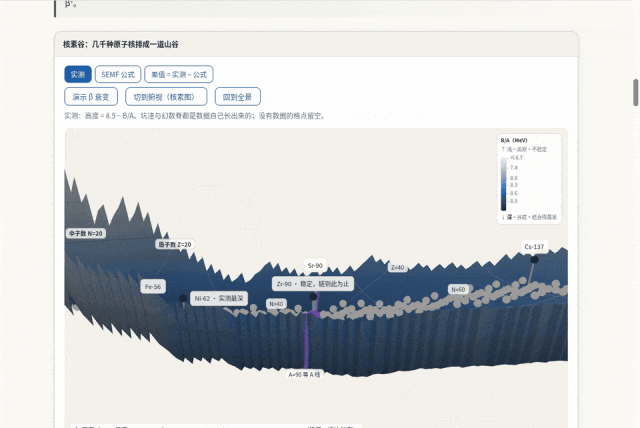
核素谷在实测、公式和差值模式间切换,并演示β衰变
质子数、中子数与每核子结合能被排成一座三维谷地,视角和数据模式切换以后,可以沿等质量数方向观察 β 衰变怎样走向谷底。
现在整个项目仍然是一个单文件 HTML,大约 2.1MB,接近 2 万行代码。这样的项目很容易把模型真正的长程编程能力显出来。做一张漂亮的首页并没有多难,真正困难的是,当一个系统越长越大以后,它还能不能在里面继续工作。它得知道东西放在哪里,改动会牵连什么,也得知道,有些地方即使看起来方便,也不能随意去碰。
02 买一台洗衣机之前,我先把三种烘干技术拆开看
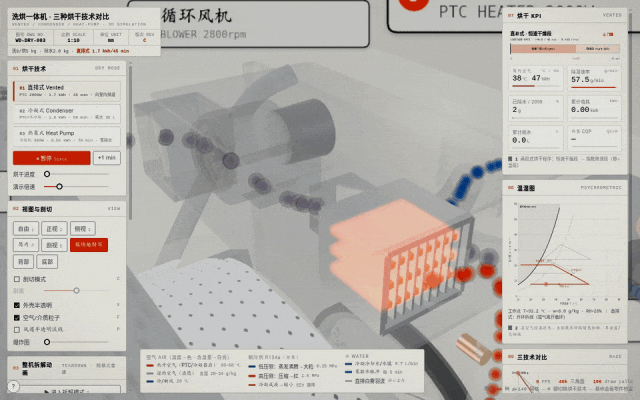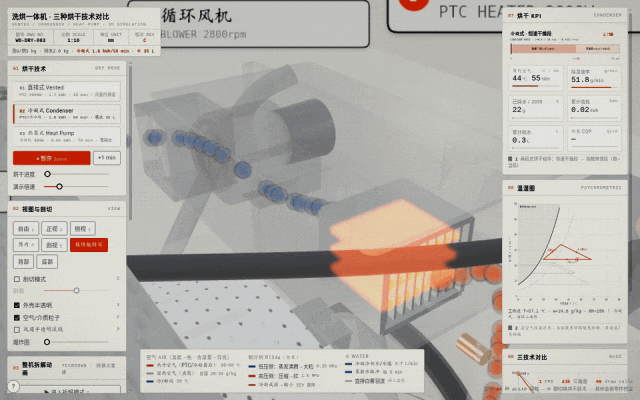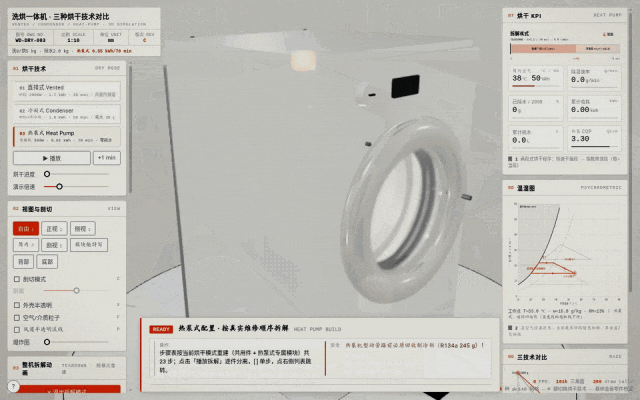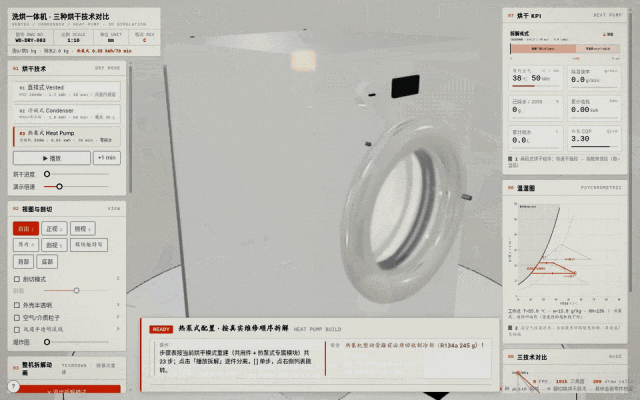
直排、冷凝、热泵三种烘干技术与爆炸图
我最近准备买一台滚筒洗烘一体机。商品页里,直排、冷凝、热泵这几个词常常并排出现在参数表上。看得久了,大概都知道热泵省电,也知道冷凝式更加常见。可机器里面究竟因此多了什么东西,空气从哪里进去,又从哪里出来,衣服里的水分怎样离开,热量最后去了哪里,只靠几段文字其实很难在脑子里拼成一幅完整的图。
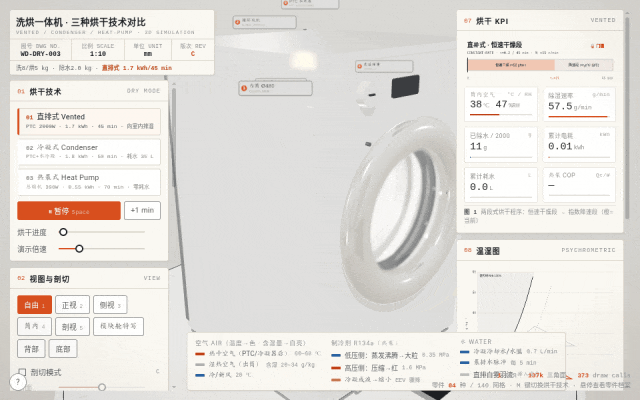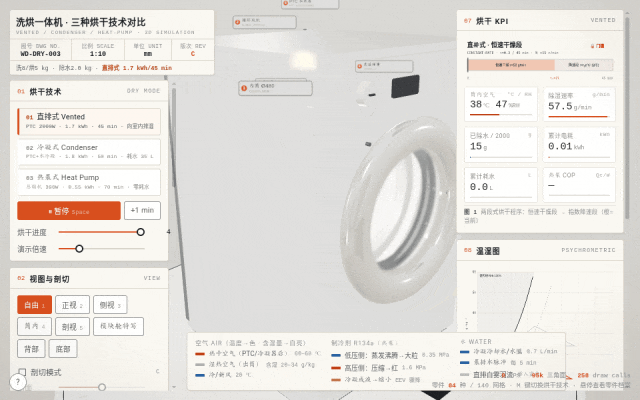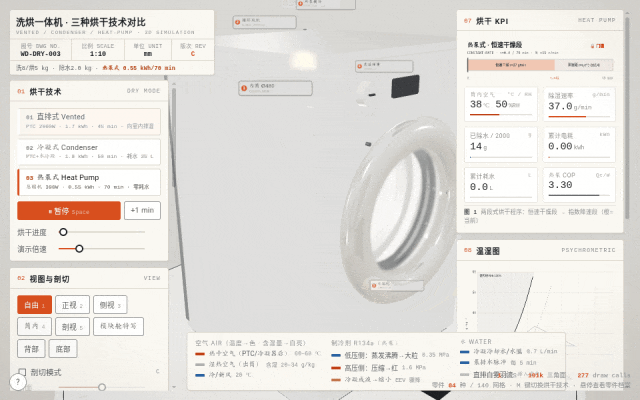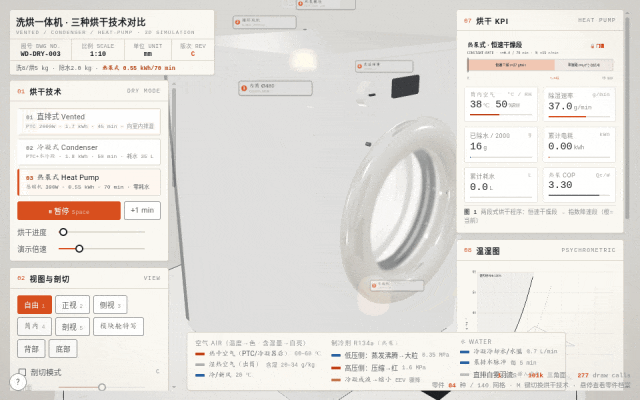
所以我干脆把三种技术都装进了同一台三维洗衣机里。
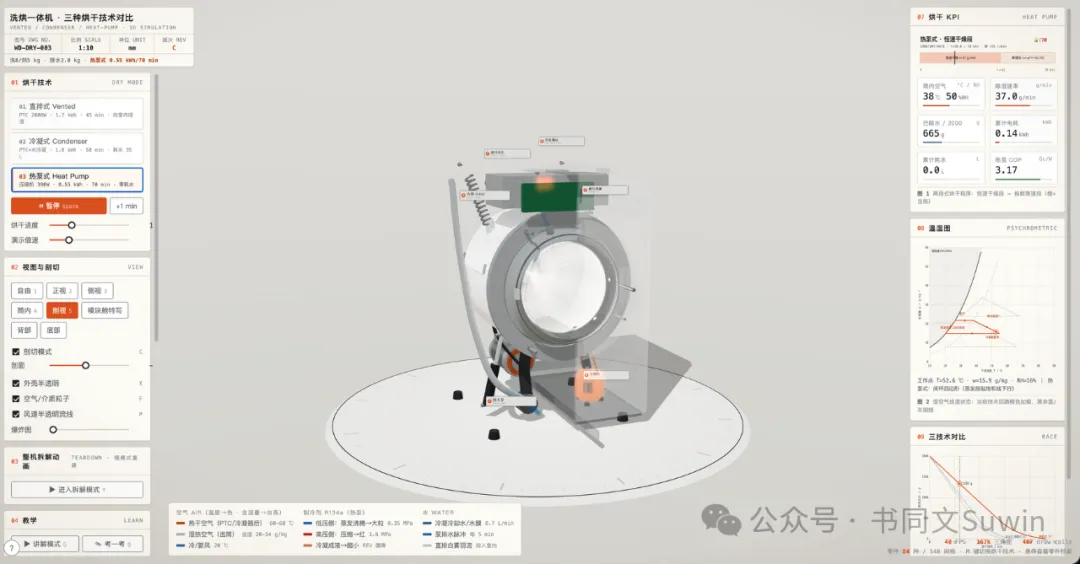
页面里只要切换烘干方式,机器内部的部件、空气流动的粒子、三维标注、温湿图和右侧的数据都会随之改变。
直排式的办法最直接,湿热空气产生以后便排到机外。冷凝式会让湿热空气经过水冷凝风道,把其中的水汽冷却成液态水。到了热泵式,机器里又多出压缩机、蒸发器、冷凝器和膨胀阀。水汽凝结时释放出来的潜热没有就此散掉,而是留在制冷剂的循环里,再被送回空气中继续加热。
右侧那张温湿图也跟着三套结构一起变化。直排式走出一条开放路径,冷凝式形成闭合三角形,热泵式则形成闭合四边形。温度、含湿量、除水速度、电耗、耗水量,还有热泵性能系数,都可以放在同一个过程中观察。以前参数表上一列一列分开的数字,到这里终于有了彼此之间的关系。
拖动烘干进度,KPI、温湿路径和三技术曲线同步变化
同一组工况下切换直排、冷凝与热泵,再拖动烘干时间,筒内温湿度、累计除水、用电、用水和曲线位置会同时更新。
我又把整台机器继续往里拆。外壳可以剖切,也可以变成半透明;零部件能够单独隐藏和显示;风路可以用流线表现;整机还能拉开成爆炸图。
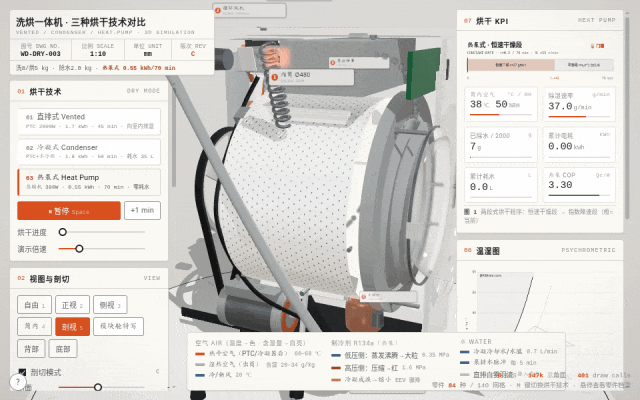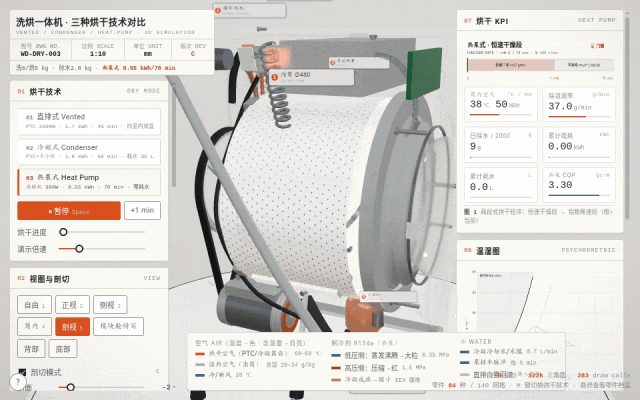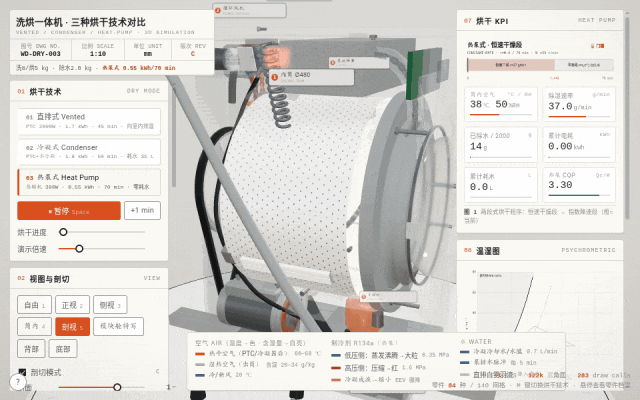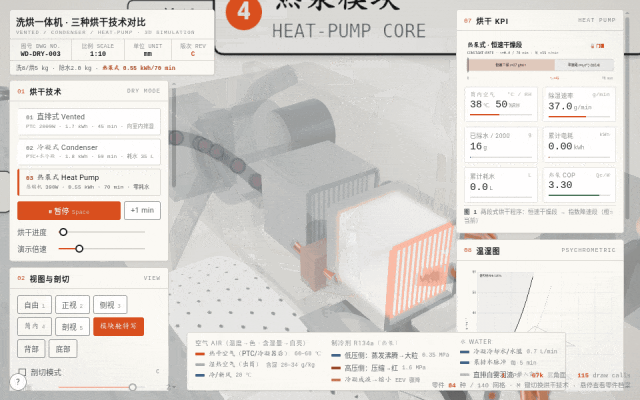
热泵模式下切换剖切、半透明外壳、风路粒子和模块舱视角
剖面沿机身移动时,滚筒、循环风路、蒸发器、冷凝器和压缩机的空间关系会逐层显露。
鼠标落到任何一个部件上,旁边都会出现它的中英文名称、材料、工艺、用途、关键参数和当前状态。
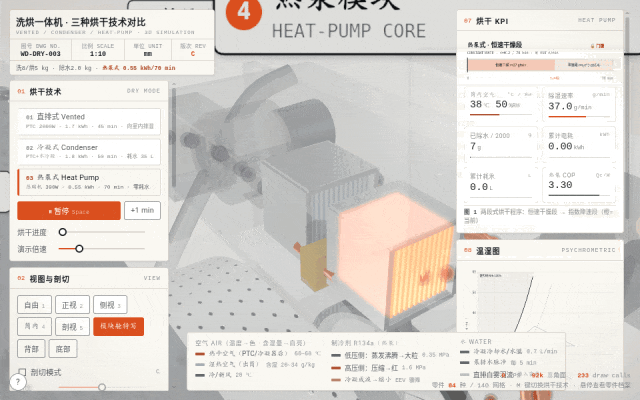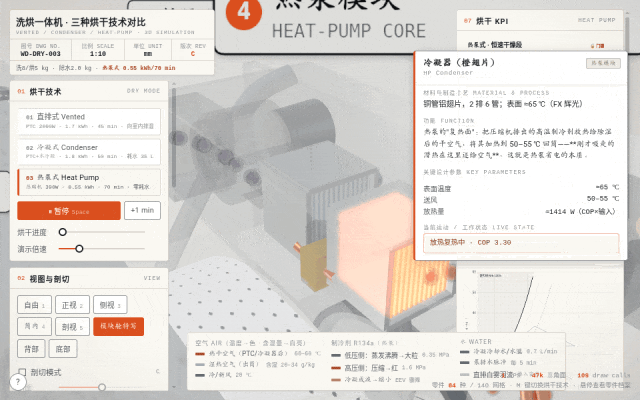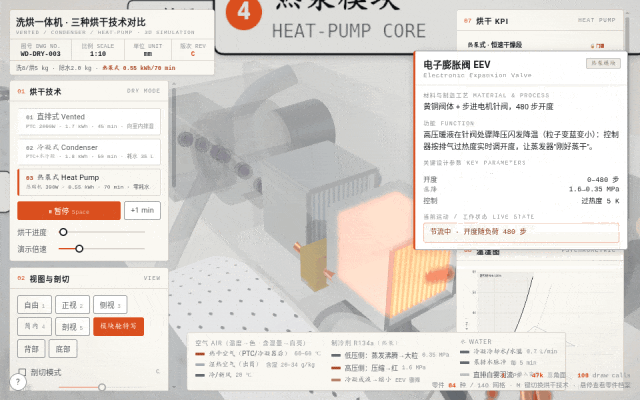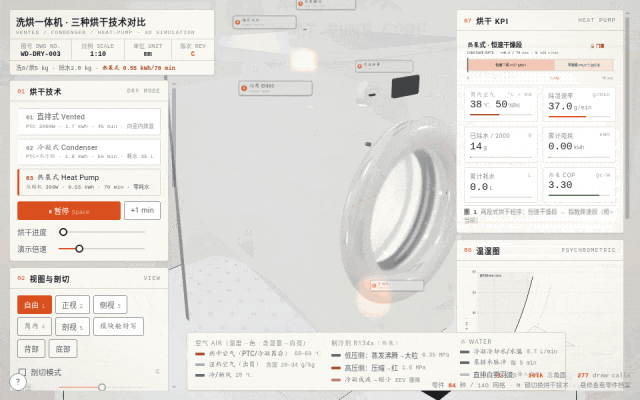
悬停热泵系统零件,查看材料、功能、参数与实时状态
零件卡会随着指针切换,从蒸发器、冷凝器到压缩机,结构档案与当下运行状态放在同一张卡片中。
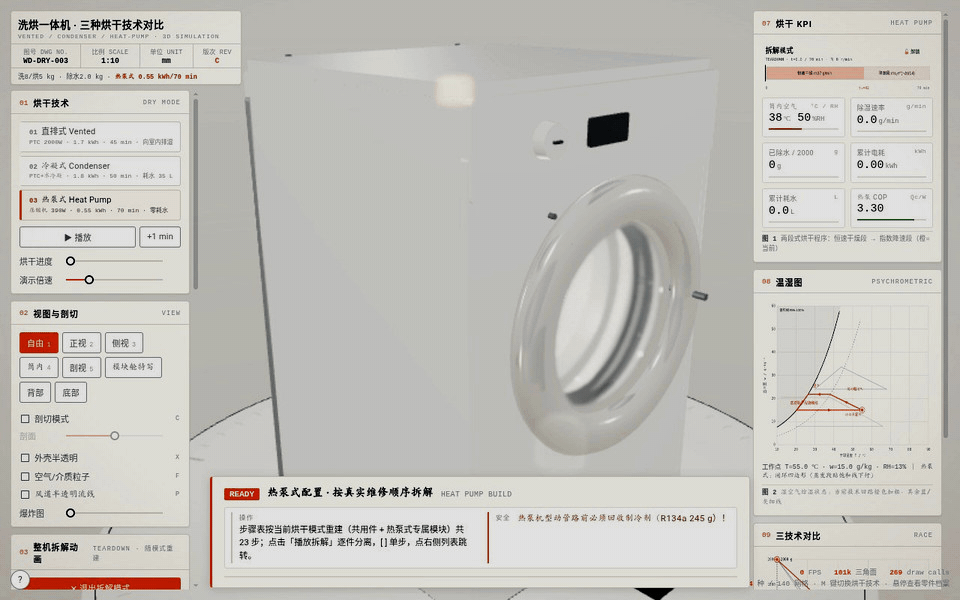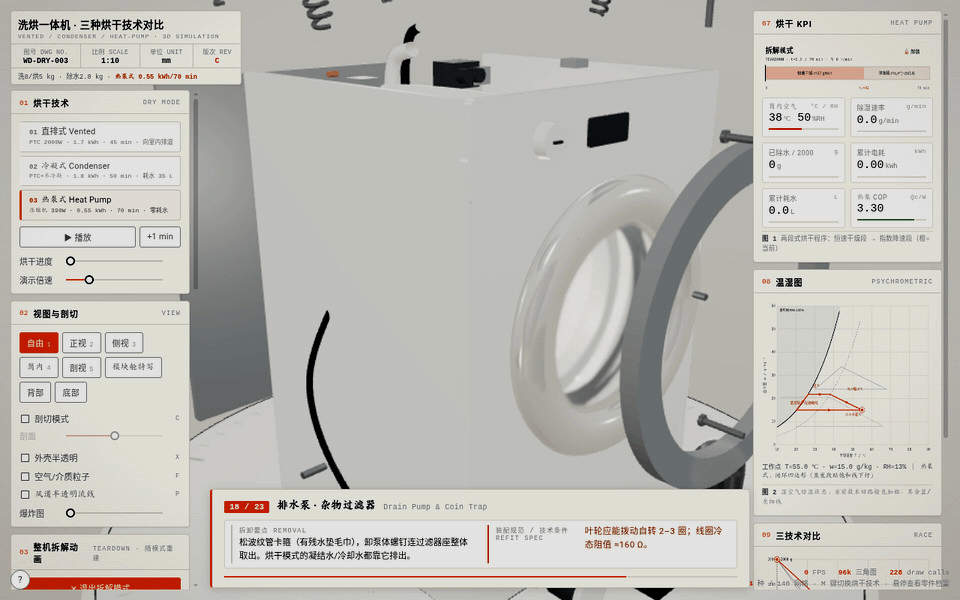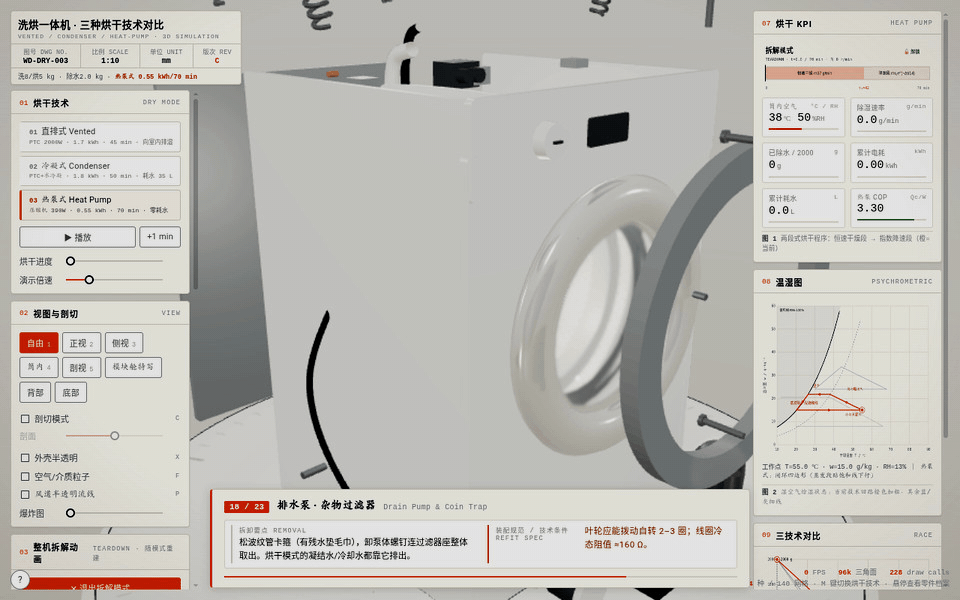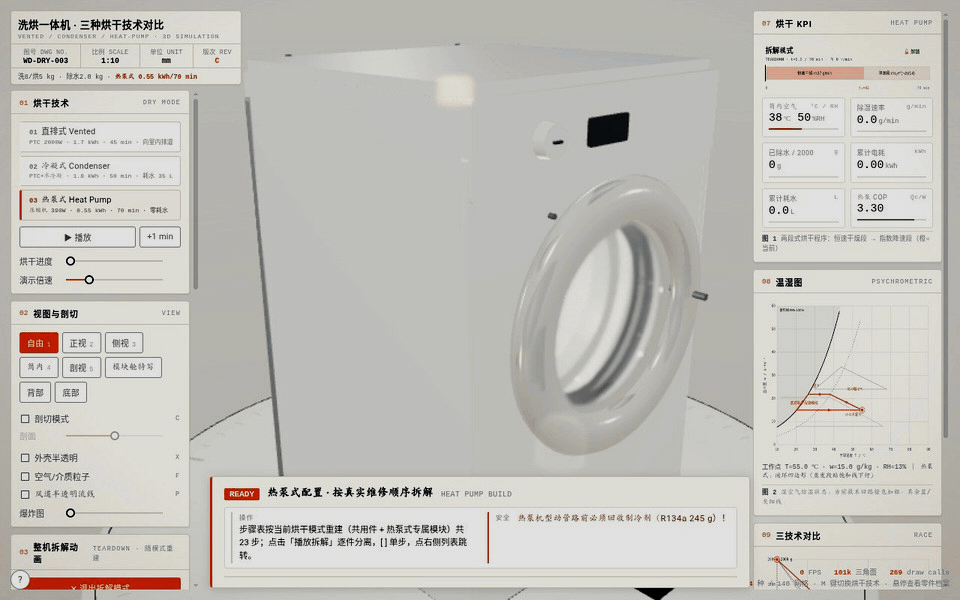
热泵洗烘一体机逐步拆解与逆序装配
热泵模式一共做了 23 个拆解步骤。先断电断水,再从顶盖、滤网和风机开始,一路经过制冷剂回收、膨胀阀、蒸发器、冷凝器、压缩机、皮带、电机、减震器、配重、排水泵、前面板、外筒和内筒,最后一直拆到轴承与水封。
每一步都有自己对应的镜头和拆装提示。拆到底以后,还可以让整个过程反过来播放,看那些零件按照原来的次序一个一个重新归位。
这个项目最初的念头以及提示词,来自我在 B 站看到 UP 主温述卿的一段 AI 制作的柴油机拆解视频。
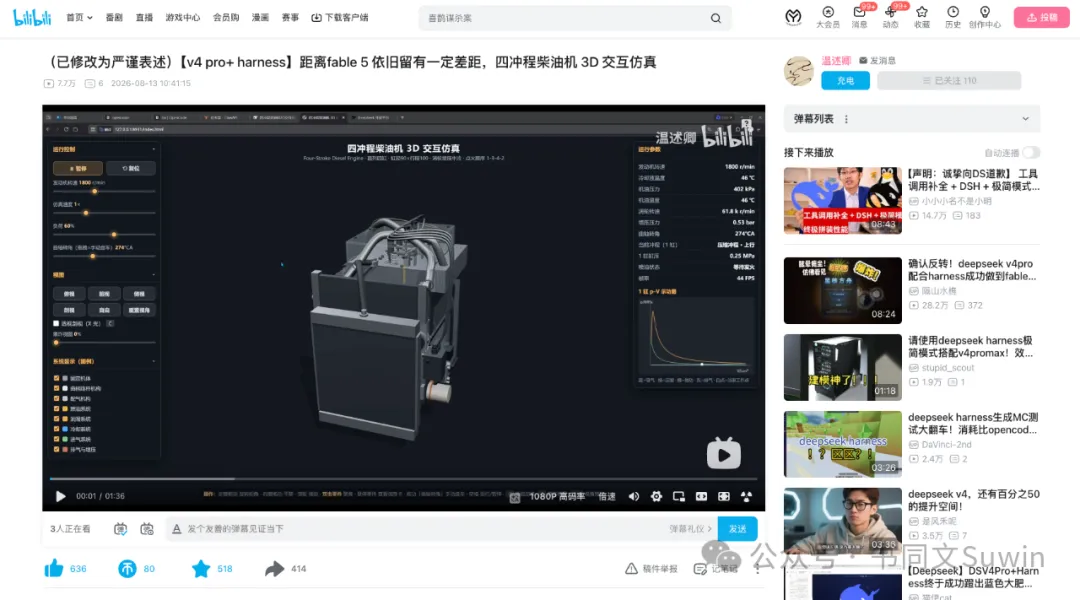
我把反复会用到的做法用 AI 重新整理了一遍,加入参数化尺寸、物理材质、剖切、半透明、爆炸图、介质粒子、零件信息卡、拆解动画和浏览器验证,最后把这些东西整理成了一个 mech-sim-3d Skill。
这套 Skill 我会公开到 GitHub。以后无论是发动机、泵、压缩机、齿轮箱,还是机器人关节和其他机械教学页面,都可以沿着同一套骨架继续做下去。很多已经解决过一次的问题,也就不用再从一张空白页面开始重新寻找答案。
03 魏晋南北朝太乱,我让地图自己讲
第三个项目,是魏晋南北朝舆地推演图。
这段历史从 220 年走到 589 年,前后整整 369 年。三国之后是西晋,西晋之后又有东晋、十六国、南北朝,直到隋重新统一。北方政权一次次建立、分裂、吞并,南方也先后经过宋、齐、梁、陈。朝代表背下来当然不难,可名字一多,脑子里往往只剩下一串次序。那些国家到底在哪里,彼此怎样相邻,战争为什么从这里打到那里,人口又为什么向另一个方向迁移,很难仅凭文字形成完整的空间感。
所以我想把时间和地理放在同一个画面里,让它们一起变化。
页面中央是一张古地图风格的舆地图。左边可以打开疆域、都邑、州郡、地形、山川、长城、战阵、迁徙、纪事和国名等图层。下方是一条从 220 年一直延伸到 589 年的时间轴,旁边还有政权存续图。右侧的内容则随着年份改变,展示当年的事件、疆域信息和势力变化。
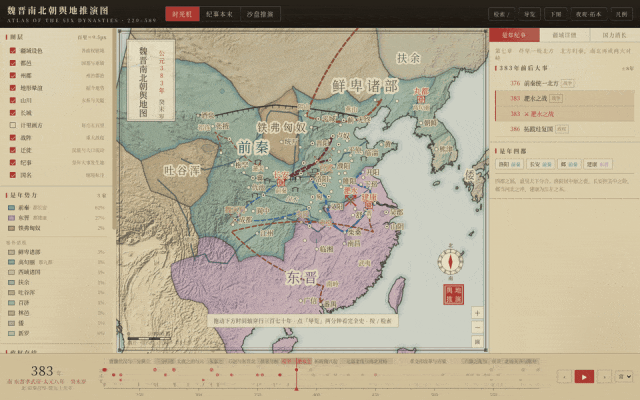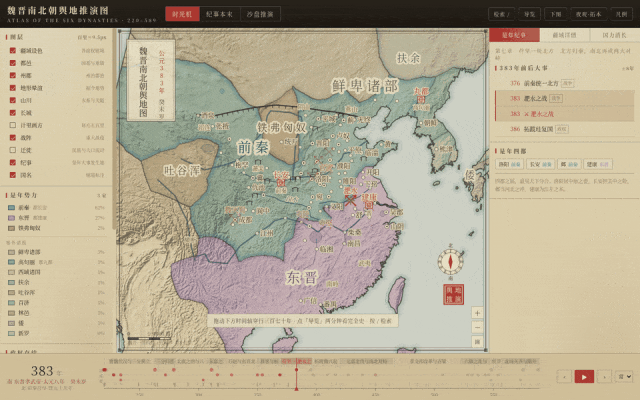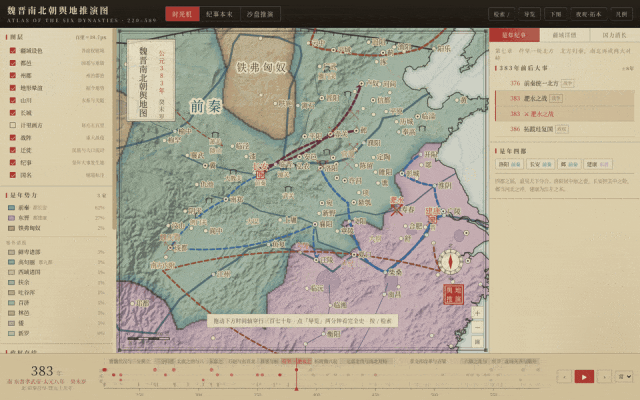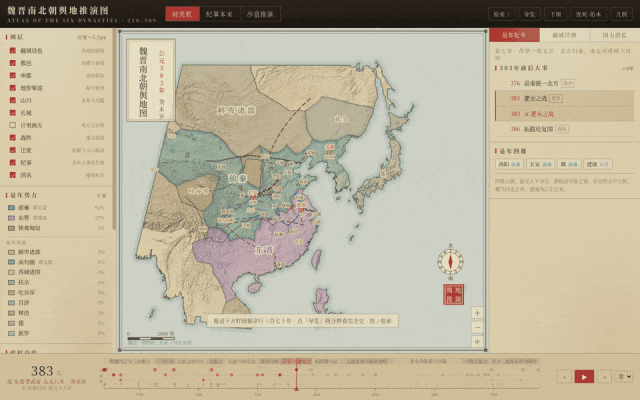
逐项打开地形、山川、战阵与迁徙图层,并在全境与中原之间缩放
同一年份下逐层叠加信息,可以看到疆域底色之上怎样出现都城、州郡、战场、迁徙路线和地形脉络。
时间轴缓缓往后拖,曹魏、蜀汉和孙吴依次退出,西晋短暂完成统一,很快又走向崩解。北方随后进入十六国并立的年月,前秦一度扩张,又迅速瓦解。再往后,北魏统一北方,继而分成东魏和西魏,又分别走向北齐和北周。直到隋出现,这场延续数百年的分裂才终于收束。
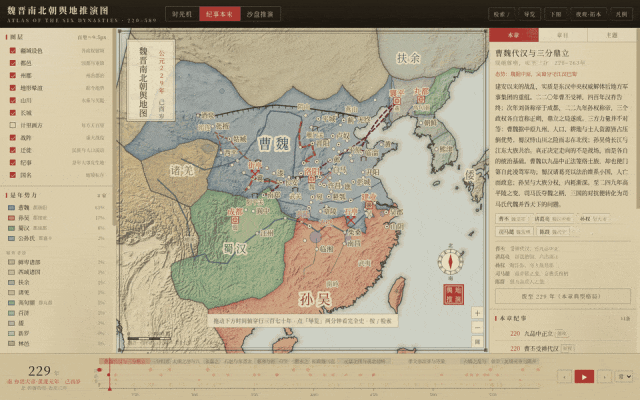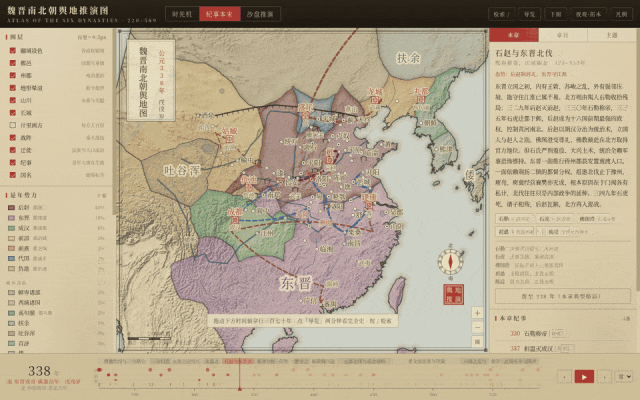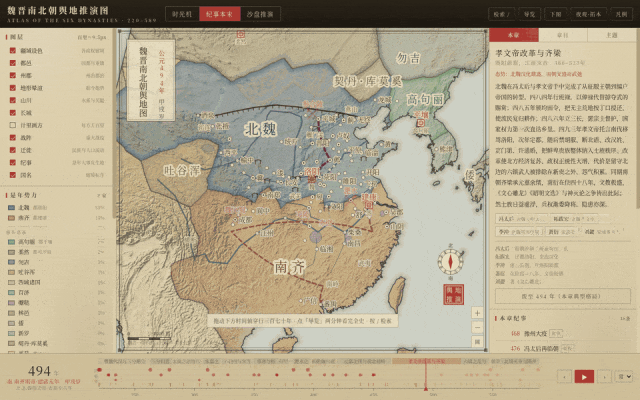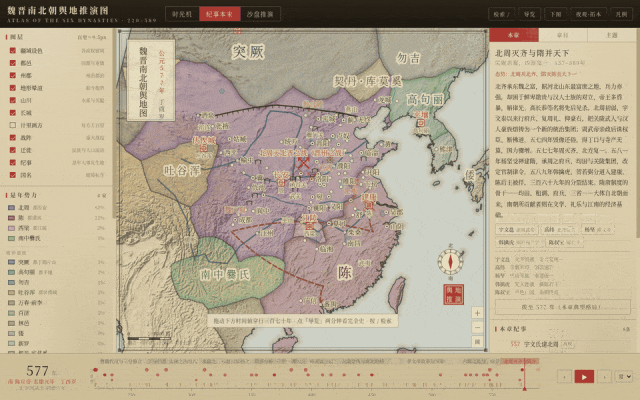
纪事本末沿十四个历史阶段切换代表年份与格局解说
从三国鼎立、西晋统一、十六国并起,到北魏、东西魏、北齐北周与隋,每一章都把代表年份、势力格局和事件说明放回同一张地图。
我还给这张地图准备了时光机、纪事本末和沙盘推演三种模式。可以沿着年份一路往后看,也可以只盯住一场战役、一条迁徙路线,或者一个完整的历史章节,顺着其中的线索慢慢展开。
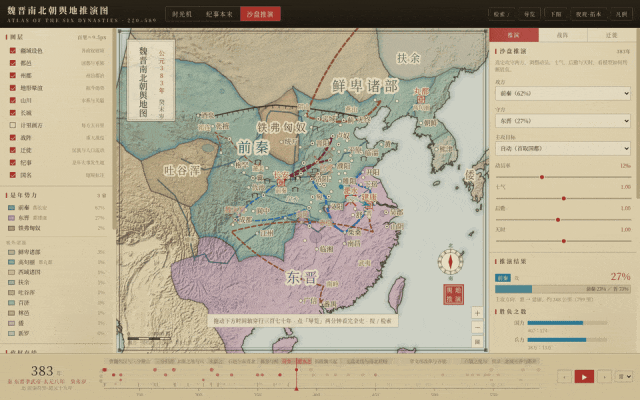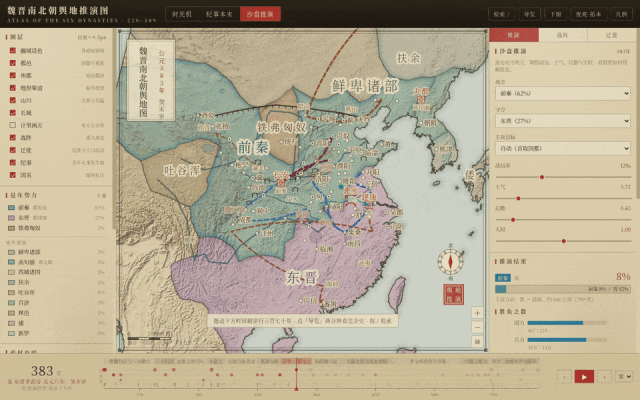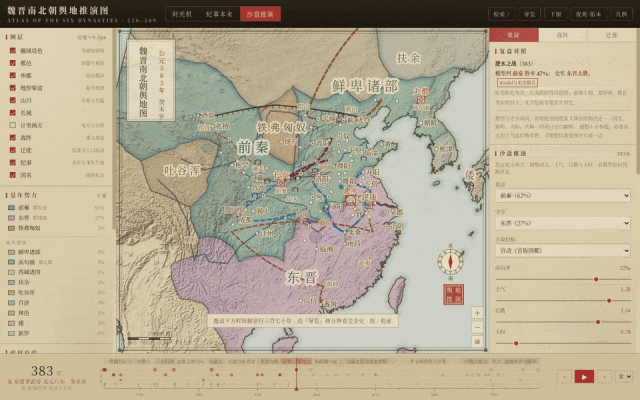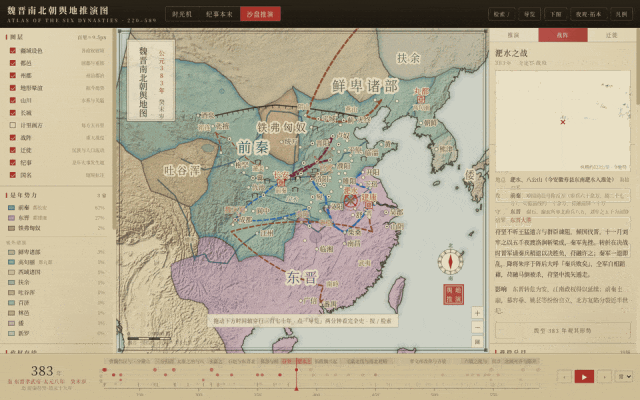
载入淝水之战,调整动员、士气、后勤和天时并对照史实复盘
沙盘模式会先给出双方条件与推演结果,再回到战役经过、转折和影响,让模型判断与史实并排出现。
历史类项目给模型出的题,又和前两个不同。政权什么时候存在,一座城在哪一年归谁,都城何时迁走,某场事件发生在什么年份,战役路线怎样画,迁徙指向何处,这些信息最后又要同时落到地图、颜色、标签、时间轴和右侧文字上。它帮人把一段极其零碎的历史拼成整体,让数百年的变化,在脑海里逐渐长出一张能够移动的图。
04 三个项目真正考的,是模型能不能把事情做完
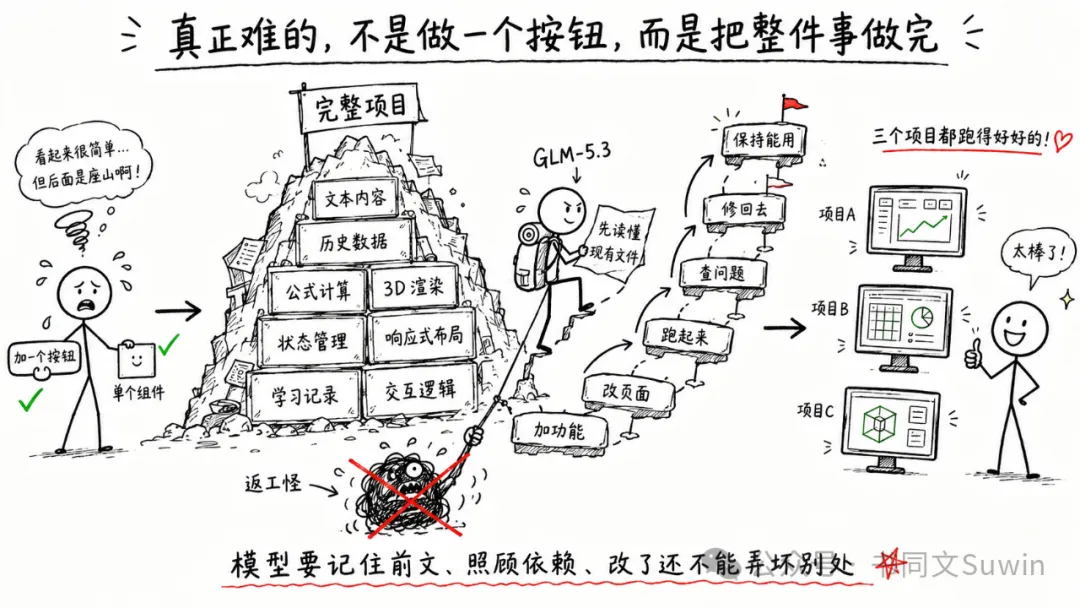
三个页面有长篇内容,有历史数据,也有公式计算、画布图表、三维渲染、状态管理、响应式布局、学习记录和大量彼此牵连的交互。
这一次我感受最深的,是它在长任务里的延续能力。核物理网站接近 2 万行以后,它依然能够顺着原来的章节、组件和状态系统继续做。洗衣机项目需要同时照顾三维模型、零件档案、图表和拆解步骤,它也能够把几部分的关系维持住。历史沙盘的大量资料全都塞在一个单文件里,年份的变化依然能够带动整套界面一起改变。
当然,它也会犯错。三维页面一不留神就容易变得太重;有些科学参数表面上看起来合情合理,往下追却找不到足够清楚的出处;历史疆界更不可能只看生成结果,仍然要人工核对。模型越来越擅长把一套系统搭起来,可资料是真是假,数字边界在哪里,最终结果能不能通过验收,这些是属于我们人类的责任,没有随着 AI 能力增强而消失。
05 这次 GLM 抢回来的,是工程交付的位置
从公开结果来看,GLM-5.3 在 Terminal-Bench 3.0 上得到 28.3,Kimi K3 是 17.4。在 DeepSWE v1.1 上,GLM-5.3 得到 66.9,DeepSeek-V4 Pro-0813 是 62.7。Agents' Last Exam 的命令行任务中,它得到 28.5,同样处在开源模型首位。
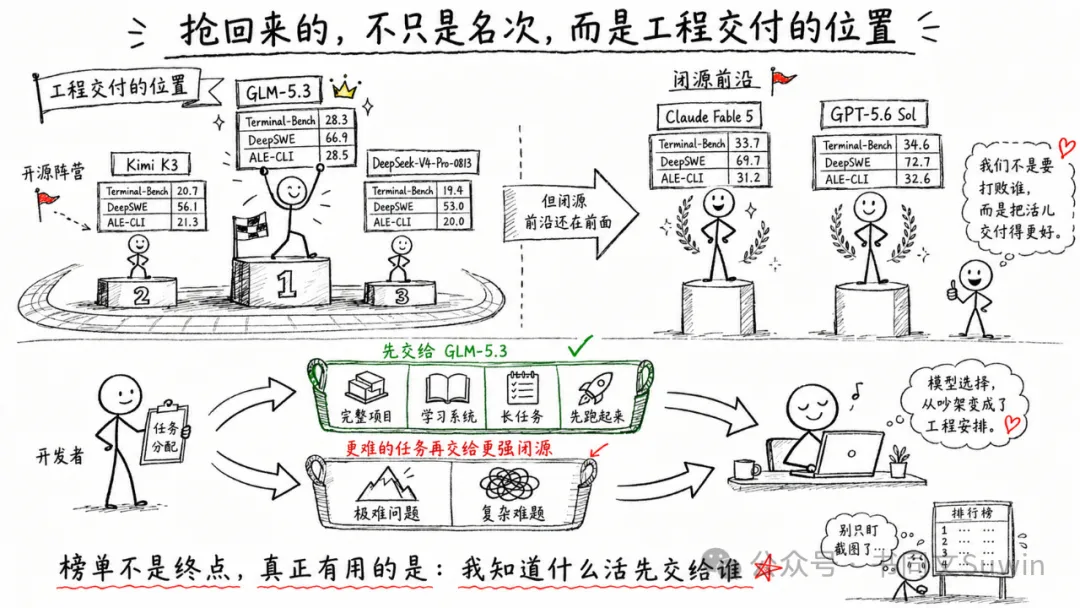
这并不意味着它已经在所有任务上越过最强的闭源模型。Terminal-Bench 3.0 上,Claude Fable 5 是 33.7,GPT-5.6 Sol 是 34.6。DeepSWE v1.1 上,两者分别得到 69.7 和 72.7,这样的距离仍然存在。
可当开源模型走到这个位置以后,开发者安排工作的方式已经会随之改变。越来越多完整项目,可以先交给 GLM-5.3 去做;那些仍然存在明显能力差距的困难任务,再交给更贵更强的闭源模型。
06 我现在更愿意用这种方式看一个新模型
模型刚发布的时候,大家盯着看的总是榜单。可榜单更新得很快,今天还在讨论的一张截图,过不了多久就会被下一张替代。真正做出来的东西,却可以继续留在那里。
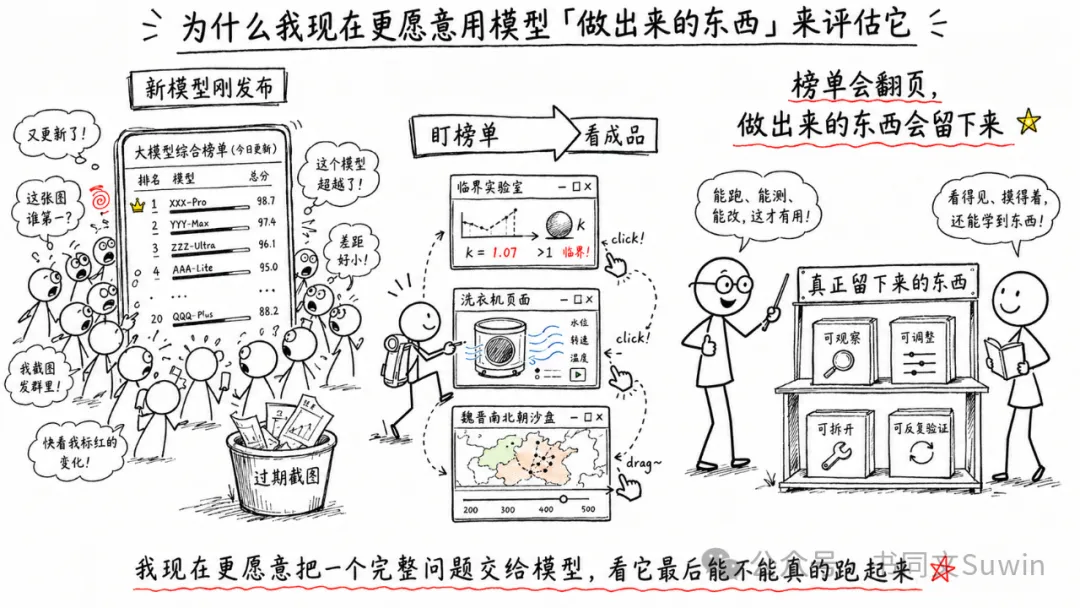
在临界实验室里,读者可以亲手改变半径,看着 k 一点点越过 1。到了洗衣机页面,原本藏在金属外壳后面的风道、冷凝器和压缩机被一件件显出来。再到魏晋南北朝沙盘,369 年的兴亡更替被收入一条时间轴里,只要拖动年份,整张地图便随着历史一道变化。
原本只能坐下来阅读的知识,因此有了另一种形态。它们可以被观察,可以被调整,可以一层一层拆开,也可以在变化中反复验证。
比名次更值得看的,是它再次把一个问题摆到了我们面前。一个模型真正成为生产力,最终还是要进入完整项目,经历那些琐碎、漫长、彼此牵连,又不能轻易出错的工作。
