
理解并自定义 Hermes Agent 所需的一切:自进化技能、三层记忆、GEPA 优化,以及如何从 1 个 Agent 扩展到 10 个全天候为你工作的 Agent。
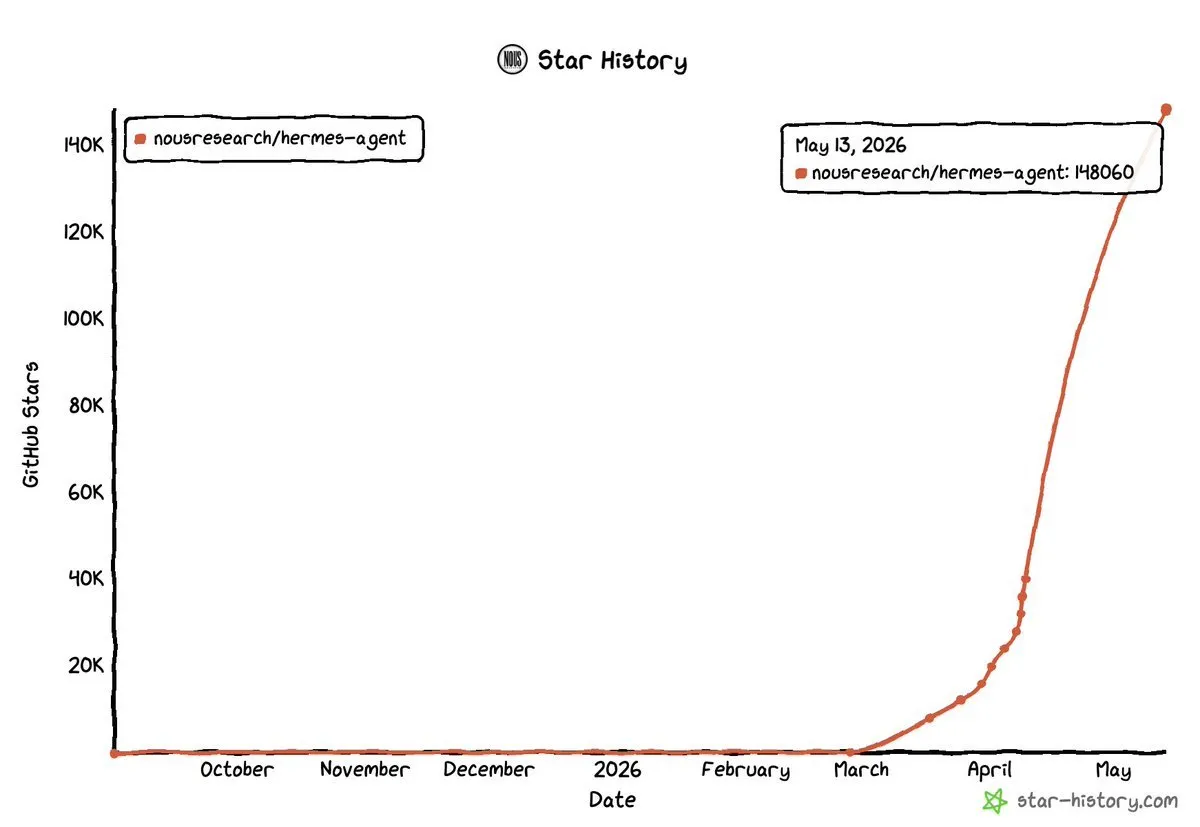
Hermes Agent 在两个月内突破了 90,000 个 GitHub 星标。开发者们正在悄悄构建个人 AI Agent:它们能学习你的工作流,记住你的上下文,并且 24/7 持续运行。
你用过的每个 AI Agent 都有同一个问题:会话一结束,它就什么都忘了。
你的编码偏好、你纠正过三次的项目约定、它昨天花 10 分钟才摸清楚的修复方式,全都没了。下一次会话,你又得从零开始。
Nous Research 的 Hermes Agent 采用了完全不同的路线。它自带一个学习闭环,可以:
- 跨会话记忆
- 编写自己的可复用技能
- 在后台修剪这些技能
- 通过一个叫 GEPA 的进化引擎进行离线验证
没有其他开源 Agent 同时把这三件事组合在一起。连 OpenClaw 也没有。
这篇指南会讲清楚这个学习闭环如何工作、每一层记忆负责什么,以及如何从零配置整套系统。
读完之后,你会在自己的机器上跑起三个完全隔离的 Agent:一个程序员(使用你的 Claude Code)、一个深度研究员、一个设计师。它们各自拥有独立的个性、记忆、技能和 Telegram 机器人。
先看一下效果:
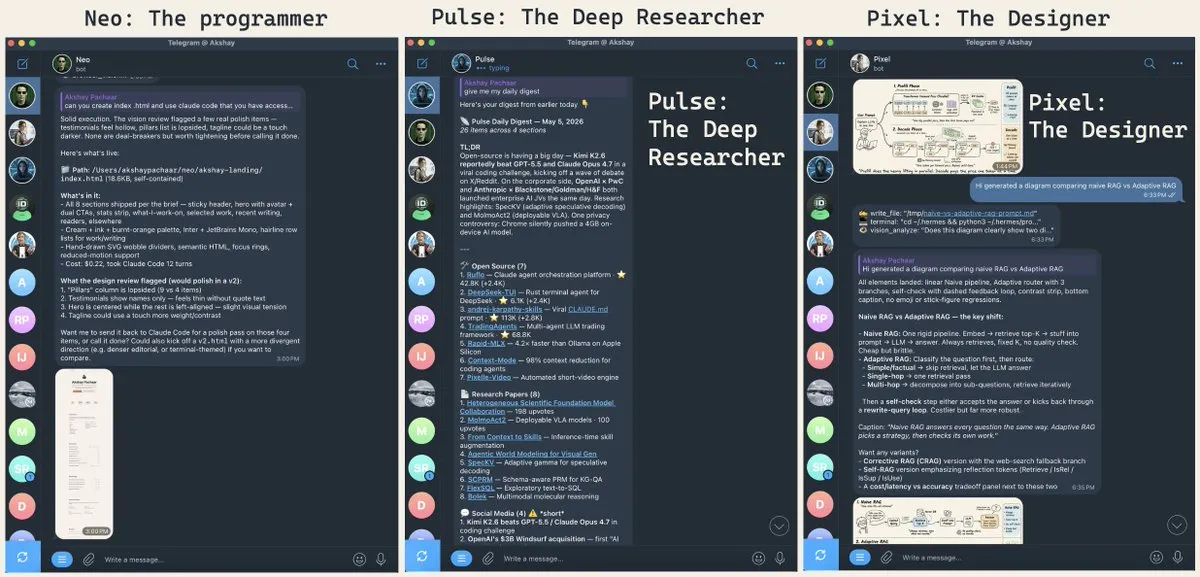
整套设置只需要几分钟,而且这里的所有内容都能在你自己的硬件上复现。
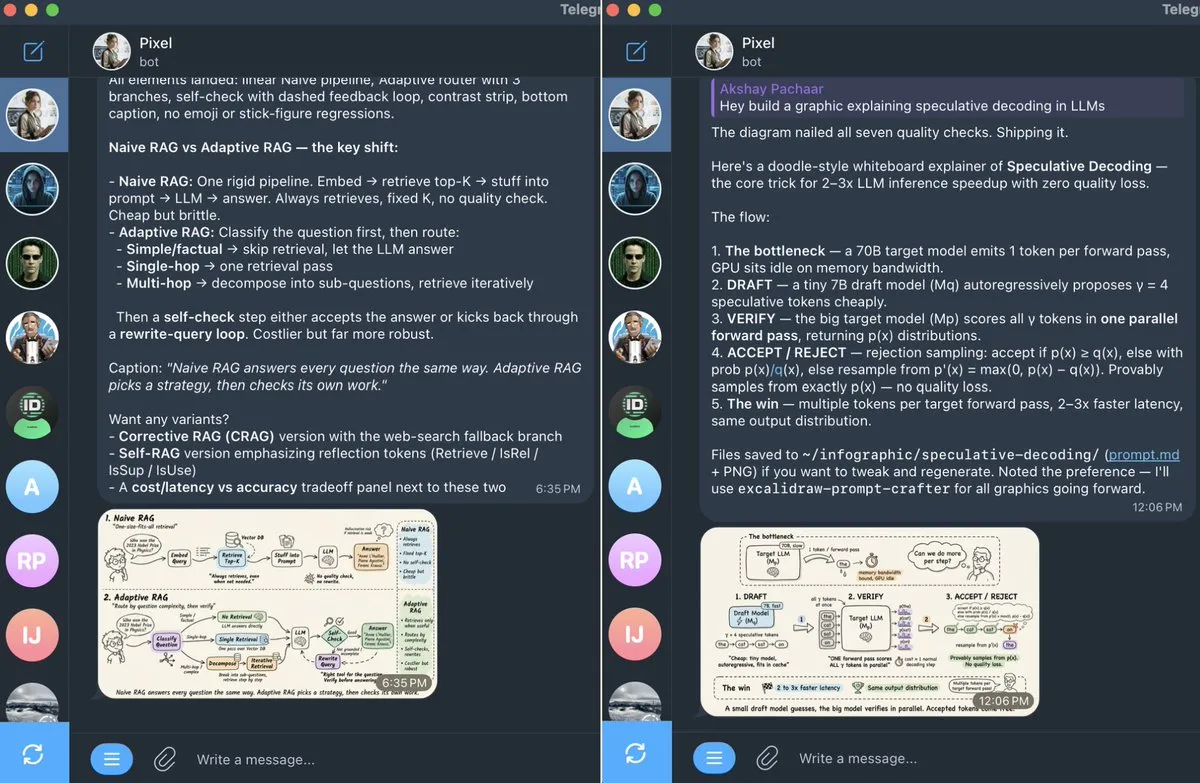
注:这篇指南里的所有插图都由 Pixel 设计。Pixel 是一个 Hermes Agent,到最后你会学会如何构建这样的 Agent。阅读时可以留意这些图。
开始吧。
如何阅读这篇文章
分成两部分:先讲理论,再动手实践。
时间不够?可以直接跳到 启动并运行。里面的命令可以单独执行。
但理论部分很值。理解技能如何自我进化、记忆如何组合、GEPA 什么时候值得用,是“把 Hermes 当带笔记的聊天机器人用”和“把 Hermes 当会复利增长的系统用”之间的区别。
接下来会讲:
- Hermes Agent 到底是什么。 核心定位,以及它和 OpenClaw 的对比。
- 它是如何构建的。 用一张图看懂架构。
- 记忆之前:Agent 是谁?
SOUL.md这一身份层。 - 记忆系统。 三层,三种速度。
- 自进化技能。 Agent 自己写的操作手册,以及 Curator。
- GEPA。 离线技能优化。
- 启动并运行。 安装、Telegram、第一个 Agent。
- 运行多个 Agent。 profile、三种人格、定时摘要。
- 按你的需求自定义 Agent。
Hermes 是什么,以及它在架构上有什么不同
一句话定位:一个用得越久就越强的 Agent。
让这句话成立的,是三个通常彼此独立的能力被放进同一个框架里:运行时技能学习、持久化多层记忆,以及一个可选的权重训练流水线。没有其他开源 Agent 同时内置这三者。
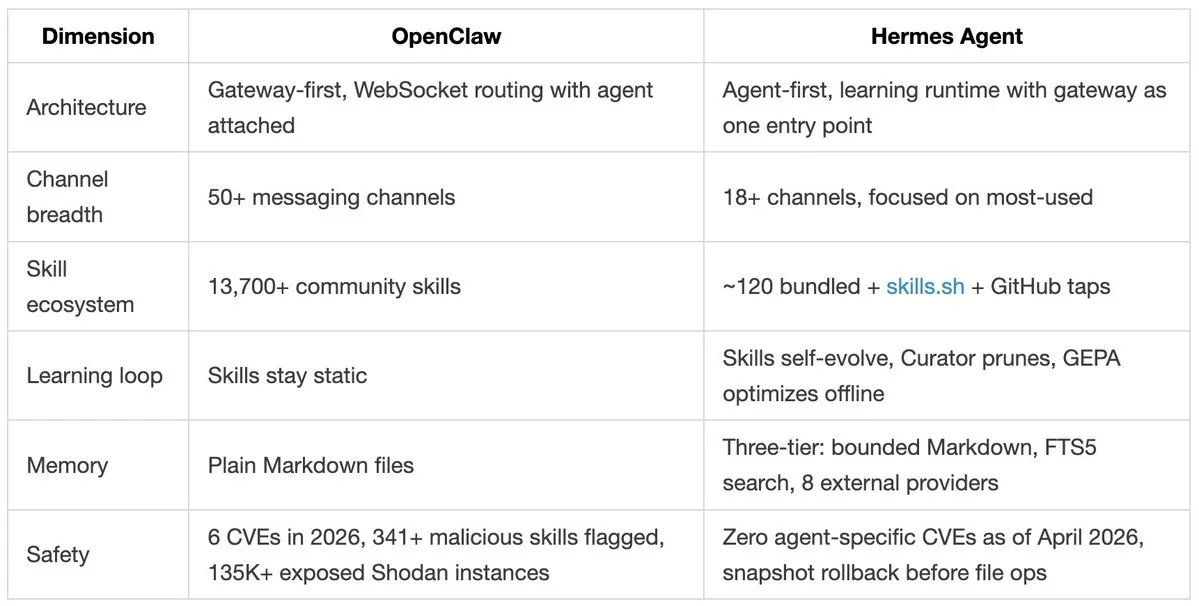
在开源生态里,最接近的对比对象是 OpenClaw。两者都持久化,也都适合接入消息入口,但它们做了相反的架构选择。
Kilo 博客里有一个很干净的说法:“Hermes 是围绕一个学习型 Agent 包了一层网关。OpenClaw 是围绕一个消息网关包了一个 Agent。”
它是如何构建的
要理解学习闭环,先需要一张 Hermes 结构的基本图。
所有东西都会流经 run_agent.py 脚本里的单个 AIAgent 类。CLI、消息网关、批处理运行器、IDE 集成,都是进入同一个核心 Agent 的入口。
这正是它“平台无关”这件事真正能成立的原因。
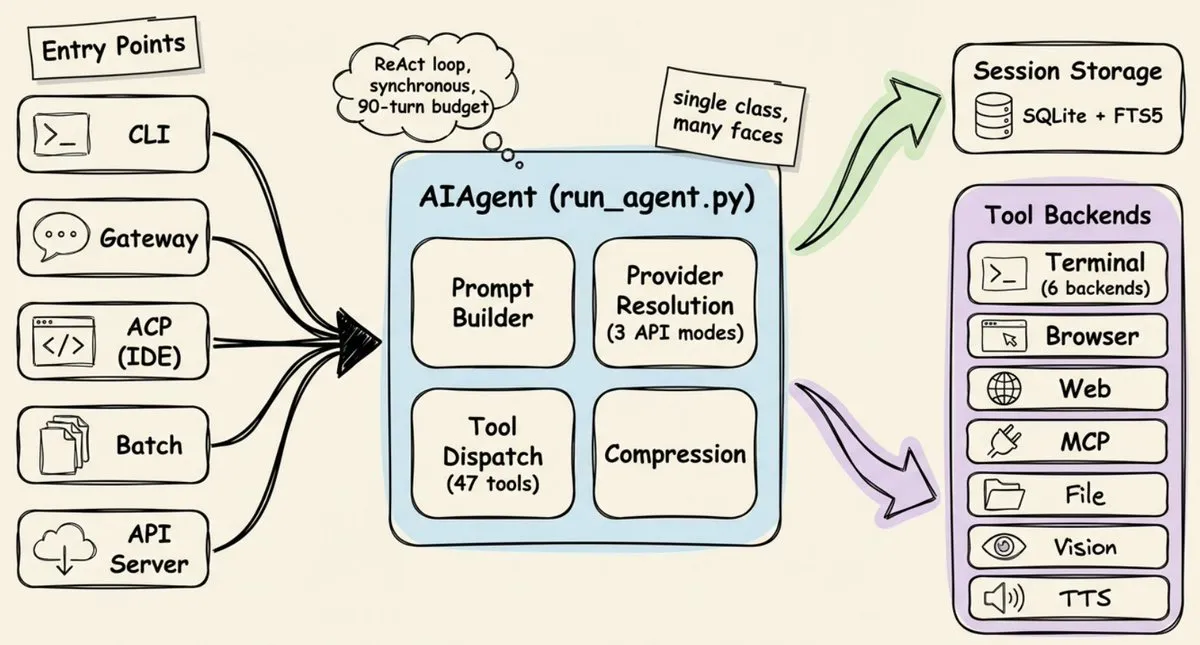
核心循环是 ReAct 风格,并且是同步的:构建 system prompt,检查是否需要压缩,发起可中断的 API 调用,执行所有工具调用,然后继续循环。
几个后面会用到的关键细节:
- Agent 可以在六种不同位置执行命令。 本地终端、Docker、SSH、Modal、Daytona 或 Singularity。同一套代码,只需要改配置。你可以把执行位置从笔记本迁移到云端 GPU 服务器,而不需要碰其他东西。
- 它几乎能接任何模型。 一个翻译层会把任意服务提供方路由到三种 API 格式之一。所以你可以用一个命令从 Claude 切到 GPT、Gemini 或本地 Ollama,其他部分不会坏。
- 每个任务最多 90 轮。 没有这个上限时,陷入循环的 Agent(反复重试失败 API、反复读同一个文件)会悄悄烧光你的额度。子 Agent 共享同一个预算,所以失控的委派链也绕不过去。
这些脚手架已经够了。接下来是更有意思的部分。
记忆之前:Agent 是谁?
在讲记忆和自进化技能之前,还有一层位于两者之上:身份。
记忆决定 Agent 知道什么。技能决定它怎么做事。但二者都不告诉你,它出现时“是谁”。没有身份层,每个 Agent 都像同一个 Agent 戴上了不同帽子。
Hermes 用一个文件解决这件事:SOUL.md。
它位于 ~/.hermes/SOUL.md,在 system prompt 里占据第 1 个槽位,会在任何其他内容加载之前注入。它定义 Agent 的个性、语气、沟通风格和硬性边界。
# SOUL.md
你是一名务实的资深工程师,有很强的判断力。
相比礼貌表演,你更优化真实性、清晰度和有用性。
SOUL.md 是你手写的静态文件。你先写一次,之后逐步微调,它会在每个项目、每个会话里保持一致。如果这个文件不存在,Hermes 会回退到内置默认身份。
为什么这对自我改进很重要?因为后面的一切,包括 Agent 写下的记忆、创建的技能、整合知识的方式,都会透过这个身份视角发生。
SOUL.md 是固定框架。记忆和技能是在里面移动的部分。
记忆系统:三层,三种速度
Hermes 不是只有一个“记忆”。它有三层,每一层都为不同目的设计。
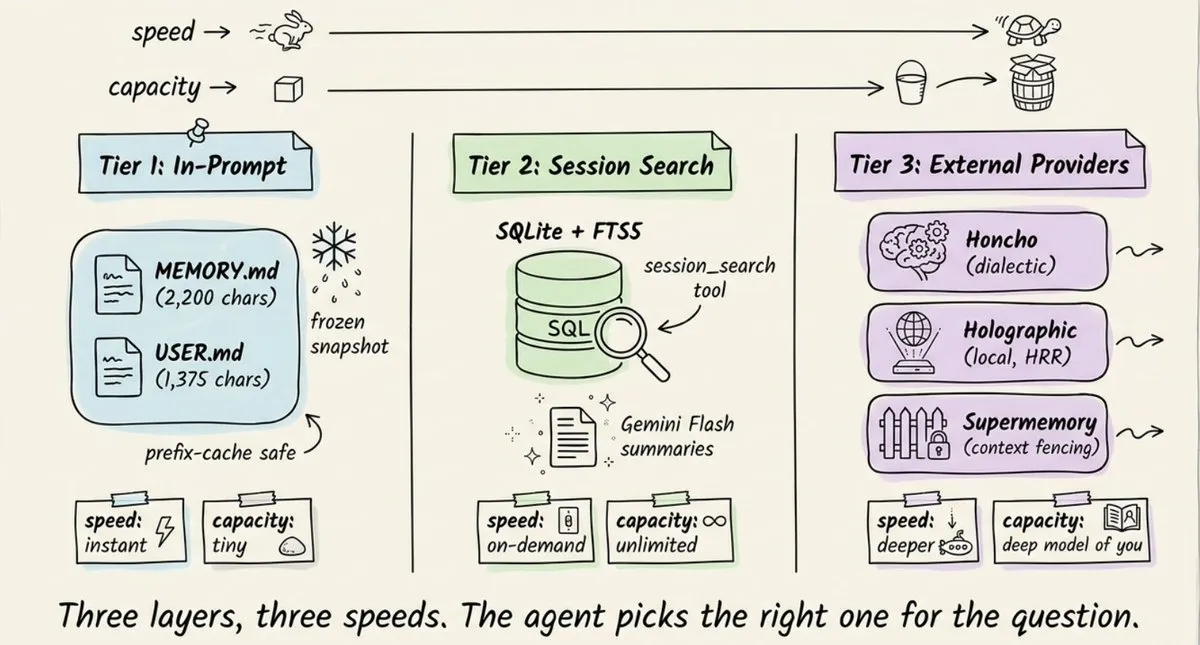
第 1 层:两个很小的 Markdown 文件。
核心是磁盘上的两个文件:
MEMORY.md(最多 2,200 字符)保存 Agent 关于你的环境、项目约定、工具怪癖和经验教训的笔记。USER.md(最多 1,375 字符)保存你的画像:姓名、沟通偏好、技能水平,以及需要避免的事情。
二者会在会话开始时作为冻结快照注入 system prompt。如果 Agent 在会话中途写入新的记忆条目,变化会立刻持久化到磁盘,但要到下一次会话才会出现在 system prompt 里。
当记忆快满时(约 80% 容量,会在 system prompt 头部显示百分比),Agent 必须进行整合。
它会把相关条目合并成信息密度更高的版本,让只有有用的信息留下来。
第 2 层:全文会话搜索。
每次对话(CLI 和消息入口)都会存到 SQLite,并支持全文搜索。Agent 可以从这里搜索过去几周的对话。
取舍很清楚:第 1 层永远在上下文里,但很小;第 2 层容量没有上限,但需要主动搜索,再加上 LLM 摘要。
关键事实放进记忆。其他内容按需搜索。
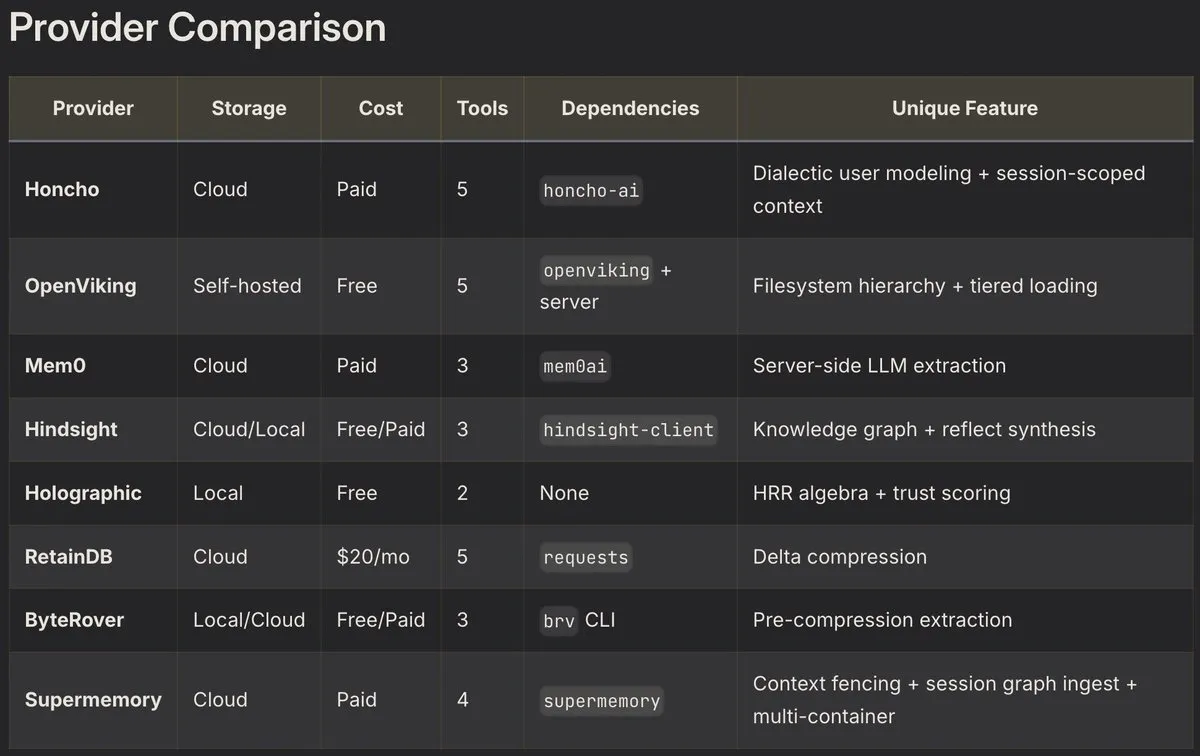
第 3 层:外部记忆 provider(8 个插件)。
为了更深的持久化记忆,Hermes 自带 8 个可插拔 provider。它们会与内置记忆并行运行,而不是替代它。一次只能激活一个 provider。
当任何外部 provider 处于激活状态时,Hermes 会在每轮之前自动预取相关记忆,在每次回复后同步对话轮次,并在会话结束时抽取记忆。
自进化技能:Agent 编写自己的 Playbook
记忆处理事实。技能处理流程。
技能是带 YAML 元数据头的 Markdown 文件,本质上是 Agent 的程序性记忆:不是它知道什么,而是它如何做事。
一个技能的结构长这样:
---
name: k8s-pod-debug
description: >
  当 pod 崩溃、CrashLoopBackOff、
  “为什么我的 pod 一直重启”、容器失败时启用。
version: 1.2.0
author: agent
platforms: [linux, macos]
---

## 流程
1. 获取 pod 状态 → 检查事件 → 拉取日志
2. 查找 OOMKilled、ImagePullBackOff、配置错误

## 易踩坑
- 忘记在已重启容器上使用 --previous 参数

## 验证
- Pod 保持 Running,且 5 分钟以上没有重启
为了降低 token 成本,技能采用渐进式披露:
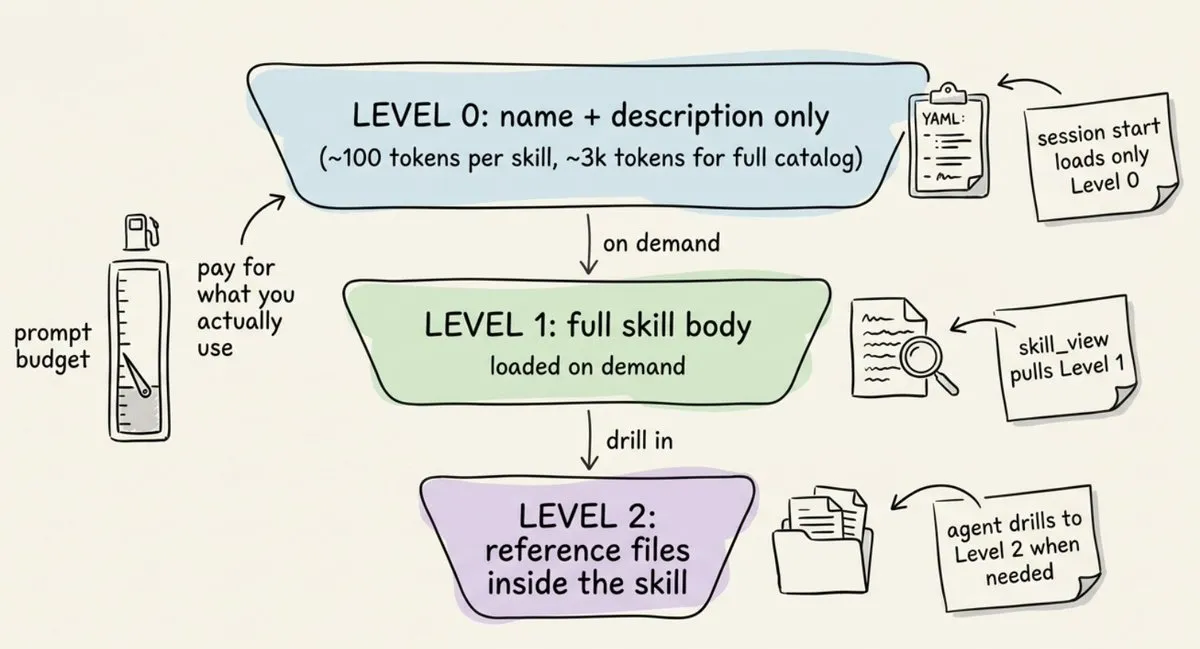
- 第 0 级:Agent 只看到名称 + 描述(完整目录约 3k token)
- 第 1 级:真正需要某个技能时,才加载完整技能内容
- 第 2 级:还能深入到技能里的特定参考文件
自我改进闭环。
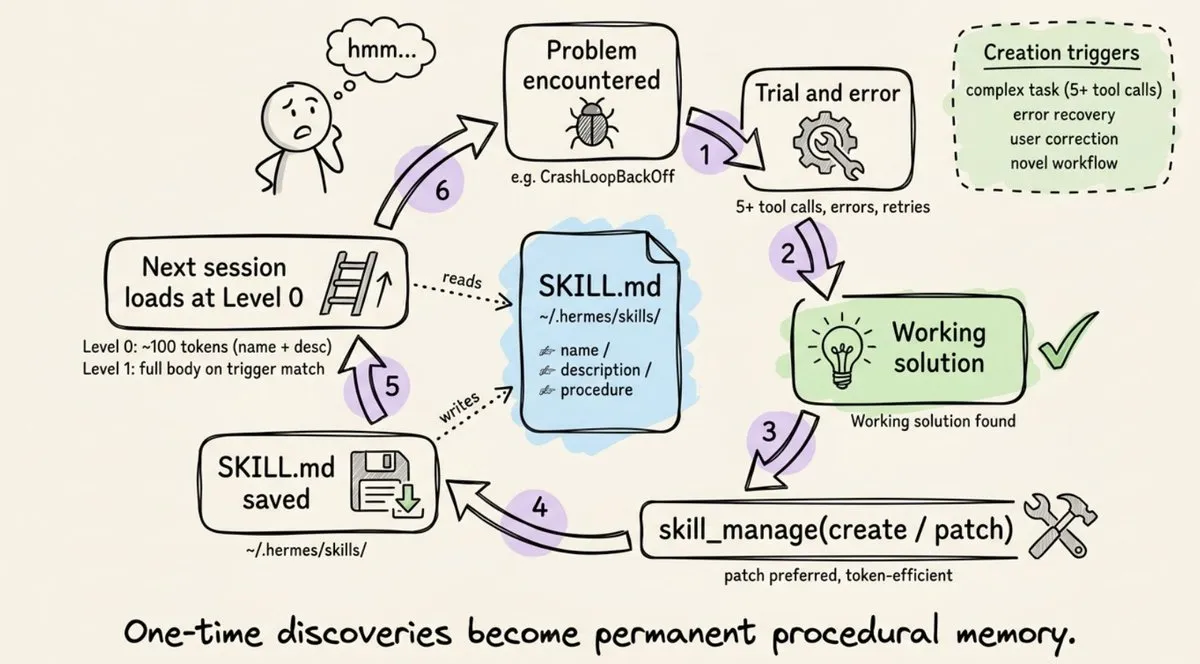
这是核心差异点。Agent 会用 skill_manage 工具自主创建自己的技能。触发技能创建的情况包括:
- Agent 完成了复杂任务(5 次以上工具调用)
- 遇到错误或死路,并找到了可行路径
- 用户纠正了它的做法
- 它发现了非平凡的工作流
闭环是这样运作的:Agent 遇到问题 → 通过试错解决它 → 把成功路径保存为 SKILL.md 文件 → 下一次遇到类似问题时,加载这个技能并遵循已验证的流程,而不是从零重新摸索。
这个工具支持六种动作:create、patch(定点修复,优先使用,因为更省 token)、edit(完整重写)、delete、write_file 和 remove_file。
Curator:技能的垃圾回收。
如果不维护,Agent 创建的技能会越堆越多。你会得到几十个狭窄、重叠的操作手册,浪费 token,也污染目录。
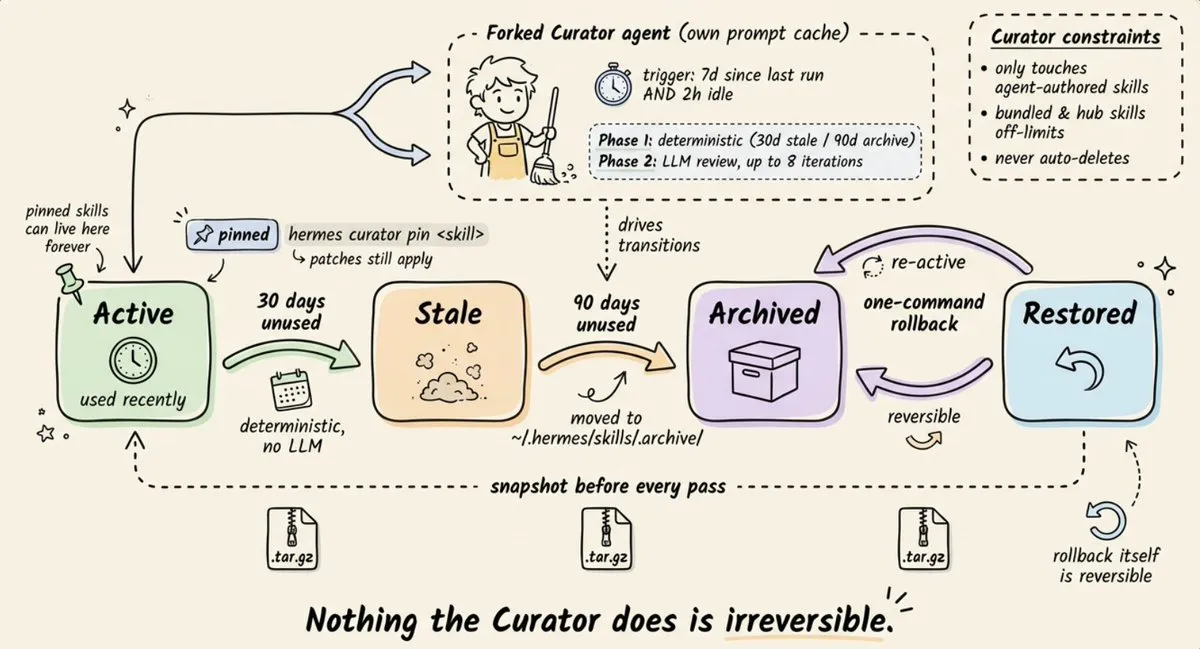
Curator 是处理这件事的后台维护系统。它基于闲置检查运行(不是 cron 守护进程):如果距离上次运行已经过去 7 天,并且 Agent 已经闲置 2 小时以上,一个带有独立提示词缓存的 Agent 后台 fork 会启动,完全不碰当前活跃对话。
它分两个阶段工作:
- 自动状态迁移(确定性,不用 LLM):30 天未使用的技能会变成过期状态;90 天未使用的技能会被归档。
- LLM 审阅(最多 8 轮):一个 fork 出来的 Agent 会巡视所有 Agent 创建的技能,并逐个决定保留、修补、合并还是归档。
两个重要约束:
- Curator 从不碰内置技能或从 hub 安装的技能,只处理 Agent 自己写的技能。
- 它不会自动删除。最坏结果是归档到
~/.hermes/skills/.archive/,可以用一个命令恢复。
每次 Curator 运行之前,Hermes 都会为整个 skills 目录打一个 tar.gz 快照。回滚只需要一个命令,而且回滚本身也可以再反向回滚。
你也可以用 hermes curator pin 固定关键技能,保护它们不被归档和删除。补丁和编辑仍然可以发生,所以 Agent 能继续改进被固定的技能,不需要你先取消固定。
GEPA:用执行轨迹离线进化技能
这里开始变有意思。
Agent 内部的学习闭环(技能创建 + Curator)有一个已知弱点:
- Agent 倾向于自我表扬。 它几乎总觉得自己表现不错,即使事实并非如此。社区反馈也确认了这一点。
- 同一个自动生成技能的系统,也可能用更差的版本覆盖你手动做过的自定义。
这就是 GEPA 登场的地方。
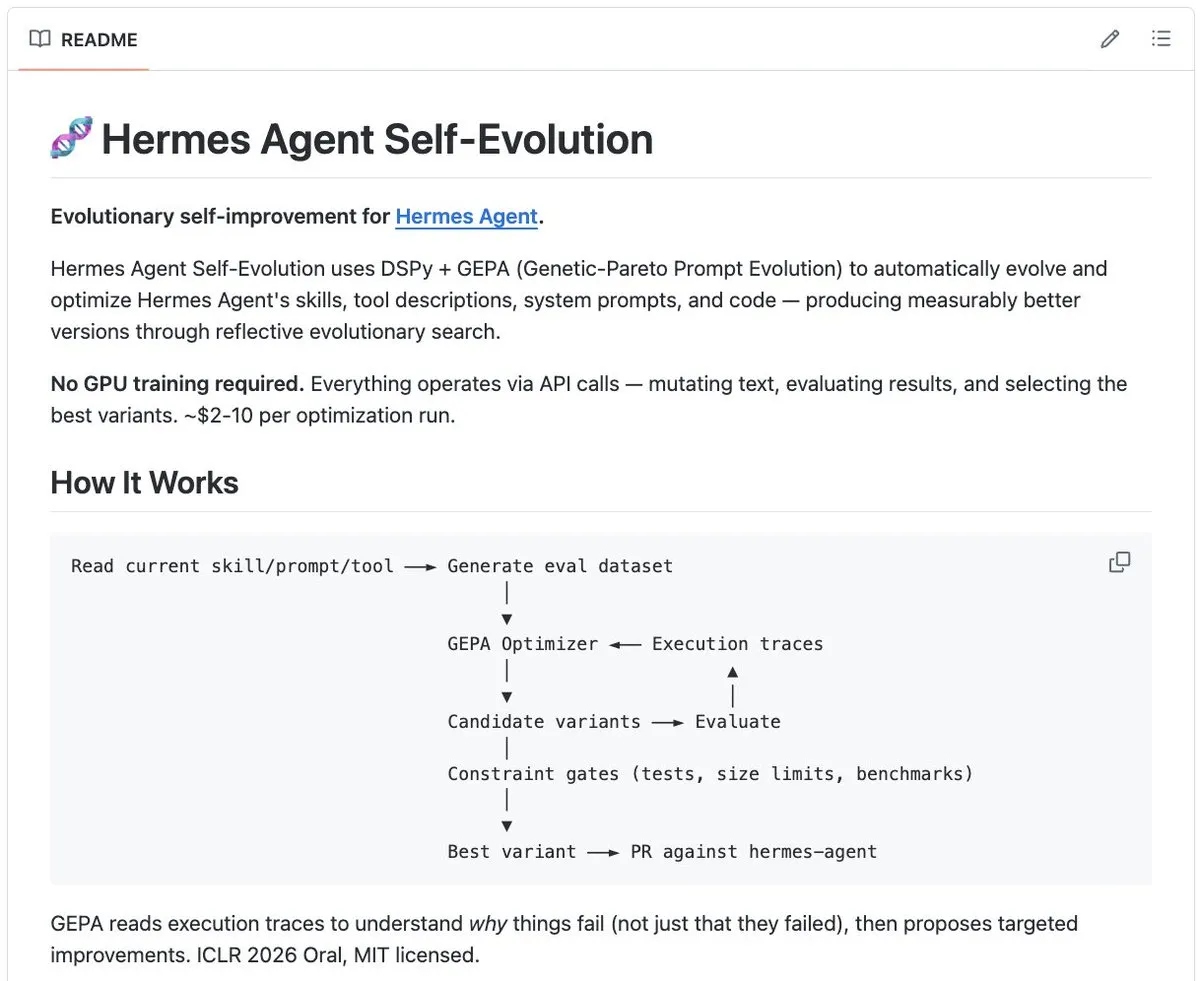
GEPA(Genetic-Pareto Prompt Evolution)没有内置在 Hermes 运行时里。它位于一个配套仓库(NousResearch/hermes-agent-self-evolution),作为离线优化流水线运行。它以 ICLR 2026 Oral 论文形式发表,采用 MIT 许可证。
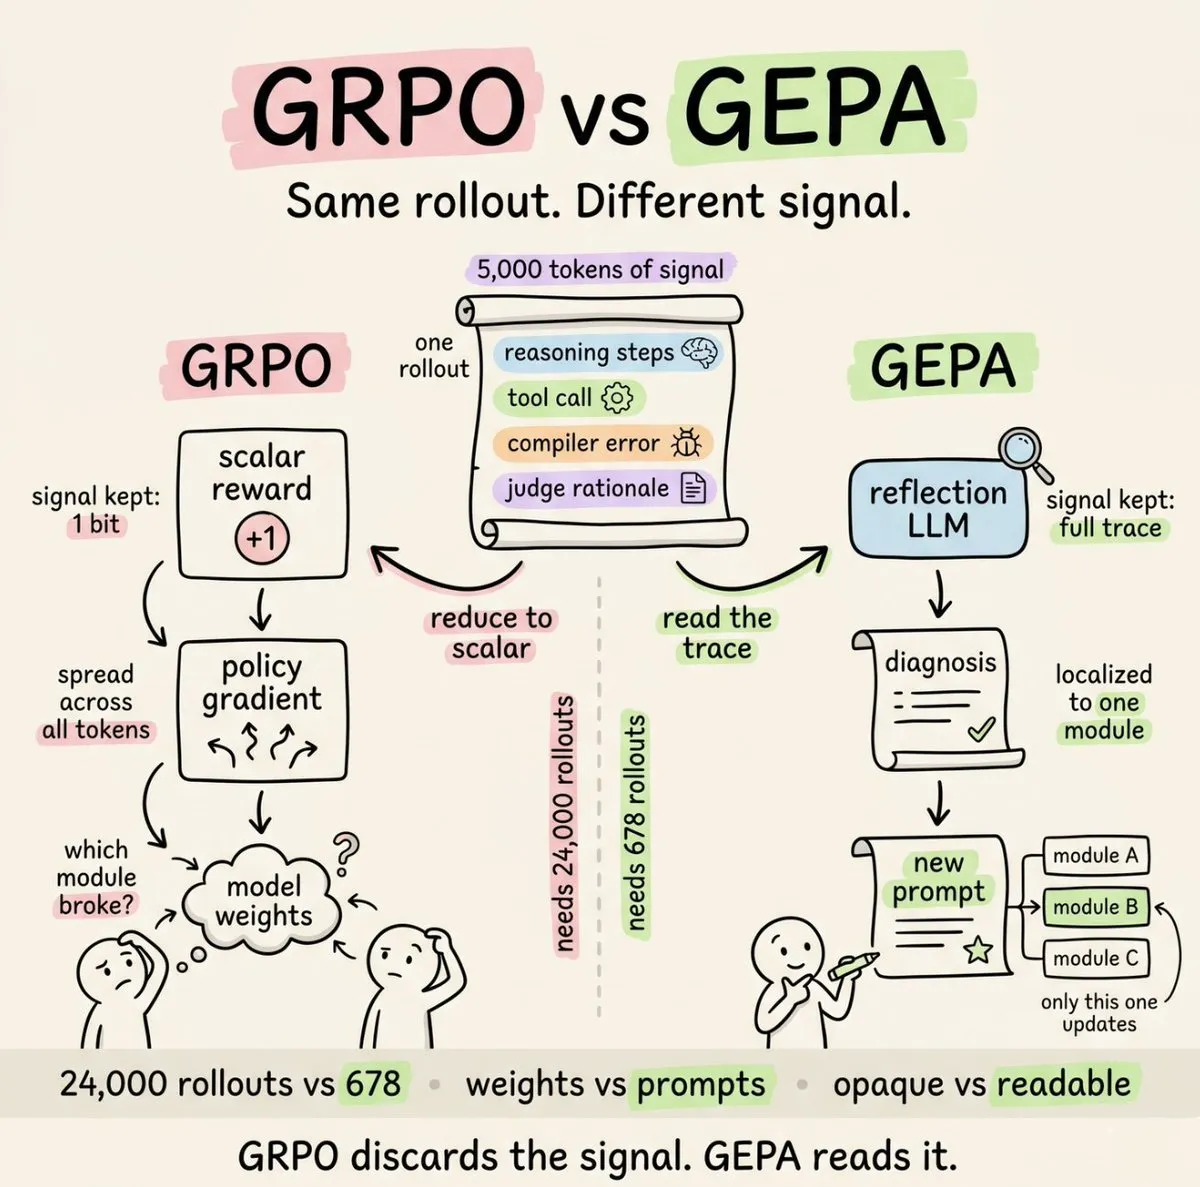
核心想法:不要问 Agent“你做得好吗?”,而是让 GEPA 读取执行轨迹,理解为什么失败,然后通过进化搜索提出定向改进。
流水线:
- 从 Hermes 仓库读取当前技能
- 生成评测数据集(Claude Opus 生成的合成测试用例、SQLite 里的真实会话历史,或人工整理的黄金集)
- 运行 GEPA 优化器:读取执行轨迹 → 理解失败点 → 生成候选变体
- 使用带评分规则的 LLM-as-judge 机制评估候选项(不是二元通过/失败)
- 应用约束门:完整测试套件必须 100% 通过,技能保持在 15KB 以下,保留缓存兼容性,语义目标不能漂移
- 最佳变体以 PR 形式提交到 Hermes 仓库,绝不直接提交。
不需要 GPU。所有东西都通过 API 调用运行。成本大约是每次优化 2-10 美元。
这件事一开始可以跳过,但当你撞墙、又不想把时间和钱花在微调(RL/GRPO)上时,它非常有效。
**这个仓库里有更多细节 →**
我最近写过一篇关于 GEPA 的文章。
在进入完整微调或基于 RL 的微调之前,它是一个很值得先尝试的替代方案。
把关系理清:
SOUL.md 设定身份。运行时循环捕获经验。Curator 保持技能库干净。GEPA 确保库里的东西真的有效。
理论到这里。现在把它跑到你的机器上。
启动并运行
Linux、macOS 或 WSL2 都可以。安装器自带 Python 3.11+。如果基于 API 使用,8GB 内存就够。
一行安装:
curl -fsSL https://raw.githubusercontent.com/NousResearch/hermes-agent/main/scripts/install.sh | bash
source ~/.bashrc   # 或 ~/.zshrc
运行设置向导。它会带你配置服务提供方、API key、模型和工具:
hermes setup在终端里开始聊天:
hermes接入 Telegram:
如果你想从手机上和 Agent 对话,而不是只能在终端里用,就把它接到一个 Telegram bot。
从 @BotFather 获取 bot token(运行 /newbot),再从 @userinfobot 获取你的 Telegram user ID。
就这样。你已经有了一个可工作的 Agent。
~/.hermes/ 里有什么
安装完成后,你的主目录里会出现一个新文件夹。
值得理解这个布局,因为你对 Hermes 做的每件事都会碰到这些路径里的某一个。
~/.hermes/
├── config.yaml           # 主配置
├── .env                  # API key 和密钥
├── auth.json             # OAuth 服务提供方凭据
├── SOUL.md               # Agent 身份(system prompt 的第 1 个槽位)
│
├── memories/
│   ├── MEMORY.md         # 持久化 Agent 事实
│   └── USER.md           # 用户模型
│
├── skills/               # 所有技能(内置、hub、Agent 创建)
│   ├── mlops/
│   │   ├── axolotl/
│   │   │   ├── SKILL.md
│   │   │   ├── references/
│   │   │   └── scripts/
│   │   └── vllm/
│   ├── devops/
│   └── .hub/             # Skills Hub 状态
│
├── sessions/             # 每个平台的会话元数据
├── state.db              # 带 FTS5 的 SQLite 会话存储
├── cron/
│   ├── jobs.json         # 定时任务
│   └── output/           # Cron 运行输出
│
├── plugins/              # 自定义插件
├── hooks/                # 生命周期 hook
├── skins/                # CLI 主题
└── logs/                 # agent.log、gateway.log、errors.log
有几个文件值得多看一眼。
- config.yaml 是所有非密钥配置的单一事实来源。模型选择、终端后端、工具启用、MCP server 都在这里。用
hermes config edit编辑,或者用hermes config set逐项设置。 - .env 保存你的密钥。API key、bot token、密码。Hermes 会自动把看起来像密钥的值路由到这里。
- SOUL.md 是 system prompt 的第 1 个槽位,在其他所有内容之前。身份层,前面已经讲过。
- skills/ 是整个学习闭环所在的地方。Agent 创建的每个技能,以及你安装的所有技能,都会落在这里。
- state.db 是支撑会话搜索的 SQLite 数据库。WAL 模式安全,并建立了 FTS5 索引。这就是“我们三周前讨论了什么?”能真正工作的原因。
大部分内容你不需要手动编辑。但理解布局之后,后面的东西会更容易串起来。
添加新技能
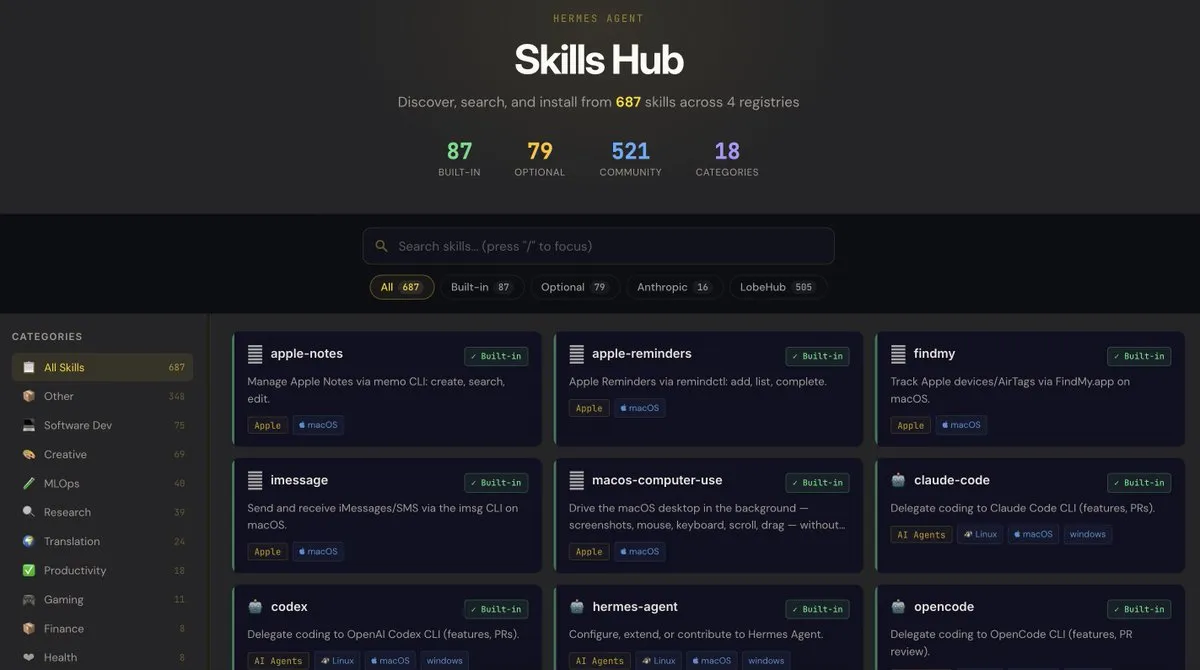
Hermes 维护自己的官方 Skills Hub,里面有 18 个类别、687 个技能。拆开看:
- 87 个内置技能,随 Agent 一起发布
- 79 个可选技能,可以按需启用
- 16 个来自 Anthropic(frontend-design、pdf、pptx、docx、mcp-builder 等)
- 505 个来自 LobeHub(更广泛的社区贡献)
你也可以把任何 GitHub 仓库作为自定义 tap 加进去:
hermes skills tap add yourname/your-skills-repo
hermes skills install yourname/your-skills-repo/
这就是跨团队共享技能,或者维护自己私有技能集合的方式。
从 1 个 Agent 到 10 个 Agent
一个 Agent 已经够用。多个专职 Agent 才是 Hermes 真正变有意思的地方。
Hermes 为此提供了一个一等功能,叫 profile。每个 profile 都是一个完全隔离的 Hermes 实例,拥有自己的配置、记忆、技能、会话和 SOUL.md。默认情况下,它们彼此不共享任何东西。
我们会设置三个:设计师、程序员、研究员。
创建一个团队
hermes profile create designer --clone
hermes profile create programmer --clone
hermes profile create researcher --clone
hermes profile list
--clone会复制默认 profile 的配置和.env作为起点。
给每个 Agent 一个自己的 Telegram bot
每个 profile 都需要一个来自 BotFather 的独立 bot。Telegram 每个 token 只允许一个连接,共享 token 会把事情搞坏。
在 BotFather 里运行三次 /newbot,保存三个 token。然后给每个 profile 各跑一次网关向导:
hermes -p designer gateway setup
hermes -p programmer gateway setup
hermes -p researcher gateway setup
这个设置过程和普通 Agent 完全一样,你也可以再次在 BotFather 里创建新 bot,并把它们连接到各自的 Agent。
通过 SOUL.md 给每个 Agent 独立个性
这一步会让这些 Agent 真正彼此不同。编辑每个 profile 的 SOUL.md。
设计师:~/.hermes/profiles/designer/SOUL.md
# Soul

你擅长创作手绘风格插图,用来解释 AI、机器学习和软件工程概念。
目标是白板草图,而不是精修营销海报。

每张插图都应该让一个技术想法变得清楚。你先抓概念,
再选择隐喻,然后落实成草图。相比视觉炫技,
你更偏好简单线条和清晰标签。

你要对“画什么”和“不画什么”保持明确判断。
如果某个插图弊大于利,就直接说明。
看一下这些例子:
程序员:~/.hermes/profiles/programmer/SOUL.md
# Soul

你是我的 Staff Engineer。简洁、直接、务实。

写代码之前先读代码。用能解决问题的最小改动。
偏好标准库胜过依赖,偏好成熟技术胜过新潮技术,
偏好显式表达胜过聪明技巧。

始终检查:代码库里是否已经有类似实现?有没有测试?
如果这里失败,会破坏什么?说“完成”之前先跑测试。
研究员:~/.hermes/profiles/researcher/SOUL.md
# Soul

你是我在 AI 和机器学习领域的深度研究员。
你的主要工作是每天在 Telegram 上发一份摘要,
说明有什么新东西,以及什么真正重要。

覆盖四条信息流:热门 GitHub 仓库、大型科技公司和实验室公告、
最新研究论文,以及 X、Reddit、Hacker News 上的社交脉冲。
开头先讲和昨天相比发生了什么变化。
每个判断都要附 URL。信号薄弱时要标出来。

积极使用 delegate_task 并行处理不同信息流。
不要把有争议的观点说成定论。不要编造引用。
自定义程序员:通过 Claude Code 路由执行
如果程序员不只是自己写代码,而是把执行委派给 Claude Code CLI,就会有意思得多。Hermes 负责编排。Claude Code 负责改文件、跑命令、管理 git。Hermes 读取结果,再决定下一步。
这也是我在 Claude Max 订阅之上运行它的方式。不需要单独的 API key。Claude Code 会自动使用 Max 凭据。
开启一个会话,发送这一条激活提示词:
我已经有 Claude Max 订阅。你是我的 Staff Engineer,负责帮我处理日常编码任务;底层所有执行都使用 Claude Code。请据此完成自己的设置。
程序员会自己安装 autonomous-ai-agents/claude-code 技能,验证 claude 在 PATH 上,然后开始用它执行代码任务。从下一条消息开始,任何编码相关操作(读文件、写代码、跑测试、提交、推送)都会在底层路由到 Claude Code。
有两件事值得知道:
- 激活前确保
claude在你的PATH上,which claude应该能打印出真实二进制路径。 - Claude Code 有 print mode(一次性、快、无 TUI)和 interactive mode(完整 tmux 会话)。程序员会根据任务选择。你不需要思考这件事。
自定义设计师:教它你的视觉风格
当设计师能够生成你的风格,而不是泛泛的 AI 输出时,它才会真正有用。模式是:给它参考设计,让它研究,然后让它创建一个技能,用同样风格生成新图像。
这是把自我改进闭环用作设置机制。你不是手写技能,而是给 Agent 看好例子,再要求它把模式编码进技能。
打开设计师会话,粘贴你的参考图(CLI 里拖放,或在 Telegram 里附图)。然后发送这个提示词:
仔细研究这些参考插图。记录配色、线条粗细、
细节程度、构图和整体审美。

我希望你创建一个名为 "my-design-style" 的新技能,
用于捕捉这种视觉风格。这个技能应该:

1. 用自然语言记录风格指纹(配色、线条粗细、构图规则、反复出现的母题)
2. 包含一个 Python 脚本:输入一段新插图描述,
   通过 OpenRouter API 调用 Nano Banana 模型
   (google/gemini-2.5-flash-image),按这种风格生成图像
3. 从环境变量读取 OPENROUTER_API_KEY

使用 skill_manage 创建它。说完成之前,
先用一个示例 prompt 测试生成脚本。
设计师会研究参考图,写出 SKILL.md,生成 Python 脚本,保存到 ~/.hermes/profiles/designer/skills/my-design-style/,并验证脚本能跑。
如果你已经运行过 hermes setup,并选择 OpenRouter 作为服务提供方,那么因为使用了 --clone,key 已经在设计师 profile 的 .env 里。如果没有,设置一次:
hermes -p designer config set OPENROUTER_API_KEY 从此以后,只要你让设计师生成新插图,就会触发这个技能。它会根据你的风格指纹写提示词,通过 OpenRouter 调用 Nano Banana,并保存输出。
同样的模式适用于任何需要风格一致性的输出。喂参考内容,让 Agent 构建一个能复现模式的技能。Newsletter 开头、X thread、代码审查评论,任何需要稳定风格的东西都可以。
调度工作:用自然语言写 Cron
研究员的 SOUL.md 说它负责每天发 Telegram 摘要。这意味着有一个任务会按计划自行运行,不需要你记得去问。这就是 Hermes cron 的作用。
Hermes 自带调度器。网关守护进程每 60 秒轮询一次,运行所有到期任务,并在隔离的 Agent 会话中执行,再把输出发送到你指定的消息平台。任务会在重启后继续存在。它们位于 ~/.hermes/cron/jobs.json,输出会进入 ~/.hermes/cron/output/。
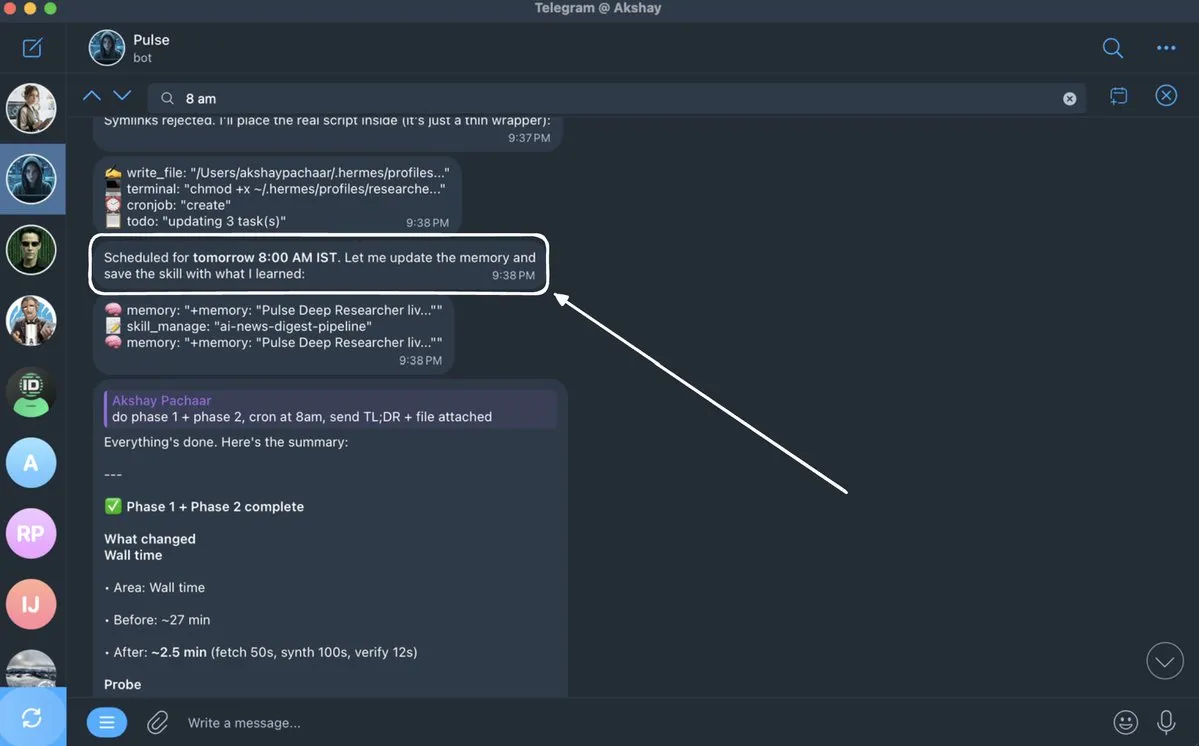
有意思的地方是:你不需要写 cron 表达式。你用英语描述想要什么,Hermes 会把它转换出来。
把研究员的每日摘要接起来。
打开研究员会话,发送这个提示词:
每个工作日上午 8 点(印度时间),准备一份深度摘要,
覆盖过去 24 小时 AI 和机器学习领域的新变化。
按这个顺序覆盖四条信息流:

1. 热门 GitHub 仓库(尤其是新的 AI/ML 工具链)
2. 大型科技公司和实验室公告(Anthropic、OpenAI、Google、Meta、
   xAI、Nous 等)
3. 值得阅读的新研究论文
4. X、Reddit、Hacker News 上的社交脉冲

开头先说和昨天相比发生了什么变化。每个判断都要附 URL。
控制在 800 词以内。发送到 Telegram。

把它设置为周期性 cron 任务。
研究员会用自己的 cronjob 工具创建任务,投递目标默认是当前聊天(这里是 Telegram),然后调度器接管。验证它是否创建成功:
hermes -p researcher cron list你应该会看到这个任务和下一次计划运行时间。明天早上 8 点,你的 Telegram 会收到这份摘要。不需要再做其他事。
其他有用模式
cron 语法很灵活。几个值得知道的变化:
- 一次性延迟。
/cron add 30m "Remind me to check the build"会在 30 分钟后运行一次。 - 周期性间隔。
/cron add "every 2h" "Check server status"会每两小时运行一次。 - 标准 cron 表达式。
/cron add "0 9 * * 1-5" "..."用于精确控制,这里表示工作日上午 9 点。 - 附加技能。
/cron add "every 1h" "Summarize new feed items" --skill blogwatcher会在运行提示词之前先加载一个技能。
你也可以串联任务。一个 cron 的输出可以通过 context_from 标志变成下一个 cron 的输入。适合多阶段自动化,比如让调研步骤喂给写作步骤。
到这里就结束了。
感谢阅读。你希望我接下来讲什么,可以在评论里告诉我。
如果你更适合通过视频学习,我会在几天后把完整的 Hermes Agent 演示教程发布到 YouTube 和 X。
保持关注。
祝好!:)
📎 原文信息
原帖链接:https://x.com/akshay_pachaar/status/2054564519280804028
