7 月 18 日,OpenClaw 的创建者 Peter Steinberger 发帖问:“我们还在聊循环,还是已经转到图谱了?”
几个小时后,Hamel Husain 发文,标题很直白:《循环工程已死,图谱工程登场》。
两人当然都带着几分玩笑。这个领域改名太勤,连调侃“又改了个名字”都快成一种内容类型了。
但玩笑确实问到了关键处:当多个循环需要一起工作时,问题就不再是“怎么把某个循环写好”,而是“怎么让它们彼此协调”。而图谱,一直就是工程师描述协调关系的语言。
这就是图谱工程真正要解决的事。先把梗放一边,看看它到底是什么。
图谱其实没有那么神秘
把图谱拆开看,无非是三样东西:
- 节点:一个具体的工作单元,可以是智能体、一次模型调用、确定性函数、工具,甚至是负责审批的人。
- 边:决定接下来该跑什么。它可以表示顺序、并行,也可以根据上一步的结果分支。
- 状态:在边上流动的共享对象。各节点从中读取信息,也往里面写入结果。
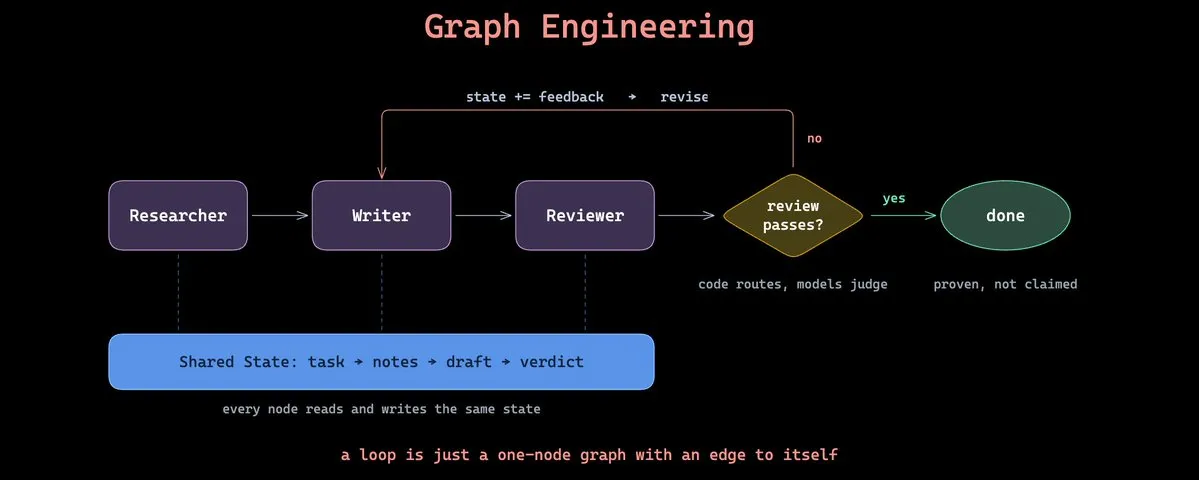
graph.add_node("research", research_agent)
graph.add_node("write", writer_agent)
graph.add_node("review", reviewer_agent)

graph.add_edge("research", "write")
graph.add_edge("write", "review")
graph.add_conditional_edge("review",
lambda state: "done" if state.approved else "write")这是最常见的入门结构:研究者找材料,写作者出初稿,审阅者判断是否通过。通过就结束;没通过,就把草稿送回写作者继续改。
三个节点、四条边,其中一条边回指前面的步骤,于是形成了一个循环。
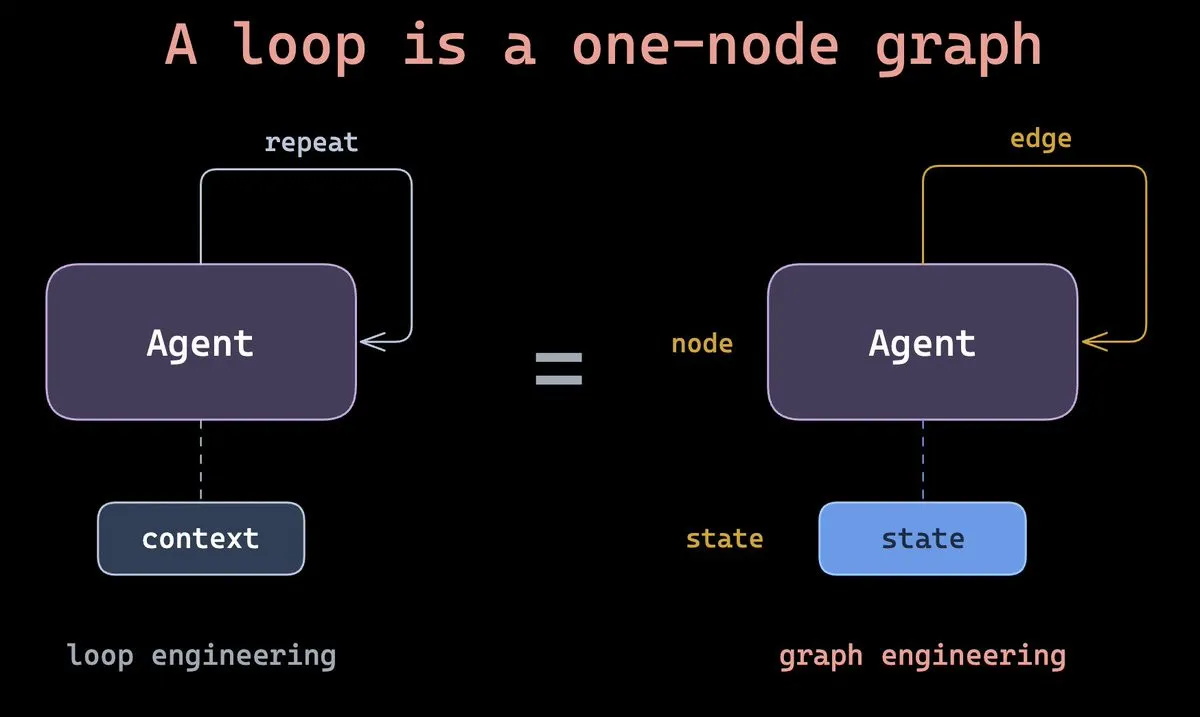
真正值得记住的是:单智能体循环,本质上只是“边指回自身”的单节点图谱。图谱并不是要取代循环,它解决的是如何把多个循环连接起来,并把协作关系管住。
模型之外,工程层越来越多
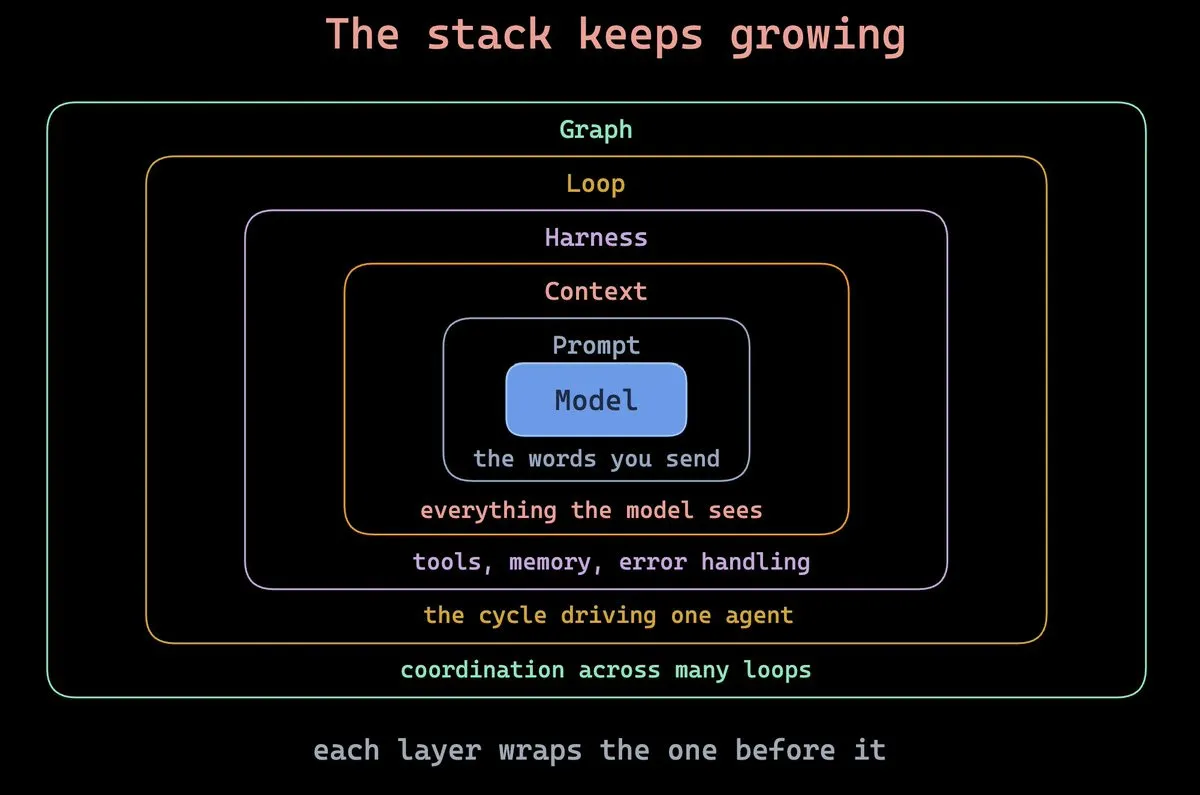
AI 系统的重心一直在从模型本身向外围迁移,每往外一层,大家就给它起了一个新名字:
- 提示词工程:你直接发给模型的那段话。
- 上下文工程:模型能看到的全部信息,不只是提示词。
- Harness工程:模型周围那层负责调用工具、维护状态、处理错误的代码。
- 循环工程:推动一个智能体持续向目标前进的自主循环。
- 图谱工程:协调多个循环的那一层,决定谁先跑、谁并行、谁检查谁。
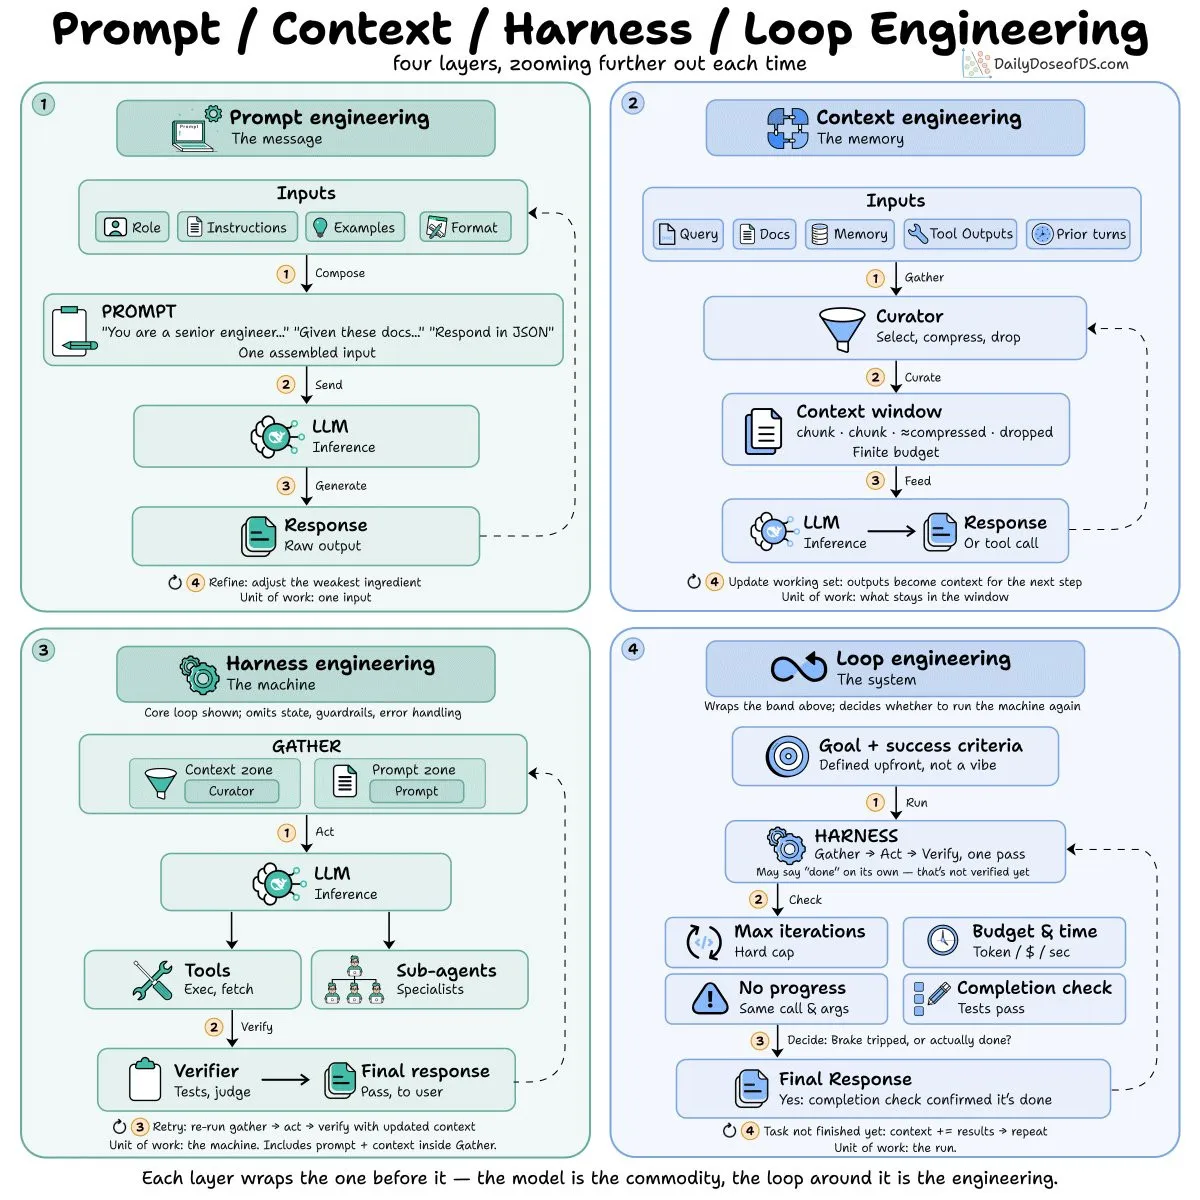
这些层并不是平行存在的。图谱由循环组成;循环需要可靠的运行框架;每次框架调用都绕不开上下文;而所有上下文,最终都包含提示词。底层没做好,图谱只会把问题放大成一种更复杂的失败。
也别把“图谱工程”当成新发明。LangGraph 在 2024 年 1 月就已经给出了同样的基本模型:在共享状态上组织节点和边。Microsoft 的 AutoGen 有 GraphFlow,Google 也把 ADK 2.0 的工作流运行时建立在同一思路上。新的是名字,不是实践。Hamel 那篇文章下有条高赞回复只有一句:“欢迎回来,langchain。”
所以,真正的能力不在于“发明图谱”,而在于知道图谱什么时候值得用,以及怎样不让它慢慢失控。最难的地方主要有四个。
难点一:别把每一步都拆成节点
最典型的过度设计,是把“概括这份 PDF”硬拆成五个节点:抓取、分块、概括、审阅、格式化。
一个节点只有在它代表真实差异时才值得存在,例如要换一个模型、换一套工具,或需要一个职责独立的角色,像只读审阅者。那些本来就能塞进现有循环里的小步骤,不该为了“看起来像图谱”而单独变成节点。
一个很实用的判断标准是:如果图谱画不到一张餐巾纸上,它大概率已经太复杂了;如果把两个节点合并后什么都没损失,它们一开始就不该分开。
难点二:让共享状态保持可控
单循环常见的问题叫上下文衰减。到了图谱里,类似的问题会转移到共享状态上。
每个节点都会修改状态对象。节点二一次随意的写入,到了节点五就可能变成一条被认真对待的“事实”。等最终输出出错时,脏数据往往已经穿过半个系统,很难再追。
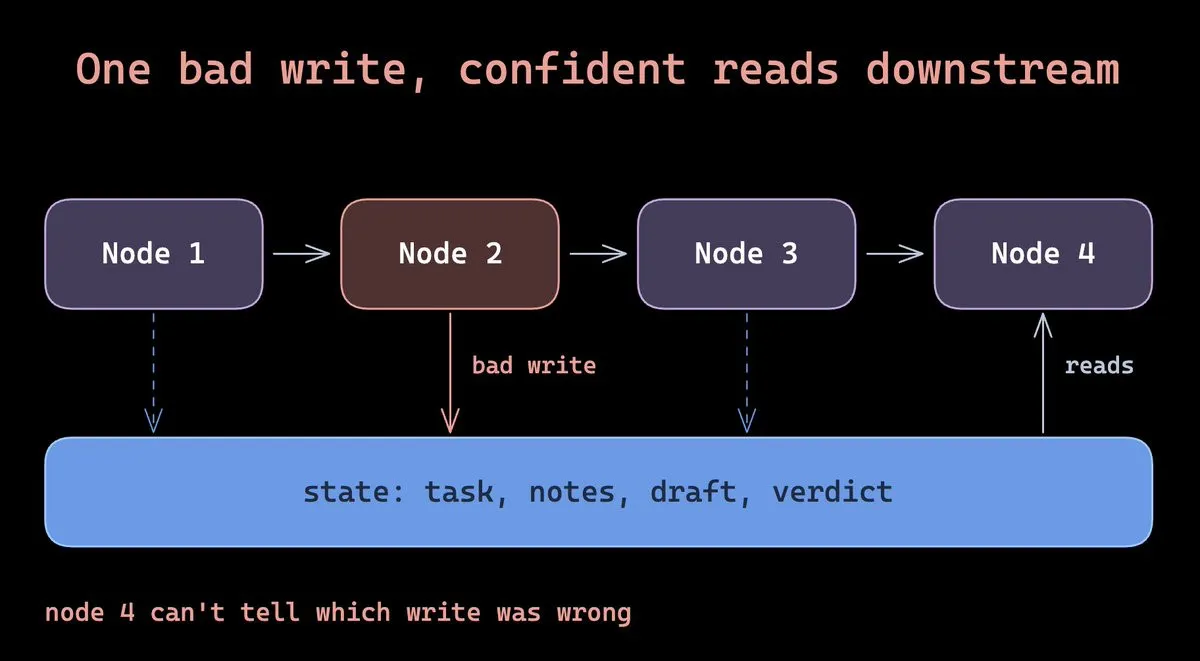
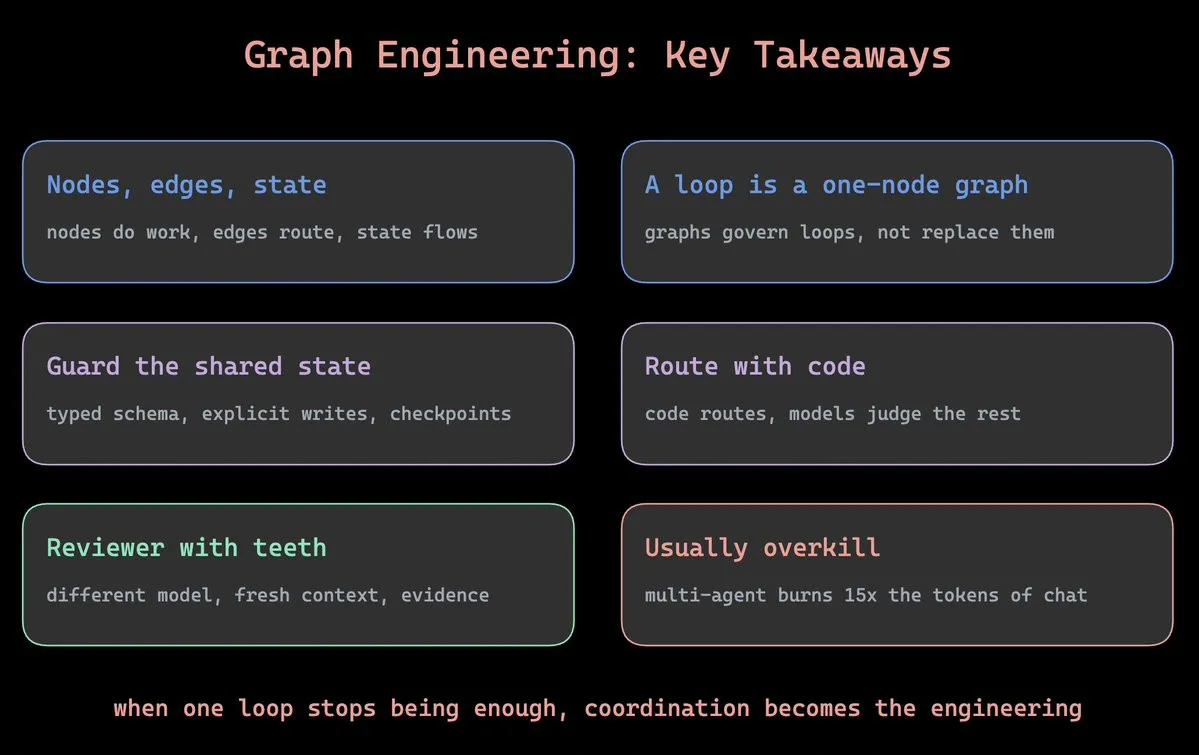
处理方法并不花哨:给状态定义带类型的模式;明确每个节点能写哪些字段;在节点之间设置检查点。这样就能回放一次运行,准确找出问题从哪个节点开始出现。
不过,回放也有代价。检查点之后的节点会重新执行,因此所有带外部副作用的节点,例如发邮件、创建记录,都必须能安全地重复运行。
难点三:把路由交给合适的人
每条边背后都是一个决定:下一步走哪条路,以及谁来做这个决定。
让模型来选路径,灵活是灵活,但不稳定也随之而来。同一份状态在两次运行中可能走出不同路线,排查问题会很痛苦。
Google 为 ADK 2.0 提出的原则很清楚:可预测的路由交给确定性代码;只有真正需要判断力的环节才交给模型。
因此,只要条件能被明确检查,就用代码决定路由;只有必须理解语义、解释意图时,才值得花一次模型调用。
难点四:别让智能体集体附和
循环工程里有一条很硬的规则:不要让智能体给自己批改作业。
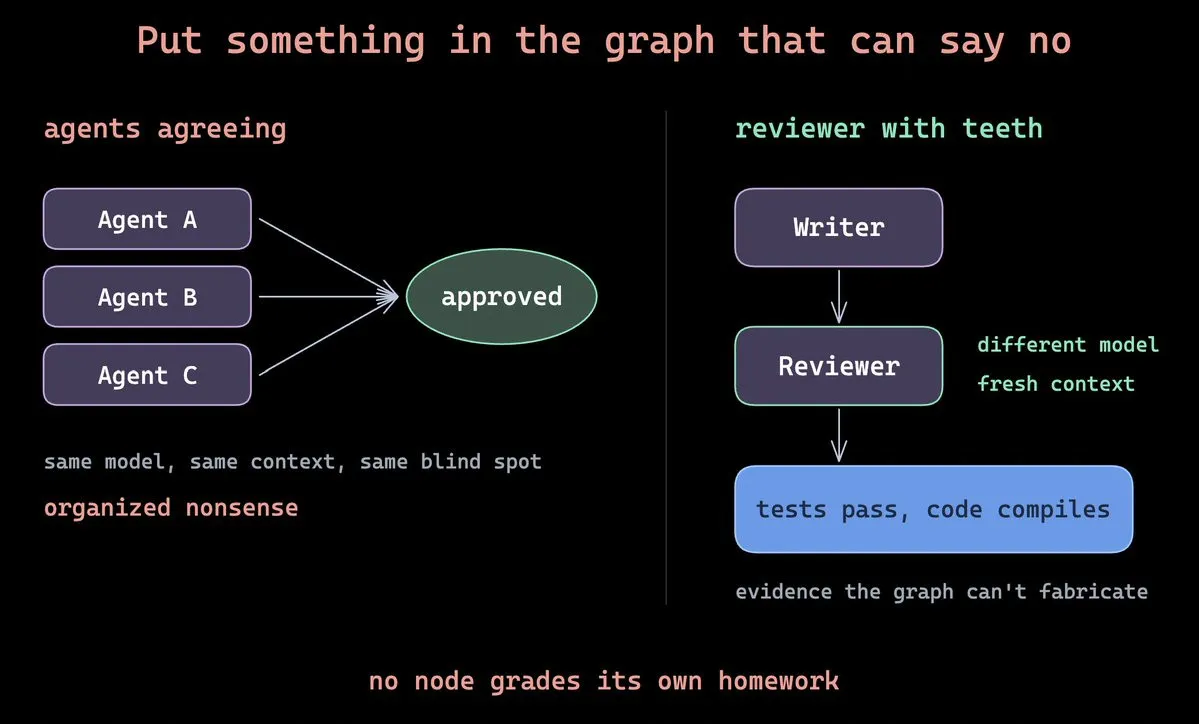
放到图谱里,这条规则只会更重要。二十个基于同一底座模型、读着同一份有缺陷上下文的智能体,并不会因此获得二十份独立判断。它们很容易彼此认同,而模型本身也可测量地偏爱自己的输出。
结果看起来像工业化的“有组织胡言乱语”:结构很完整,答案却错得很自信。
真正有效的审阅节点要有一点“牙齿”:换一个模型来做;只给它完成判断所需的新鲜上下文,不把整段对话全塞进去;再让它依赖图谱无法伪造的证据,例如确实跑过的测试、真正编译通过的代码。
Cognition 运行编程智能体 Devin 一年后,也落在同一个做法上:可以让多个智能体读代码、发表意见,但任何时刻只能有一个智能体真正修改内容。
这背后的分工很合理。阅读可以并行,因为错误观点在没有人采取行动前几乎没有成本;写入才会造成实际损害,所以应把写入集中在一个可见、可控的地方。
很多时候,图谱属于过度设计
坦白说,大多数时候确实如此。
Anthropic 给出的数字很直观:一个智能体消耗的 token 约为一次聊天交互的 4 倍;多智能体系统约为 15 倍。每多一个节点,成本都会继续放大。
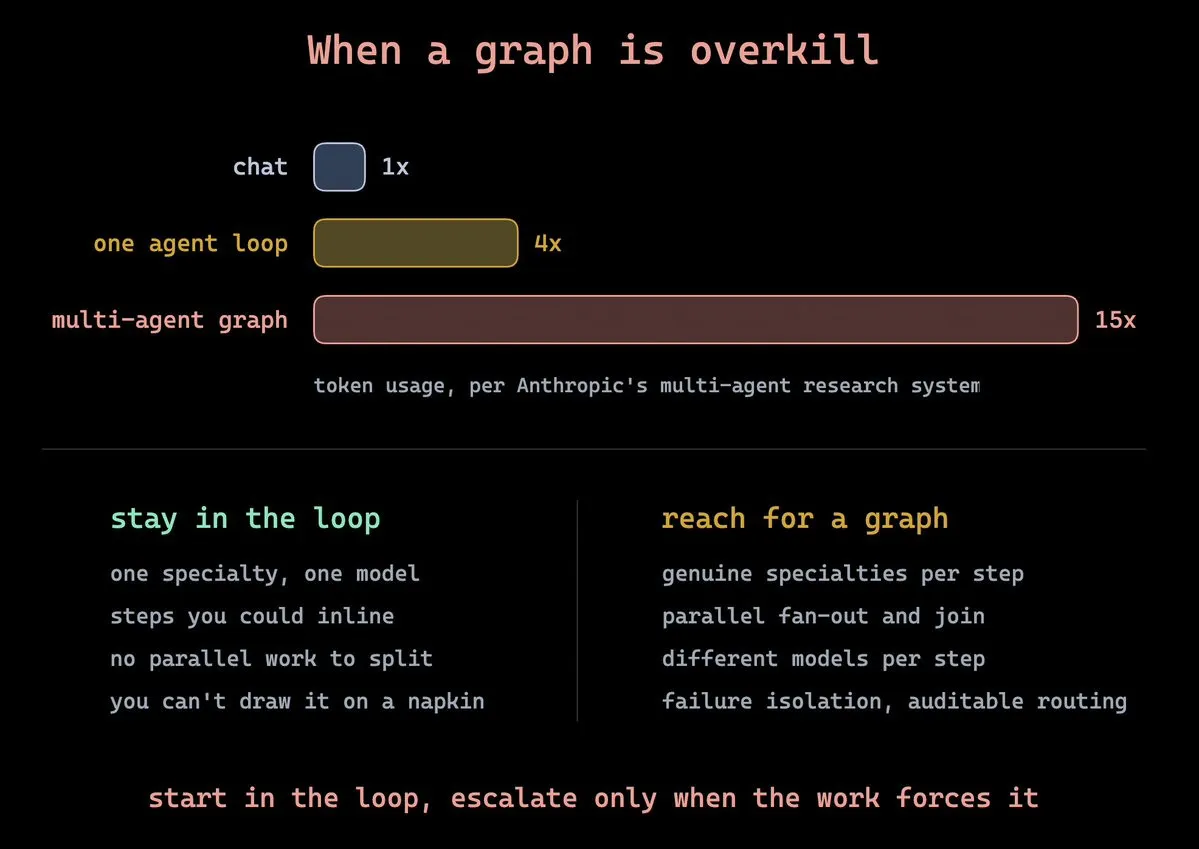
图谱真正有价值的前提,是任务本身能自然并行。Anthropic 的多智能体研究系统在内部研究评测中比单个 Opus 智能体高出 90.2%,因为研究天然可以分成多路独立检索,再把结果汇合起来。但他们在《构建有效智能体》中反复强调的原则没有变:先找到最简单的解法,只有任务确实需要时才增加复杂性。
LangGraph 自己的建议也很直白:如果你的智能体只是一个带工具的简单循环,LangGraph 反而是过度设计。
判断并不复杂。工作真的能拆成不同专长、需要并行扇出与汇合、不同步骤需要不同模型,或者你需要故障隔离和可审计路由时,图谱才值得出场。否则,继续把循环做好就行。
从一个强循环开始
第一天没必要画出一张智能体组织架构图。更好的做法是逐步搭起来:
- 先把单个循环打磨好:有停止机制、有真正的完成检查,也有批评者。脆弱循环拼成的图谱,只会变成分布式失败。
- 写代码前先把图谱画在纸上,并让每个节点说明自己为什么必须存在。
- 一开始就定义状态模式和写入权限。状态漂移,是图谱最常见的失控来源。
- 让审阅节点使用不同模型和新鲜上下文,并把判断锚定在外部证据上。
- 给每个节点设预算上限。图谱里是多个循环同时消耗 token,一个薄弱验证器也会同时把钱烧掉。
图谱工程,最终是在做协调
图谱工程不是来替代循环工程的新学科。它只是给每个智能体构建者都会遇到的那一刻起了个名字:当一个循环已经不够用,协调本身就成了工程问题。
这个词也许活不过今年,但这个设计问题不会消失。