
大家好,我是PaperAgent,不是Agent!
8.27日, Google 在同一天发了两篇 Agent Skill 论文:一篇 WikiSkill ,讲 Skill技能怎么越进化越聪明 ; 我用字节Agent做了个科研Skill,3小时干完一天的活
一篇 SKILL.state ,发表在EMNLP,讲 Skill技能怎么跑得又稳又省 。
一个管 学习 ,一个管 执行 ,合起来正好拼出谷歌对 Agent Skill 的完整押注: 技能不仅要能进化,还要能扛住长程执行 。 办公Agent炸锅!豆包工作远超预期
WikiSkill:给技能进化装上一个维基百科
2.1 核心思想:经验 → 知识 → 技能
WikiSkill 的灵感来自 Karpathy 提出的 LLM Wiki 概念:把经验编译成持久的、可复利的知识。以往的技能进化方法里,指导技能开发的洞察散落在各轮优化历史里,下一轮进化基本用不上。WikiSkill 在 原始经验 和 可执行技能 之间,插进了一个 结构化知识层(Wiki) 。
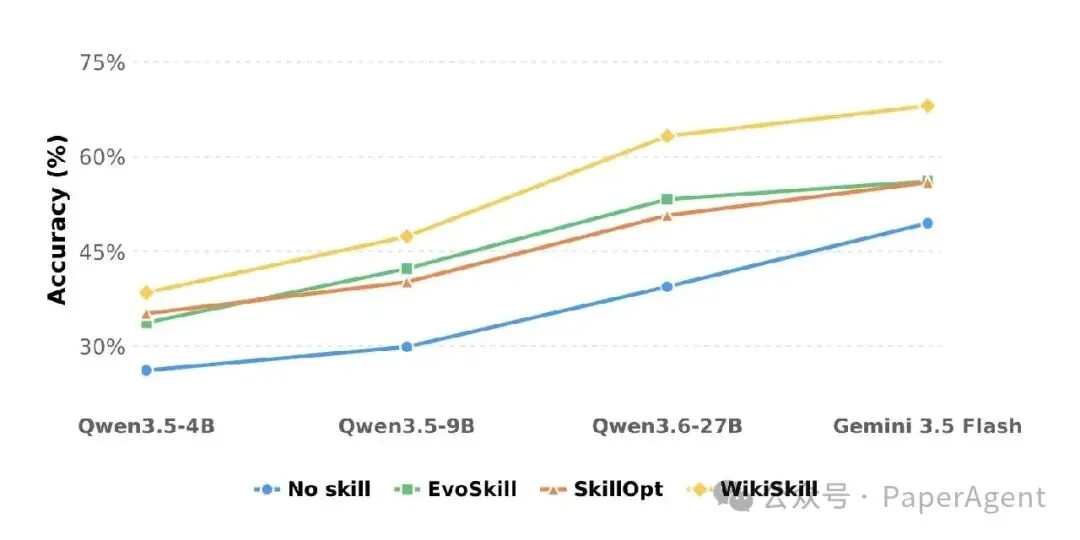
Figure 1 | WikiSkill 主结果
先直接看疗效:在五个基准的平均准确率上,WikiSkill 不仅稳定碾压无技能基线,还超过了 EvoSkill、SkillOpt 等现有进化方法。更有意思的是—— 模型越强,WikiSkill 的优势越明显 。
2.2 三层架构 + 四步进化循环
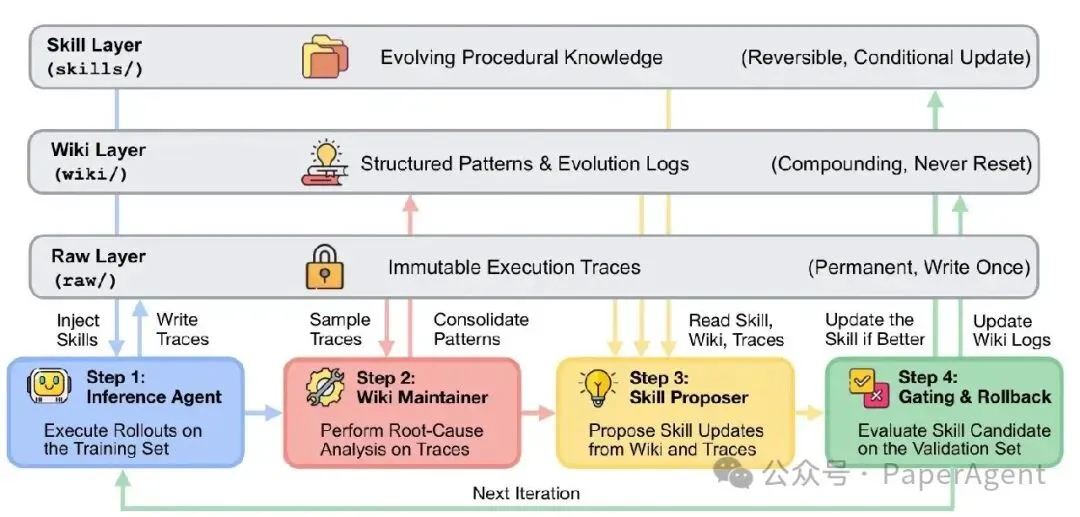
Figure 2 | WikiSkill 框架总览
WikiSkill 把 Agent 工作区组织成三层:
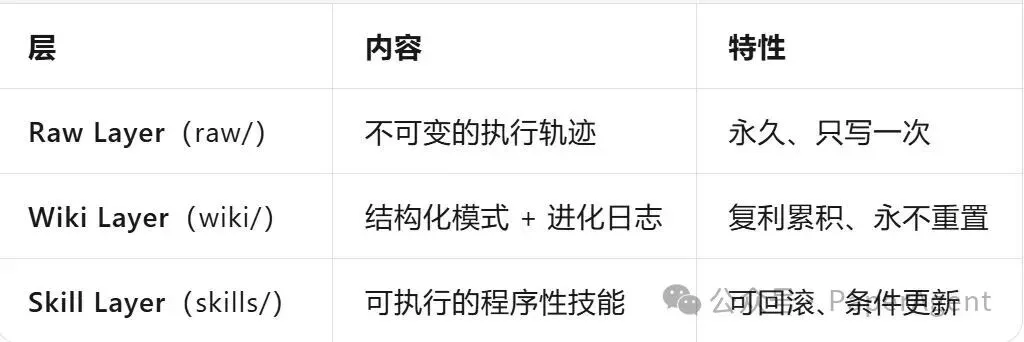
每一轮迭代跑四个角色:
- Inference Agent :带着当前技能在训练集上跑 rollout(注意:它 不能看 Wiki );
- Wiki Maintainer :对轨迹做根因分析,把失败模式和成功策略固化成 wiki 里的 pattern 页面;
- Skill Proposer :以 ReAct 方式读 wiki 索引、技能影响追踪器,按需翻阅具体轨迹,提出原子化的技能更新;
- Gating & Rollback :候选技能在验证集上打分,好了才收,差了就回滚—— 但 Wiki 永远不回滚 ,失败的提案记录也会留下来,防止下次重蹈覆辙。
这个 技能可回滚、知识不回滚 的不对称设计,是全文最精妙的一笔:技能是易错的假设,知识是沉淀的资产。
2.3 主实验:全面、稳定地赢
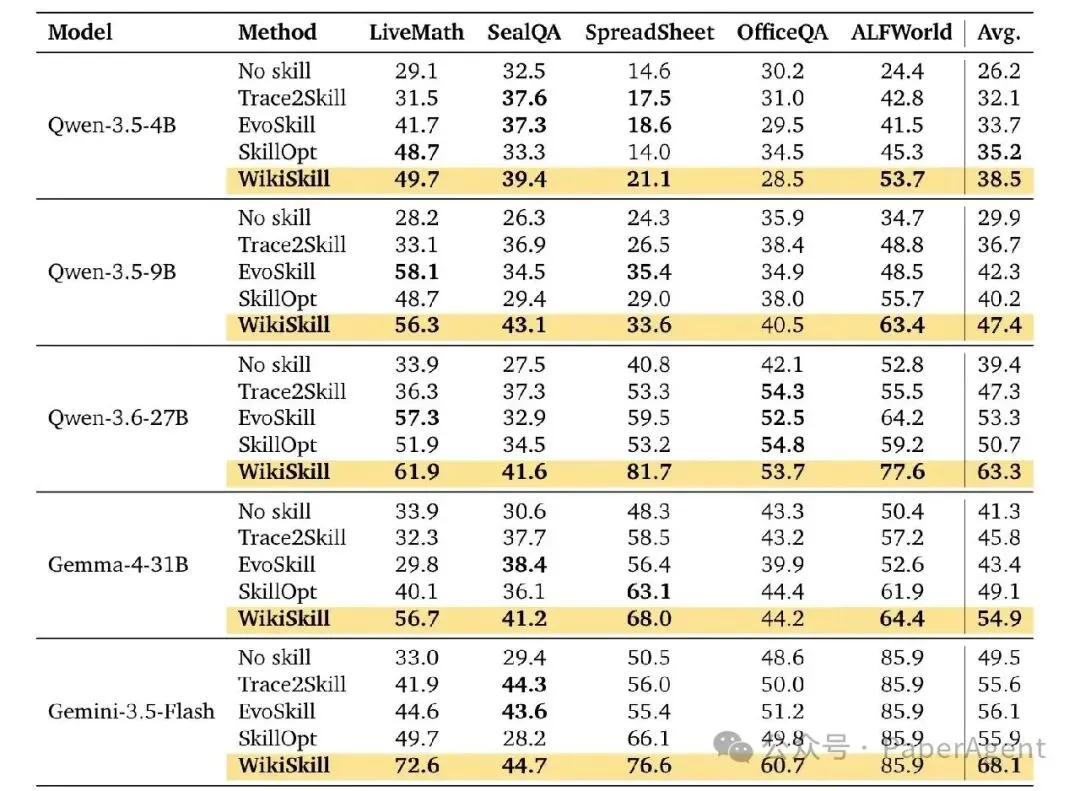
Table 1 | 跨模型跨任务的方法对比
Table 1 是硬菜:5 个模型(Qwen-3.5-4B/9B、Qwen-3.6-27B、Gemma-4-31B、Gemini-3.5-Flash)× 5 个基准(数学推理 LiveMath、搜索 SealQA、表格操作 SpreadSheet、长文档问答 OfficeQA、具身交互 ALFWorld)。几个亮点:
- 相比最强对手 ,WikiSkill 平均分分别高出 3.3 / 5.1 / 10.0 / 5.8 / 12.0 分;
- Gemini-3.5-Flash 在 LiveMath 上从 33.0% 飙到 \\72.6%\\,SpreadSheet 从 50.5% 到 \\76.6%\\;
- 对手们则很不稳定:EvoSkill 能把 Qwen-9B 的 LiveMath 从 28.2% 拉到 58.1%,却会把 Gemma-4-31B 从 33.9% 拉到 29.8%(负优化)。
2.4 最反直觉的发现:技能进化与模型 scaling 互补
论文里两个结论值得加粗:
(1)模型越大,从技能进化中获益越多。 Qwen 家族内,WikiSkill 带来的平均提升分别是 +12.3(4B)、+17.5(9B)、+23.9(27B)个百分点。SpreadSheet 上更夸张:+6.5 / +9.3 / +40.9 。
(2)但技能又能让小模型”越级打怪”。 Qwen-3.5-9B + WikiSkill 拿到 47.4% 平均分,反超了无技能的 Qwen-3.6-27B(39.4%)——三倍参数差距,被一份进化出的技能抹平了。
2.5 技能还能跨模型转移,甚至比自己进化的还好用
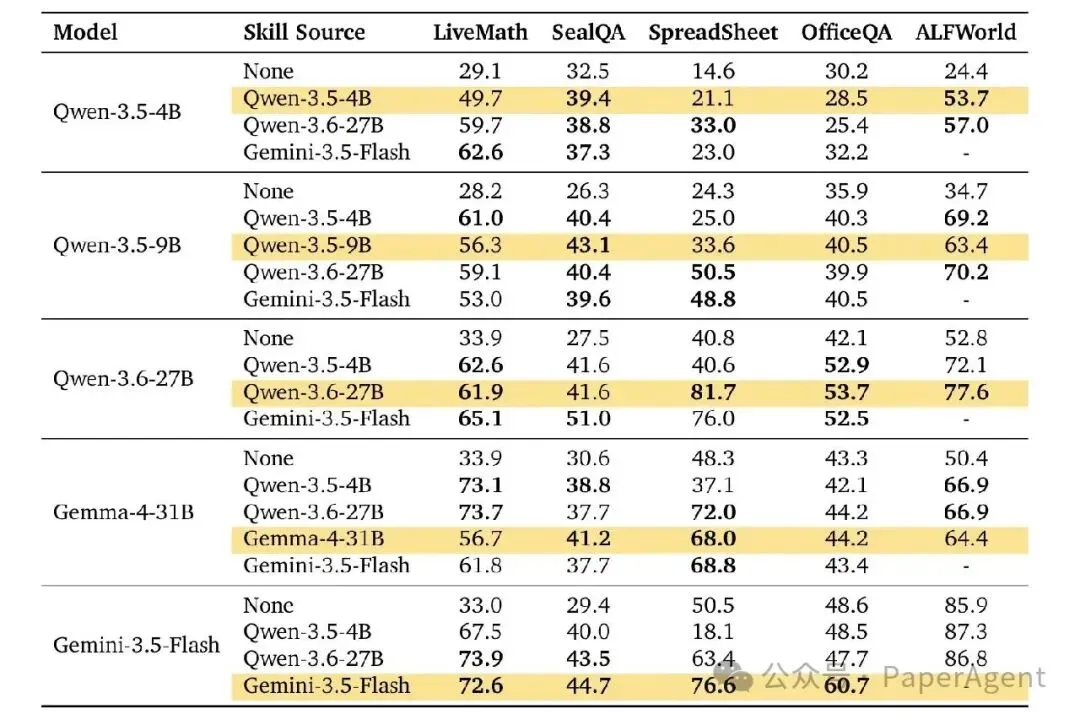
Table 2 | 跨模型技能转移
Table 2 揭示了一个很有意思的现象: 发现技能的能力和执行技能的能力是两种能力 。
- Qwen-3.6-27B 进化出的技能,给 Qwen-3.5-9B 用在 ALFWorld 上拿到 70.2%,比 9B 自己进化的技能(63.4%)还高;
- 甚至小模型的技能也能帮大模型:Qwen-3.5-4B 的技能把 Gemma-4-31B 的 LiveMath 推到 73.1%;
- 但转移也会翻车:Qwen-3.5-4B 的 SpreadSheet 技能把 Gemini-3.5-Flash 从 50.5% 坑到 18.1%——因为小模型的技能里写满了”单行 Python 命令”之类的低级补丁,束缚了强模型写端到端脚本的手脚。
结论: 通用程序性知识可转移,模型特异的 workaround 会负迁移。
2.7 案例解剖:一次 Wiki 指导的技能进化
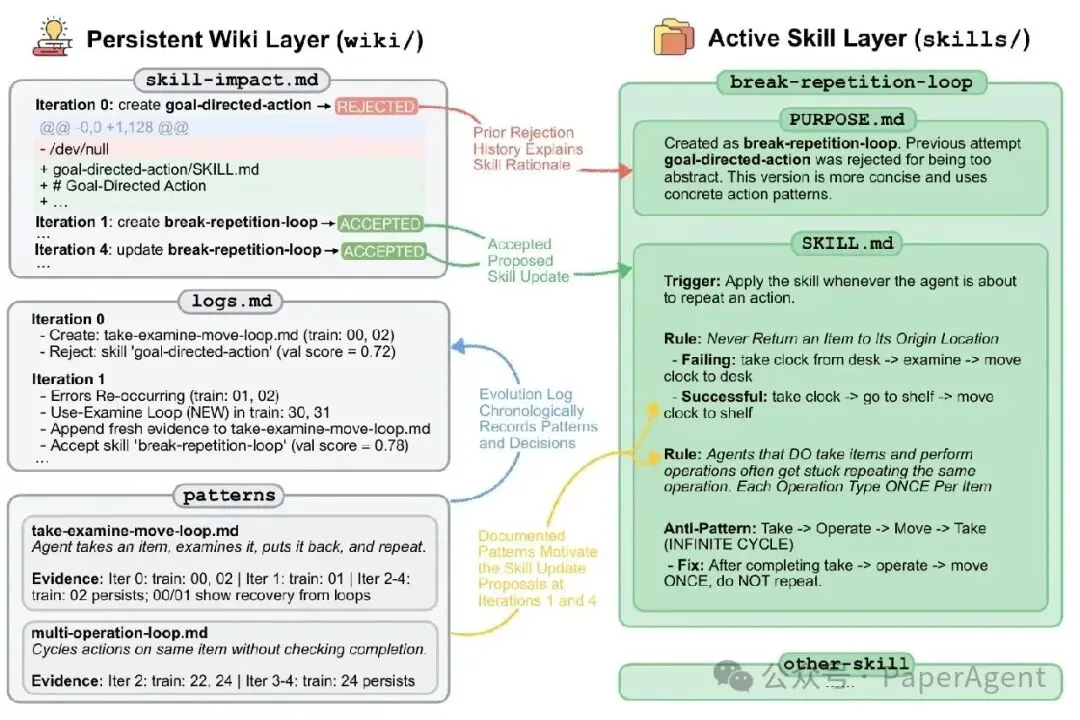
Figure 3 | ALFWorld 案例研究
Figure 3 追踪了 Qwen-3.6-27B 在 ALFWorld 上的真实进化过程:
- 第 0 轮 :Wiki 记录了”拿东西→检查→移动”的死循环模式;Proposer 提出 goal-directed-action 技能,太抽象,被验证集 拒绝 ——但拒绝记录留在了 skill-impact.md 里;
- 第 1 轮 :Proposer 参考失败历史,提出更具体的 break-repetition-loop(规则:“永远不要把物品放回原处”), 被接受 ;
- 第 4 轮 :随着新的循环变体出现,Wiki 持续累积证据,技能被进一步精炼出”每种操作对每件物品只做一次”的规则。
这就是”审计轨迹驱动进化”的完整闭环。
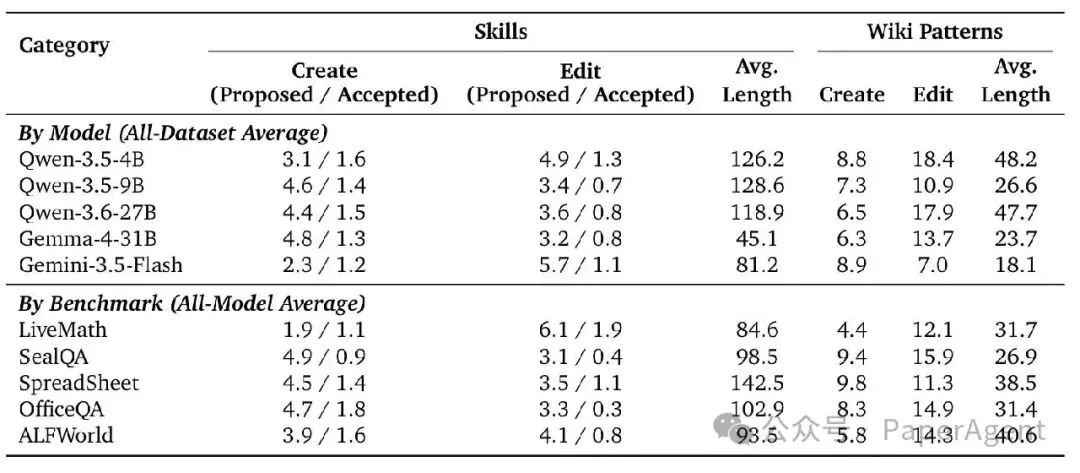
Table 4 | 技能与 Wiki 模式统计
Table 4 还给了组有趣的数据:Qwen 系模型写出的技能更长(119\~129 行),Gemma 和 Gemini 更精简(45 / 81 行);SpreadSheet 产出的技能最长(142.5 行)、Wiki 模式最多(9.8 个),LiveMath 最短最少。技能形态,确实是模型和任务共同塑造的。
三、SKILL.state:把技能执行从聊天记录改成状态机
如果说 WikiSkill 关心技能的 生产 ,SKILL.state 关心的就是技能的 消费 ——执行。 填补空白!首篇多模态Agentic框架前沿综述
3.1 问题:对话式执行迟早被自己的历史拖死
现在几乎所有 Agent 运行时都是同一个模式:每一步都把原始技能说明 + 不断膨胀的历史记录(推理、动作、观察、工具输出)塞给模型。后果是:
- Prompt 随执行步数线性增长,累计 token 开销是 \\O(T²)\\;
- 过期的观察和推理赖在上下文里不走,模型要不断区分”现在的事实”和”历史的垃圾”——长程任务下这就是”上下文中毒”。
3.2 方案:每一步只看三样东西
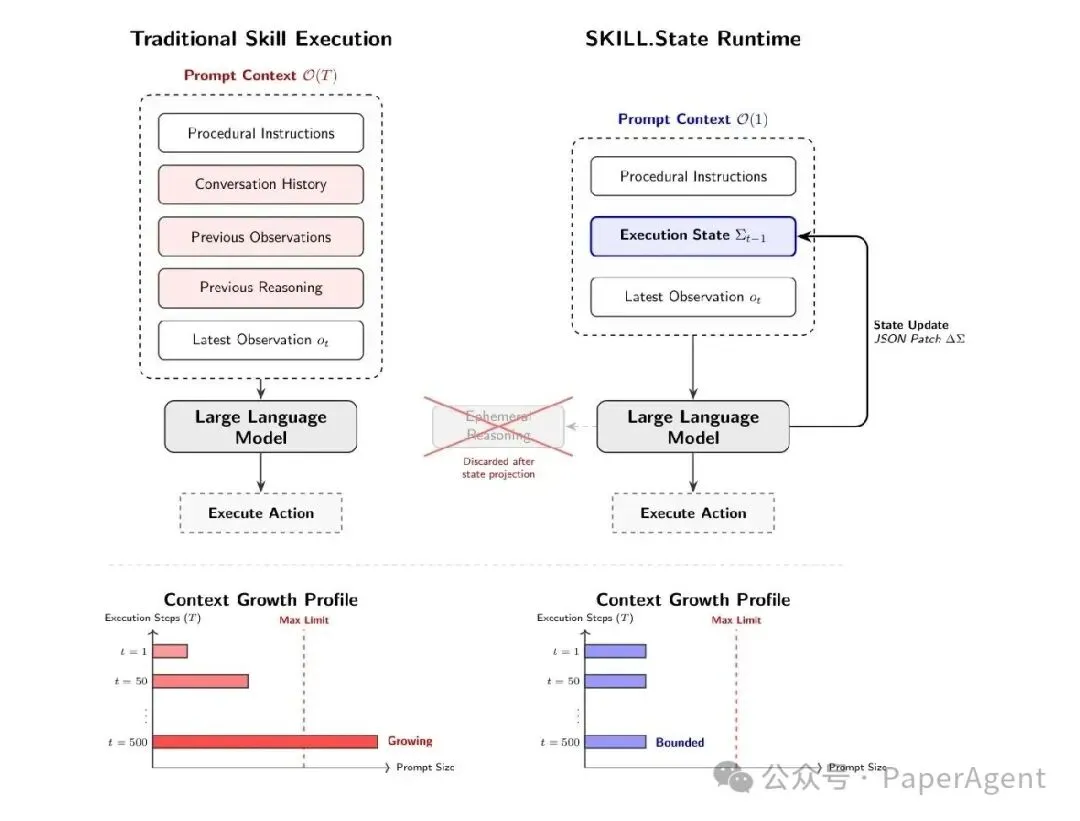
Figure 1 | SKILL.state 架构总览
SKILL.state 把执行重构为显式状态转移(Figure 1)。每一步模型只收到:
- P :不可变的技能说明书;
- Σt :结构化的当前执行状态(JSON);
- ot :最新一条环境观察。
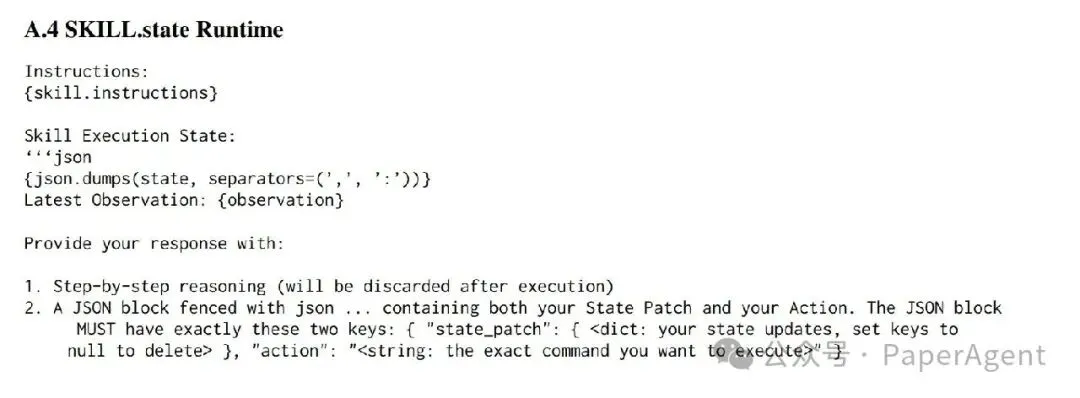
模型输出推理轨迹 Rt、状态补丁 ΔΣt 和动作 at;运行时确定性地校验补丁、合并进状态(Σt+1 = Σt ⊕ ΔΣt),然后—— 把推理轨迹永久丢弃 。步内的多步 CoT 推理完全保留,但只要状态转移一验证,推理就进不了下一个 prompt。
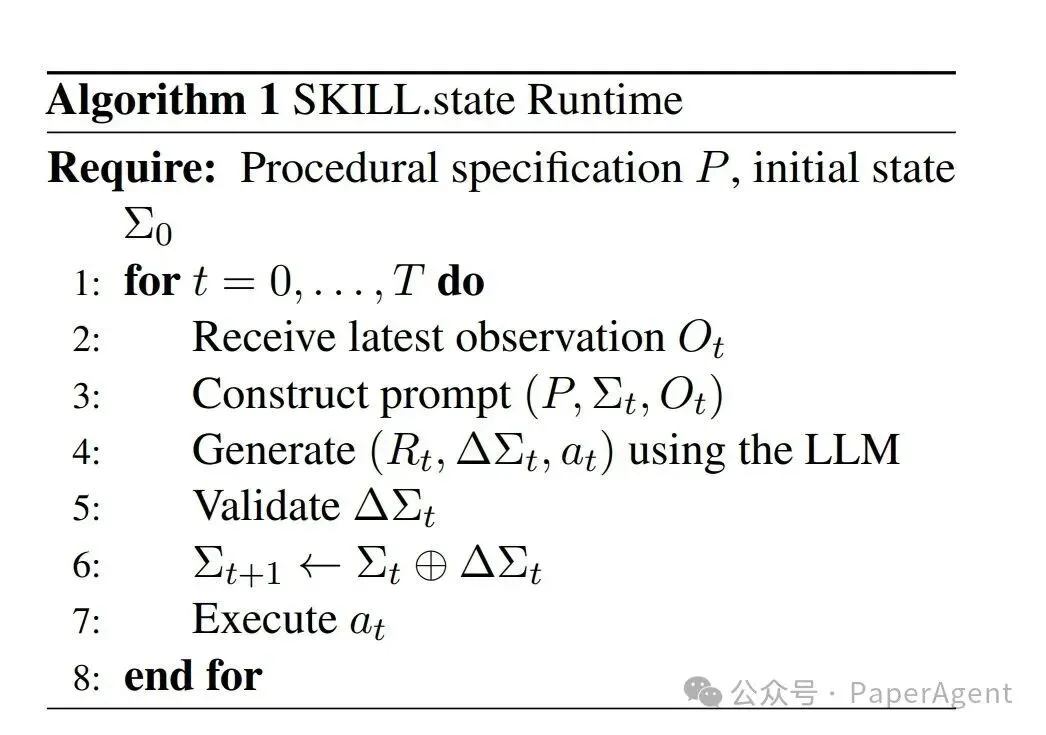
结果:Prompt 大小变成 \\O(1)\\,累计 token 变成 \\O(T)\\。状态 schema 按领域写一次即可,比如 InterCode CTF 全部 100 道题共用同一个 5 字段 schema。
3.3 实验一:长程 scaling,16 倍省 token 还更准
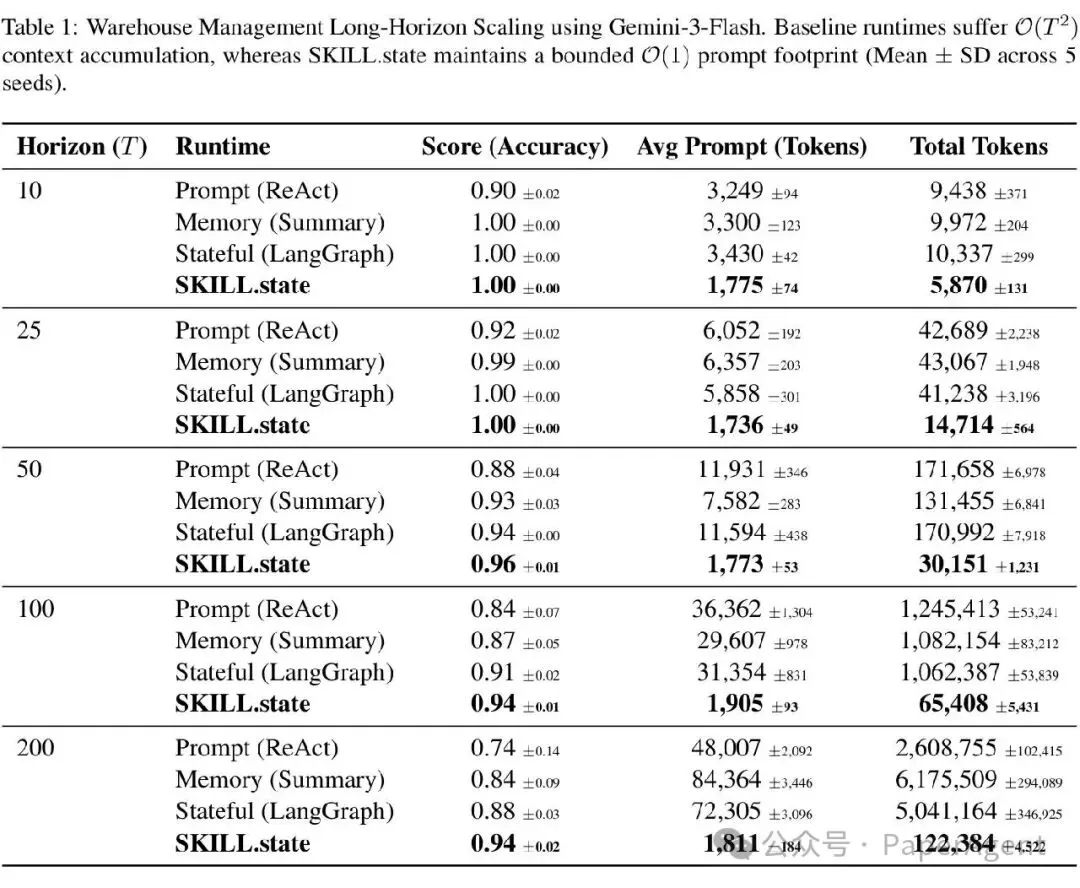
Table 1 | 仓库管理长程 scaling
在自建的 SkillExecBench 仓库管理环境(500 个货架,T 从 10 拉到 200)上:
- T=100 时,Stateful(LangGraph 式)基线烧掉 1,062,387 token,SKILL.state 只用 65,408 —— 16.2 倍压缩 ,准确率还更高(0.94 vs 0.91);
- T=200 时,Memory 基线膨胀到 6.1M token,SKILL.state 只要 122k,准确率 0.94 对 0.84;
- Prompt 大小始终钉在 1,736\~1,905 token,一条平线。
3.4 实验二、三:抗噪 & 状态恢复
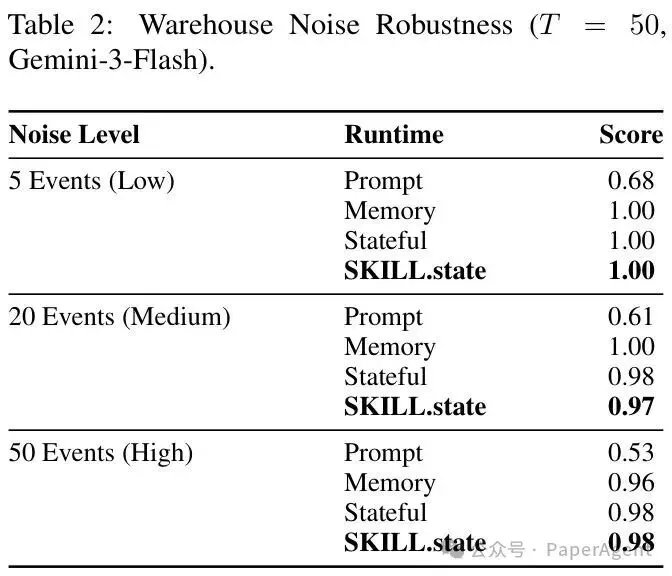
Table 2 | 噪声鲁棒性
往观察里灌系统遥测垃圾(每步最多 50 条干扰事件):标准 ReAct 从 0.68 崩到 0.53 ,SKILL.state 全程 ≥0.97 ——干扰信息在生成状态补丁时就被过滤了,根本进不了后续 prompt。
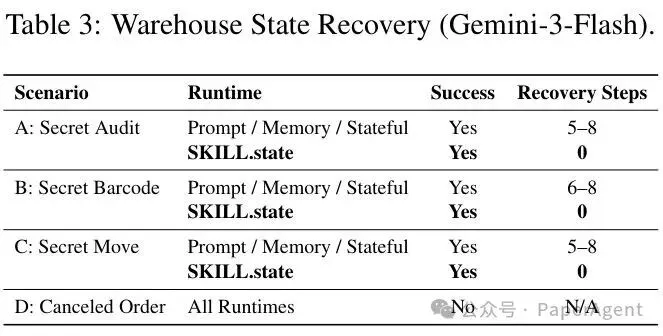
Table 3 | 状态恢复
更狠的是”静默环境漂移”测试:外部角色偷偷改世界状态。历史型基线会连着幻觉 5\~8 步(旧事实压过新观察),SKILL.state 零恢复步数 ——它只信当前状态,纠正警报一到,状态立刻更新。
3.5 实验四:真实基准全面领先
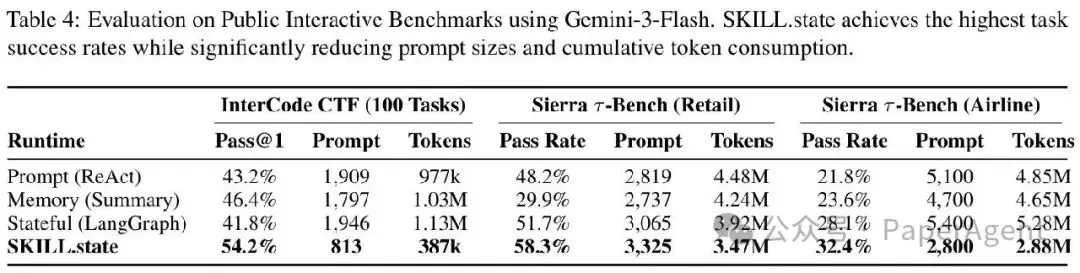
Table 4 | 公开交互基准
- InterCode CTF (100 道 Linux 渗透题):pass@1 达 \\54.2%\\,比最强基线高 7.8 分,总 token 比 ReAct 省 60.4%;每步 prompt 只有 813 token;
- τ-Bench Retail :58.3% 通过率,成本最低;
- τ-Bench Airline (基线 prompt 峰值超 11,000 token/步):SKILL.state 平在 \~2,800 token/步,通过率 32.4%,省 40%+ token。
3.6 实验五:不是”短就好”,是”结构化才好”
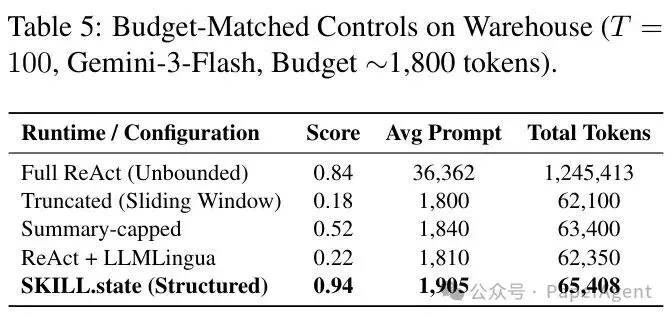
Table 5 | 预算对齐控制实验
有人可能会说:你赢是不是只因为 prompt 短?作者把基线全部压到同样的 \~1,800 token 预算下对比——滑窗截断崩到 0.18(早期库存分配被踢出窗口),LLMLingua 压缩崩到 0.22(统计熵过滤把”看着冗余其实关键”的货架 ID 删了),而 SKILL.state 是 0.94 。结论:赢的是 结构化状态 ,不是压缩。
https://arxiv.org/pdf/2608.27454
WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution
SKILL.state: Scalable Long-Horizon Agent Skills
https://arxiv.org/pdf/2608.26263动手设计AI Agents:(编排、记忆、插件、workflow、协作)
Loop工程已死,Graph工程永生
一篇Loop+Harness的自进化Agent最新综述
2026,做Agentic AI,绕不开这两篇开年综述
已经读到这了,不妨点个👍、❤️、↗️三连,加个星标⭐,不迷路哦\~
