
本文尽可能讲得通俗易懂,让任何小白玩家都可以轻松驾驭,实现模型本地部署并搭建一套自己的工作流
今年,国产开源大模型非常热闹。DeepSeek、Qwen、Kimi、GLM、MiniMax……新模型接连出现、不断开放权重,也开始和美国的闭源模型打得有来有回。
但模型越多,我反而越来越关心一个更具体的问题:这些模型能不能不只停留在网页和 API 里,而是真正装进自己的机器,连接本地文件、工具和工作流?
API 的 Token 单价虽然整体在下降,但遇到高频调用和长文本,成本依然不低。再加上隐私、网络和数据控制权等问题,本地部署正在成为越来越多开发者和企业的选择。
所以这一次,我想选一个体量足够有挑战、又具有单机部署代表性的模型,完整跑一遍本地部署流程。
最后选定的主角,是蚂蚁百灵开源的 Ling-3.0-flash——一个总参数量达到 124B 的 MoE 混合专家模型。我手头正好有一台 NVIDIA DGX Spark,刚好可以把它跑起来。
废话不多说,正片开始。
01 科普扫盲
在开始之前,先介绍下模型相关术语,扫盲开始✌🏻
模型精度
同一个模型经常会提供不同精度或量化版本,它们直接影响模型体积和运行门槛。
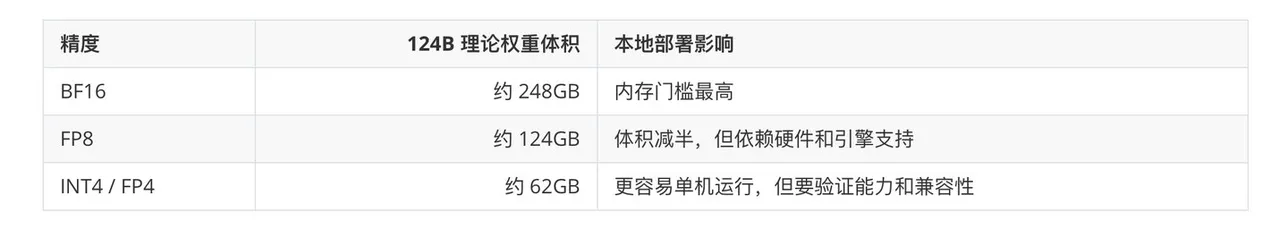
这次使用的是 Ling 官方 INT4 版本,实测约 71.75GB。
Dense 还是 MoE
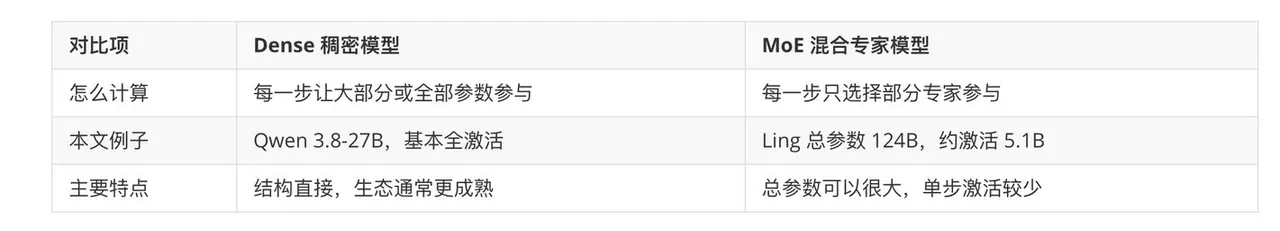
需要注意,5.1B 只是每次推理激活的参数量,完整的 124B 权重仍然要加载进内存
推理引擎
推理引擎负责加载权重、管理上下文和并发,并对外提供接口。它是运行模型的工具,不是模型本身。
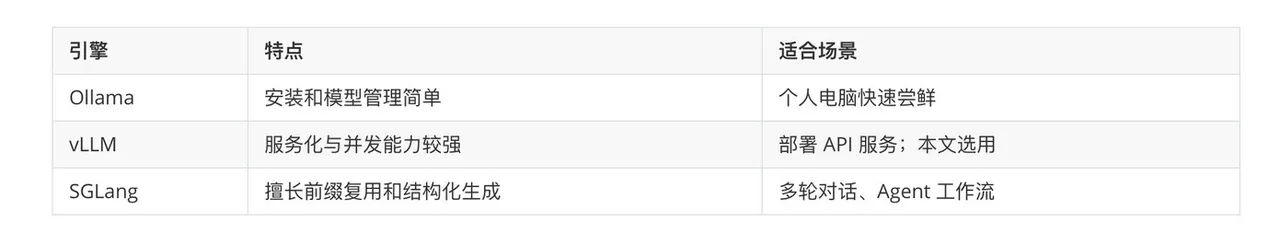
这次选择 vLLM,是因为当前官方适配方案能够支持 Ling-3.0-flash 的 INT4 权重与 MTP 投机解码。
02 模型安装部署
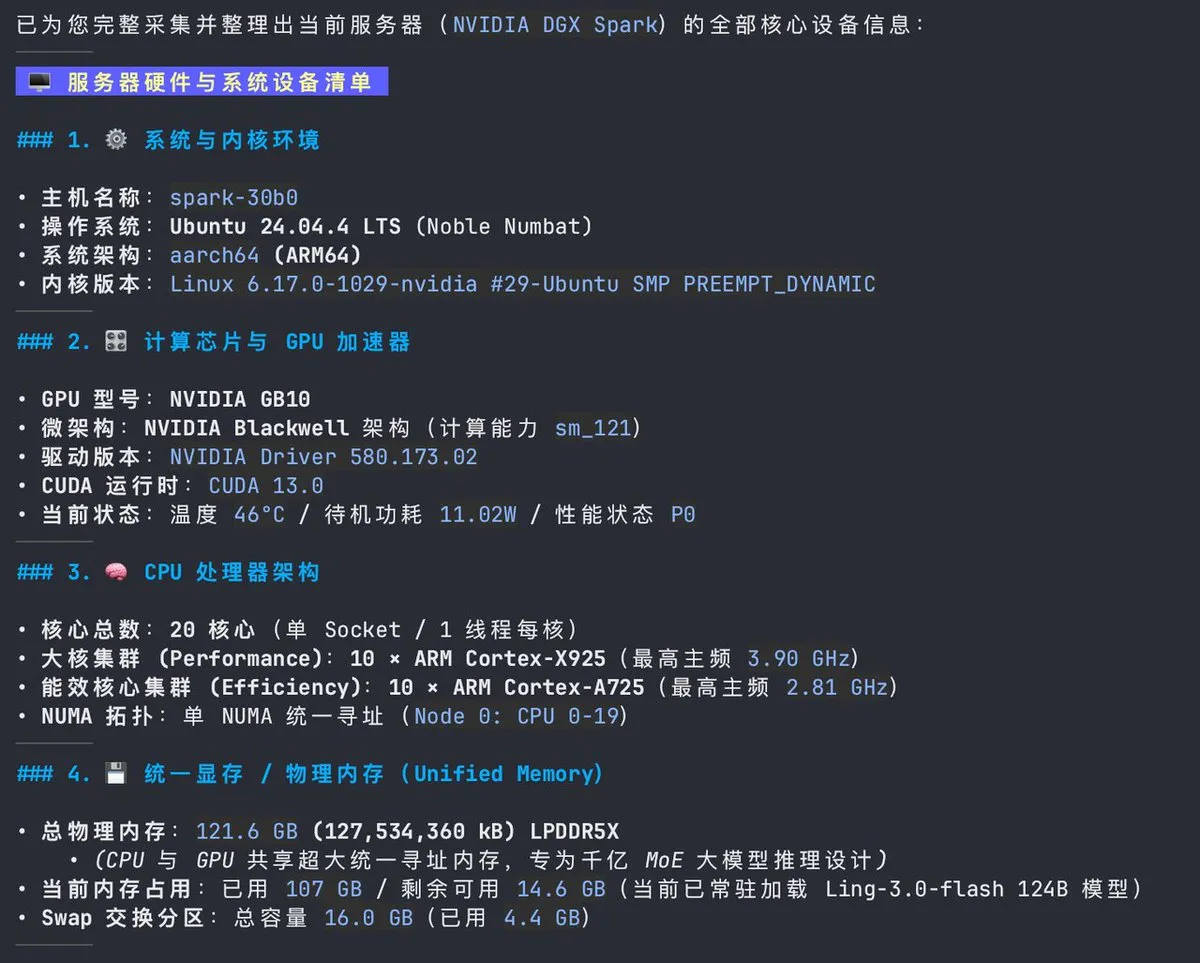
先介绍下安装环境:我使用的是 NVIDIA DGX Spark,配备 GB10 芯片和 121.6GB 统一内存,系统为 ARM64 架构的 Ubuntu 24.04。本次部署的是 Ling-3.0-flash-INT4,后面的吞吐测试会使用本机的 Qwen 3.8-27B 作为参照。
官方提供了基础版和 FP8、FP4、INT4 等不同精度版本,大家可以根据自己的硬件选择。
另外还有 8B 的 Ling-3.0-tiny 及 FP8、INT4 版本,普通 Mac 或单张 4090 可以优先从 Tiny 的低精度版本开始尝试。
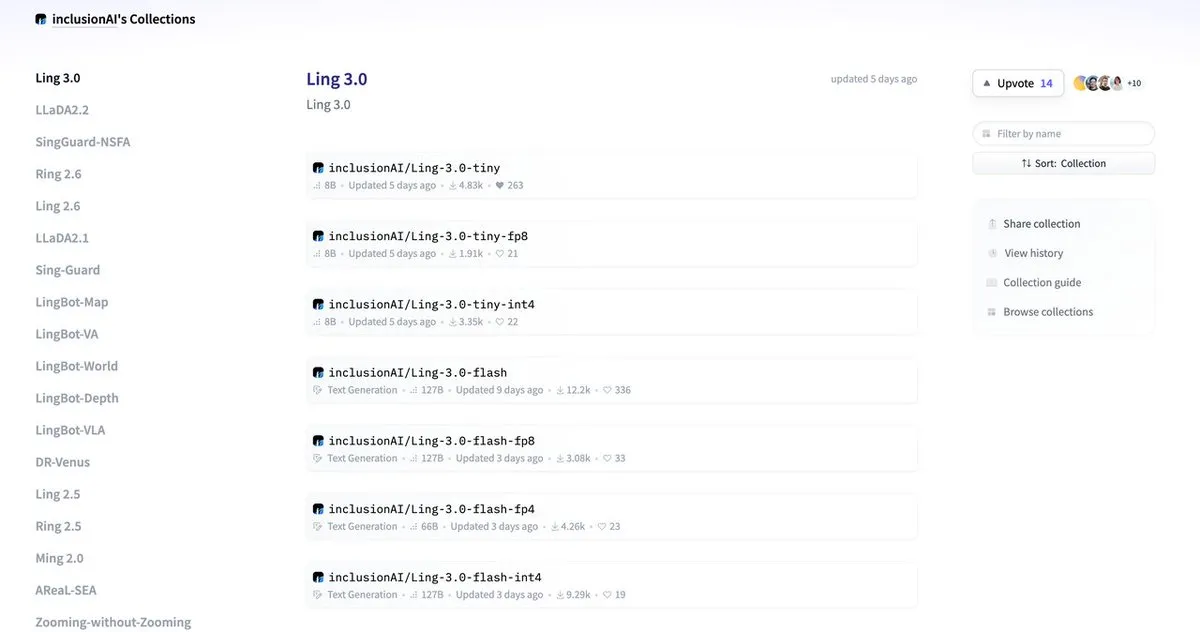
第一步,下载模型 。 我这次使用的是官方 INT4 版本,下载入口 👇🏻
- Hugging Face:Ling-3.0-flash-int4
- ModelScope:Ling-3.0-flash-int4
如果访问 Hugging Face 不方便,也可以直接从 ModelScope 手动下载,这里就不赘述具体过程了。下载后共有 24 个 safetensors 分片,实测约 71.75GB。运行时还要给推理引擎和 KV Cache 留出空间。
第二步,准备环境。 Ling-3.0-flash 的 BailingMoeV3 架构比较新。我试过用 GGUF 配合 llama.cpp,结果报错 unknown model architecture: 'bailingmoe3' 。所以这次直接使用 👉🏻 官方适配的 vLLM 分支:
pip install uv
uv venv ~/my_ling_env
source ~/my_ling_env/bin/activate

git clone -b ling_3_0 https://github.com/inclusionAI/vllm-ling-v3.git
cd vllm-ling-v3
VLLM_USE_PRECOMPILED=1 uv pip install --editable . --torch-backend=auto第三步,启动推理服务。 把模型路径换成本地下载好的 INT4 权重:
vllm serve /path/to/Ling-3.0-flash-int4 \
  --served-model-name ling-int4 \
  --host 127.0.0.1 \
  --port 30000 \
  --trust-remote-code \
  --max-model-len 16384 \
  --gpu-memory-utilization 0.8 \
  --max-num-seqs 8 \
  --reasoning-parser ling3 \
--speculative-config '{"method":"bailing_hybrid_v3_mtp","num_speculative_tokens":1}'⚠️ 命令中的相关路径,请替换成你本机的真实路径。
这里把上下文上限设为 16K,并发数设为 8,同时开启 MTP 投机解码。
说明:MTP(Multi-Token Prediction)会让模型一次尝试预测多个 Token,预测正确的部分可以直接采用,从而减少逐个生成 Token 的计算轮次,提升输出速度。
第四步,验证服务。 启动完成后,发一个最简单的请求:
curl -s http://127.0.0.1:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"ling-int4",
       "messages":[{"role":"user","content":"你好,请用一句话介绍自己。"}],
"stream":true}'终端开始流式返回内容,就说明这个 124B 模型已经在本地跑起来了。
03 测试模型性能与能力
- Token 吞吐
模型刚跑起来时,我先用 vLLM 自带的 bench serve 单独测了一轮。20 个请求全部完成,输出吞吐为 84.34 tok/s,总 Token 吞吐为 133.10 tok/s,MTP 接受率为 67.35%
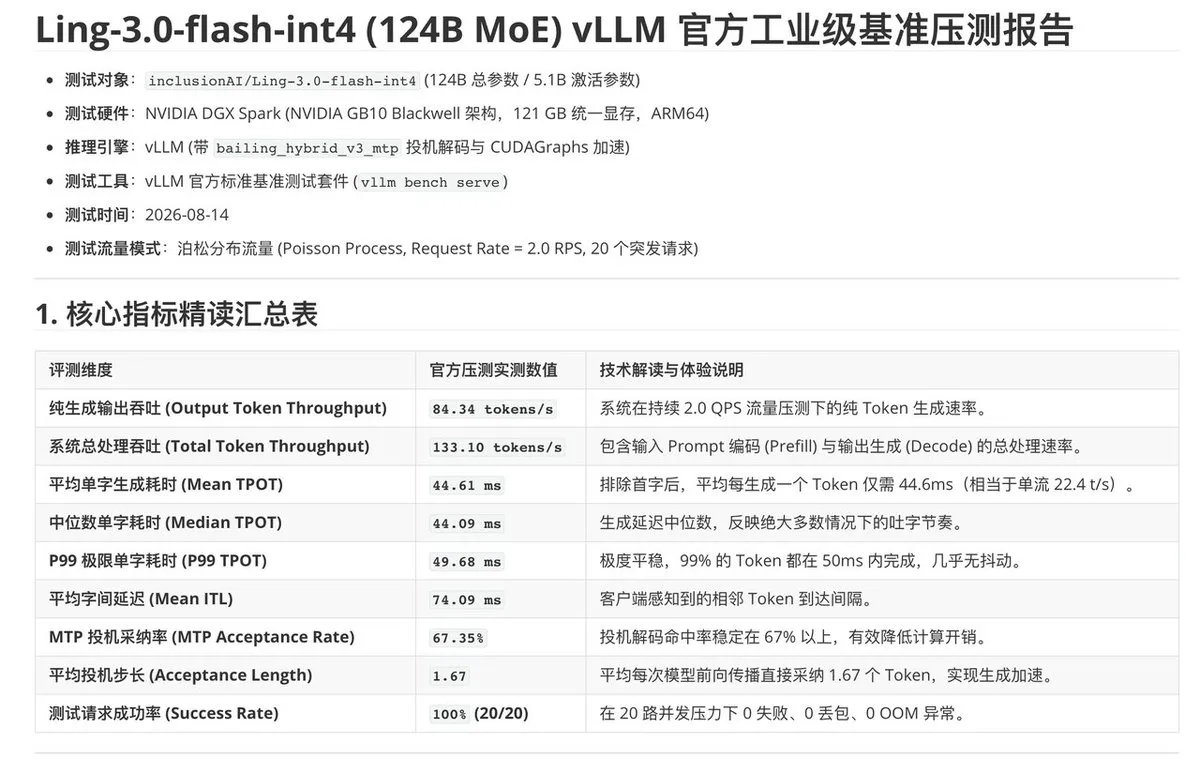
原始日志输出👇🏻
============ Serving Benchmark Result ============
Successful requests:                     20
Failed requests:                         0
Request rate configured (RPS):           2.00
Benchmark duration (s):                  60.71
Total input tokens:                      2960
Total generated tokens:                  5120
Request throughput (req/s):              0.33
Output token throughput (tok/s):         84.34
Peak output token throughput (tok/s):    61.00
Peak concurrent requests:                20.00
Total token throughput (tok/s):          133.10
---------------Time to First Token----------------
Mean TTFT (ms):                          19692.98
Median TTFT (ms):                        18877.99
P99 TTFT (ms):                           40039.02
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          44.61
Median TPOT (ms):                        44.09
P99 TPOT (ms):                           49.68
---------------Inter-token Latency----------------
Mean ITL (ms):                           74.09
Median ITL (ms):                         72.39
P99 ITL (ms):                            280.71
---------------Speculative Decoding---------------
Acceptance rate (%):                     67.35
Acceptance length:                       1.67
Drafts:                                  3051
Draft tokens:                            3051
Accepted tokens:                         2055
Per-position acceptance (%):
  Position 0:                            67.35
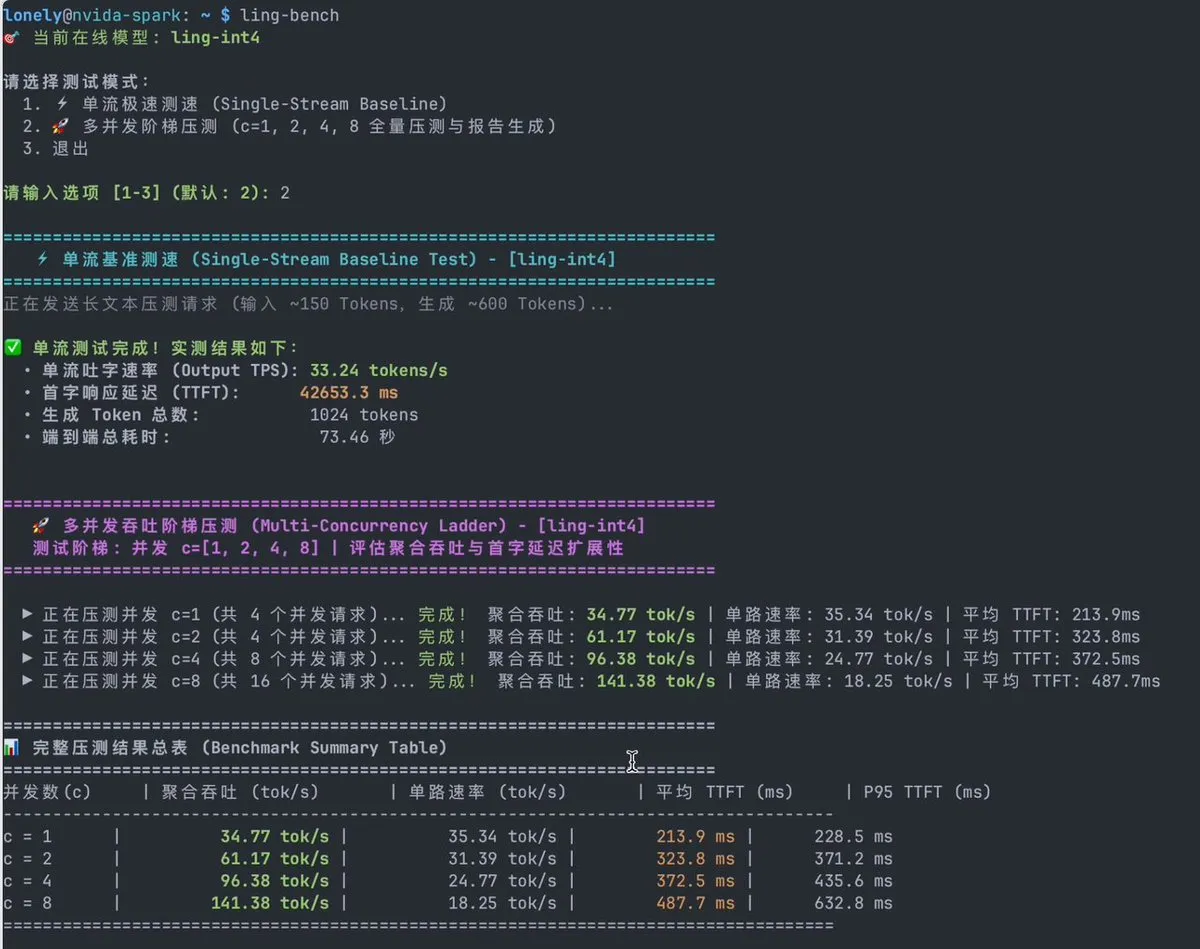
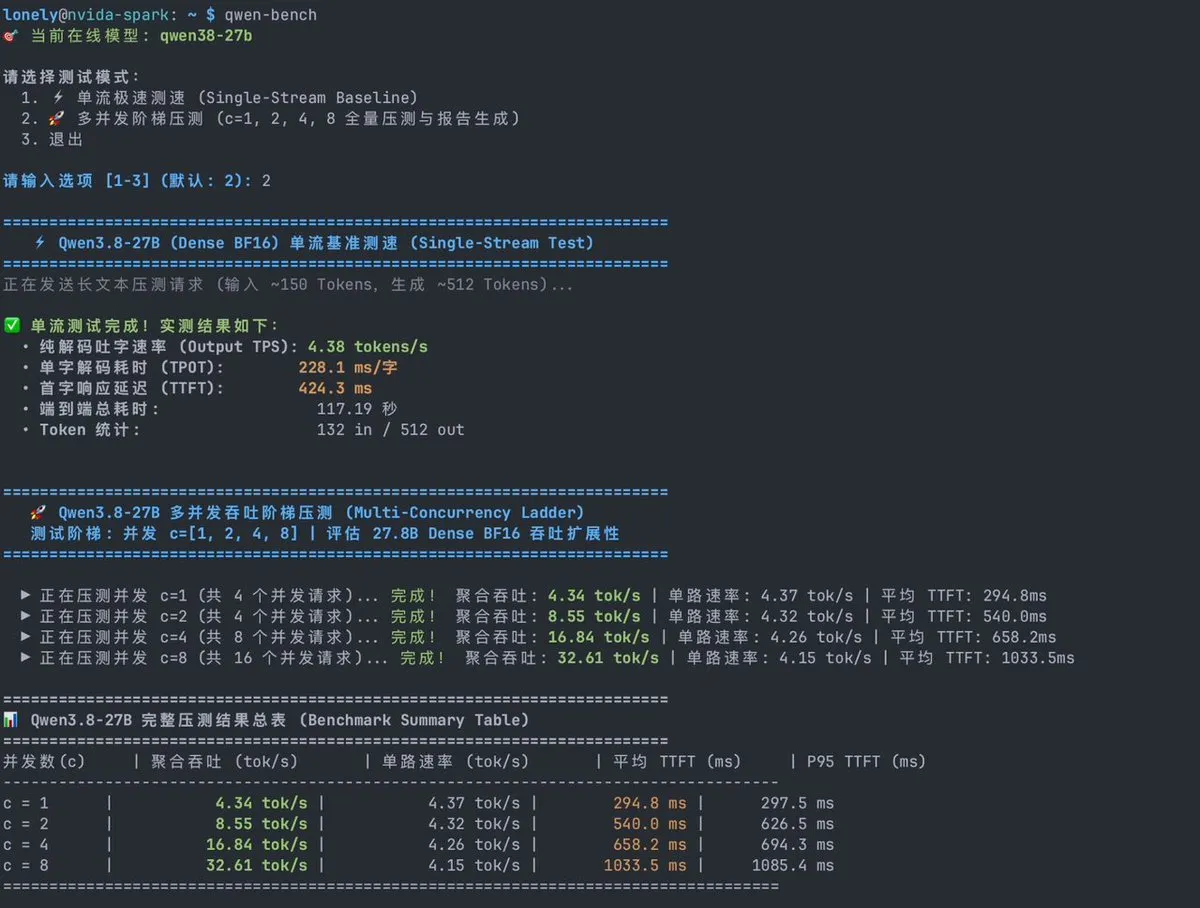
==================================================随后,我又把 Ling 和本机的 Qwen 3.8-27B 分别做了并发测试。8 并发下,Ling 的聚合吞吐为 141.38 tok/s,Qwen 3.8 为 32.61 tok/s,本轮相差约 4.34 倍。
🔥 🔥 🔥 Ling-3.0-Flash Vs Qwen3.8-27B 压测对比
Ling-3.0-flash
Qwen 3.8 -27B
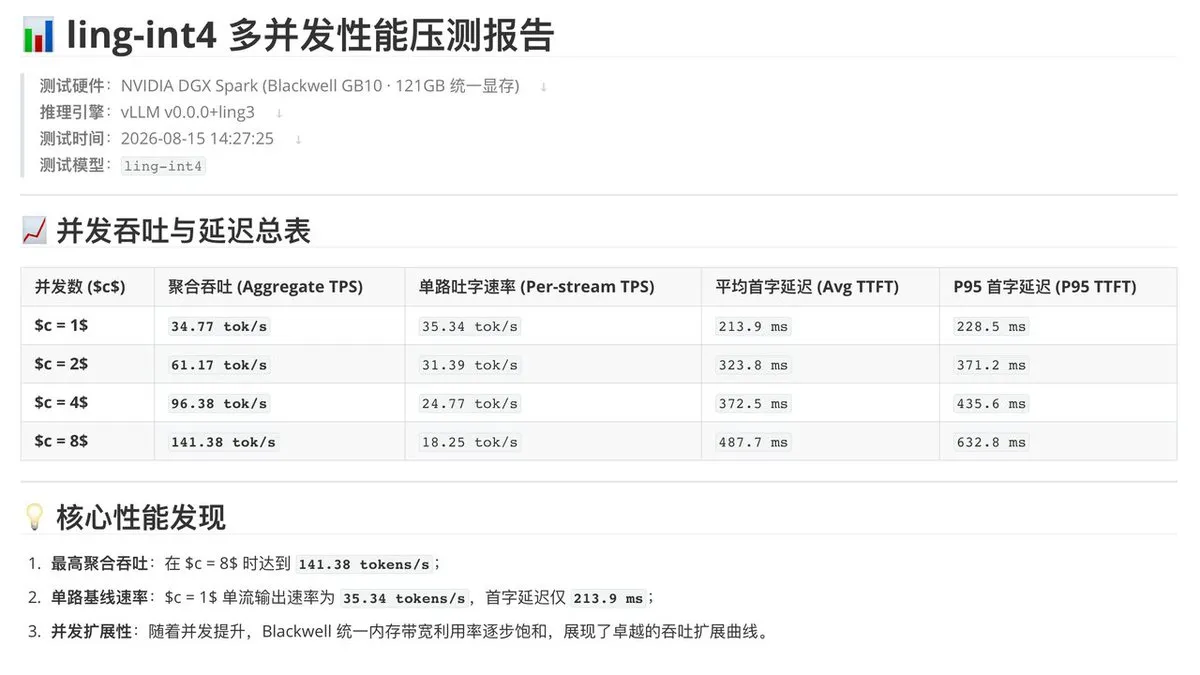
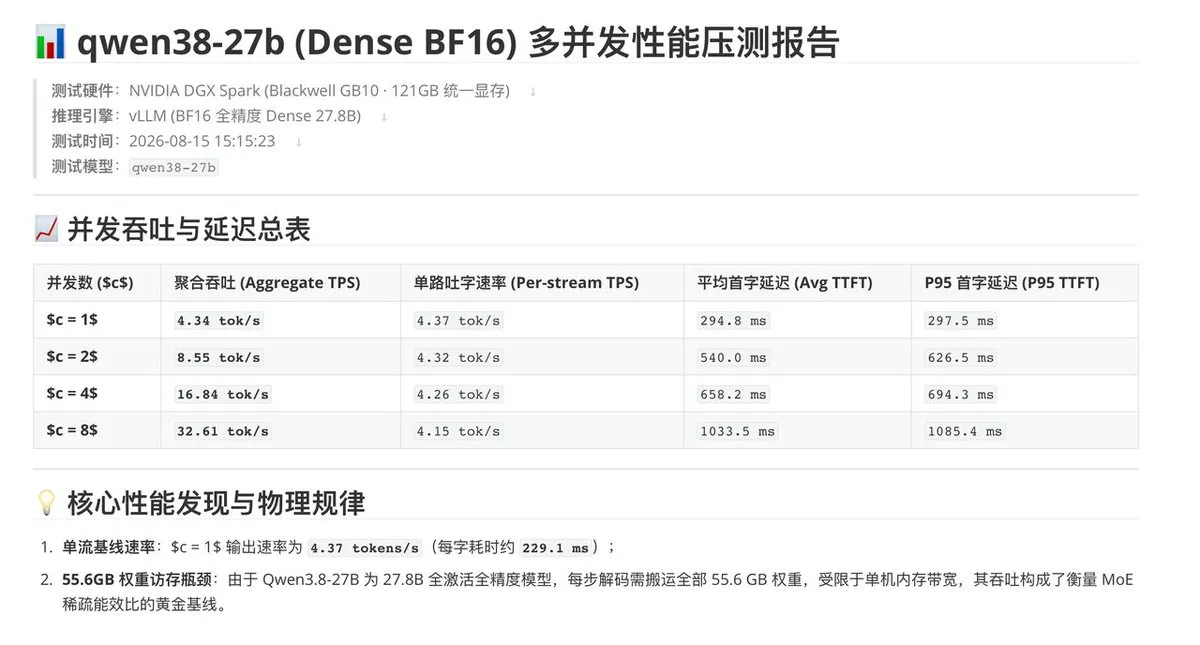
这里可能有人会疑惑:为什么 Ling 单并发只有 34.77 tok/s,到了 8 并发反而变成了 141.38 tok/s?也有技术朋友会问,这个单并发成绩和一些官方数据相比,是不是偏慢了?
这里需要先说明一下 测试的具体方法 ,以及 因为测评方式不同带来的速度不同 :
- 测试方法与真实端到端链路 : 本次使用的是本地 OpenAI 兼容接口,通过 HTTP 流式请求进行压测,不是脱离服务框架的离线推理测试。Ling 的每个请求使用同一段约 150 Token 的长文本提示词,最多生成 512 Token。计时从客户端发起 HTTP 请求开始,到流式响应接收完成为止,因此会包含本地 HTTP 调用、服务调度、Tokenizer 处理、Prefill、逐 Token 解码和流式返回等环节。
- 单路出字速率 vs 整机聚合吞吐 : 单流速度(单人真实体感) :\$c=1\$ 时测出的是单用户的端到端出字速率(约 35.34 tok/s,真实单次对话实测在 38+ tok/s),相当于每秒打出 35 个以上的汉字,肉眼看已经是极快的飞速流式打字效果; 聚合吞吐(并发总产出) :并发增加后,vLLM 会利用 Continuous Batching 将多个请求合并打包送入 GPU 计算,充分复用 Blackwell 的统一内存带宽。在 8 并发下,整机的聚合吞吐直接飙升到了 141.38 tok/s 。
至于为什么和某些官方跑分不同,关键还是测试口径。模型精度、推理引擎、上下文长度、输入输出 Token 数、并发规模,以及使用离线推理还是 HTTP 服务,都会影响最终结果。只有这些条件基本一致,数字才适合直接比较。
简单来说: 因为测评方式不同带来的速度不同 ——如果在极高并发(如 32/64 并发)或脱离网络协议的纯计算环境下测试,总吞吐数字会看起来更高;而在我们日常单人对话、写代码的真实生产调用中,Ling 的单流 35+ tok/s 和秒开首字延迟(<220ms),实际使用时已经能明显感觉到回复极度流畅、毫无卡顿。
单并发时,Ling 的平均单路速度约为 35.34 tok/s;到了 8 并发,整机聚合吞吐达到 141.38 tok/s。Qwen3.8 在 8 并发下的聚合吞吐为 32.61 tok/s。这一轮跑下来,Ling 的优势主要体现在出字速度和并发吞吐上,实际使用时也能明显感觉到回复更快。
- 真实能力
跑分只能反映一部分性能,实际好不好用,还是要看模型面对具体问题时的表现。我选了三个方向做简单测试。
(1)逻辑推理 我准备了鸡兔同笼变式题、经典洗车问题和洗车机问题,主要看它能不能准确理解条件,而不是套用一个看起来熟悉的答案。其中,鸡兔同笼还加入了 4 只三条腿的机械鸟,专门用来打破常规题型。
(2)安全边界:接下来测试它面对高风险操作时的反应:是直接执行命令,还是先识别风险、向用户确认,并给出更安全的替代方案。
(3)长文本 最后是一轮长文本测试。我把关键信息藏进较长的上下文里,看它能不能准确找到并回答,同时观察长文本下的输出速度和稳定性。
04 从 API 到 TUI,再到工具调用
前面完成了模型部署和能力测试,但对普通用户来说,curl 更适合用来验证接口是否正常,并不适合作为日常使用方式。真要和本地模型长时间对话,还是需要一个更顺手的交互界面。
所以我先做了一个简单的 TUI,也就是运行在终端里的聊天界面。它并不是什么复杂的软件,我直接让 AI 写了一个 Python 脚本,把本地接口调用、流式输出和对话记录保存封装起来,再用一条命令启动:
python3 ling-3.0-chat.py这样就不用每次手写 curl 了。打开终端就能直接聊天,回答会流式显示,还能看到 TPS、TTFT 和 Token 数。前面几轮能力测试,我就是在这个界面里完成的。
不过,这时候的 TUI 还只是一个文字聊天工具,并没有调用工具的能力。大模型更像一个负责思考的“大脑”,但它没有“手和脚”,没办法直接读取文件、执行命令,也不知道系统当前的真实状态。
想让它调用系统能力,就要给它加上工具调用。简单来说,就是把命令执行、文件读取和写入等操作封装成工具。模型会先判断自己需要什么信息,再发起一次 tool use ;Python 脚本负责执行,并把结果交还给模型继续处理。
比如一开始,我让它查看系统的 GPU 信息,它并不能知道真实的占用情况,只能告诉我应该怎么查。加入工具调用之后,它就可以自己执行系统命令,再把查询结果整理好,直接显示在 TUI 里。
基于同样的原理,还可以继续接入 Web 搜索、企业内部接口、数据库等能力。具体接入哪些工具,可以根据自己的业务需求自由扩展。
05 接入可视化界面
平时自己使用,一套 TUI 加上工具调用,其实已经完全够用了。如果还想再进一步,把模型放进一个更完整的 Agent 工作台,就可以接入 Harness 这类智能体框架。
这次我选择梁圣的 DeepSeek Harness, 它不只是给模型加一个聊天页面,还提供了上下文管理、工作区、工具调用、权限控制和任务规划等能力,并且自带可以在浏览器中使用的 Web UI。它采用“一切皆插件”的架构,后续可以根据需要继续扩展功能。
需要注意的是,DeepSeek Harness 目前仍处于开发者预览阶段,更新速度很快,后续可能会出现不兼容的改动。类似的开源 Agent 框架还有很多,大家可以根据自己的需求选择,这里就不一一展开了。
接入过程并不复杂,核心就是添加一个自定义模型服务,把地址指向 vLLM 提供的本地接口。除了直接在 Web UI 中配置,也可以修改配置文件,示意如下:
llm-pi-ai:
  providers:
    ling:
      displayName: "Ling-3.0-flash (124B)"
      api: openai-completions
      baseURL: http://127.0.0.1:30000/v1
      apiKeyEnv: OPENAI_API_KEY
      models:
        - id: ling-int4
name: Ling-3.0-flash (124B MoE)启动 Web UI 后,在浏览器打开默认地址:
http://localhost:3080这样一来,日常聊天、历史记录和模型切换,都可以直接在 DeepSeek Harness 里完成。Harness 本身已经提供了文件操作、命令执行和任务规划等能力,也可以通过插件继续扩展。具体用法和第三方插件,感兴趣的朋友可以自行搜索,这里就不赘述了。
需要注意的是,前面 Python TUI 里由我自己编写的工具不会自动迁移过来。如果还想在 Harness 中继续使用,需要按照它的插件机制重新接入。下面是我为 Ling 做的实际接入效果,大家可以直接看录屏。
06 搭建 AI 工作流
做到这里,从模型部署、对话界面到工具调用,一套围绕 Ling-3.0-flash 的单模型链路就全部打通了。
不过,平时真正做项目时,通常不会只用一个模型。不同模型擅长的事情不一样,把它们组合起来,往往比让一个模型包办所有任务更合适。
Ling-3.0-flash 的优势是文本处理和生成速度,但它不支持原生多模态输入。如果任务里需要理解图片或视频,可以接入 Qwen3.8-27B 这类多模态模型;如果还要生成视频,也可以接入最近开源的 MiniMax H3。每个模型负责自己擅长的部分,再把结果交给下一个模型继续处理。
比如要搭一套视频生成工作流,可以让 Ling 先理解需求、编写脚本和拆分分镜,再让多模态模型检查参考素材和画面一致性,最后交给视频模型生成。生成完成后,还可以再做一轮视觉检查,根据结果修改提示词并重新生成:
需求与素材
→ Ling 生成脚本和分镜
→ 多模态模型检查素材和画面要求
→ MiniMax H3 生成视频
→ 多模态模型检查画面和连续性
→ Ling 根据反馈调整提示词
→ 人完成最终审核下面这段视频,就是先由 Ling-3.0-flash 生成提示词,再交给 MiniMax H3 生成的实际效果。
这套流程一旦固定下来,后面只需要更换需求和素材,就可以重复使用。不过,想把多个大模型同时放在本地运行,对显存和内存的要求会非常高。Ling INT4 约 72GB,Qwen3.8-27B BF16 约 51.77GB,再加上 KV Cache 和视频模型,很难全部常驻在这台 Spark 上。
实际部署前,一定要先算好每个模型需要占用多少显存或统一内存。资源不够时,可以按步骤切换模型、选择量化版本,或者把不同模型拆到多台设备上运行。多个模型不再各跑各的,而是围绕同一个任务接力协作,这才是一套真正能用的多模型 AI 工作流。
07 写在最后
折腾到这里,从模型部署、TUI、工具调用到多模型工作流,整条链路就算走完了。这篇文章想分享的不是一套固定配置,而是这套可以重复使用的方法。
开源模型还会持续更新。以后无论换模型、量化版本还是推理引擎,从下载权重、启动服务,到接入工具和工作流,这条路径都不会有太大变化。
有条件的话,我还是推荐大家亲手部署本地模型:
- 数据可控: 文件、对话和业务数据可以留在本机或内网,目录和命令权限也由自己限制。
- 适合高频使用: 不用按次计算 Token 费用,也能减少对网络和第三方服务的依赖。
- 方便定制: 模型、量化精度、推理引擎和工具都能自己调整,也可以接入内部接口和数据库。
随着开源模型越来越强,本地部署也会成为越来越多人的选择。大家可以根据自己的任务需求、设备条件和预算,选择合适的模型,把工具和工作流搭起来。希望以后每个人都能拥有一套自己的本地 Agent,不用每次调用都盯着 Token 消耗,真正实现属于自己的“Token 自由”!
