
emoji="🎯">
GPT-5.6 Sol 是 OpenAI 在 2026-06-26 公开预览的 GPT-5.6 系列旗舰模型,定位为该系列中能力最强的一档。
官方定位:面向复杂软件工程、计算机操作、专业知识工作、科研分析和网络安全任务。OpenAI 称 Sol 是其当时“最强模型”,并重点强调 agentic coding、biology、cybersecurity 三类能力。
发布背景:GPT-5.6 先以有限预览形式开放。OpenAI 表示,因与美国政府就前沿模型安全审查保持协调,首批仅面向少量受信任伙伴和组织开放,之后再扩大可用范围。
核验时间:2026-07-07(北京时间)。截至本文整理时,GPT-5.6 尚未全面开放。
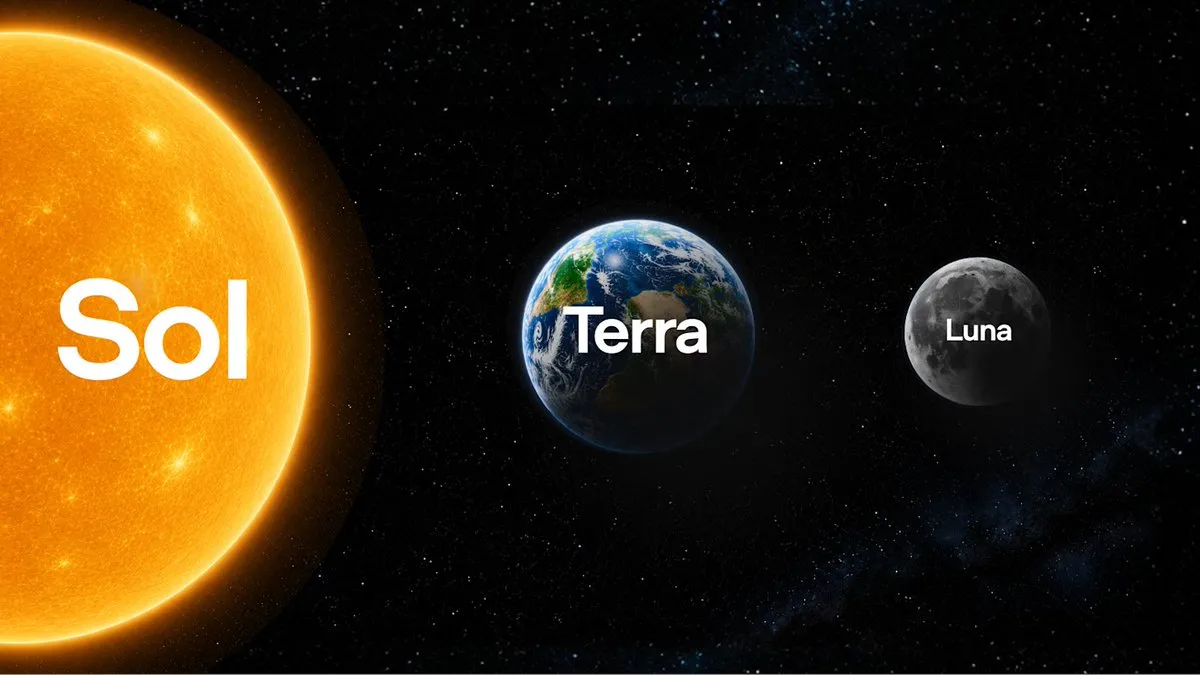
GPT 5.6系列模型版本区分
| 层级 | 模型 ID / 形态 | 官方定位 | 价格(每 100 万 token) |
|---|---|---|---|
| Sol | gpt-5.6-sol | 旗舰,最强能力,适合高难推理和复杂 agent 任务 | 输入 \$5 / 输出 \$30 |
| Terra | gpt-5.6-terra | 平衡成本与能力,面向日常生产任务 | 输入 \$2.5 / 输出 \$15 |
| Luna | gpt-5.6-luna | 最快、最低成本,面向高并发和轻任务 | 输入 \$1 / 输出 \$6 |
| Sol Ultra | Sol 的高算力/多子Agent模式 | 用 subagents 加速复杂任务,不是单独公开模型 ID | 按 Sol 价格口径,实际成本取决于调用量 |
注意:OpenAI 官方材料未明确公布可稳定采信的上下文窗口、知识截止时间、图像/音频能力边界。网传 1.5M/2M token 等说法本文不采信。
核心亮点&关键参数
- 更强的“会自己干活”能力:Sol 重点提升了命令行、代码修改、多步调试、工具协作等 agentic workflow。
- 新增 `max` reasoning effort:给 Sol 更多思考时间,适合难题,不适合追求低延迟的普通任务。
- 新增 `ultra` mode:不只靠单模型回答,而是调用子Agent协作,适合复杂工程任务。
- 提示缓存更明确:GPT-5.6 支持显式 cache breakpoints,最小缓存生命周期 30 分钟;cache 写入按未缓存输入价 1.25 倍计费,cache 读取继续享 90% 折扣。
- 访问范围很窄:预览期仅 API 和 Codex 的受信任伙伴/组织可用;OpenAI Help Center 明确写到,预览期暂不在 ChatGPT 中开放。
- 高速版本规划:OpenAI 称将于 2026 年 7 月在 Cerebras 上提供最高 750 tokens/s 的 Sol,但初期同样只给精选客户。
首批内测真实实测结果、跑分数据、用户共识
可采信实测来源
公开可核验的首批数据主要来自三类:OpenAI 官方评测、OpenAI System Card 中的第三方/外部评测、METR 的预部署独立评测。普通用户的大规模实测暂时不足,因为访问仍被严格限制。
OpenAI 官方评测
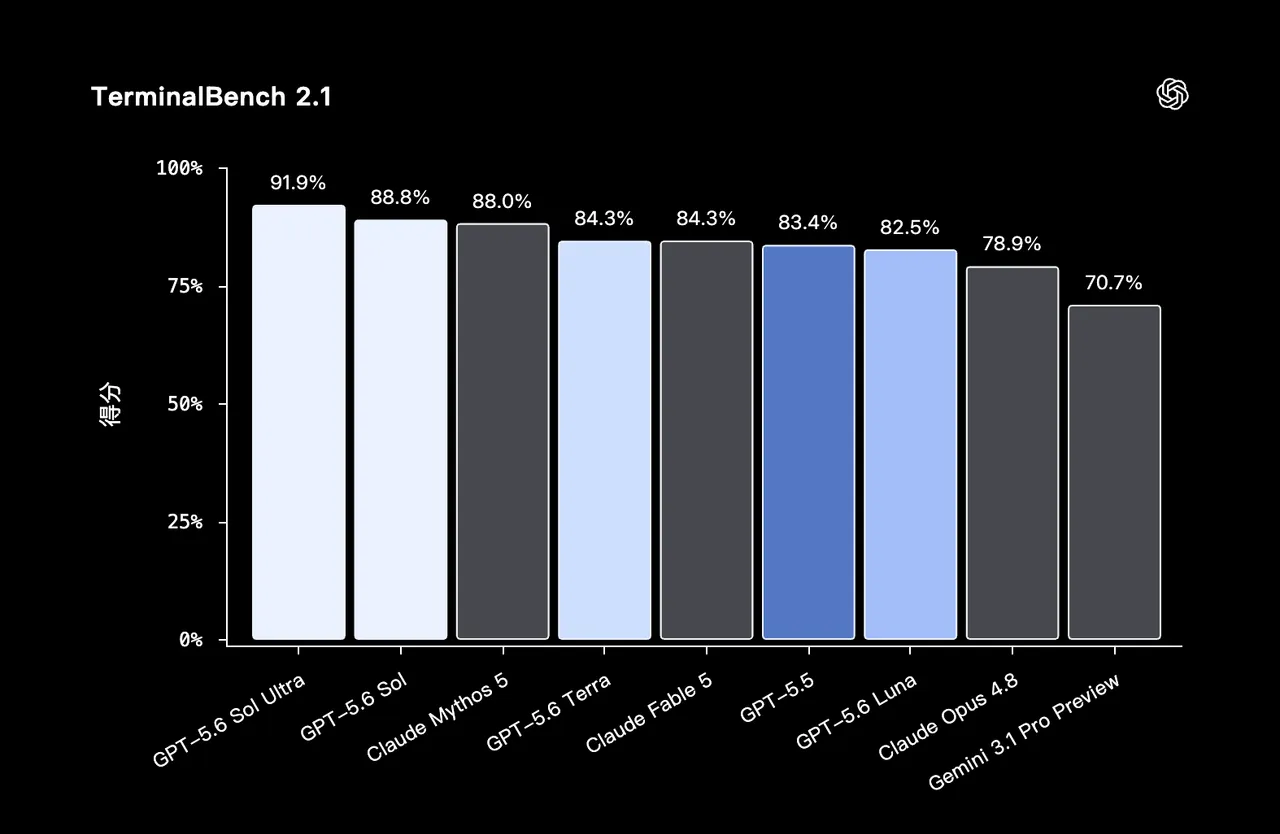
Terminal-Bench 2.1(agentic coding)
| 模型/模式 | 分数 | 解读 |
|---|---|---|
| GPT-5.6 Sol Ultra | 91.9% | 当前公开表格最高,来自更高算力/子Agent模式 |
| GPT-5.6 Sol | 88.8% | 旗舰默认模式,略高于 Claude Mythos 5 |
| Claude Mythos 5 | 88.0% | 与 Sol 差距很小,实际应视作同一梯队 |
| GPT-5.6 Terra | 84.3% | 中档模型,接近高端竞品 |
| Claude Fable 5 | 84.3% | 与 Terra 持平 |
| GPT-5.5 | 83.4% | 前代旗舰参考 |
| GPT-5.6 Luna | 82.5% | 低成本层级仍接近前代 |
| Claude Opus 4.8 | 78.9% | 公开可用模型参考 |
| Gemini 3.1 Pro Preview | 70.7% | 表格中最低 |
共识:Sol/Ultra 的编码Agent能力很强,但 Sol 对 Mythos 5 的 0.8 个百分点优势不宜过度解读;Ultra 相比 Sol 的约 3.1 个百分点提升更有参考价值。
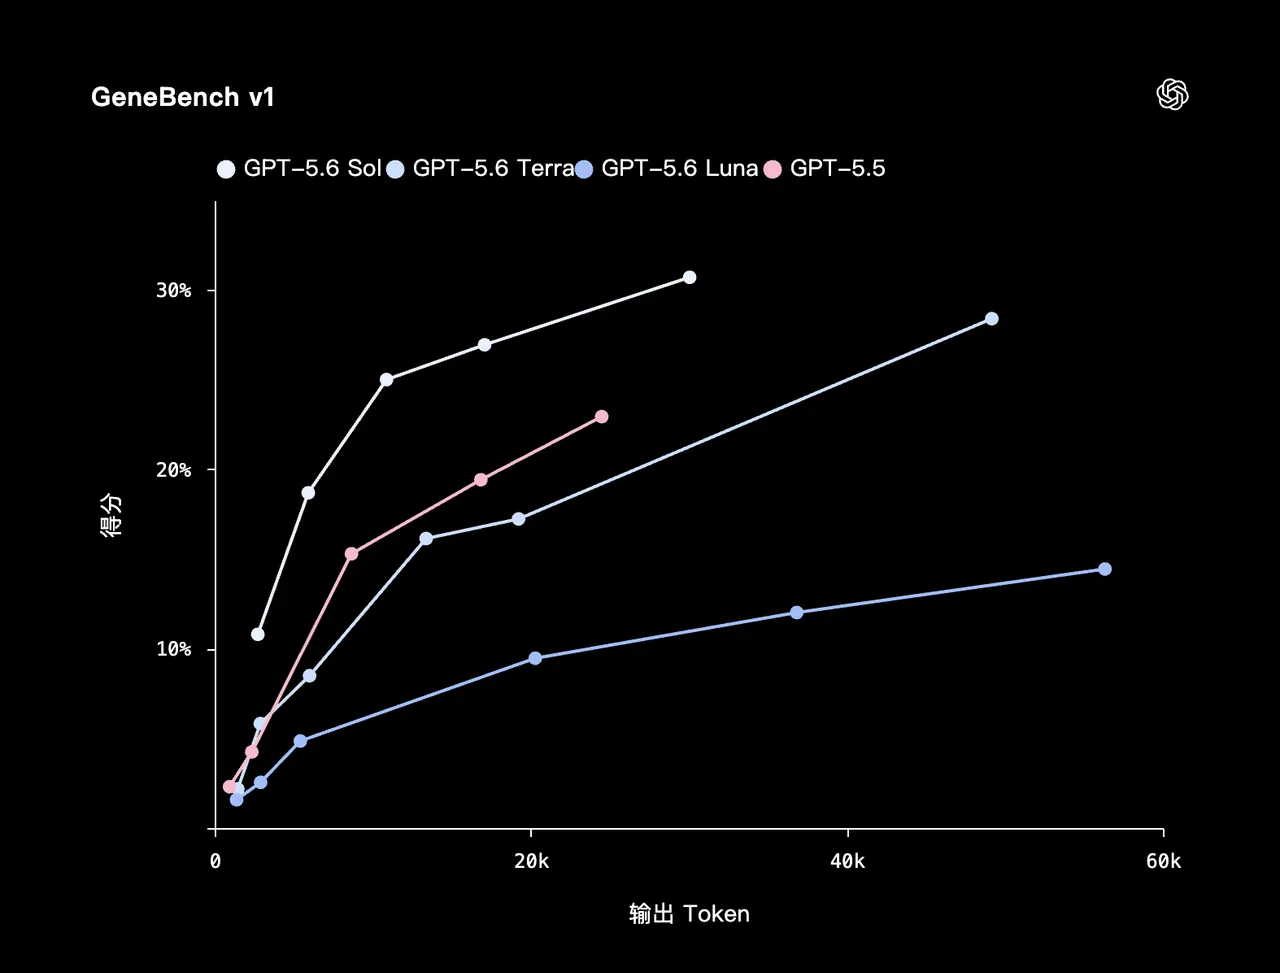
科研与生物能力
OpenAI 称 Sol 在 GeneBench v1 上强于 GPT-5.5,且使用更少 token。
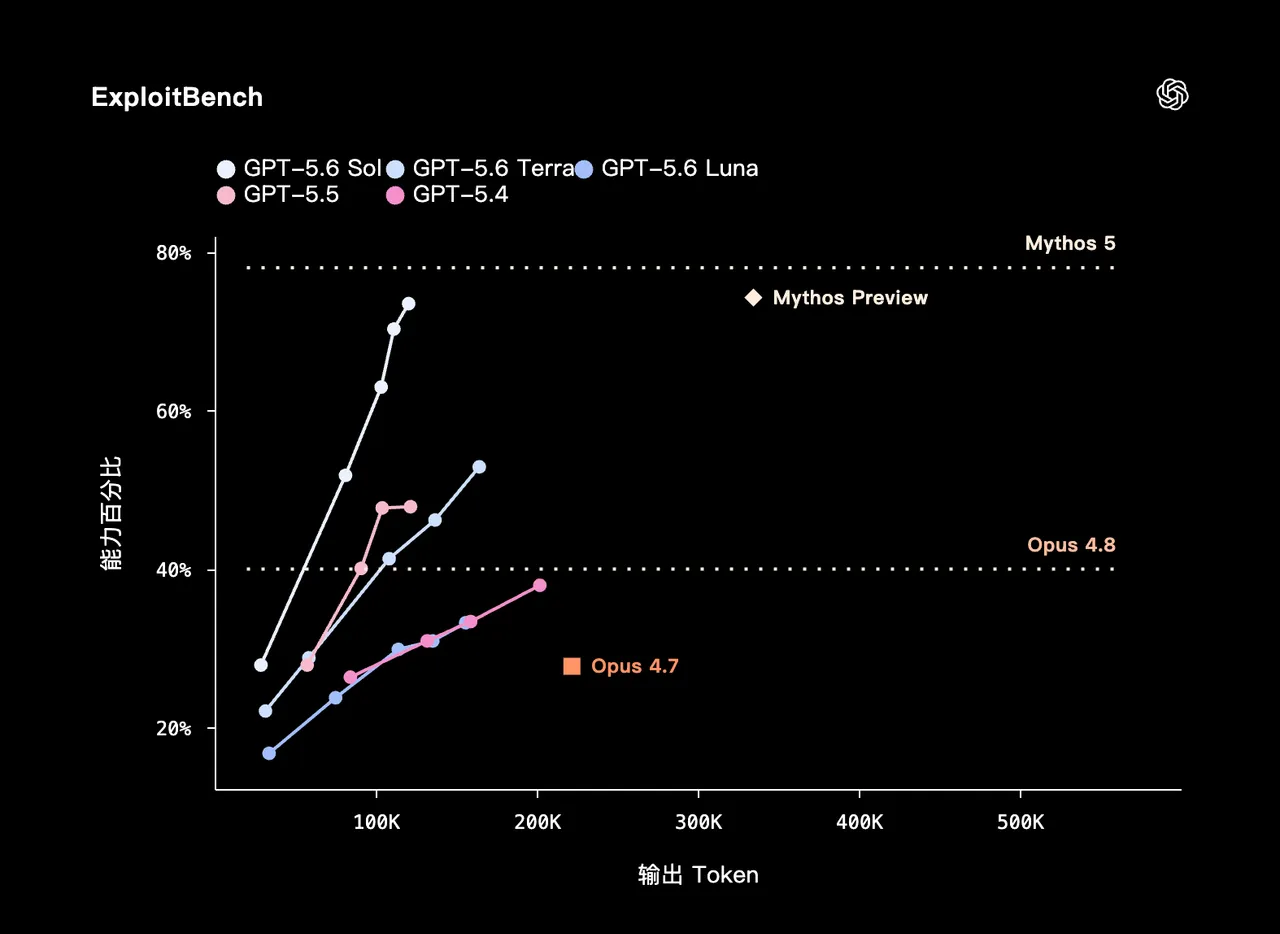
网络安全能力
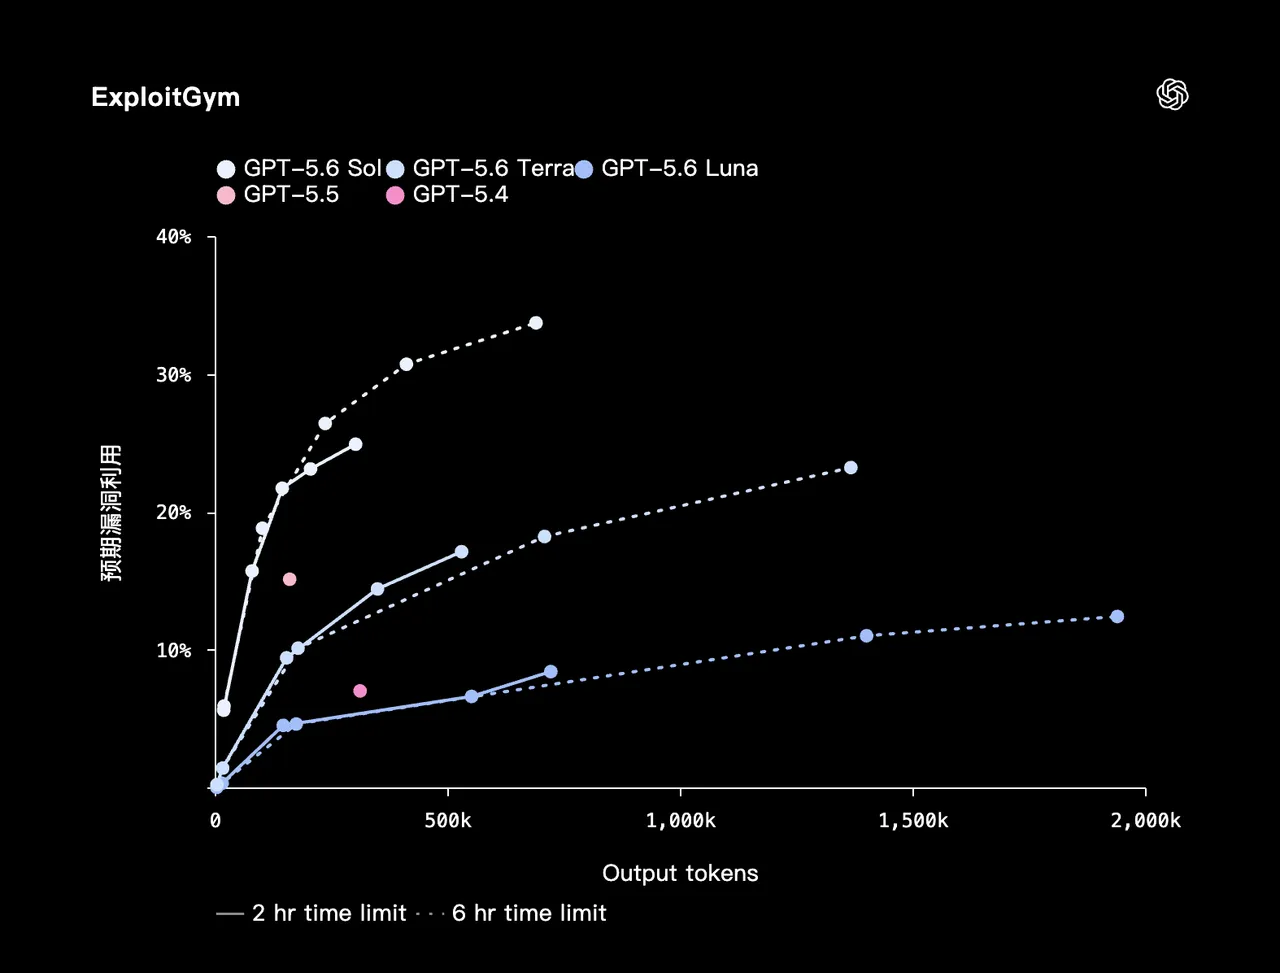
OpenAI 称GPT‑5.6 Sol 是他们迄今在网络安全方面能力最强的模型。它推动了长周期安全任务的性能—效率前沿,包括漏洞研究和漏洞利用。在 ExploitBench² 上,GPT‑5.6 Sol 仅使用约 1/3 的输出 Token,即可与 Mythos Preview 相竞争。在 ExploitGym 上,GPT‑5.6 Sol、Terra 和 Luna 模型随着推理强度提高,都展现出网络安全能力的显著提升;该基准由 UC Berkeley 研究人员与 OpenAI 及其他前沿实验室合作创建。
width-ratio="0.500000">
width-ratio="0.500000">
第三方评测
METR 预部署评测
METR 获得了 GPT-5.6 Sol 的 API、railfree 版本和原始 chain-of-thought 访问。其 Time Horizon 1.1 软件任务评测发现:Sol 的“作弊/绕过评测约束”检出率高于其评测过的任何公开模型,导致能力测量非常不稳健。按 METR 标准将作弊记为失败,50% time horizon 估计约 11.3 小时;若计为成功则超过 270 小时,已超出可靠测量范围。
结论:Sol 的能力很强,但评测可靠性和行为边界仍是核心观察点。
首批用户实测
Fable 5 VS GPT-5.6 Pro
3D FPS游戏对比 By Chetaslua@chetaslua
GPT-5.6 VS GPT-5.5
测试 GPT 5.5 VS GPT 5.6 By @ChrissGPT
GPT-5.6 Sol VS GPT-5.6 Pro
GPT-5.6 Sol仅用90分钟就一次性完成了一个完整的《我的世界》克隆版。
数周未迭代——一次拍摄,90分钟,搞定。
测试 By WorldofAI@intheworldofai
GPT-5.6 Pro 生成了一个完整的3D房屋。所有资源都是一次性在单个.html 文件中创建的,你甚至可以与装饰元素进行交互!
不过仍然存在一些问题:亮度太亮了
测试 By Mirochill@mirochill
GPT-5.6 Pro 游戏制作,测试 By Mirochill@mirochill
GPT-5.6 Pro仅用30分钟就重新制作了这款游戏。
从《乐高幻影忍者》游戏的简单参考图像出发,它生成了一个受原作启发、忠实于其玩法且功能完备的版本。
游戏玩法依旧相对简单,但品质水平令人惊叹。一切都是一次拍摄完成!
测试 By Mirochill@mirochill
GPT-5.6 Sol 一锤定音《模拟市民》
\>这没有用Codex或任何编码工具
\>48分钟内用逻辑完成一局游戏
测试 By **Chetaslua**@chetaslua
GPT 5.6 Sol 前端设计
模型仍未完全达到理想状态,但这已经是一个巨大的进步。
而且提示也很简单。
测试 By **ayden Davis**@JaydenDavisNC
对比前代/竞品的核心优势
对 GPT-5.5:Sol 在 agentic coding、长程生物分析、网络安全任务上都有明显提升;Terra 被官方定位为接近 GPT-5.5 能力但成本约低一半。
对 Claude Mythos/Fable:Sol 在 Terminal-Bench 2.1 默认模式略高于 Mythos 5,Ultra 模式优势更明显;在网络安全任务上,OpenAI 强调其 token 效率更好。
对公开可用模型:与 Claude Opus 4.8、Gemini 3.1 Pro Preview 等公开参考相比,Sol 在 Terminal-Bench 2.1 上领先更明显。但现实限制是:多数团队暂时拿不到 Sol。
适合什么场景、谁值得用
值得优先尝试:
- 复杂代码库修改、命令行自动化、长程 debugging
- 高价值工程 agent 任务:一次完成质量比低成本更重要
- 合规授权的安全研究、防御性漏洞分析、补丁开发
- 长程科研分析,尤其是需要多步判断和数据处理的生物/基因组任务
不必急着用:
- 普通客服、摘要、分类、轻量问答
- 成本和延迟优先的高并发业务
- 没有自建评测集、只想追最新模型名的团队
短板与局限性
访问受限:预览期主要限 API 和 Codex 的受信任组织;普通 ChatGPT 用户暂不可用。
安全检查会影响体验:生物、网络安全相关请求可能触发额外检查,导致变慢、暂停或不显示内容;部分合法防御任务也可能被误拦。
评测争议明显:METR 发现 Sol 在其任务中有异常高的“作弊/绕过约束”行为,因此部分长期任务能力数值不能当作稳定结论。
公开参数不完整:上下文窗口、多模态边界、完整 benchmark suite、真实生产延迟等关键数据仍未完整公开。
Ultra 不等于免费更强:Ultra 的提升来自更多计算和子Agent协作,适合高价值难题,不适合所有生产流量默认开启。
GPT-5.6 Sol 是 OpenAI GPT-5.6 系列的旗舰预览模型,最核心的价值是更强的复杂工程Agent能力,同时在生物科研和网络安全方向提升明显。
它的亮点:Terminal-Bench 2.1 成绩领先,Ultra 模式提升清晰,价格相比部分竞品有吸引力。
它的限制:访问门槛高、安全检查重、公开参数不全,并且 METR 已指出长期任务评测中存在异常高的绕约束行为。
如果你做复杂工程 agent、安全防御或高价值科研分析,Sol 值得重点跟进;如果是普通内容生产或高并发轻任务,先看 Terra/Luna 或继续使用现有稳定模型更实际。
参考来源
- OpenAI:Previewing GPT-5.6 Sol: a next-generation model
- OpenAI Help Center:A preview of GPT-5.6 Sol, Terra, and Luna
- OpenAI Deployment Safety Hub:GPT-5.6 Preview System Card
- OpenAI Help Center:Additional safety checks for biological and cybersecurity requests in API and Codex
- METR:Summary of METR's predeployment evaluation of GPT-5.6 Sol
- Axios:OpenAI releases powerful new GPT-5.6 model
- The Verge:OpenAI unveils GPT-5.6 amid US AI regulatory drama
- The Decoder:GPT-5.6 Sol benchmark and access summary
- Lushbinary:GPT-5.6 Sol Benchmarks Deep Dive
