
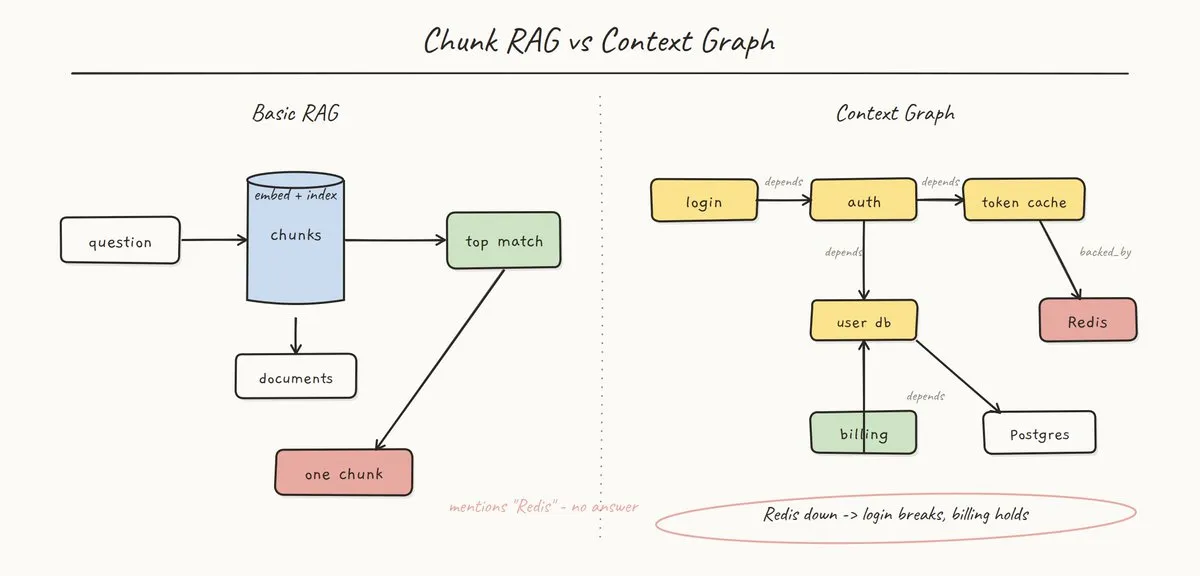
问一个文本块检索器:“如果 Redis 挂了,什么会出问题?”它会把语料库里那个包含 Redis 这个词的句子交给你。
- 但那个句子并没有回答问题。真正的答案分散在四份彼此没有互相提及的文档里,而相似度搜索没有办法从一份文档走到下一份文档。
这就是 RAG 的天花板,而且它不是一个调参问题。嵌入向量检索的是“提到”你所问对象的文本。它无法检索对象本身,也无法检索真正承载答案的关系链。对单一事实查询来说,这没问题;但凡涉及多跳推理,它在结构上就不是合适的工具。
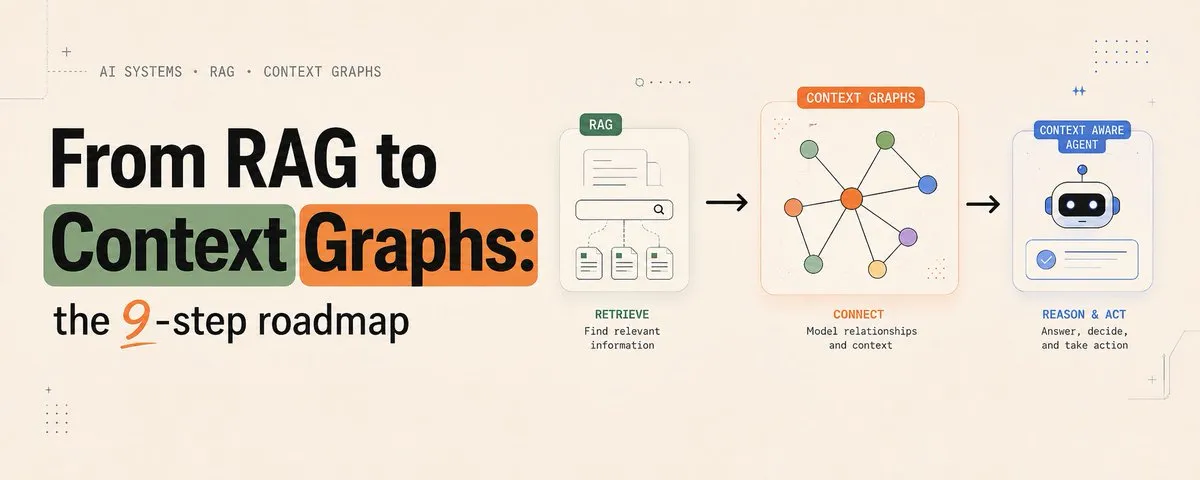
- 修法不是继续检索段落,而是开始检索一张图:实体是节点,关系是边,答案是路径。下面是一条从文本块走向可遍历、可引用的上下文图的 9 步路线图。不需要框架。下面这个引擎大约 150 行代码。
第一层:抽取
01. 从 RAG 回答不了的问题开始
不要一上来就构建图。先写下当前检索器回答失败的那个查询,因为这个查询会定义图真正需要的实体和关系。
失败查询有一个形状:它们是多跳的。“如果 Redis 挂了,什么会出问题?”真正问的是:“依赖某个东西的那个东西,又依赖 Redis 支撑的那个东西,那么上游会有哪些受影响?”每一跳都是一个关系,答案是一条路径,而不是一个段落。如果你最难的问题只是单跳查找,你不需要图。如果它们是链条,你就需要图。
02. 抽取实体和关系,而不是嵌入向量
RAG 会把文本块转成嵌入向量。上下文图会读取每个文本块,并抽取三元组:主体、关系、客体。在生产环境里,抽取器通常是一次 LLM 调用。这里用的是少量确定性模式,因此输出可复现。
PATTERNS = [
    (re.compile(r"(.+?) depends on (.+)", re.I),   "depends_on"),
    (re.compile(r"(.+?) is backed by (.+)", re.I), "backed_by"),
    (re.compile(r"(.+?) runs on (.+)", re.I),      "runs_on"),
    (re.compile(r"(.+?) is owned by (.+)", re.I),  "owned_by"),
]

def extract(chunk_id: str, text: str) -> list[Triple]:
    out = []
    for sentence in re.split(r"[.\n]", text):
        s = sentence.strip()
        if not s:
            continue
        for rx, rel in PATTERNS:
            m = rx.match(s)
            if not m:
                continue
            subj = m.group(1)
            for obj in re.split(r"\band\b", m.group(2)):   # "X and Y" -> 两条边
                obj = obj.strip()
                if obj:
                    out.append(Triple(subj.strip(), rel, obj, chunk_id))
            break
return out每个三元组上的 chunk_id 不是事后补上的小东西。它让最终答案可以被引用;而 RAG 一旦把文本块拼进提示词,就会把这件事丢掉。
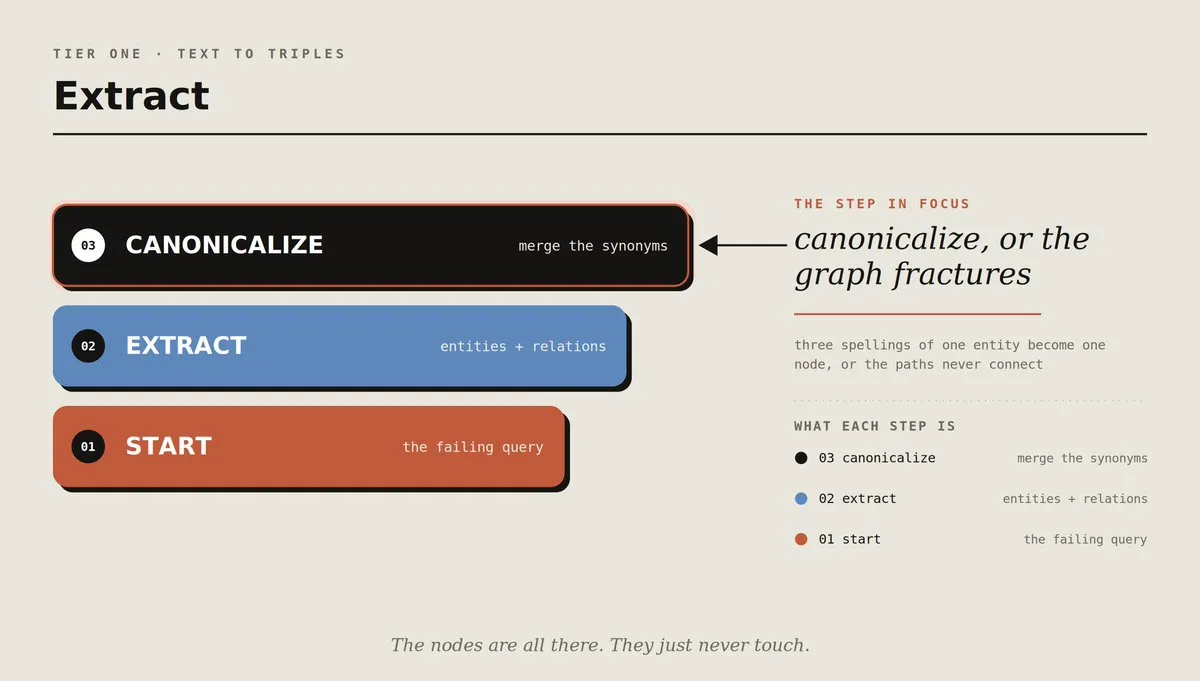
03. 做规范化,否则图会碎掉
第一道关卡。
- “The Auth Service”、“auth service”和“AuthService”其实是同一个实体。
如果图把它们当成三个实体,那么每条边都会落到不同节点上,路径永远连不起来。规范化是一个不显眼的步骤,但它决定了这到底是一张图,还是三个互不相连的碎片。
ALIASES = {
    "authservice": "auth service",
    "user db": "user database",
    "postgres": "postgresql",
}

def canon(name: str) -> str:
    n = name.strip().lower()
    n = re.sub(r"^the\s+", "", n)
    n = re.sub(r"\s+", " ", n)
    n = re.sub(r"[.]$", "", n)
return ALIASES.get(n, n)转小写、去掉冠词、合并空白、应用别名表。这是实体消歧问题的缩小版。做错它,是自制 GraphRAG 返回不了有用结果最常见的原因:节点都在那里,只是彼此从未接触。
第二层:连接
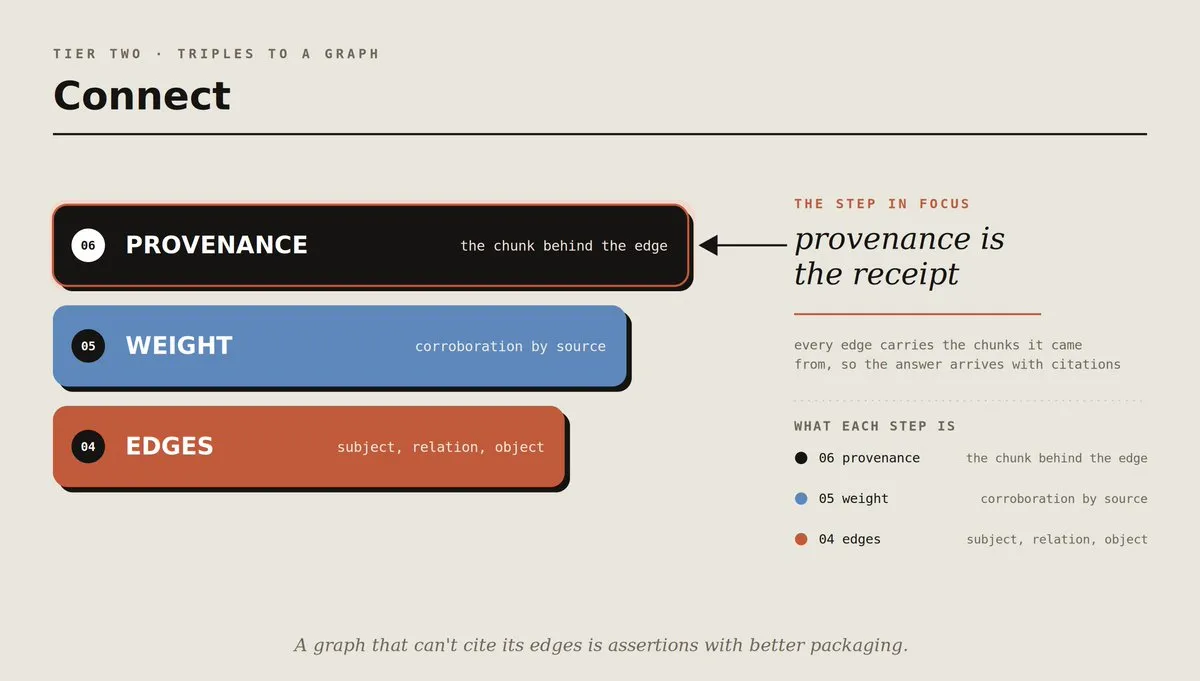
04. 构建边列表:主体、关系、客体
图本身由两张邻接表组成,一张正向,一张反向,因为你需要双向遍历:正向回答“X 依赖什么”,反向回答“什么依赖 X”。
@dataclass
class Edge:
    rel: str
    dst: str
    weight: int = 1
    sources: set = field(default_factory=set)

def add(self, t: Triple) -> None:
    s, o = canon(t.subj), canon(t.obj)
    self.nodes.add(s); self.nodes.add(o)
    self._merge(self.fwd, s, t.rel, o, t.source)
self._merge(self.rev, o, t.rel, s, t.source)同时存储两个方向会让内存翻倍,但也会消除一整类“我只能朝一个方向搜索”的缺陷。对知识图来说,这始终是值得的取舍。
05. 根据多少来源达成一致来给边加权
如果两个不同文本块都说 auth service 依赖 token cache,那么这条边就比单一来源断言的边更强。这就是佐证:把智能体群体变成验证器的同一个思想,应用到图上。
@staticmethod
def _merge(side, a, rel, b, src) -> None:
    for e in side[a]:
        if e.rel == rel and e.dst == b:      # 同一条边再次出现 = 佐证
            e.weight += 1
            e.sources.add(src)
            return
side[a].append(Edge(rel, b, 1, {src}))在真实运行中,auth-service 到 token-cache 这条边来自两个文本块,因此权重为 2。当两条路径都可能回答同一个问题时,由被多方佐证的边构成的路径更值得信任,而这个权重就是第 8 步里的排序依据。
06. 给每条边附上来源
第二道关卡。
每条边都携带它来自哪些文本块。正是这个属性,让上下文图可以回答问题,而不只是给出看似合理的建议:当图返回一条路径时,它也会返回每一跳的收据。
def cite_path(g: ContextGraph, path: list[str]) -> list[str]:
    lines = []
    for a, b in zip(path, path[1:]):
        for e in g.fwd.get(a, []):
            if e.dst == b:
                src = ",".join(sorted(e.sources))
                lines.append(f"{a} -{e.rel}-> {b}  [{src}]  x{e.weight}")
                break
return lines输出会像这样,而这就是整件事的重点:
login flow -depends_on-> auth service  [c1]  x1
auth service -depends_on-> token cache  [c2,c8]  x2
token cache -backed_by-> redis [c3] x1三跳,三条引用,其中一条得到了佐证。如果一张图不能引用自己的边,那它只是包装更好的断言堆。
第三层:遍历
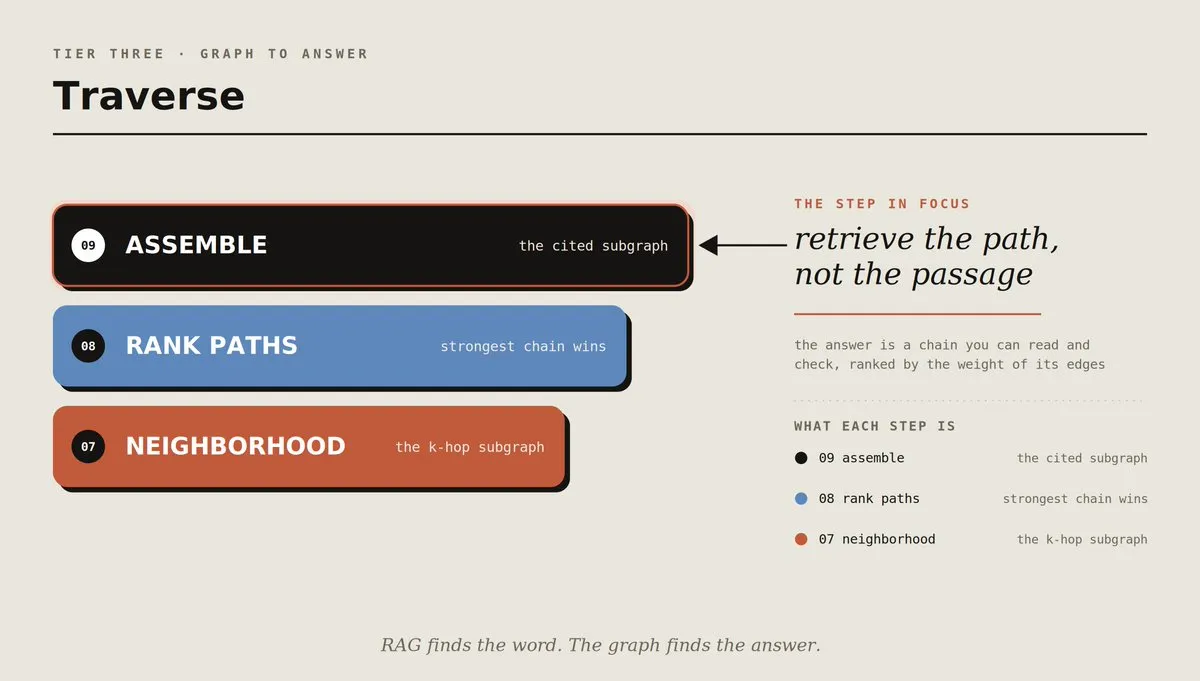
07. 按 k 跳邻域检索
现在,检索不再是相似度计算,而是一次行走。一个问题的上下文,不是最相似的 top-k 文本块,而是问题中提到的实体在 k 跳以内的子图。
def neighborhood(g: ContextGraph, start: str, hops: int) -> set:
    seen, frontier = {canon(start)}, {canon(start)}
    for _ in range(hops):
        nxt = set()
        for n in frontier:
            for e in g.fwd.get(n, []):
                nxt.add(e.dst)
        frontier = nxt - seen
        seen |= nxt
return seen08. 给路径排序,而不是给段落排序
第三道关卡。
多跳问题要通过反向可达性来回答:如果 Redis 挂了,就沿着反向边走,找出所有会随之出问题的上游部分。
def impacted_by(g: ContextGraph, failed: str) -> list[tuple[str, list[str]]]:
    start = canon(failed)
    out, seen = [], {start}
    q = deque([(start, [start])])
    while q:
        node, path = q.popleft()
        for e in g.rev.get(node, []):
            if e.dst in seen:
                continue
            seen.add(e.dst)
            newpath = path + [e.dst]
            out.append((e.dst, newpath))
            q.append((e.dst, newpath))
return out结果不是一组排序后的文档,而是一组排序后的路径,每一条都是你可以阅读和检查的因果链。
token cache   via redis <- token cache
auth service  via redis <- token cache <- auth service
login flow    via redis <- token cache <- auth service <- login flow
存活:billing, platform team, postgresql, user database三个东西会坏,四个东西会存活,而图可以同时说出这两组。文本块检索器完全无法生成“存活”列表,因为语料库里没有任何地方直接写了这件事。它只存在于结构里。
09. 带引用地组装子图
最后一步交给模型的不是一堵文本墙,而是一张子图。答案路径上的节点、连接它们的边,以及每条边背后的文本块 ID,会一起进入上下文窗口。模型的任务从“在这一堆东西里找答案”缩小成了“读这条链,然后把它表达出来”。
这种缩小才是真正的收益。你已经把困难部分,也就是连接分散事实,从提示词里移出来,放进了一个你自己构建并能检查的结构里。模型不再猜测连接,而是阅读连接。
图真正回答了什么
我用八个单事实文本块构建了图,在同一个问题上同时运行文本块检索器和图遍历,并打印了两边结果。
把第一个输出块和最后一个输出块对照看。文本块检索器返回的是包含 Redis 这个词的句子,而那个句子不包含答案。图返回的是从 login flow 一路到 Redis 的链条,每一跳都有引用,而且两个来源一致的那条边权重为 2。同一个语料库,一个检索器找到了词,另一个找到了答案。
结语:RAG 检索的是提到答案的内容,图检索的是答案本身
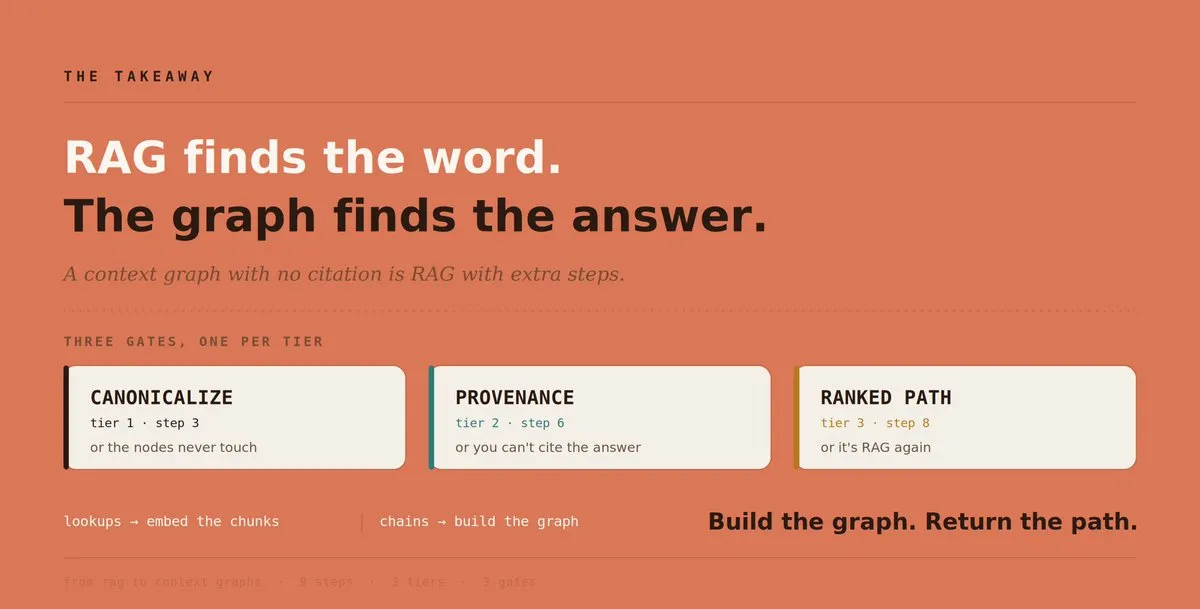
九个步骤,三层结构,三道关卡。
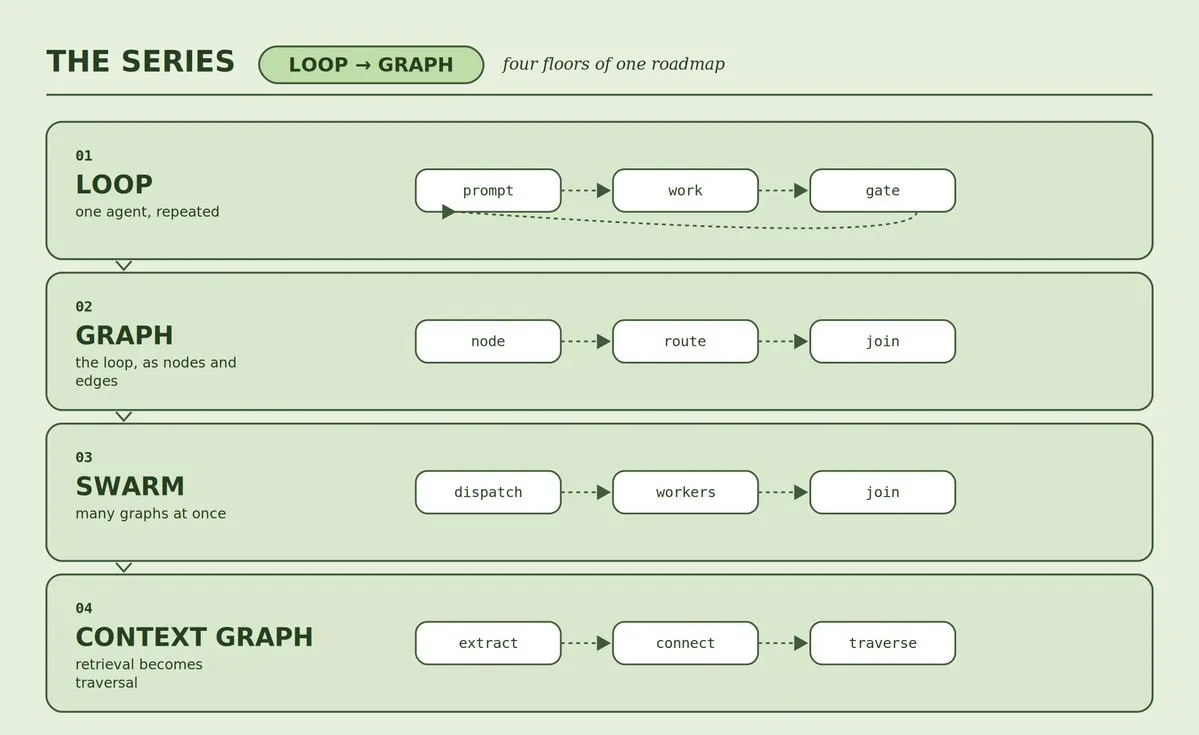
第一层把自然语言文本转成实体和关系,并让它们对齐。第二层把它们连接成一张带权重、可引用的图。第三层不再测量相似度,而是沿图行走来检索,并返回你可以阅读和验证的路径。
注意这些关卡的位置。规范化结束第一层,来源追踪结束第二层,排序路径结束第三层。这和循环、图、智能体群体是同一种形状,原因也一样。没有引用的上下文图,只是多绕了几步的 RAG。
- 过去两年,检索领域一直在推销更好的嵌入向量:更大的模型、更长的上下文、更聪明的分块。这些工作有天花板,而天花板不是嵌入向量质量。问题在于,一个文本块只能告诉你它自己说了什么,而多跳答案永远不在任何单个文本块里。结构性缺口无法靠相似度补上。
但诚实的说法不是每个人都应该构建图。大多数检索都是单跳的;对单跳查找来说,RAG 更简单、更便宜,而且是正确的。测试就在第 1 步:你最难的问题到底是查找,还是链条?如果是查找,就给文本块做嵌入向量,然后继续往前走。如果是链条,你已经在问图的问题了,只是你还没有把图建出来。
- 如果你通过了这个测试,就从小处开始。一个关系类型,一张规范实体表,一种遍历。先让“什么依赖 X”返回一条带引用的路径,再加入第二种边类型。顺序很重要:抽取喂给连接,连接喂给遍历,而在未规范化节点上做遍历,什么都不会返回。
重点从来不是更好地搜索文本,而是检索结构,而不是检索自然语言文本。构建图,返回路径。
