
大家好,我是老袁。
在之前的文章中,我们分别探索了未来的写作模式、如何AI写PRD,本次我们重点探索下如何将PRD生成HTML可交互文件。之前文章链接如下:
本篇正文如下:
将一大段 PRD 交给 AI,一次生成完整 HTML,看起来可以省去大量原型制作工作。
页面数量增加后,结果会很快变得难以掌控。字段可能遗漏,页面风格可能漂移,跳转关系也可能断裂。等到 HTML 生成完再发现这些问题,修改对象已经变成了整个页面。
后续 PRD 再次调整,产品经理很难立即判断变更会影响哪些页面、公共样式和跨页交互,只能对整份 HTML 进行全量排查。
生成速度只缩短了第一版的制作时间;能否定位变更、控制影响和逐项验收,决定了后续迭代的成本。
我多次调试制作了 prd-html skill,目标就是为长 PRD 到 HTML 原型之间建立一条可拆分、可检查、可追溯的路径。
方法基础:以 Markdown 统一需求源
我为这个 skill 确立了一条基础规则:
Markdown 是需求的唯一事实源,HTML 是根据 Markdown 生成的交互产物。
需求发生变化时,先更新 Markdown,再根据影响范围更新 HTML。这样可以将需求修改的入口收敛到一处,避免 PRD 和原型各自维护一套逻辑。
一大段原始 PRD 仍然不适合直接作为多页生成输入。它需要先被拆成 AI 能稳定加载、用户能提前评审的页面单元。
我借鉴了 GitHub Spec Kit 的 spec-driven 思路。GitHub 官方文档采用 Spec → Plan → Tasks → Implement 的分阶段过程,让意图通过结构化产物进入实现。
原型阶段不需要搬入 git 分支、特性编号、API 合约和完整测试用例。我只保留了一条适合原型生成的思路:先确认需求结构,再生成页面。
AI 生成的可控性,来自输入被拆成了可评审的单元,也来自每个单元都有明确边界。
执行流程:从需求拆解到单文件交付
prd-html 从开工到交付共分为 7 个阶段。PRD → spec 骨架 → 公共资产 → 逐页生成 → 逐页验收 → 整体验收 → 单文件交付
阶段 0:确认生成目录
原型生成位置必须由用户指定。目录未确认,流程不启动。
阶段 1:设计规范选型与 spec 骨架建立
skill 先读取设计规范清单,列出可选风格和建议,等待用户确认。
随后,将长 PRD 拆成三类中间产物:
spec/_导航地图.md:记录页面清单、跳转关系和优先级。
spec/_公共规范.md:记录项目的色板、字体、间距、布局和组件规则。
spec/XX-页面名.md:记录单页的信息结构、字段、交互和状态。页面边界、字段和跳转关系会先以文字形式经过确认,再进入 HTML 生成。
阶段 2:生成公共资产
skill 先生成 style.css 和 mock-data.js。样式从统一文件中读取,mock 数据也集中管理,为后续调整保留清晰入口。
阶段 3:分批生成和逐页验收
每批只生成 1—2 个页面。生成单页时,AI 只加载公共规范、当前页 spec 和导航地图。
页面写完后立即截图回看,检查页面是否能打开、布局是否正确、跳转是否有效、交互状态是否齐全。
阶段 4:生成统一入口与交付说明
全部页面完成后,skill 生成 index.html 作为统一入口,同时用 README 记录打开方式和页面清单。
阶段 5:整体流程验收与增量修改
用户从 index.html 进入,完整走查主业务流程,集中检查跨页断链、入口与返回、全站风格一致性。
当需求变更时,skill 先判定影响范围。单页字段或文案变更,只更新对应页面;公共规范、导航地图或跨页数据结构变更,先列出受影响页面,再执行全局更新。
阶段 6:单文件打包与交付
分页验收和整体验收通过后,skill 将页面、样式、脚本、mock 数据和本地资源打包进一个 HTML 文件,便于离线演示、下发和归档。
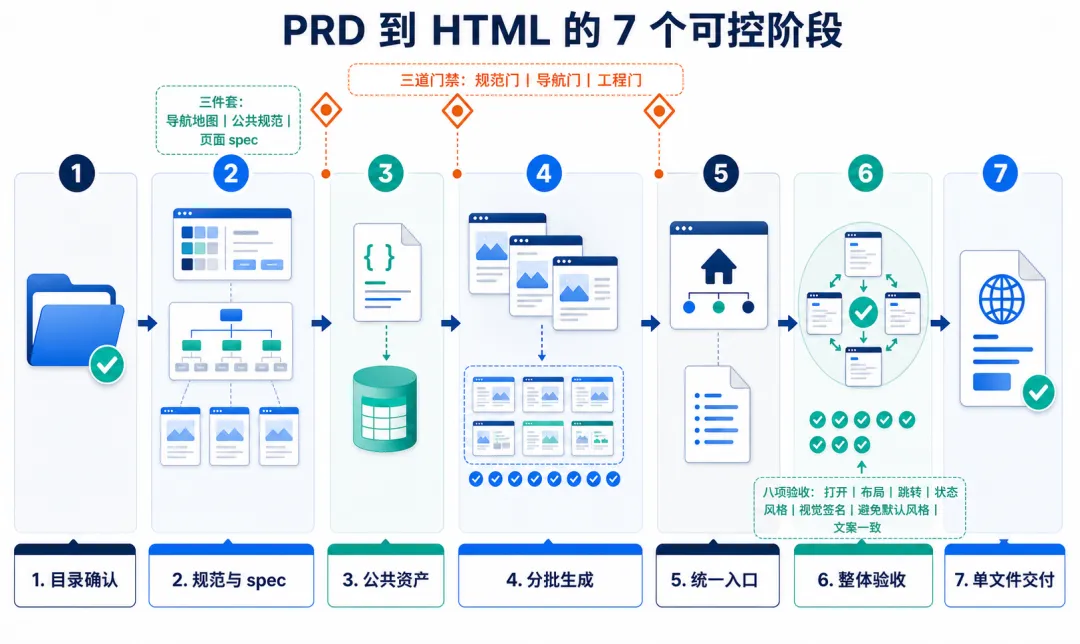
流程的价值体现在每一个阶段都有明确输入、可见产物和通过条件,问题因此能够被定位在具体环节。
扩展机制:将设计规范沉淀为可复用资产
后台系统、移动 APP、内部工具和面向客户的业务系统,布局、导航、组件和视觉基调存在明显差异。固定一套页面风格,会将 skill 的使用范围限定在单一类型项目中。
我将设计规范拆成了独立的 design-specs/ 模块。
目前已有后台通用和 APP 通用规范。后续遇到新项目,可以根据截图、设计文档或文字描述生成新规范,再登记到 design-specs/index.md 中。
每个项目的公共规范由三部分拼装:
通用 token 骨架 + 选定的类型规范 + 项目色板 = 项目专属公共规范
新增一套风格时,不需要复制整个 skill,也不需要修改生成流程。规范库会随项目持续扩展,已经验证的系统风格也可以在新项目中直接复用。
执行流程保持稳定,设计规范持续增长;两类内容分开管理,skill 才能长期适配不同项目。
质量控制:从测试暴露到门禁收紧
初版 skill 进入测试后,执行者没有询问用户选哪套设计规范。它根据需求描述或截图,自动选择了“后台-通用”或“APP-通用”。
我回头检查规则,发现其中留了“用户未选时可以兜底”。执行者按照现有规则,选择了路径更短的做法。
经过连续几次追问,我删掉了自动命中和兜底表述,将规则收紧为“每次必问”。同时在生成前增加规范门,二次检查用户是否已经确认。
另一个测试问题是生成目录。执行者曾经直接选择目录开始输出。修改后,目录确认成为第 0 步。
这一轮测试最终形成了一组完整的质量控制机制:三件套组织输入,三道门禁控制开工,八项验收检查结果。
三件套是导航地图、公共规范和页面 spec。
三道门禁分别检查设计规范是否经用户确认、页面跳转是否已经登记、工程中是否引入了多余框架。
八项验收包括:能打开、布局对、跳转通、状态齐、风格统一、体现视觉签名、避免没有项目依据的 AI 默认风格、文案基调一致。
一个 skill 的质量,可以从它拦住了多少次未经用户确认的决定中看出来。
PRD 转 HTML 的可控度 = 明确的中间产物 + 生成前门禁 + 生成后验收
使用边界:适用项目与限制条件
这套方法适合多页、需要反复迭代的体验级原型。尤其适合需要保留需求决策记录,又需要用浏览器直接演示的项目。
单页、一次性演示可以直接生成 HTML,无需引入完整 spec 流程。
这个 skill 也不承担像素级还原、复杂动效和生产级前端开发。交付流程强制使用 Axure 等特定格式时,也需要先评估 HTML 原型能否进入现有评审流程。
方法的价值取决于它解决的项目复杂度;单页演示追求直接,多页迭代需要结构和约束。
结语:
在打磨 prd-html 的过程中,我的关注点逐渐从“AI 能否生成 HTML”转向了整个流程的可控性。
生成前要能看见 AI 对需求的理解,生成后要有可执行的验收标准,需求修改时还要能判定影响范围。可重复执行的能力,建立在清晰输入、显式边界和可验收结果之上。
这个 skill 已经开源了,地址在这:
👉 https://github.com/wenhui426/prd-html-skill
如果这套方法对你有参考价值,也可以转给正在尝试 AI 原型工具的产品朋友。
