
智能体之所以有用,是因为它们能通过在真实世界中采取行动,帮我们自动化完成工作。但要让智能体稳定地做出有价值的工作,只靠好模型还不够:还需要一个精心设计、适配一组任务的harness 。
核心智能体算法很简单:给 LLM 上下文,让它循环调用工具,直到任务完成。这是最基础的循环。但驱动智能体的循环远不止这一种。@swyx 最近写了一篇很好的文章,讲的是 "loopcraft: the art of stacking loops",也就是通过堆叠和扩展循环来构建更有效的智能体。
下面是我们如何理解这套堆叠结构,以及如何用 LangChain 的基础组件对每一层进行工具化。
循环 1:智能体
最核心的智能体,就是一个模型不断调用工具,直到任务完成。
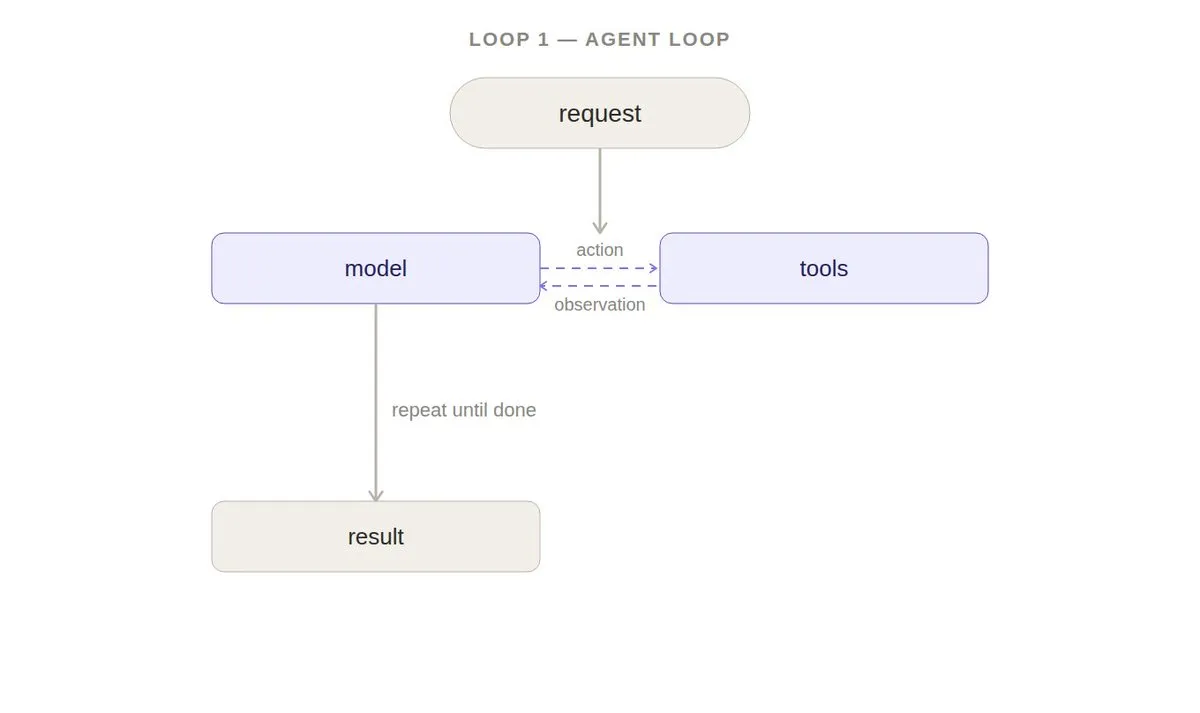
这正是 LangChain 的 create_agent 提供的能力。选择任意模型,接入工具,你就有了一个可以工作的智能体循环。工具让智能体拥有在真实世界中采取行动的能力。
以我们的内部文档智能体为例,后文会继续用它作为示例。在第一层循环里,它会收到一条文档改进请求,模型规划并起草修改,然后使用工具克隆仓库、读取文件、写文档、打开 PR,等等。
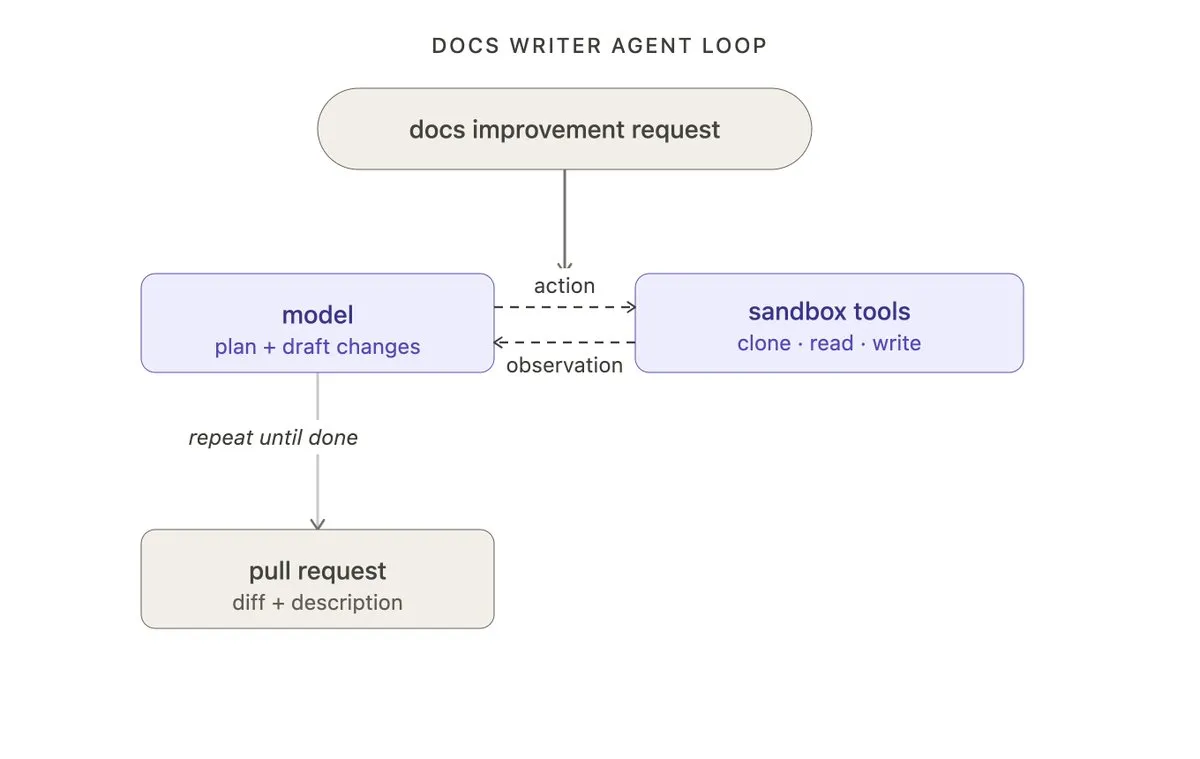
第 2 层:验证循环
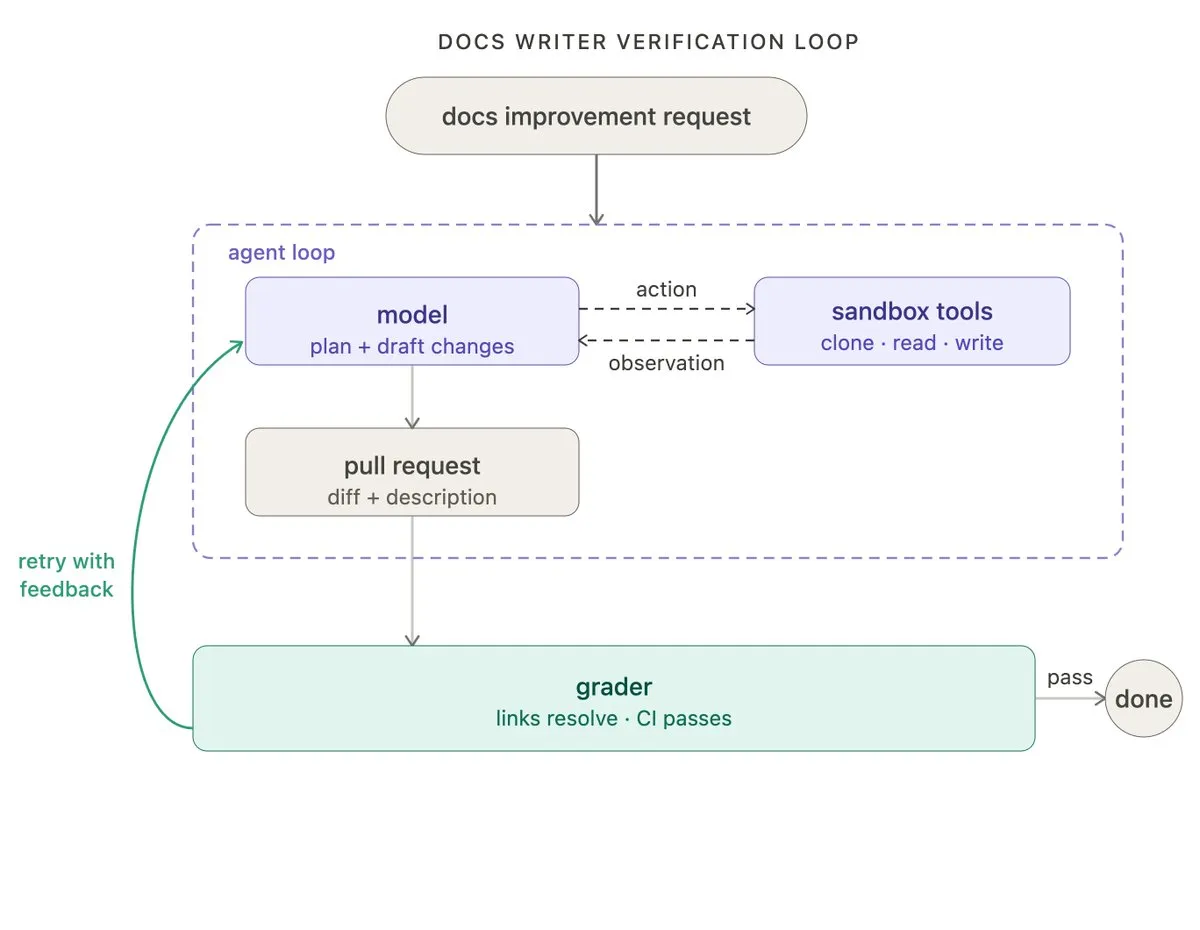
智能体循环能把工作做起来,但它第一次生成的结果不一定正确,也不一定稳定。当一致性很重要时,通常值得在外面包一层验证循环,用来检查输出;如果输出不达标,就把反馈送回模型。
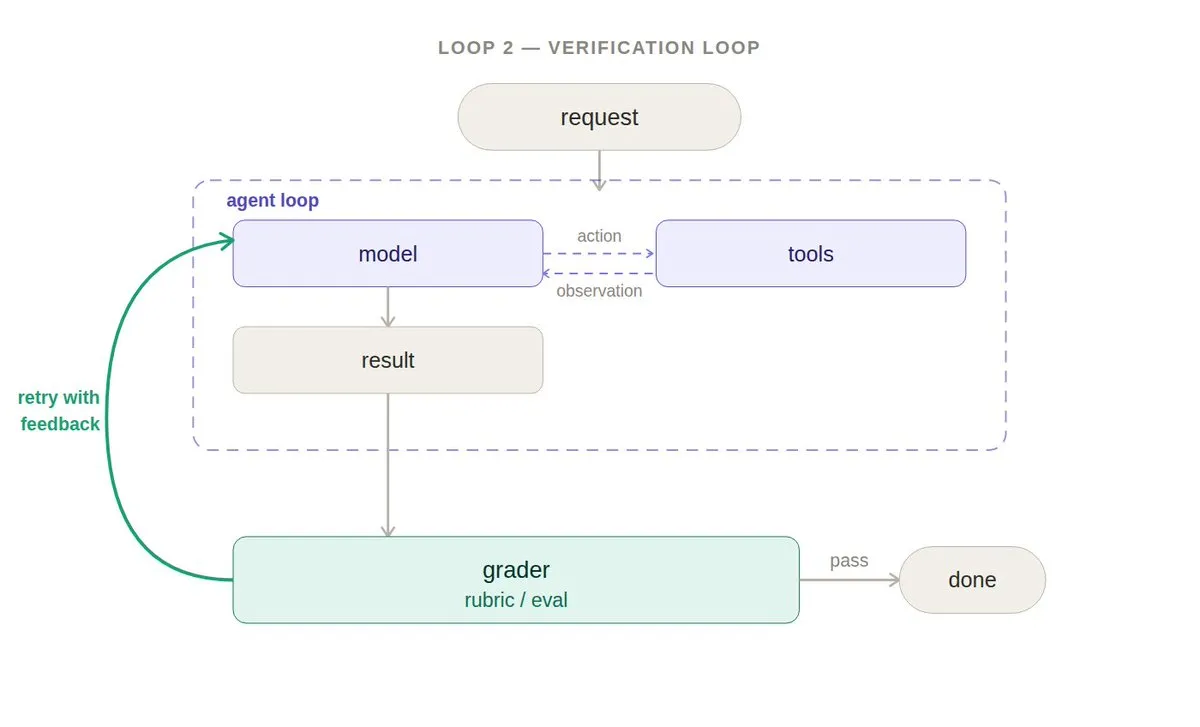
验证循环会加入一个评分器:它根据评分规则检查智能体输出;如果失败,就把结果和反馈一起送回去。评分器可以是确定性的,也可以是智能体式的,这里经典例子就是用 LLM 充当评审。
RubricMiddleware 可以处理这种模式,你也可以在 create_agent 上用 after_agent 钩子把它接起来。
回到文档写作智能体的例子,评分器会在每次尝试后运行测试,检查所有链接是否可访问、所有 CI 检查是否通过,以及变更范围是否限定在实际请求的内容内。无需人工审查,就能抓住这几类错误。
一个取舍是:加入验证会提高每次运行的延迟和成本。当质量比速度更重要时,它就值得,这也覆盖了大多数生产场景。
第 3 层:事件驱动循环
智能体开发中最重要的部分之一,是集成层:把智能体连接到你的生态系统,让它能在后台运行。
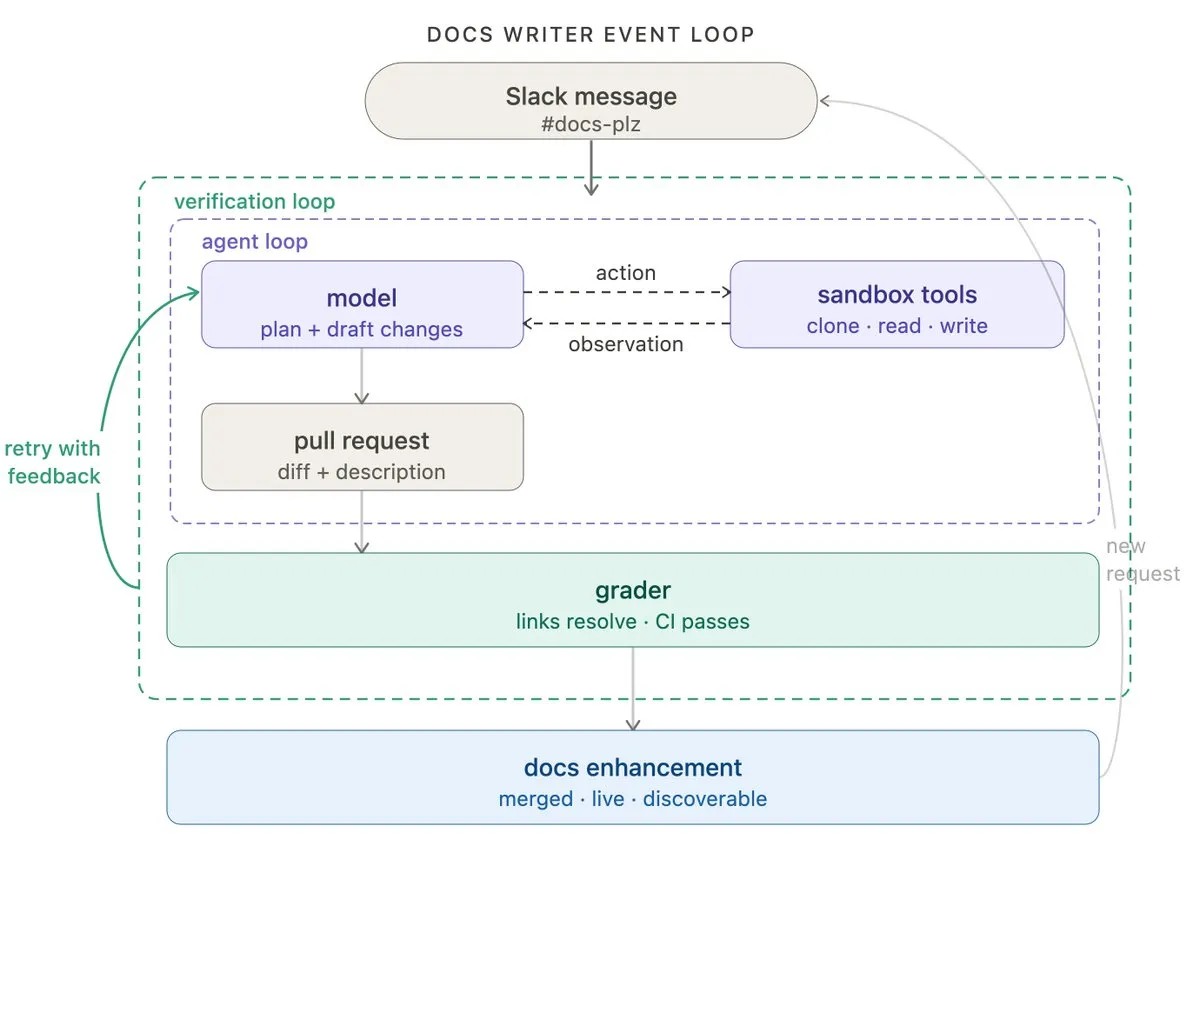
事件驱动循环会把智能体接入你的生态系统。某个事件触发,比如新文档进入系统、定时任务触发、webhook 到达,然后智能体开始运行。智能体不再是你手动调用的东西,而是更大系统里持续运行的组件。
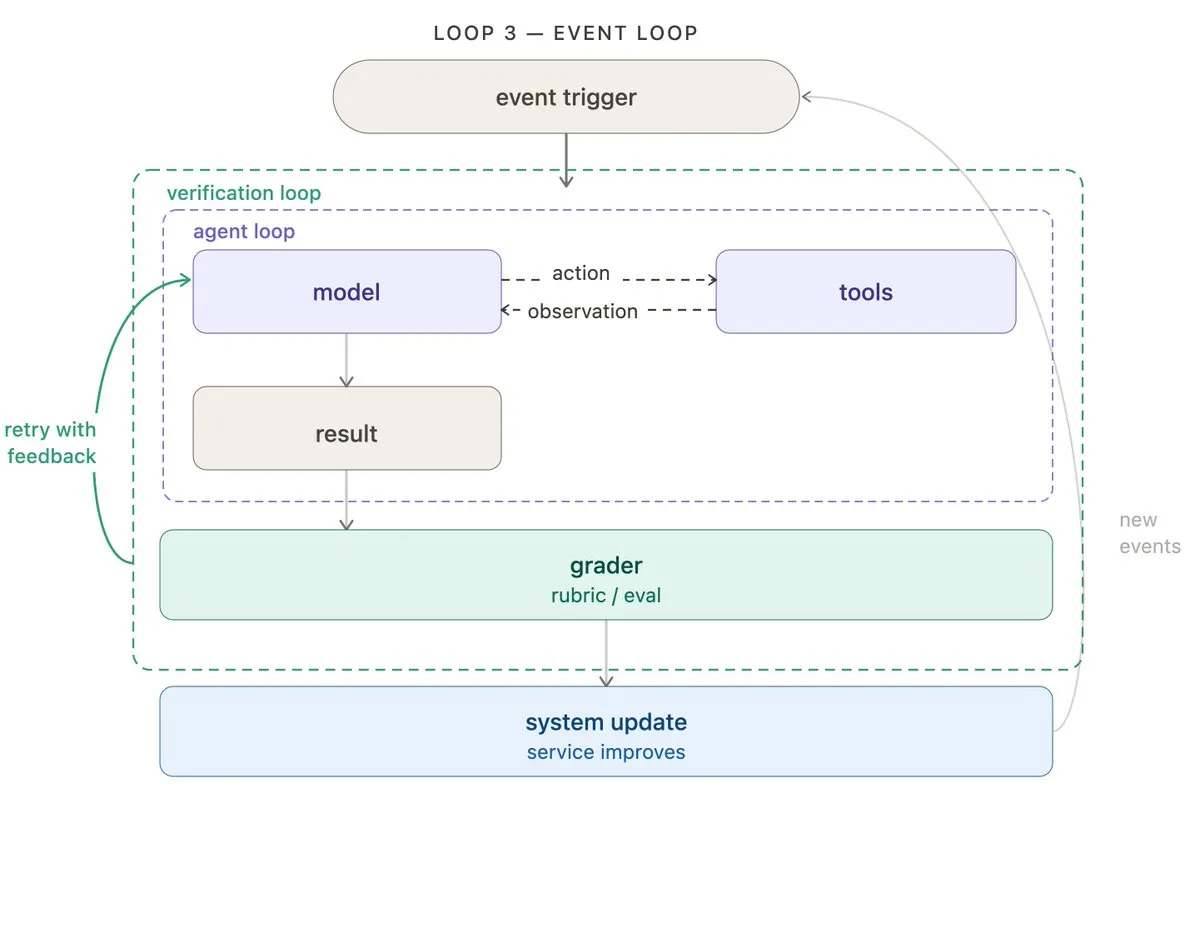
支持触发基础设施,包括 cron 定时任务和 webhook。cron 的一个常见例子,是 openclaw 里的“心跳”,它会把你的智能体变成一个始终在线、主动工作的助手。
我们的文档智能体由 Fleet 驱动,这是我们的无代码智能体构建器。Fleet 的 channels 和 schedules 负责处理事件驱动和 cron 风格的触发。我们用一个通道,在有人向 Slack 的 #docs-plz 频道发送消息时触发文档智能体。
第 4 层:爬山式改进循环
前三种循环是在自动化工作。第四种,也可以说最重要的一种,是在自动化改进。
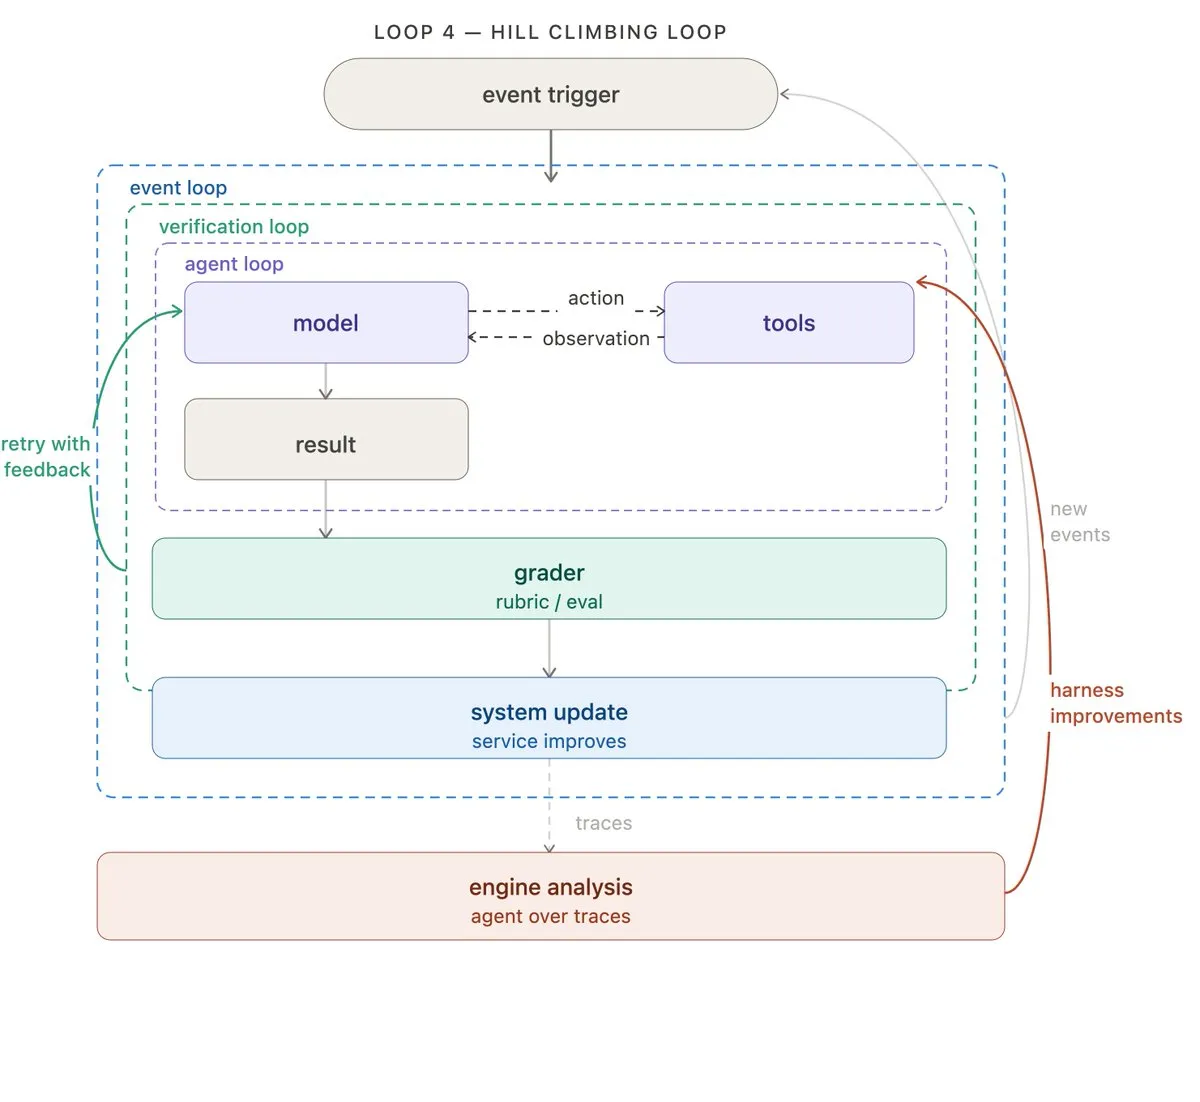
每次智能体运行都会产生一条轨迹:模型做了什么、调用了哪些工具、评分器反馈是什么,等等。这些轨迹包含高价值信号,能说明什么有效、什么无效。爬山式改进循环会让一个分析智能体读取这些轨迹,并根据分析结果重写harness ,生成更好的配置。这可以包括提示词、工具或评分器的调整。
在 LangSmith 里,你可以用 Engine 对第四种循环进行工具化。Engine 是我们的轨迹分析智能体。
继续用文档智能体作类比,我们会让 Engine 读取文档智能体的轨迹来发现问题。当多条轨迹都指向某个潜在问题时,系统会创建一个 Issue,请求修改出问题的提示词或工具。
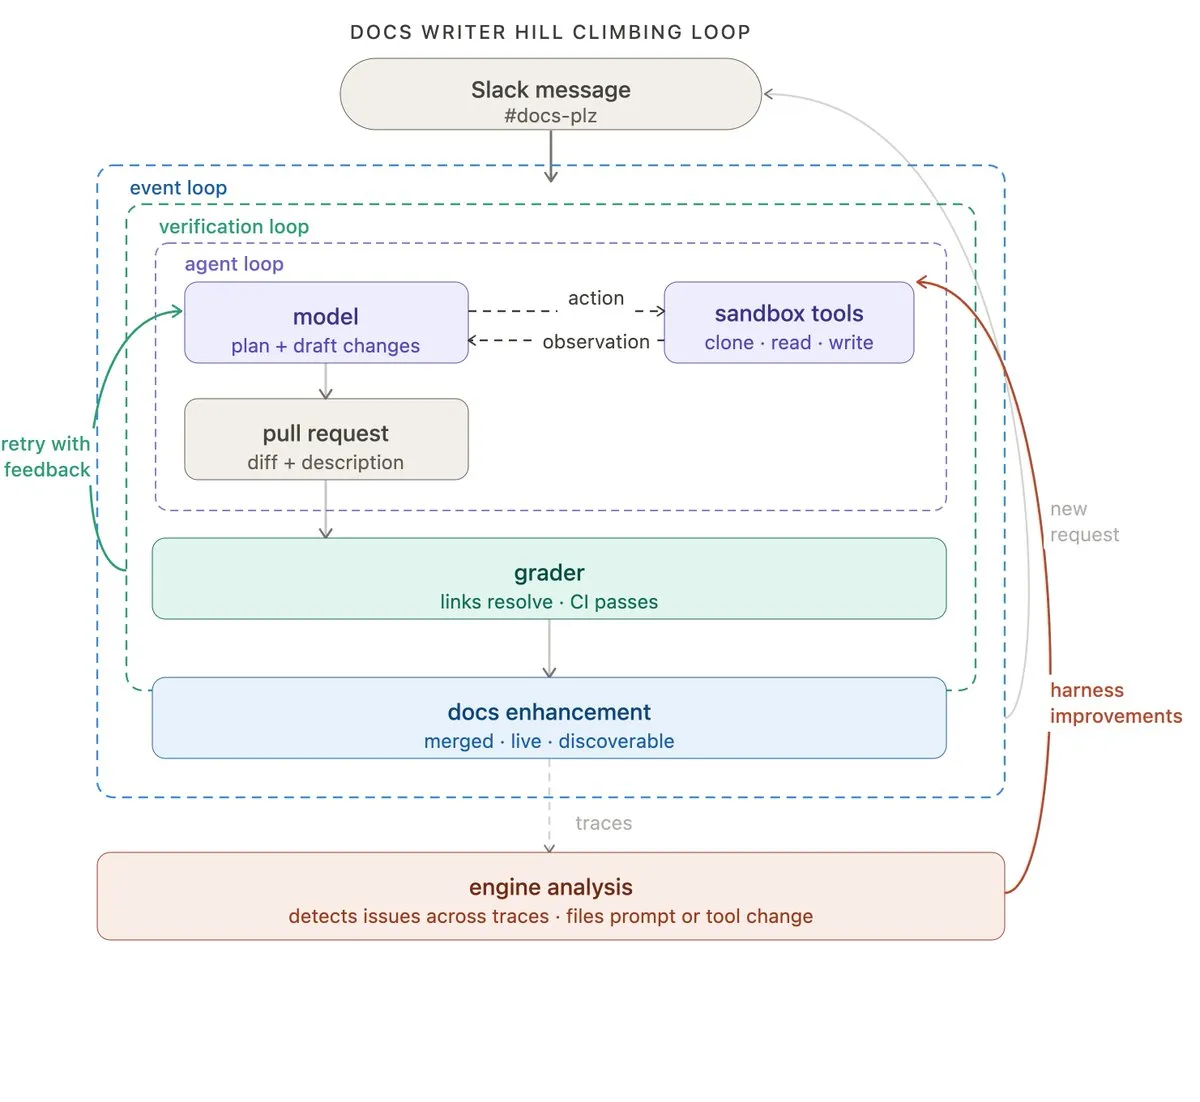
这里的关键动作是:回流箭头不只是回到最上面,而是伸进内部,直接更新智能体循环。外层循环每转一轮,都会让内层循环更有效。
向前看: 提示词和工具配置是最简单的改进对象,但不是唯一选择。对于运行开源权重模型的团队,爬山式改进循环可以接入 RL 微调,用轨迹或评测结果作为训练信号来改进模型本身。记忆、检索到的 Skill 这类辅助上下文,也可以用同样方式改进。循环是模式;它具体优化什么,由你决定。
人类监督与专业判断
自动化并不意味着把人从循环中移除。在每一层里,都有一些自然位置适合加入人类监督。自动评分器可以检查链接是否可访问;但判断表达框架是否适合目标受众,仍然需要人。那种来自上下文、经验和品味的判断,正是人工审查应该存在的位置。
有些专业知识应该被编码进提示词和工具本身,但对于敏感操作,实时人工审查至关重要,比如金融交易、数据库操作等。LangChain 可以很直接地在每一层循环里工具化这些接触点:
- 在智能体循环里,敏感操作或工具调用前要求人工输入
- 在验证循环里,让人类作为敏感工作流的评分器
- 在应用循环里,输出返回给最终用户前由人类批准
- 在爬山式改进循环里,harness 改动先经过人工审查再部署
LangChain 的所有开源框架,都把添加“人在回路中”作为一等基础组件。
把它们放在一起
如果你更喜欢表格视图,下面是这四种循环如何堆叠在一起:
| 循环 | 作用 | 影响 | LangChain 基础组件 |
|---|---|---|---|
| 1:智能体循环(模型 + 工具) | 模型反复调用工具,直到任务完成 | 自动化工作 | create_agent,任意 LangChain 支持的模型 |
| 2:验证循环(智能体 + 评分器) | 智能体运行,输出根据评分规则打分;如果失败,带着反馈重试 | 保证质量 | RubricMiddleware |
| 3:事件循环(验证 + 系统) | 事件触发智能体运行,并更新真实系统 | 规模化工作 | LangSmith Deployment / Fleet channels |
| 4:爬山式改进循环(系统 + 引擎) | 生产轨迹送入分析智能体,用来改进harness 配置 | 持续改进 | LangSmith Engine |
这就是循环工程,或者按 @swyx 的说法是 loopcraft,在实践中的样子。像 Steipete、Boris、Andrej 这样的 AI 领域领导者,都得出了同一个判断:智能体的潜力,在于你围绕它构建的循环。
我们已经思考循环 1 和循环 2 很久了。但重心应该转向循环 3 和循环 4:当智能体嵌入你的生态系统,并持续根据你的标准改进时,价值才会复利增长。
Satya 把这个问题放到组织层面来描述:那些更早构建学习循环的公司,也就是让人类判断和 token 资本共同复利的公司,会建立起难以复制的优势。
致谢
感谢 @Vtrivedy10、@masondrxy、@hwchase17 和 @huntlovell 的细致审阅。
参考资料
- deepagents 快速开始
- create_agent 文档
- RubricMiddleware
- cron jobs、webhooks
- LangSmith Engine
- Fleet channels
📎 原文信息
原帖链接:https://x.com/sydneyrunkle/status/2066928783534289358
