
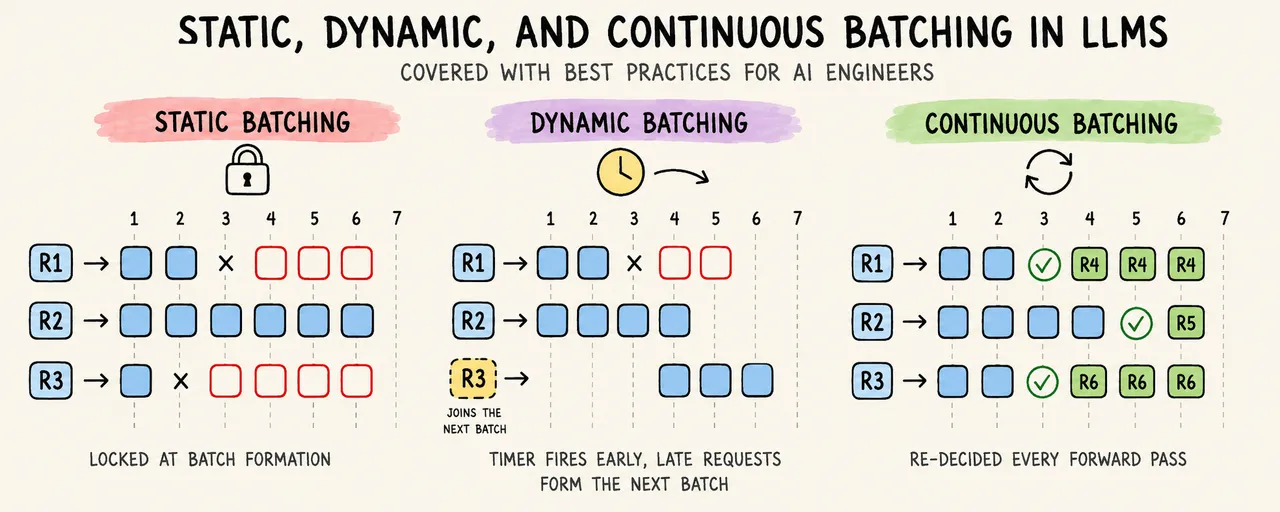
这篇文章可以帮你理解为何你的 GPU 在负载下闲置,以及哪种批处理策略能解决此问题。三种策略从基本原理出发,各自的缺陷,分块预填充,以及如何针对你的工作负载进行选择。
现代 GPU 每秒能运行数万亿次浮点运算。在其上运行一个 LLM,你常常会看到它仅利用了一小部分计算能力。
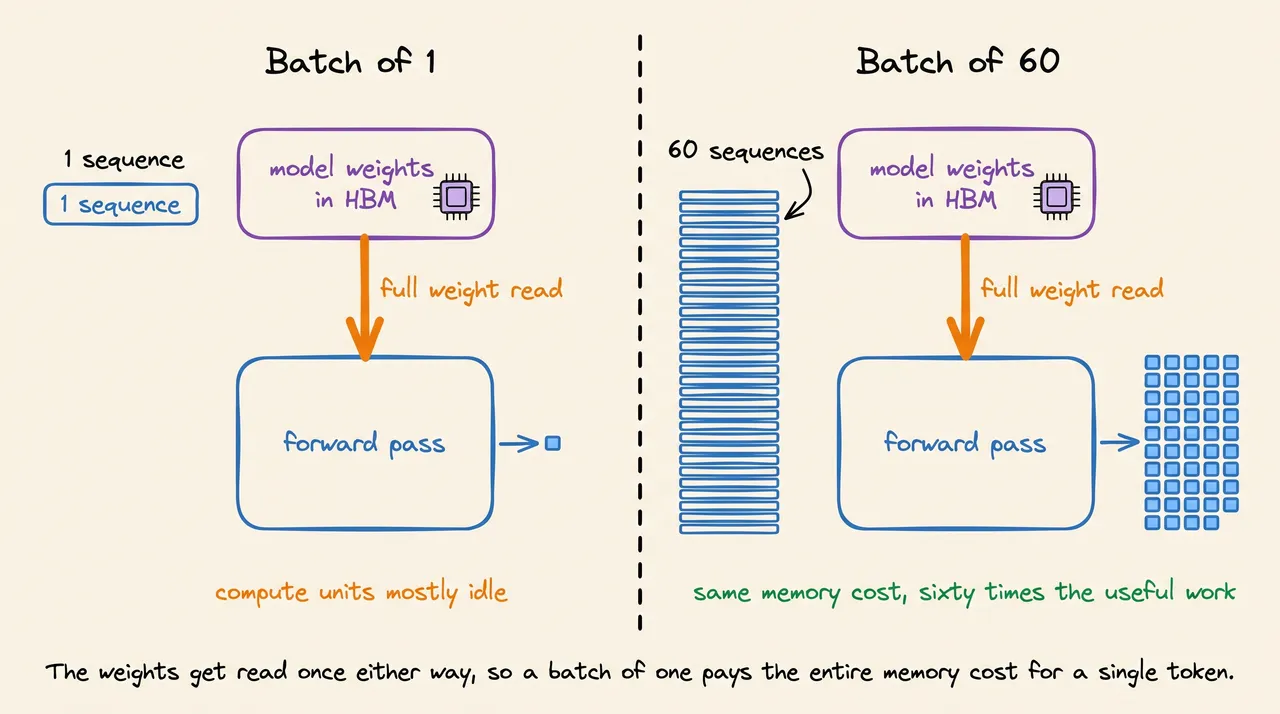
原因是生成单个 token 意味着要从内存中读取模型中的每个权重。这一读取过程占用了大部分时间,计算单元大部分时间都在等待。
批处理弥补了这一差距。权重只加载一次,将多个序列推入同一次前向传播,内存成本便分摊到所有序列上。
每个推理引擎都这么做。它们的区别在于何时决定批处理。
- 静态批处理在批次开始前决定一次
- 动态批处理按计时器决定
- 连续批处理在每次前向传播时再次决定
最后一种策略是现代推理中几乎所有吞吐量的来源。前两种值得先理解,因为每一种的缺陷正是下一种要修复的。
今天我们将逐一深入分析和理解它们。
让我们开始吧!🚀
批处理存在的原因(Why batching exists)
A100 每秒大约能进行 312 太浮点运算的 BF16 数学运算,并从内存中每秒移动约 2 太字节数据。解码完全依赖于第二个数字。
读取权重是主要成本,计算单元空闲等待。这种空闲计算是免费容量,因此一个 60 条序列的批次与单条序列的批次读取相同权重,吞吐量提升而内存读取时间保持不变。
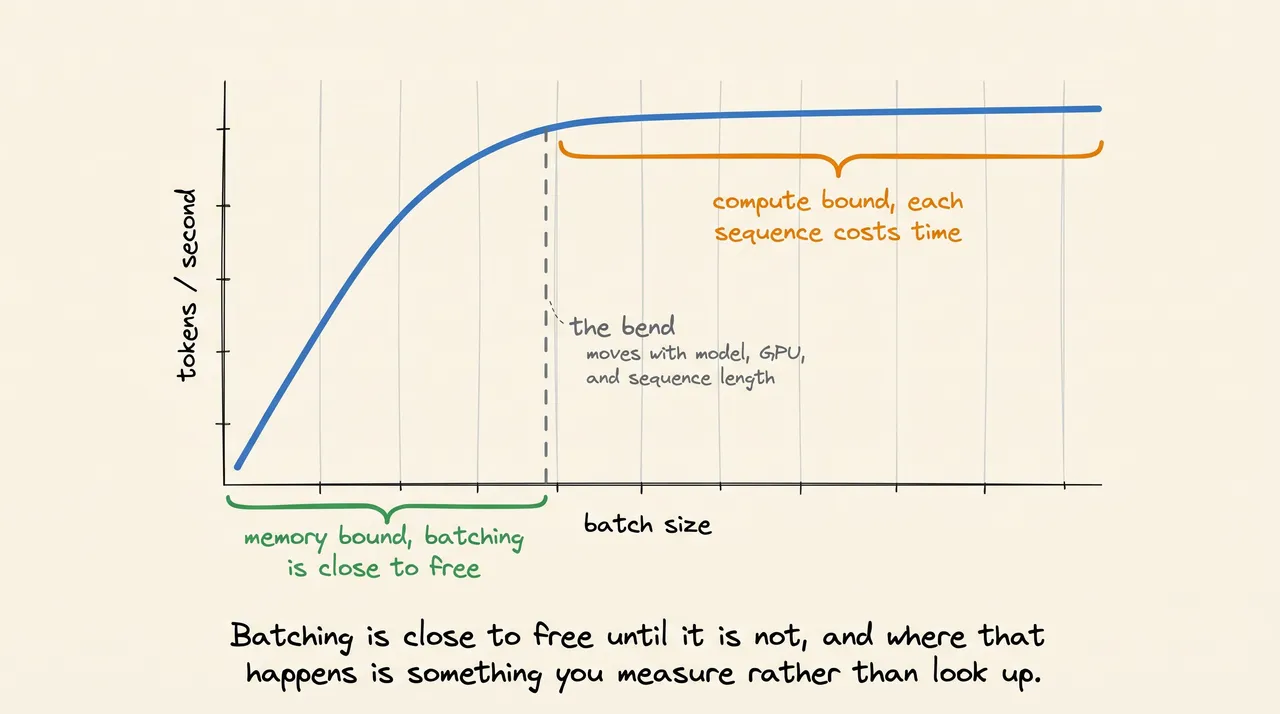
注意,吞吐量随批次大小急剧上升,然后趋于平缓。
- 在拐点以下,你处于内存受限状态,批处理几乎免费
- 在拐点以上,你处于计算受限状态,每增加一条序列都会耗费时间
拐点随模型、GPU 和序列长度而变化,因此请在你的硬件上测量。
现在,你可能在想:如果批处理这么有效,为什么不尽可能多地批处理呢?
嗯,对于 LLM 来说,这比听起来更难。让我们理解原因。
LLM 面临的挑战(What breaks for LLMs)
批处理比 LLM 出现得更早。对于分类器或嵌入模型,它是一个打包问题。
将输入填充到共同长度,堆叠成一个张量,运行一次前向传播。
这之所以有效,是因为三个条件成立。一次前向传播产生完整答案,行之间不相互依赖,且每行的成本在开始前已知。
这对于自回归 LLM 并不适用。
解码打破了这三个条件。
- 一次前向传播产生一个 token,而不是答案。 一个 400 个 token 的回答需要 400 次前向传播。
- 行依赖于自身的历史。 每次前向传播都会写入该请求的 KV 缓存,而下次前向传播会读取它。
- 成本在结束前未知。 模型通过发出停止 token 来决定,这可能在 12 个 token 后或 4000 个 token 后发生。
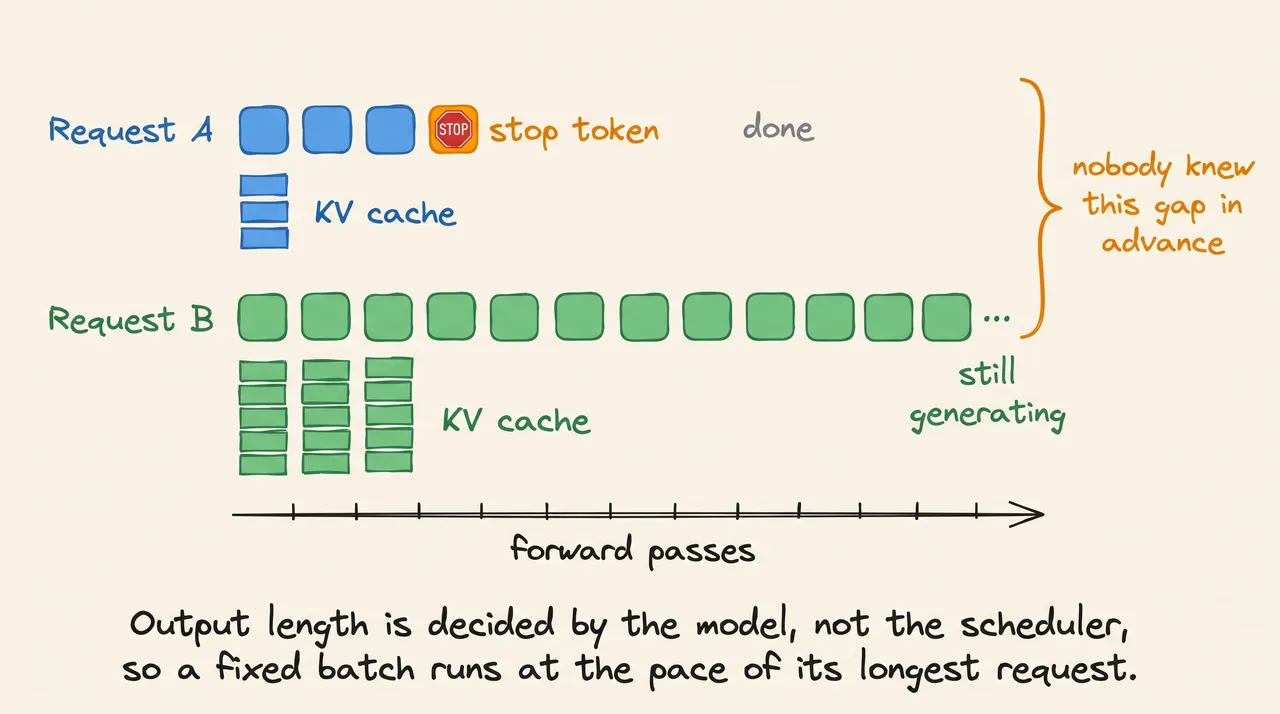
填充并不能解决这个问题。它只均衡输入宽度,而不是请求占用 GPU 的时间长度。
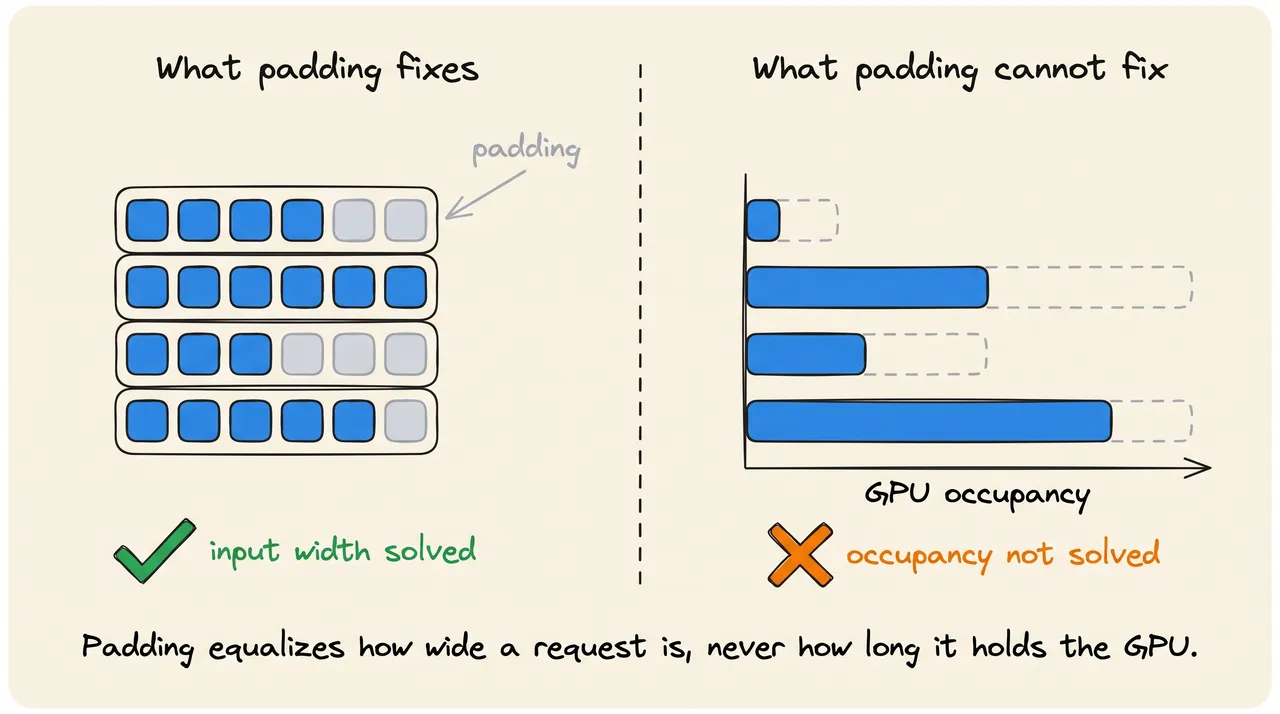
因此,开始时固定的批次以最慢成员的速度运行。三种策略是对此的三种答案,按它们对此采取行动的程度递增排列。
静态批处理(Static batching)
最简单的答案对此不做任何处理。收集固定数量的请求,一起运行,当最后一个完成时返回所有结果。
最终状态如下:
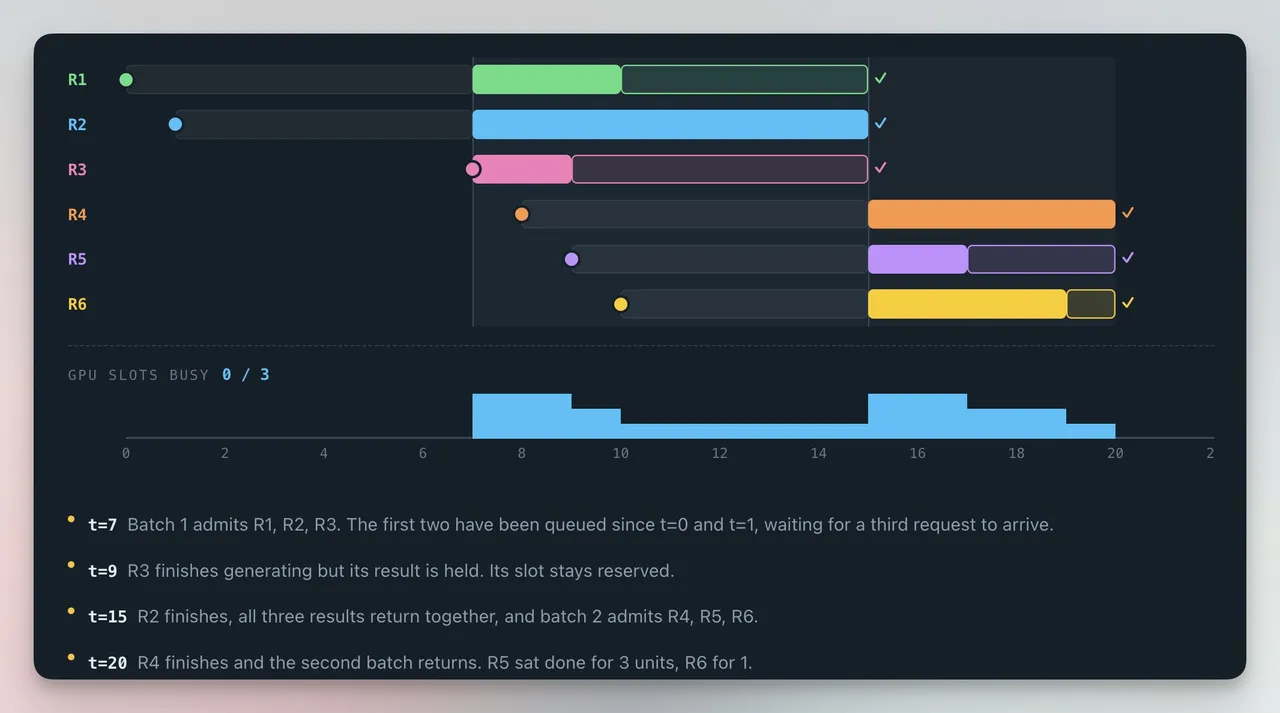
R3 在 t=9 时停止生成,但在 GPU 上占用直到 t=15,因为 R2 仍在运行。这让你付出双重代价:
- 用户答案已生成但多等待了 6 个时间单位
- 一个本可被排队请求使用的槽位被占用
浪费随输出方差增大而增加。 Anyscale 在 40GB A100 上对 OPT-13B 测量了这一点。扩大输出长度的差异使静态批处理降至约每秒 81 个 token,而连续批处理保持了高一个数量级的吞吐量。
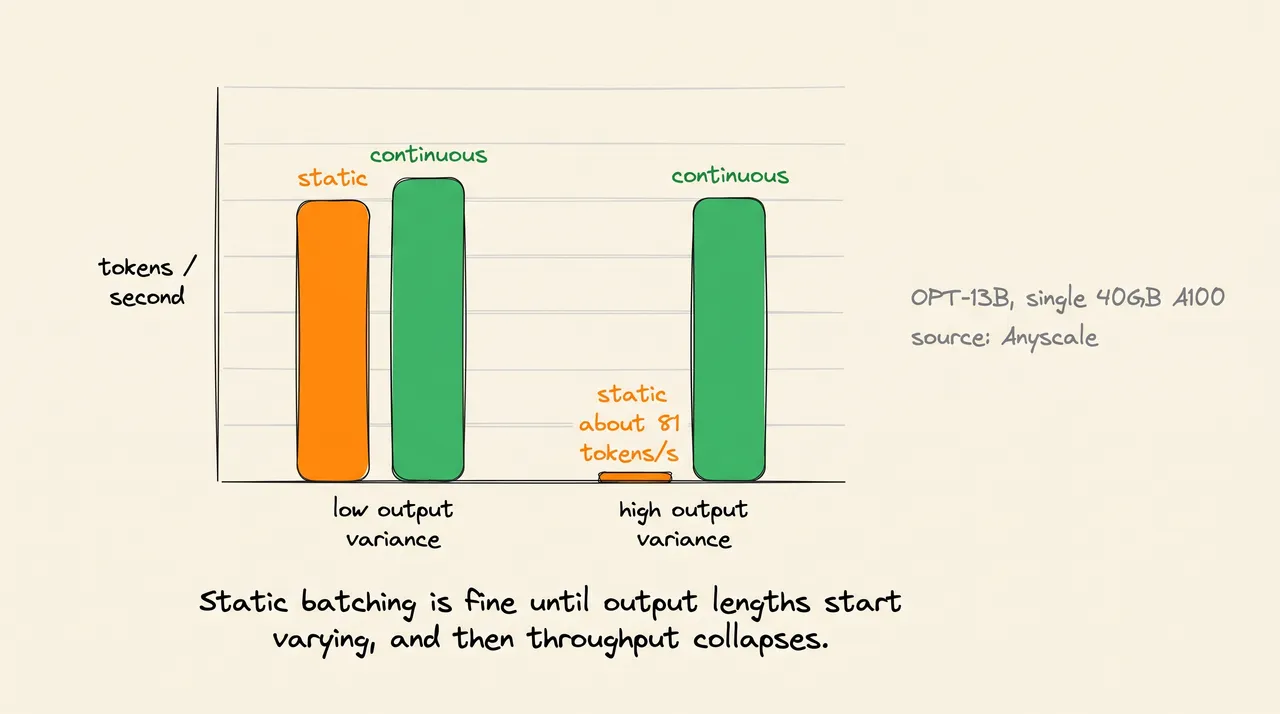
有时仍是正确的选择。 静态批处理仅在输出长度变化时看起来不好。去掉这一点,慢成员问题也随之消失。
分类、嵌入和打分正是如此。每种输出都是固定大小的,一个标签或一个向量,因此批次中的每个请求几乎在同一时刻完成,没有一个需要等待落后者。
对于这类工作,静态批处理更简单且不损失什么。
以下是在 vLLM 中配置静态批处理的方法:
from vllm import LLM, SamplingParams

llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct")
outputs = llm.generate(prompts, SamplingParams(max_tokens=64))
llm.generate 一次性将整个工作负载交给引擎。设置 max_tokens 上限,保持提示词大小相似,每个序列几乎在同一时刻完成。
👉 Hugging Face 的 pipeline API 中的 batch_size 参数也是静态批处理。适合评估脚本,但不适合实时流量。
Dynamic batching(动态批处理)
静态批处理还有第二个成本。一个请求可能要等很久才能进入批次。
如果批次大小为 8,但只有 5 个请求到达,那么这 5 个请求就会闲置,直到另外 3 个到来。
动态批处理增加了一个定时器。批次在达到大小限制或窗口过期时触发,以先到者为准。
最终状态如下:
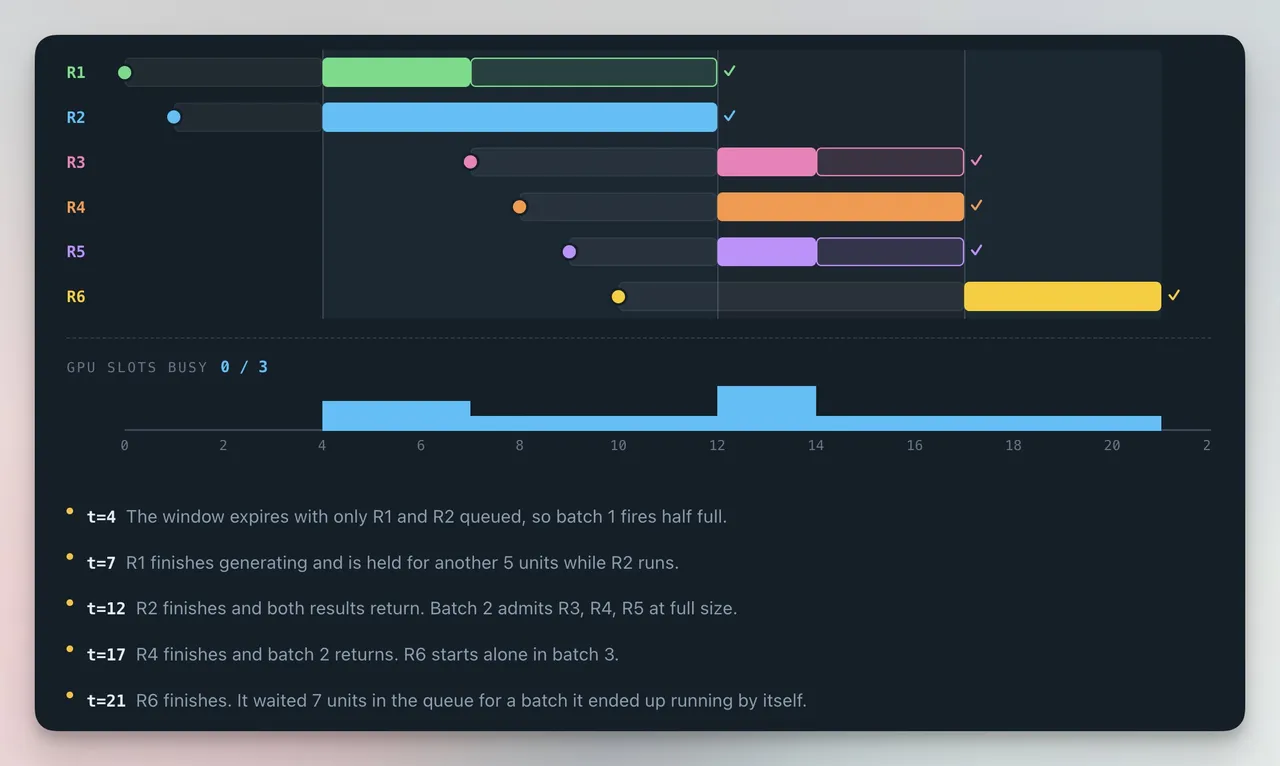
批次 1 在 t=4(固定间隔)时触发,只有 R1 和 R2,因为窗口在第三个请求到达之前已过期。两者都比静态批处理允许的时间提前四个单位开始。
它缩短了错误的等待时间。 R1 在 t=7 时完成,但仍要等到 t=12,因为 R2 还未完成。
动态批处理每个批次只做一次决策,然后将控制权交给引擎,直到所有成员完成。对于固定输出模型来说,这是一个完整的答案,这也是 Triton 提供它的原因。
dynamic_batching {
  preferred_batch_size: [ 4, 8 ]
  max_queue_delay_microseconds: 100
}
👉 preferred_batch_size 列出了调度器试图形成的批次大小。max_queue_delay_microseconds 限制了请求等待同伴的最长时间。
Continuous batching(连续批处理)
到目前为止,这两种策略都将批次视为一个工作单元,开始并运行直到批次中的所有请求完成。正是这个假设仍在让你付出代价,而连续批处理则放弃了这一假设。
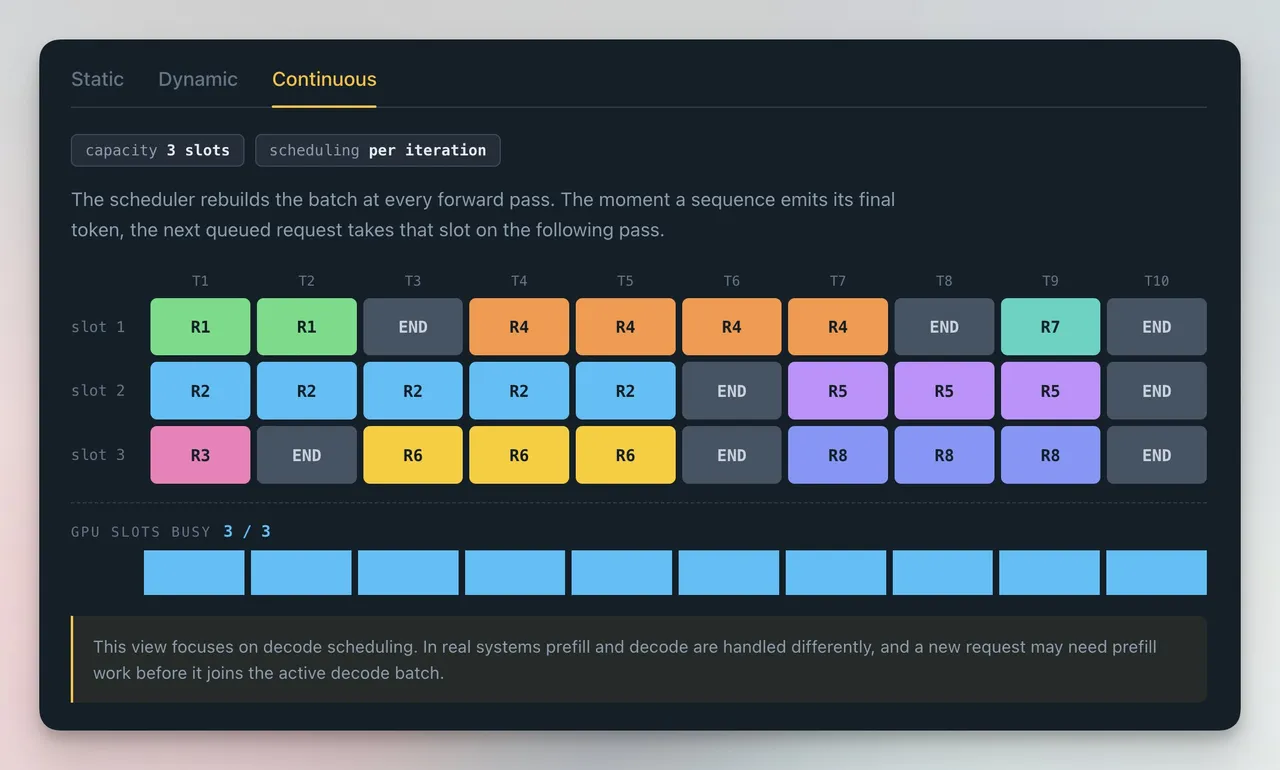
调度器运行一次迭代,收回控制权,然后再次做出决策。一旦序列发出最终 token,它就离开批次,等待中的请求会在下一轮中占据该槽位。
批次组成每轮迭代都在变化,这就是为什么它被称为迭代级调度。没有槽位会等待最慢的序列,因此即使输出长度差异很大,GPU 也能保持饱和。
最终状态如下:
限制在于内存,而非算力。 每个活跃序列都持有随着每个 token 增长的 KV 缓存,而正是这个缓存(而非数学计算)决定了能容纳多少个序列。
在配备 13B 模型的 40GB A100 上,一次只能容纳少数长序列。当缓存池耗尽时,调度器会驱逐一个正在运行的请求,稍后重新计算。
这看起来像 GPU 空间不足,但实际上是将相同的预填充计算了两遍。
👉 每个引擎都以不同名称提供连续批处理:vLLM、SGLang 和 TGI 直接这么叫,TensorRT-LLM 称之为飞行中批处理,LMDeploy 称之为持久批处理。
Chunked prefill(分块预填充)
每一轮都重建批次解决了慢成员问题,但也带来了新问题,用户看到的是卡顿。
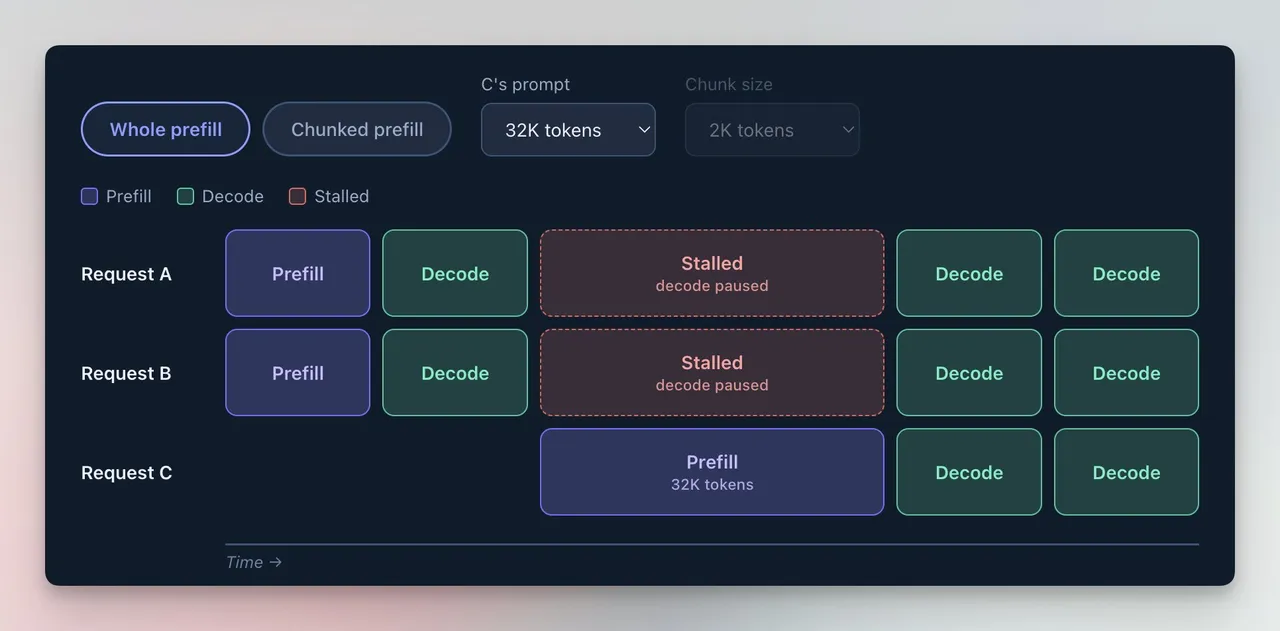
新加入的请求在一次迭代中完成预填充。一个 32K token 的提示词是一次大型、计算密集的传递,所有活跃的解码都要等它,所以当有人粘贴长文档时,输出会在句中断开。
以下是有无分块预填充的情况。
整体预填充:
分块预填充:
(请求 C 的提示词被拆分为每个 2k token 的小块)
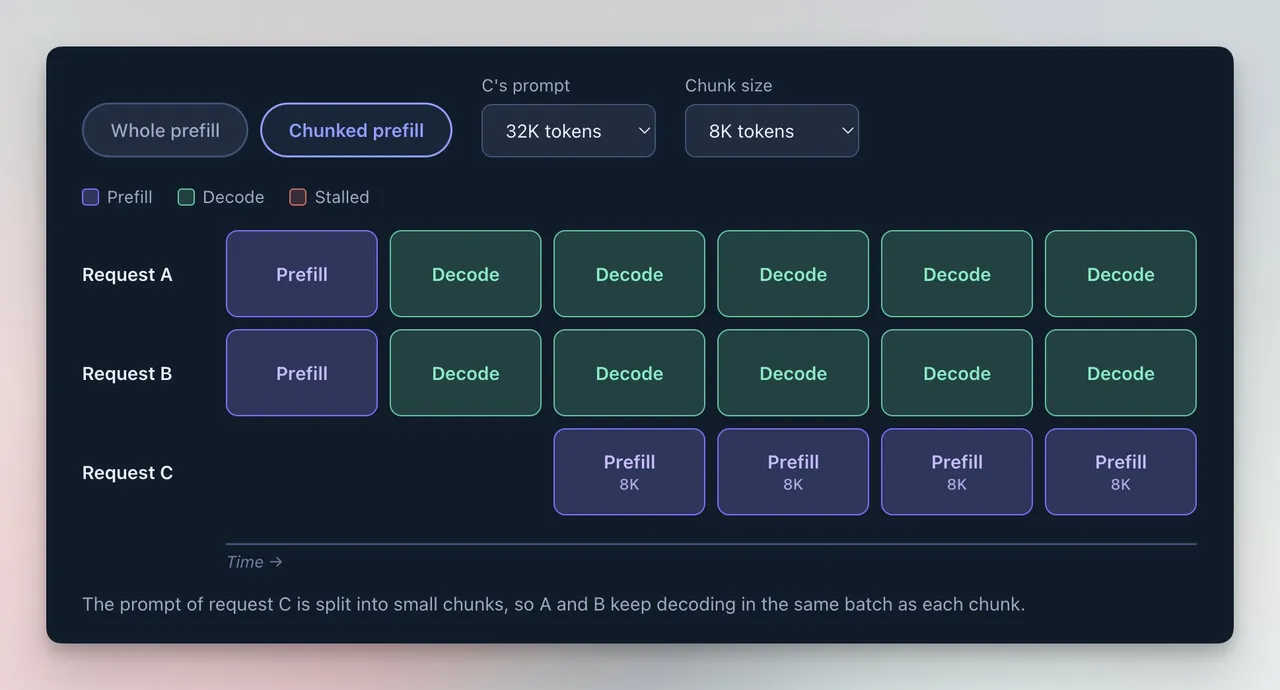
将提示词拆分到多轮迭代中。 分块预填充将提示词拆分为固定大小的 token 范围,分散在多次传递中调度,每次扩展请求的 KV 缓存。
注意力计算保持不变,因为后面的块会关注之前块处理过的内容。第一个 token 在最后一个块后到达。
预填充是计算密集型,解码是内存密集型,因此同时包含两者的批次能充分利用芯片的两个部分。
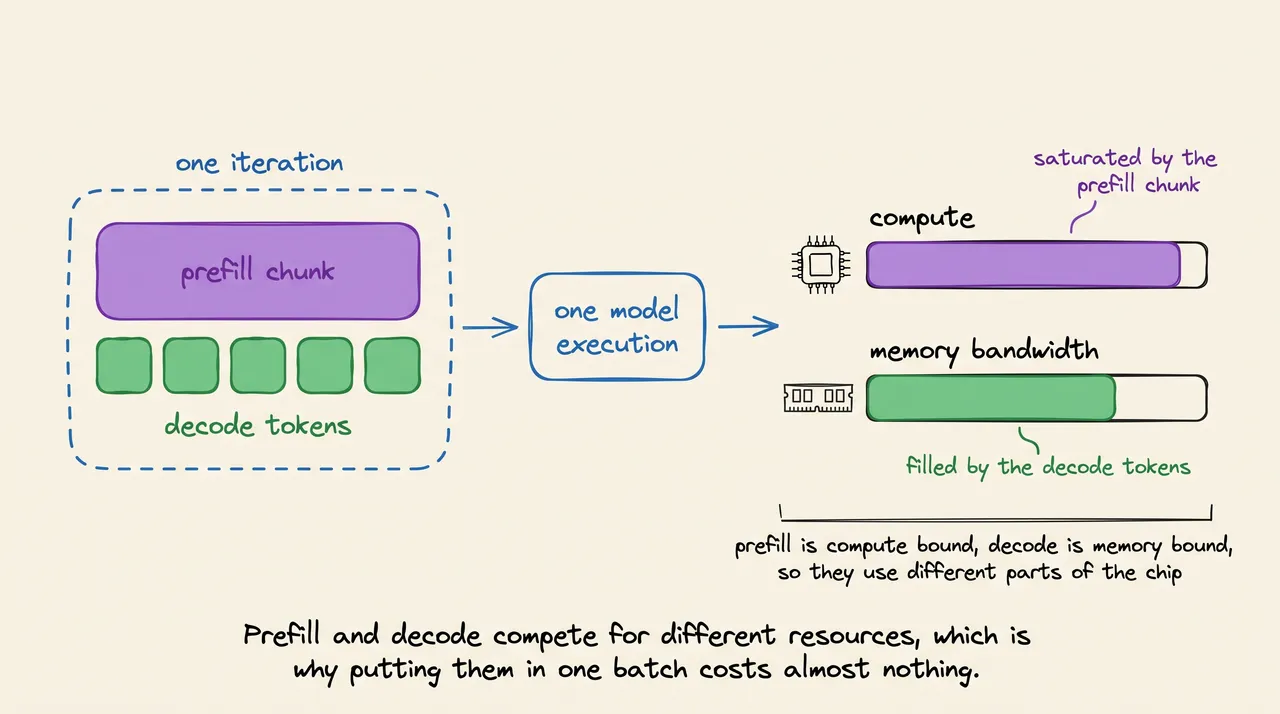
选择数值时,请注意:
- 较小的块 给调度器更多运行解码的机会,减少活跃请求的 ITL 峰值。
- 较大的块 更高效地处理新提示词,通常改善 TTFT,但活跃解码可能在 token 之间等待更长时间。
- 太小的块 可能降低 GPU 利用率并增加注意力开销,因为后面的块必须重新读取之前块创建的 KV 缓存条目。
分块预填充在 vLLM V1 中默认开启,其中 --max-num-batched-tokens 限制每次迭代的 token 数量。SGLang 使用 --chunked-prefill-size,-1 禁用。
vLLM:
vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --max-num-batched-tokens 8192
SGLang:
sglang serve --model-path meta-llama/Llama-3.1-8B-Instruct \
--chunked-prefill-size 8192👉 不存在普遍最佳的块大小。它取决于模型、GPU、您的提示词长度分布,以及您的 SLO 所衡量的延迟指标。
Conclusion(结论)
这三种策略仅在于它们何时固定批次方面有所不同,每种策略应对不同的工作负载形态。
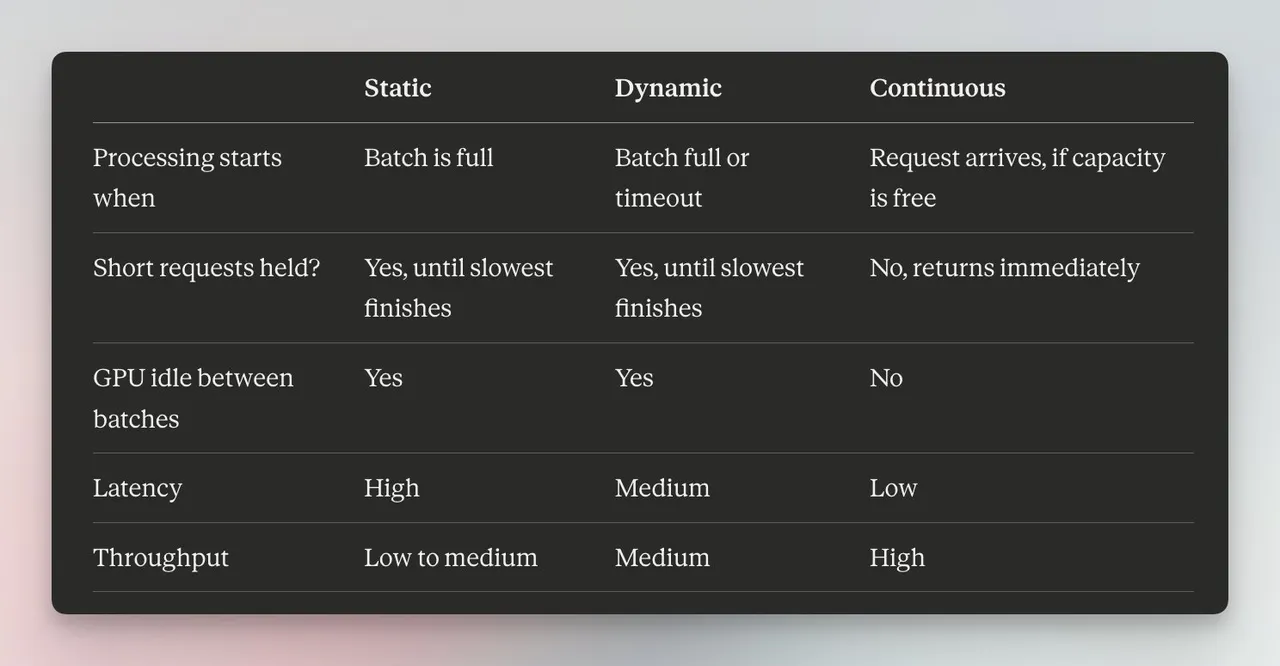
对于输出长度可变的实时流量,连续批处理是唯一能保持性能的策略,而且每个主流引擎默认都会提供这种功能。
