
最近有朋友找我咨询工具。
他们公司新买了几张 NVIDIA RTX PRO 5000 ,准备在本地部署大模型。除了日常对话和文件分析,他们还计划结合行业数据做一些微调,让模型更贴近实际业务。
问题是,工具应该怎么选?
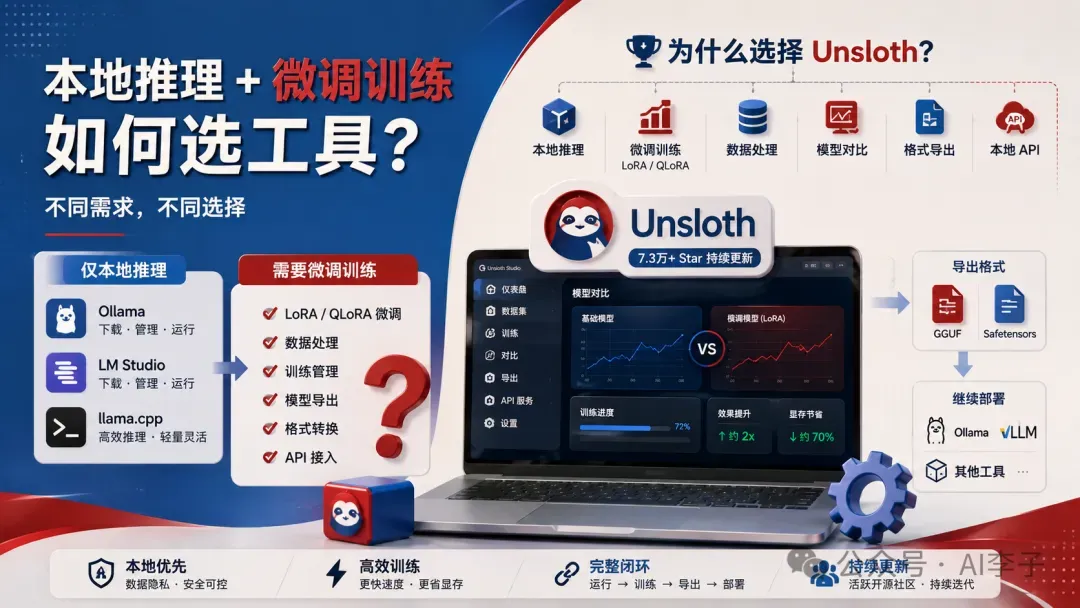
如果只看 本地推理 , Ollama 、 LM Studio 和 llama.cpp 都是比较成熟的方案。它们可以帮助你下载、管理和运行开源模型。
但朋友公司的需求还多了一步:后面可能要基于自己的数据做 LoRA 或 QLoRA 微调 。这样一来,单纯的推理工具就不够了,还需要训练、数据处理和模型导出能力。
综合考虑之后,我向他推荐了 Unsloth 。
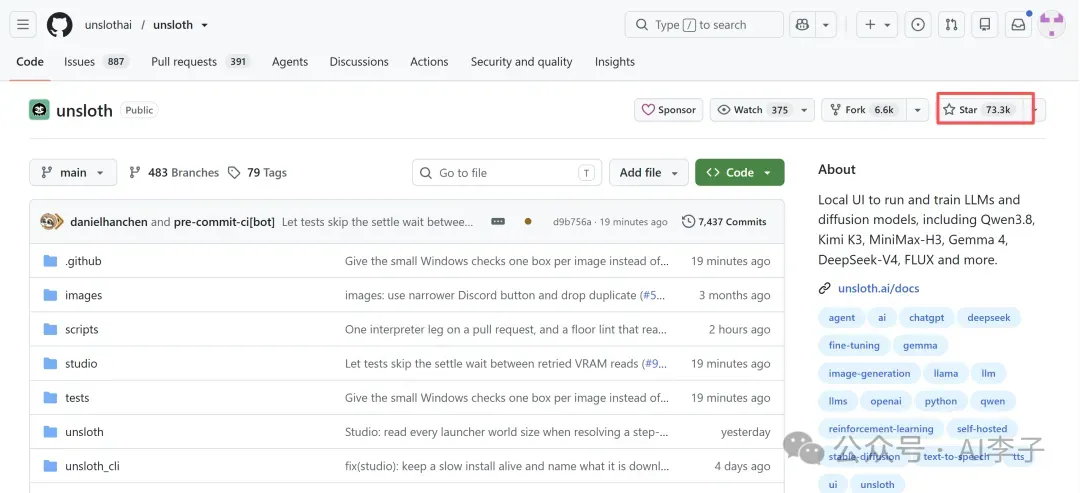
这个项目在 GitHub 上已经获得超过 7.3 万颗 Star ,仍在持续更新。
Unsloth 早期主要用于大模型微调,近两年逐步加入了 本地推理、可视化界面、数据处理、模型对比 、格式转换和 API 接入等功能。它的思路很清楚:让你尽量在本地完成模型运行、训练和部署。
下面我就简单介绍一下 Unsloth ,重点看看它适合什么场景,以及它和 Ollama、LM Studio、llama.cpp 这些工具有什么区别。
01
PART
Unsloth 是什么?
WHAT IS IT
Unsloth 是一个面向本地大模型运行和训练的 开源工具 。它早期主要以高效微调闻名,后来逐步加入了图形化界面、模型推理、数据处理、模型导出和本地 API 等功能。
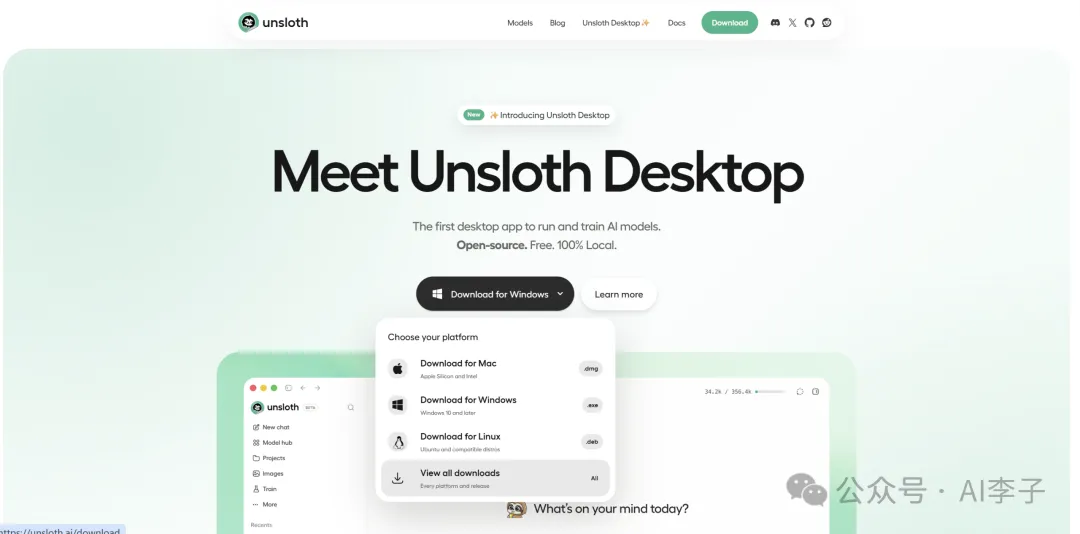
目前,Unsloth 主要提供三种使用方式:面向普通用户的 Unsloth Desktop 、本地网页界面的 Unsloth Studio ,以及适合代码开发者的 Unsloth Core 。三者面向的使用习惯不同,但都属于 Unsloth 的产品体系。
它支持的范围也已经超出传统语言模型,覆盖 文本、视觉、语音和音频模型、嵌入模型 ,以及部分图像和视频扩散模型。
从产品定位看,Unsloth 更像是一套 本地 AI 工作台 。它把模型下载、运行、数据准备、训练、效果对比和导出放到了同一个界面里。
02
PART
它最核心的能力,依然是高效微调
FINE-TUNING
Unsloth 的核心竞争力来自 训练效率 。
在 LoRA、QLoRA、监督微调以及部分强化学习训练场景中,Unsloth 使用了经过优化的 Triton 内核、显存管理和训练策略。官方称在部分模型和训练配置下,它可以达到约 2 倍训练速度 ,并减少约 70% 显存占用 。
当然官方给出的这类数字需要结合具体模型、数据集、上下文长度、批量大小和显卡型号理解, 不能简单理解成所有任务都会快 2 倍 ,也不能据此推导出固定的显存门槛。
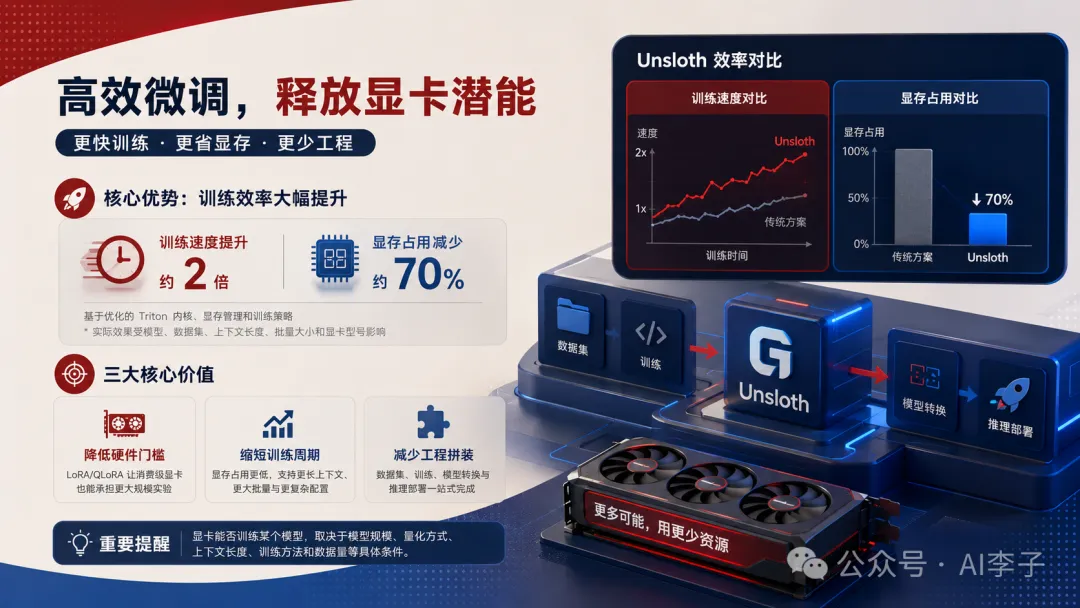
实际使用中,Unsloth 的价值主要体现在三个方面:
降低微调的硬件门槛
对于个人开发者和小团队来说,LoRA、QLoRA 等参数高效微调方式,可以让消费级显卡承担更大规模的实验。
缩短训练和调试周期
显存占用更低以后,可以尝试更长的上下文、更大的批量或更复杂的训练配置。
减少工程拼装
传统流程往往需要分别处理数据集、训练脚本、模型转换和推理部署,Unsloth 尽量把这些步骤集中起来。
不过,显卡能否训练某个模型,最终仍取决于模型规模、量化方式、上下文长度、训练方法和数据量。所谓 某种显卡一定能训练某个参数规模的模型 通常都需要加上具体条件 。
03
PART
从本地推理角度看,Unsloth 更像一个统一入口
LOCAL INFERENCE
Ollama 、 LM Studio 和 llama.cpp 的重点是模型推理和服务。Unsloth 早期重点在训练微调,如今的 Unsloth Studio 也加入了完整的本地运行能力 。
Unsloth 可以加载 GGUF、Safetensors 等格式 的模型,也支持从 Hugging Face 搜索和下载模型。已经通过 Hugging Face 或 LM Studio 下载到本地的模型,也可以被识别和使用。
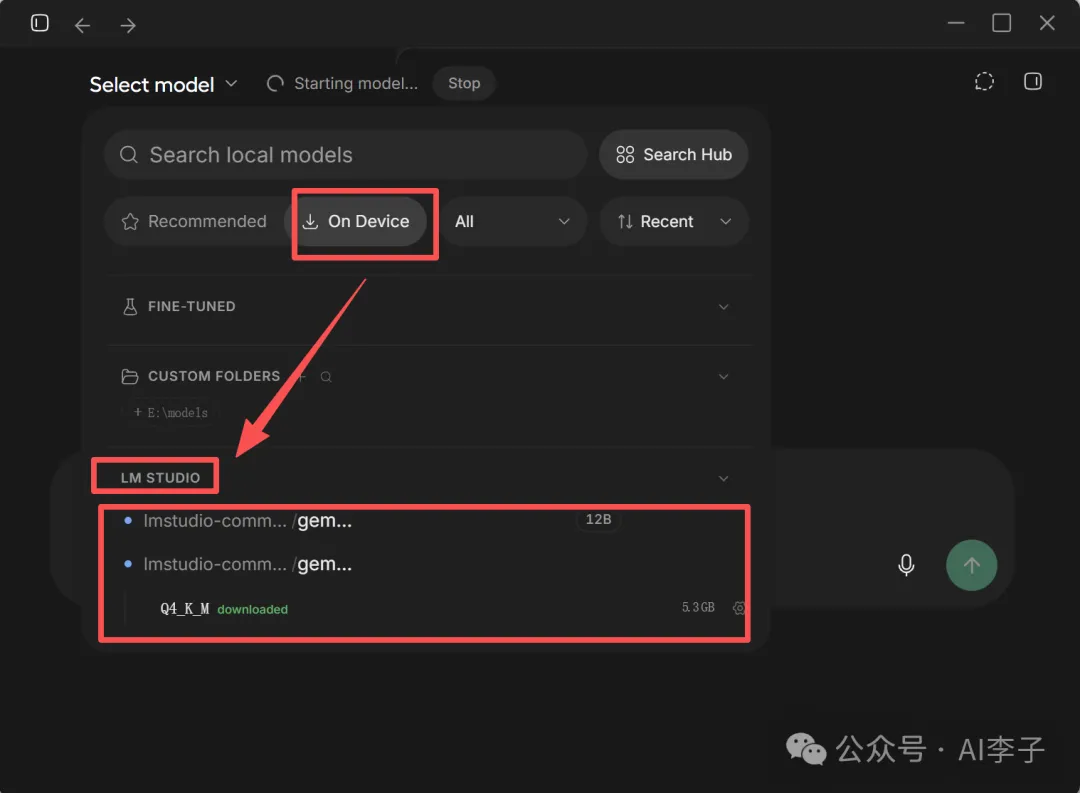
这里有一个容易混淆的地方:Unsloth 的本地推理能力 主要依托 llama.cpp 和 Hugging Face 生态 。换句话说,Unsloth 并没有重新发明一套完全独立的推理引擎,它提供的是更完整的界面、模型管理、参数设置和训练后对比流程。
因此,如果你只想把一个 GGUF 模型跑起来, Ollama 、 LM Studio 或 llama.cpp 依然是很成熟的选择。
你可以在同一个环境中运行和测试基础模型,对比基础模型与微调模型的输出,继续训练 LoRA 或 QLoRA,并将结果导出为 GGUF 或 Safetensors。 Unsloth 同时支持 OpenAI 和 Anthropic 两种协议 ,可以连接 Claude Code、Codex 等本地智能体工具。
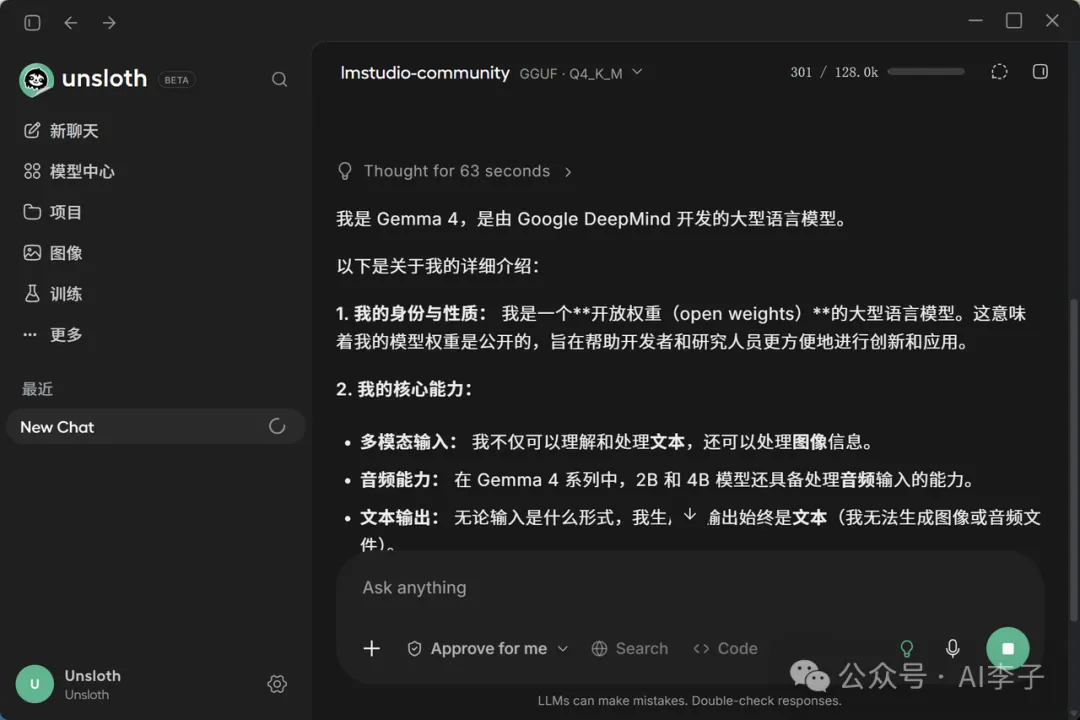
Unsloth 还提供了自动推理参数设置、模型并排对比、文件作为上下文、图像和音频输入等功能。部分模型可以使用 工具调用、代码执行和网页搜索 能力。
这些功能属于应用层增强,是否开启会影响速度和资源消耗。比如开启代码执行、网页搜索或工具调用后,整体响应时间通常会增加,因此不能把这些功能带来的体验变化 简单归因于底层模型速度 。
04
PART
模型选择比较丰富,重点在于格式和用途
MODEL FORMATS
Unsloth 官方模型目录中,可以看到 Qwen、Llama、Gemma、DeepSeek、Mistral、Phi、GLM 等多个系列,也提供 GGUF、4-bit、16-bit、FP8 等不同形式的模型。
不同格式适合的用途并不一样:
GGUF
更适合通过 llama.cpp 生态进行本地推理。
4-bit Safetensors
常用于显存有限时的推理和参数高效微调。
16-bit
通常更适合训练或作为基础模型使用。
FP8
等格式需要结合硬件和具体后端判断,适合特定的训练或部署场景。
因此,下载模型时 不能只看参数规模 。模型格式、量化等级、上下文长度和显卡显存及带宽同样重要。
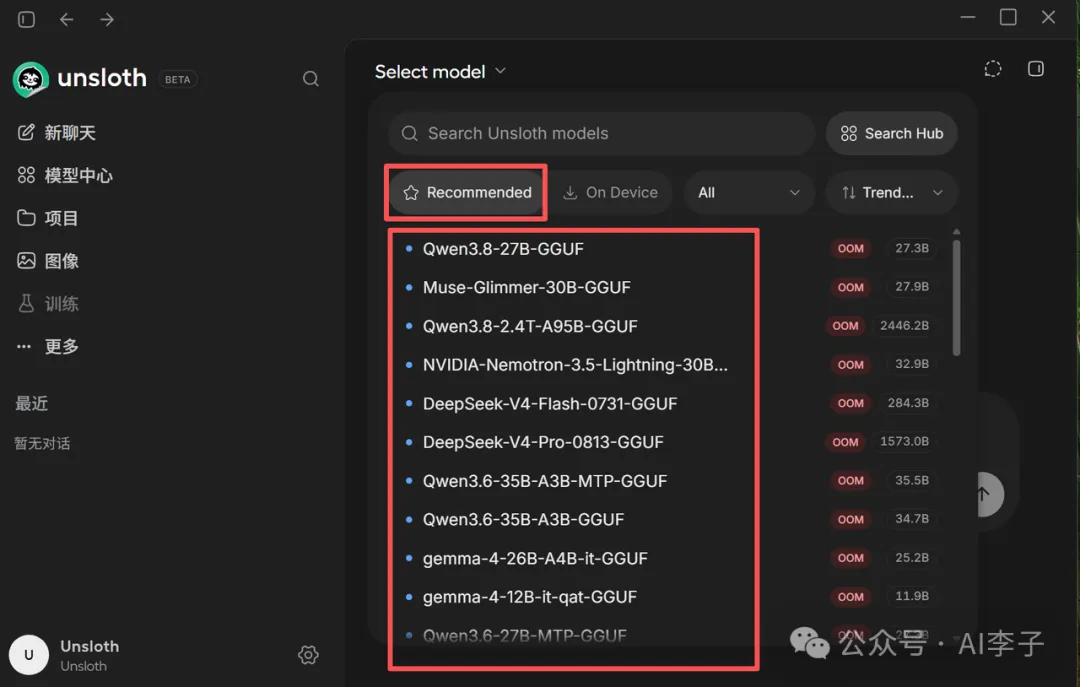
Unsloth 的一个实用之处,是它把 模型搜索、下载和使用放在了同一个入口 。对于刚开始接触本地模型的朋友,这比在多个网站和工具之间来回切换更方便。
05
PART
从数据到模型导出,形成了完整闭环
FULL LOOP
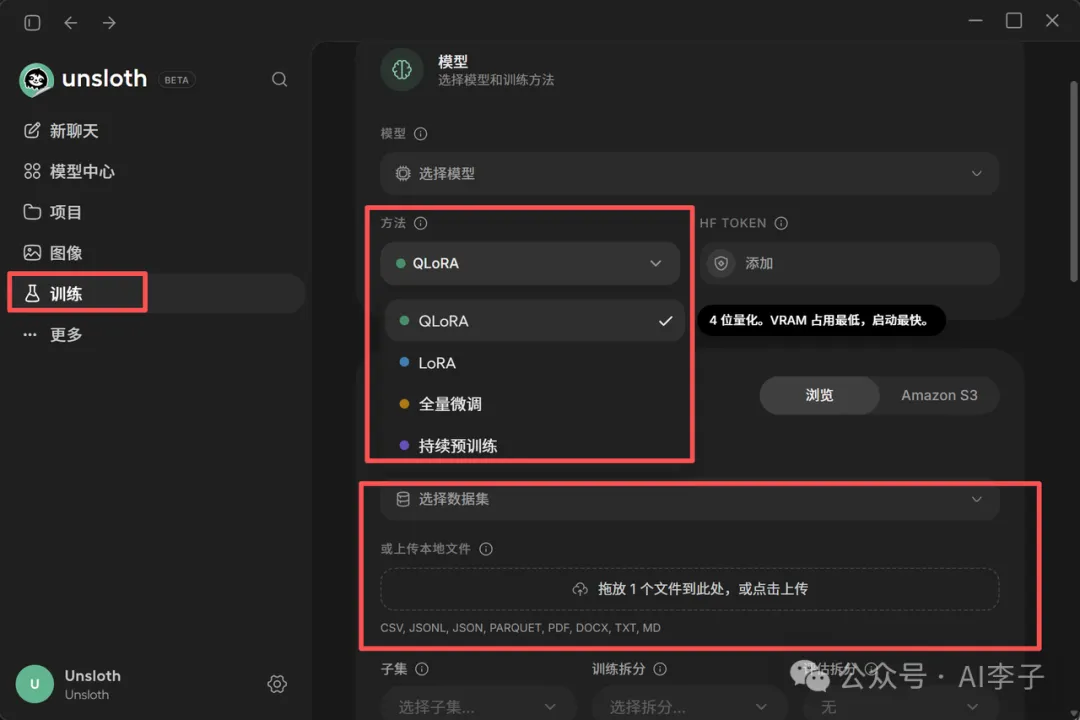
微调效果很大程度上取决于 数据质量 。
Unsloth 支持从 PDF、CSV、JSON、DOCX、TXT 等文件中整理数据,也提供 Data Recipes ,用于清洗、转换和生成训练数据。
这部分功能的意义在于,你不必一开始就编写完整的数据处理脚本,可以先通过可视化界面建立一条数据处理流程,再根据需要进行更细致的调整。
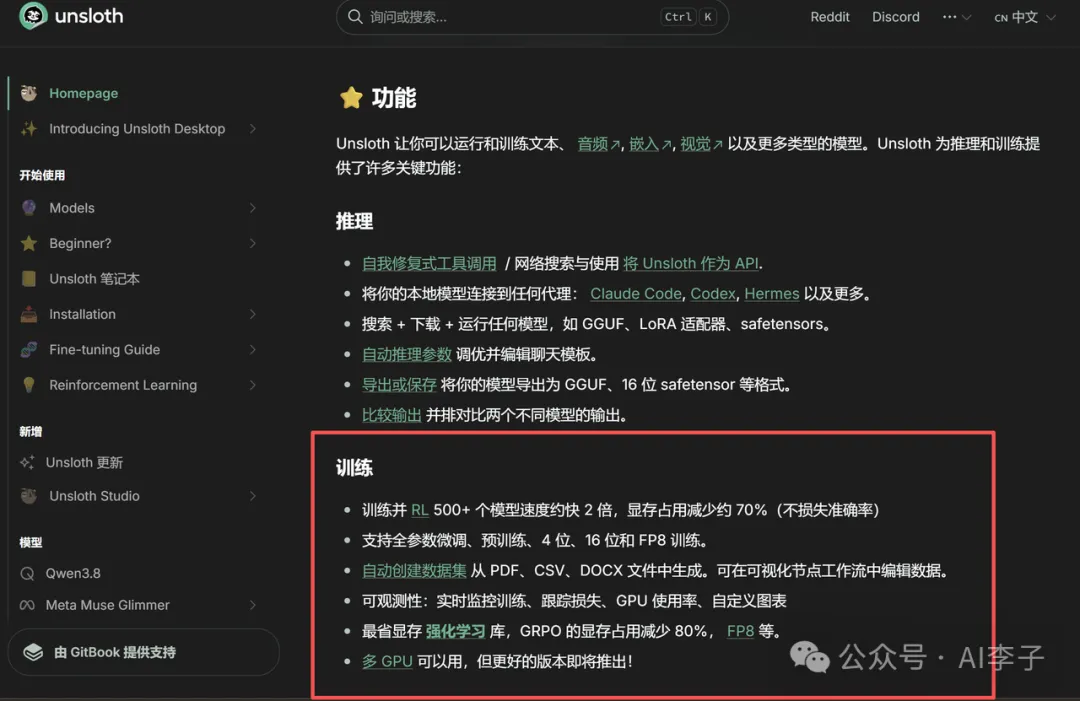
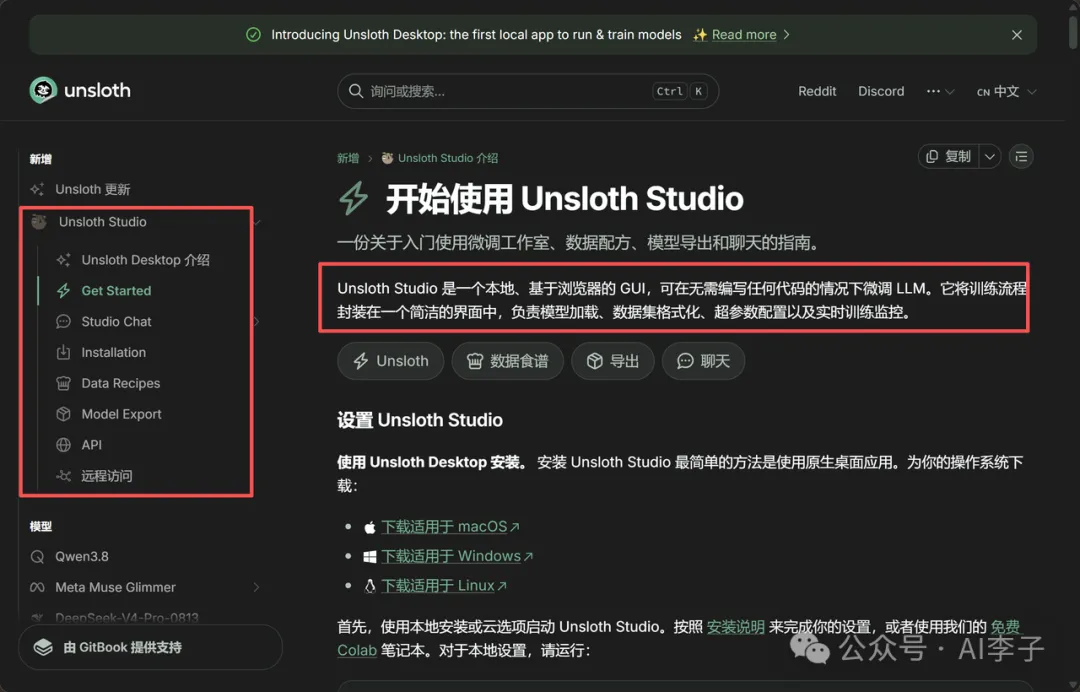
训练完成后,可以直接在 unsloth 中与微调后的模型对话,并和基础模型进行对比。这个步骤很重要,因为 训练损失下降并不代表模型一定更适合业务场景 。
有些模型可能更听话了,但通用能力下降;有些模型可能学会了特定格式,却出现了过拟合。把基础模型和微调模型放在同一个提示词下比较,往往比单独查看训练曲线更直观。
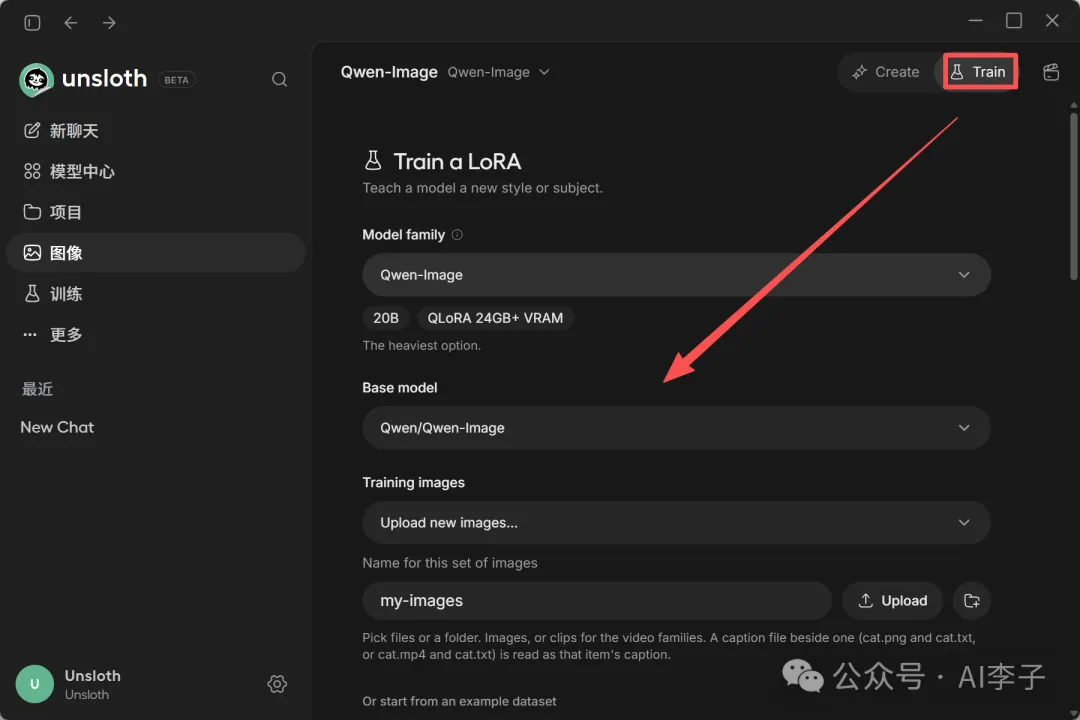
Unsloth 还支持将训练结果导出为 LoRA、Safetensors、GGUF 等格式 ,之后可以继续用于 llama.cpp、Ollama、LM Studio、vLLM 等工具。
这意味着 训练和部署之间不需要完全割裂 。训练可以在 Unsloth 中完成,部署时仍然可以选择自己熟悉的推理工具。
06
PART
本地智能体也可以调用 Unsloth 中的模型
AGENTS
Unsloth 还提供了 Unsloth Start ,可以把本地模型接入 Claude Code、Codex 等智能体工具。
它的作用,是让智能体通过本地模型完成代码生成、文件处理和项目分析等任务。对于 对数据隐私有要求 ,或者希望减少云端 API 调用的小团队,这个方向比较有吸引力。
当然,智能体体验仍然取决于模型自身的指令遵循能力、工具调用能力和显卡性能。Unsloth 提供了连接方式,但不会自动解决模型能力本身的问题。
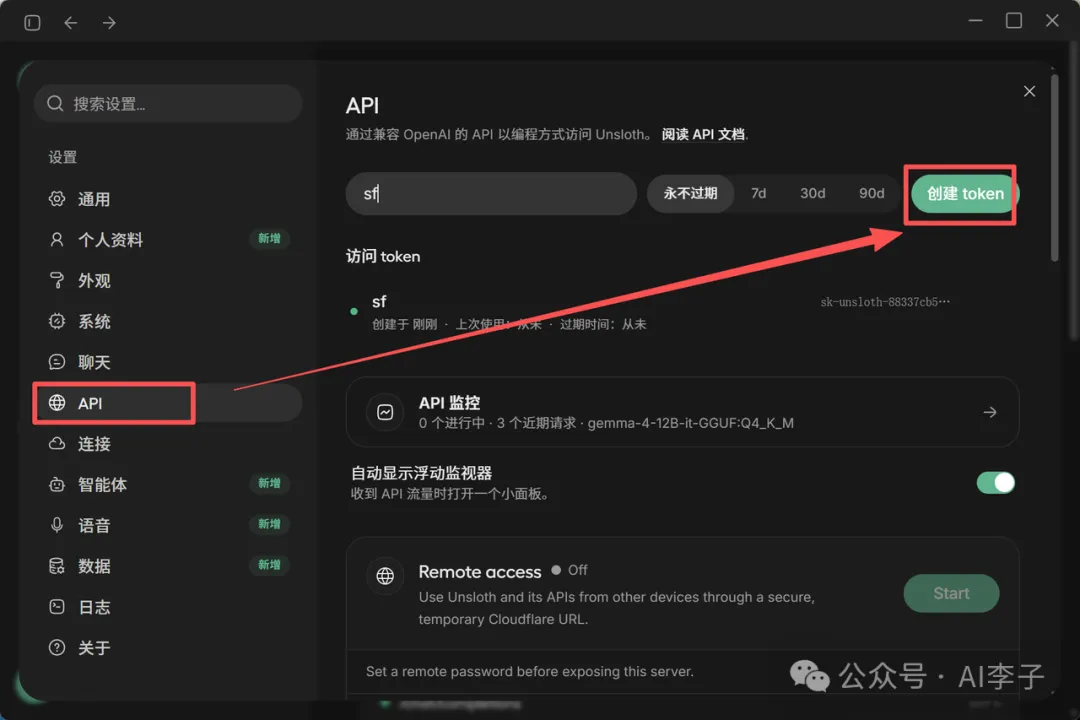
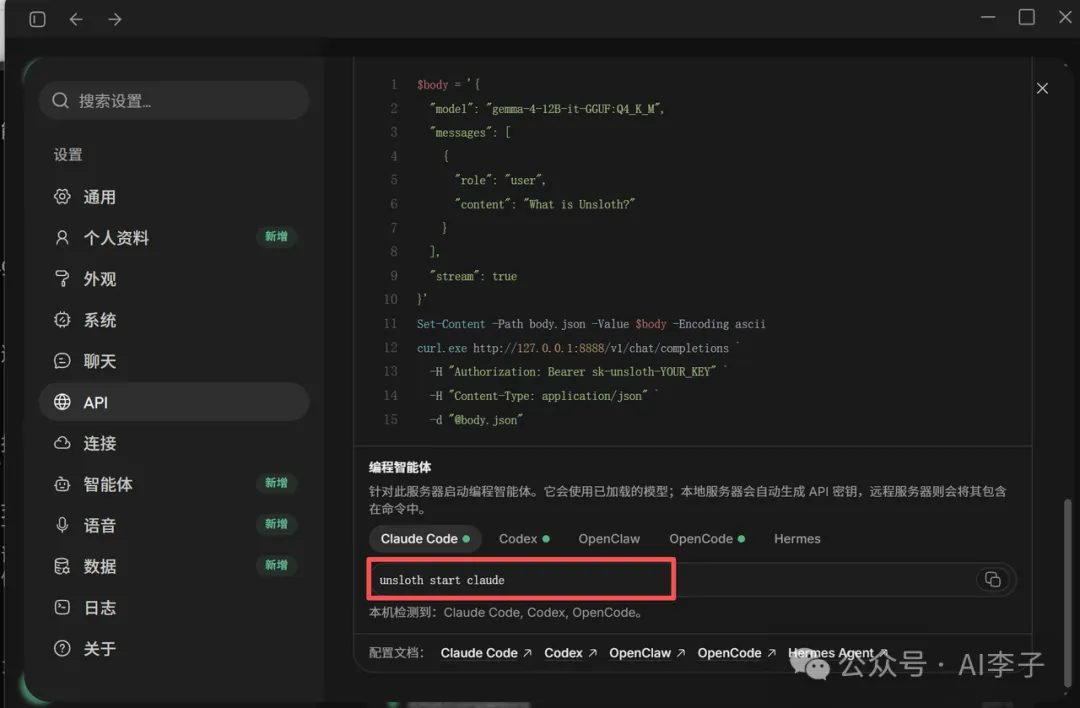
以 Claude Code 为例,在完成本地模型配置后,可以通过下面的命令启动连接:
unsloth start claude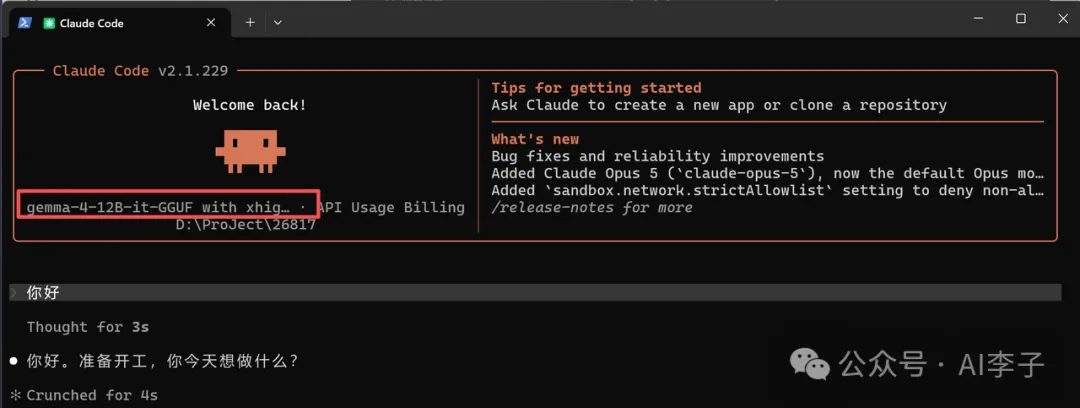
07
PART
适合什么人使用?
WHO IT'S FOR
如果只是运行几个现成模型, Ollama 、 LM Studio 依然足够简单。
如果你准备系统性地做模型定制,尤其是希望使用本地显卡完成数据整理、LoRA 或 QLoRA 微调,再把结果导出到其他推理工具中, Unsloth 会更合适 。
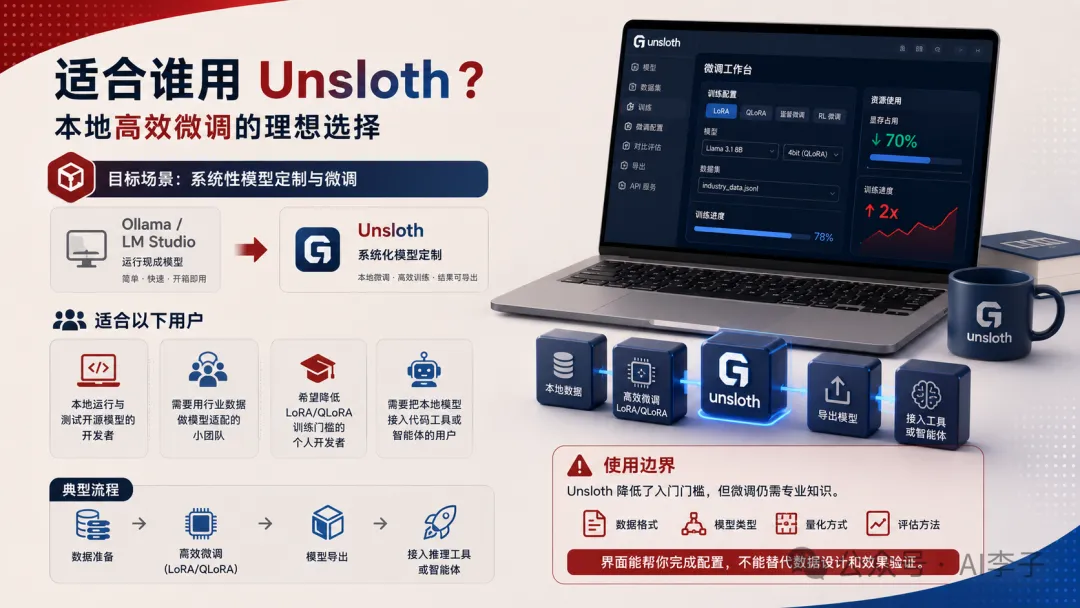
它比较适合以下几类用户:
本地运行和测试开源模型
想在本地运行和测试开源模型的开发者。
行业数据做模型适配
需要用行业数据做模型适配的小团队。
降低训练门槛
希望降低 LoRA、QLoRA 训练门槛的个人开发者。
接入代码工具或智能体
需要把本地模型接入代码工具或智能体的用户。
它也有明显的使用边界。 Unsloth 的图形界面降低了入门门槛,但微调仍然需要理解数据格式、模型类型、量化方式和评估方法。界面能帮助你完成配置,却不能替代数据设计和效果验证。
08
PART
最后
WRAP-UP
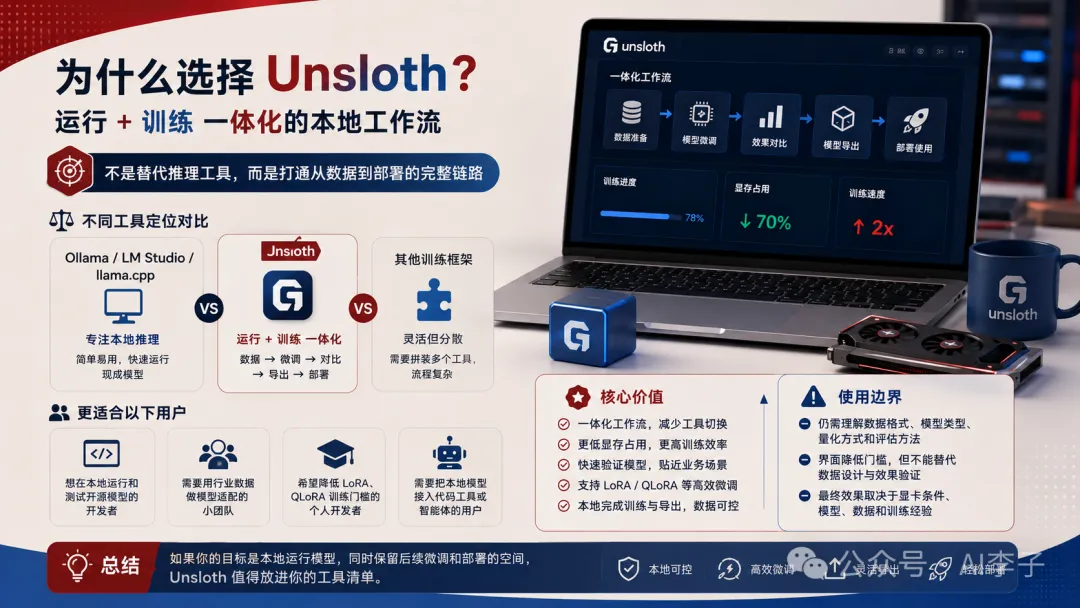
朋友公司最初只是想在本地运行模型,后面又提出了行业微调的需求。也正因为这两个需求同时存在,我才把 Unsloth 推荐给他。
如果只看本地推理, Ollama 、 LM Studio 和 llama.cpp 都是成熟方案。如果希望继续完成数据准备、模型微调、效果对比和模型导出,Unsloth 提供了一条 更连贯的本地工作流 。
它的价值不在于替代所有本地推理工具,而在于把 运行模型和训练模型放进了同一个工具体系 。对于个人开发者和小团队来说,这可以减少工具切换,也方便快速验证一个模型是否适合自己的业务场景。
当然,Unsloth 也不能替代数据设计、训练经验和效果评估。显卡条件、模型格式、训练数据和评估方法,仍然决定着最终结果。
如果你的目标是本地运行模型,同时保留后续微调和部署的空间, Unsloth 值得放进工具清单 。
项目地址
https://github.com/unslothai/unsloth
官方网站
https://unsloth.ai/
官方文档
https://unsloth.ai/docs/zh
它的价值不在于替代所有本地推理工具,而在于把「运行模型」和「训练模型」放进了同一个工具体系。
我是 AI李子 ,热衷于分享 AI 干货。如果今天这篇对你有帮助,欢迎 点赞、在看、转发 三连,我们下篇见。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见
赞
在看
收藏
THANKS FOR READING
