
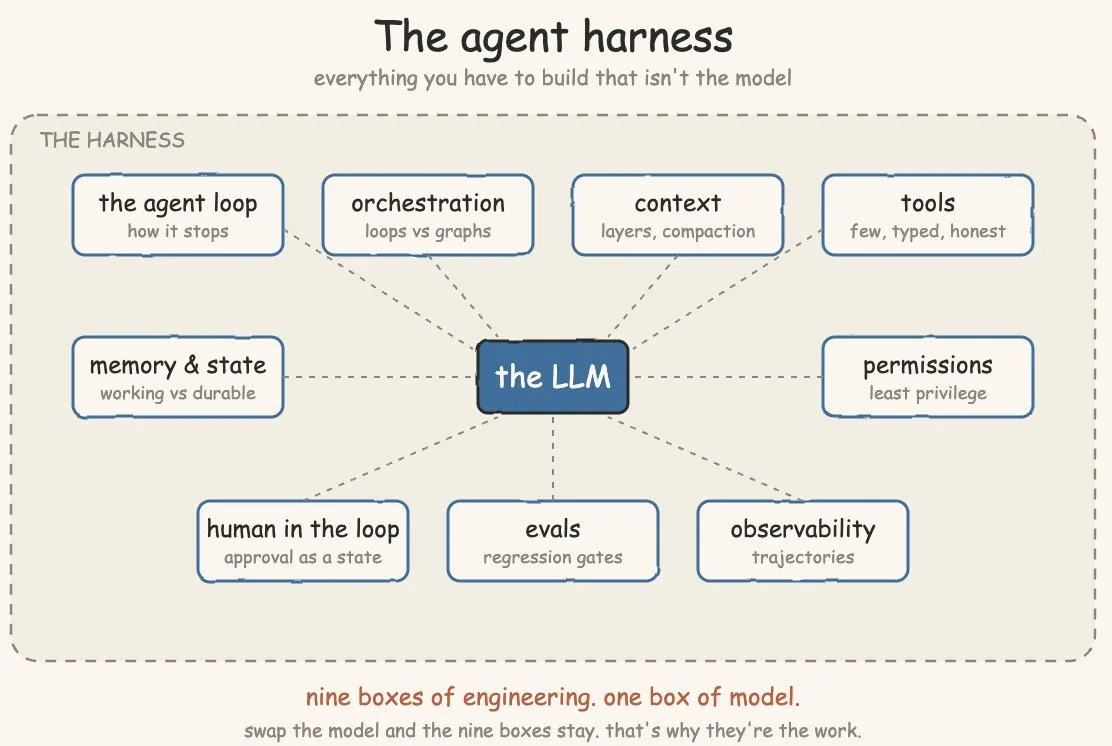
将一个前沿模型放入设计糟糕的智能体系统,你会得到一种更善言辞的失败。几乎所有工程都在模型之外,位于被称为智能体外壳的harness中。
这一部分涵盖了你无论是否意识到都在设计的五个组件:工具、提示词、记忆、编排,以及人在循环中的位置。然后是评估框架,它告诉你这些是否有效,因为这一切都不像普通代码那样可测试。
构建智能体系统需要在三个关键领域进行有意的设计:
- 理解工作负载:智能体任务与网页请求有根本不同。
- 设计外壳:你构建的而非模型本身的组件(工具、提示词、记忆、编排)
- 构建评估框架:如何衡量质量并捕捉回归
本指南涵盖所有三个方面。所有内容都来自一个真实系统:DevVoice,一个五智能体流水线,将 GitHub README 转化为经过审阅的 X 帖子、LinkedIn 帖子和 dev.to 文章。这些设计决策决定了你的智能体系统是否健全。
注意:代码示例是说明性伪代码,展示模式和概念。请根据你的框架(LangChain、LlamaIndex、Anthropic SDK 等)进行调整。
Part 1: Foundations(第一部分:基础)
智能体工作负载不是网页工作负载
从这里开始,因为几乎每个后续决策都源于此。
典型的网页请求耗时 50–200 毫秒,突发性 CPU 受限,确定性高,每单位成本几乎为零。智能体任务则完全不同:
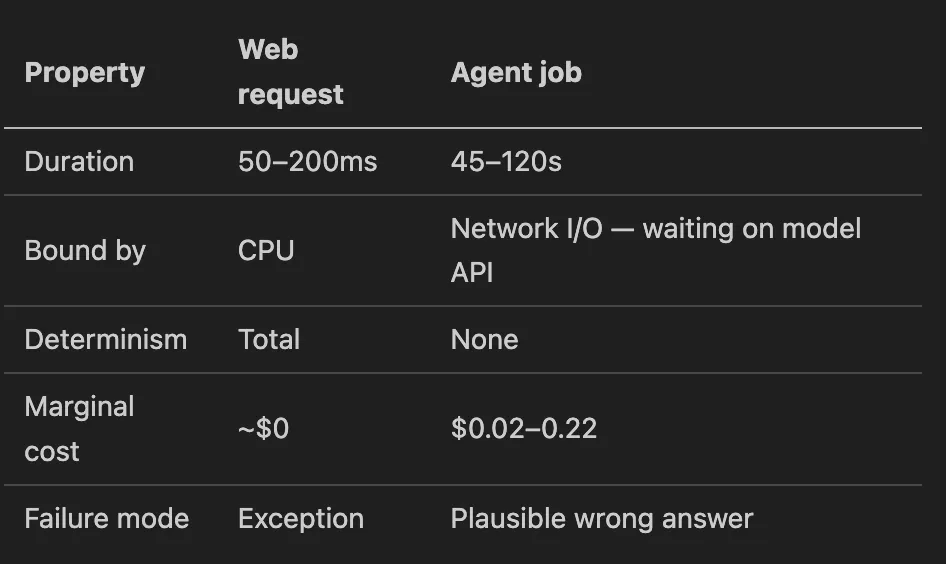
四个架构后果:
时长。你无法同步处理请求。负载均衡器有空闲超时。每个活动任务保持连接两分钟是浪费的。
I/O 受限。并发不受核心数限制。一个工作进程 70–80% 的时间都在等待模型 API。一个 2 核容器可以运行数十个并发任务。按核心数进行容量规划会浪费大部分成本。
非确定性。相同的输入会产生不同的输出,因此重试并非免费。你不能在 CI 中对输出进行断言,测试必须针对外壳而非模型。
边际成本。一个 bug 就是一张账单。智能体循环中的无限循环会以大约每分钟一美元的速度烧钱,悄无声息,直到有人发现。
从第一次提交开始就按这种形态设计,部署就是配置。按网页形态设计,部署就是重写。
Part 2: The Agent Harness(第二部分:智能体外壳)
你构建的非模型部分
外壳是你构建的非模型的一切。在真实系统中有九个盒子。其中有四个值得提前设计。
Component 1: Tools(组件 1:工具)
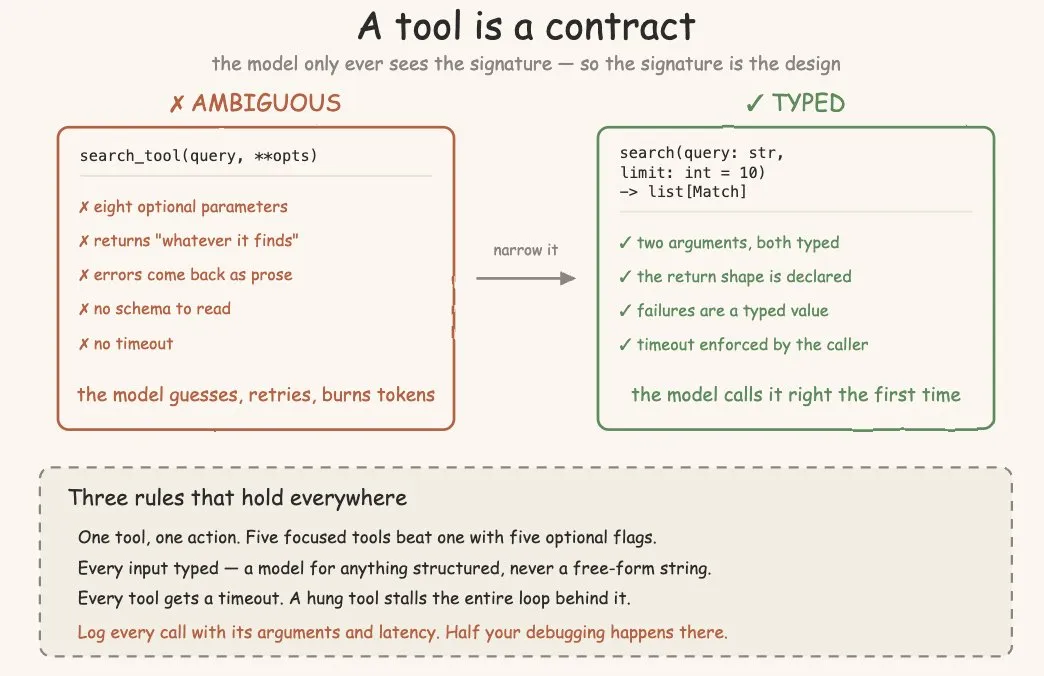
工具是智能体影响世界的唯一方式。设计不佳会浪费模型 token 在困惑上;设计良好则可将上下文削减 60%。
工具定义是一份契约:
@tool
def search_code(
    query: str,
    repository: str,
    max_results: int = 10
) -> list[CodeMatch]:
    """Search for code patterns across a repository.

    Args:
        query: The code pattern or keyword to search for
        repository: GitHub org/repo identifier
        max_results: Limit results (default 10, max 100)

    Returns:
        List of matching code locations with context
"""三个要求:
- 类型化输入输出。模型看到的是模式;歧义会浪费 token 并导致错误。对于复杂返回,使用 Pydantic 模型。
- 小表面积。每个离散动作一个工具。五个专注的工具优于一个带五个可选参数的工具。避免接受任意查询的工具,模型会错误调用它们。
- 确定且快速。一个需要 30 秒的工具是上下文的杀手。如果操作成本高,将其设为异步并使用状态工具轮询,或将其移入任务队列。
工具管理:
- 将工具放在注册表中,而不是分散在智能体代码中
- 将工具与智能体分开版本化:智能体调用 search_v2,而其他仍使用 search_v1
- 记录每次工具调用及其参数和延迟,你一半的问题都会在这里调试
- 为每个工具添加超时;挂起的工具会卡住智能体
Component 2: Prompt Engineering(组件 2:提示词工程)
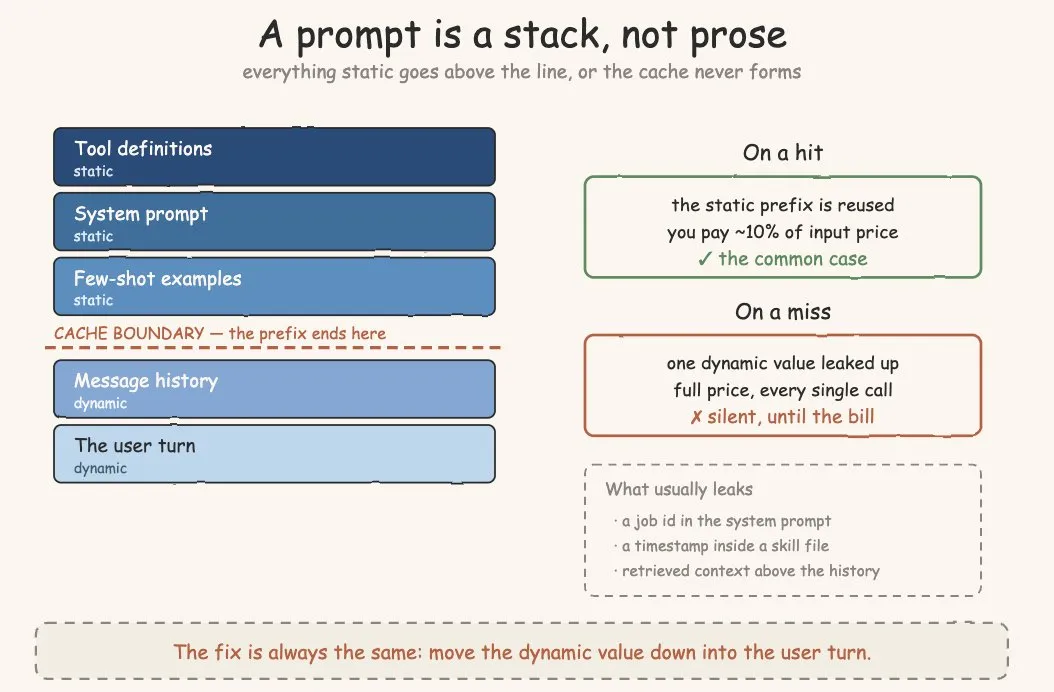
提示词不是散文,它们是状态机。结构与措辞同样重要
基本形态:
1. System prompt (static)
   - Role and context
   - Hard constraints and rules
   - Output format specification

2. Static examples (static)
   - Few-shot examples showing desired behavior
   - Edge cases you've seen fail

3. Tools specification (static)
   - Tool definitions and usage examples
   - Error handling behavior

4. Dynamic context (dynamic)
   - Conversation history
   - Per-request data (user input, retrieved documents)
   - Job state

5. User turn (dynamic)
- The actual request首要规则:静态内容必须位于动态内容之前。工具定义、系统提示词、示例、历史记录,然后是用户回合。任何向上泄漏的动态值都会摧毁提示词缓存,并悄悄使你的 token 成本翻倍。
提示词版本管理:
PROMPT_VERSION = "2024-08-19-v3"

def build_system_prompt(version: str) -> str:
    if version.startswith("2024-08-19"):
        return """You are a code reviewer..."""
    elif version.startswith("2024-08-15"):
return """You are a reviewer...""" # Previous version根据提示词版本对你的响应缓存键进行版本管理。一个糟糕的提示词会在你修复后仍被缓存并服务数小时。有了版本管理,回滚只需更改一个环境变量。
Component 3: Memory(组件 3:记忆)
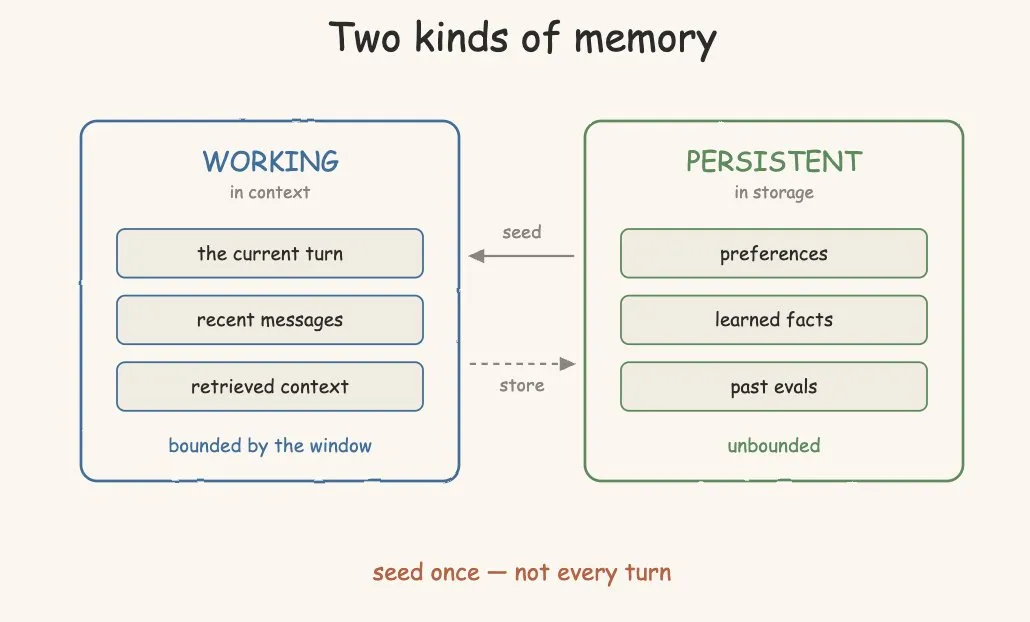
智能体需要两种记忆,它们不可互换。
工作记忆(短期,上下文内):
- 当前对话轮次
- 最近 N 条消息(已检索)
- 为此任务检索的上下文
- token 预算:上下文能容纳的一切
持久记忆(长期,存储支持):
- 用户偏好和历史
- 从以往交互中学到的事实
- 评估结果和失败案例
- 无限期存储
常见错误:把工作记忆当作持久记忆使用。每一轮都在系统提示词里加上 “记住 X” 会消耗大量 token。正确的模式是:
# At job start: seed working memory
working_memory = {
    "user_id": job.user_id,
    "past_interactions": fetch_last_n_interactions(job.user_id, n=5),
    "learned_preferences": fetch_user_preferences(job.user_id),
    "retrieved_documents": retrieve_relevant_docs(job.query),
}

# During job: work from working memory
prompt = build_prompt_with_context(working_memory)

# At job end: update persistent memory
if agent.learned_something_new:
    store_user_fact(job.user_id, fact)
避免上下文溢出:
- 智能截断工作记忆——丢弃最旧的消息,保留最近和最关键的消息
- 将长对话的摘要存入持久记忆,检索摘要而非完整历史
- 对文档采用基于内容的切块:在章节边界处断开,而不是按 token 数限制
Component 4: Multi-Agent Orchestration(组件 4:多智能体编排)
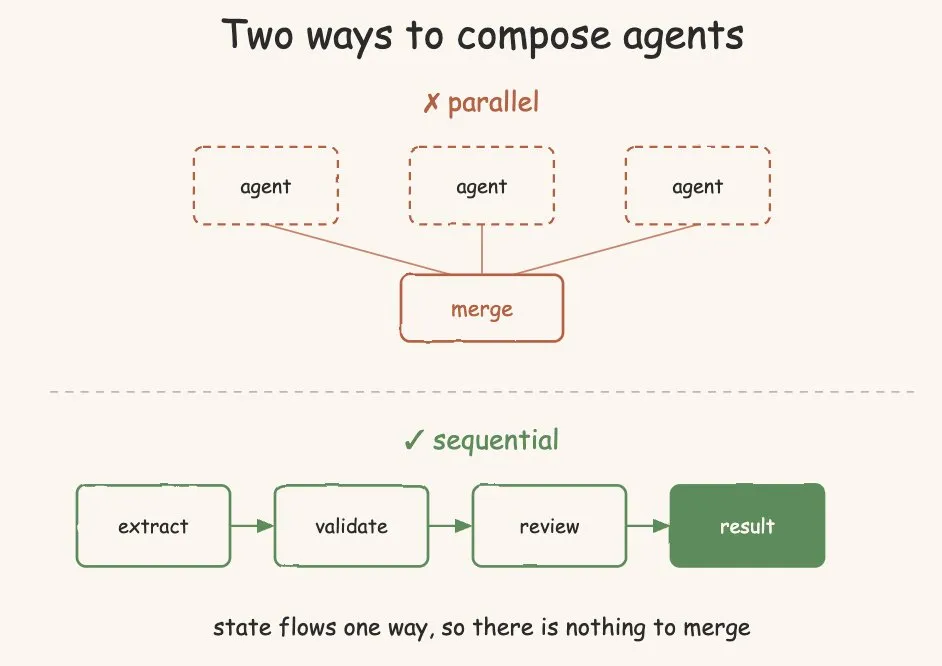
智能体可以两种方式协同:并行(智能体同时工作,结果合并)和 串行(智能体依次工作,一个的输出作为下一个的输入)。
并行智能体听起来更高效,其实不然。它们会带来协调问题:智能体 A 产生了智能体 B 需要的输出,但智能体运行速度不同。结果你不得不轮询和合并,既慢又复杂。
带子智能体的串行编排更优:
# Bad: parallel agents that might conflict
async def process_parallel(doc: str):
    results = await asyncio.gather(
        summarizer_agent(doc),
        analyzer_agent(doc)
    )
    return merge_results(results)

# Good: sequential subagents with clear data flow
def process_sequential(doc: str):
    summary = subagent_summarize(doc)
    analysis = subagent_analyze(doc, context=summary)
    final_review = subagent_review(doc, summary, analysis)
return final_review子智能体胜出的原因:
- 清晰的数据流。 智能体 B 明确依赖智能体 A 的输出
- 提前退出。 若智能体 A 的输出无效,可在启动智能体 B 前停止
- 状态更简单。 工作记忆按顺序贯穿各智能体,无需合并逻辑
- 调试更容易。 每个子智能体有一个明确的输入和输出
仅在智能体真正处理独立数据且其输出互不影响时才使用并行智能体(例如,针对同一查询调用三个不同的 API)。即便如此,也应考虑带回退机制的串行智能体。
编排层应清晰明确:
class Orchestrator:
    def run(self, job: Job) -> Result:
        extracted = self.extract_agent.run(job.content, job.schema)
        validated = self.validator_agent.run(extracted, job.rules)
        formatted = self.formatter_agent.run(validated, job.format)
return Result(data=formatted, trace=self.trace)每个子智能体在进程中构建一次并多次调用。状态按顺序流经它们。
Component 5: Human in the Loop(组件 5:人在回路)
只能读取的智能体是安全的,但没什么意思。一旦它能发送、发布或花费,它所做的某些事就不再可逆——这正是人在回路的意义所在。不是为审查而审查,而是让一个人站在模型与其不可撤销的行为之间。
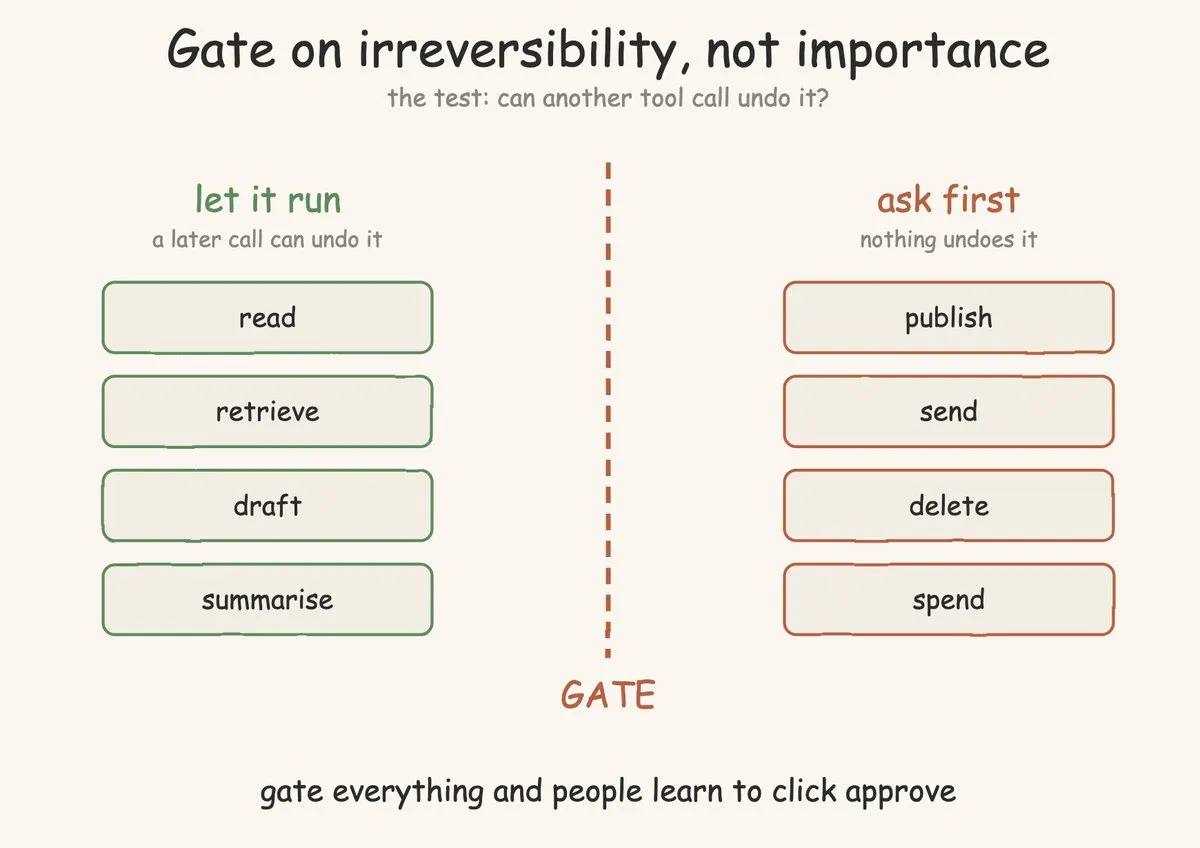
以不可逆性为门控标准,而非重要性。 检验方法是机械性的:另一个工具调用能否撤销此操作?读取、检索和草拟可以通过,因为即使模型弄错了,下一步能修正。发布、发送、删除和花费则不行。重要性是错误的标准,因为对提出请求的人来说,一切看起来都很重要。
过度门控是一种看似谨慎的失败。对所有操作都触发门控,会让审查者养成不看就点击批准的习惯——你付出了延迟的代价,却得不到任何安全性。门控因稀缺而保持其意义。
一个约束:门控是运行所停驻的状态,不是阻塞调用。其机制见第 2 部分。
循环工程 vs 图工程
门控能放置在哪里,取决于运行的结构方式,而结构方式有两种。
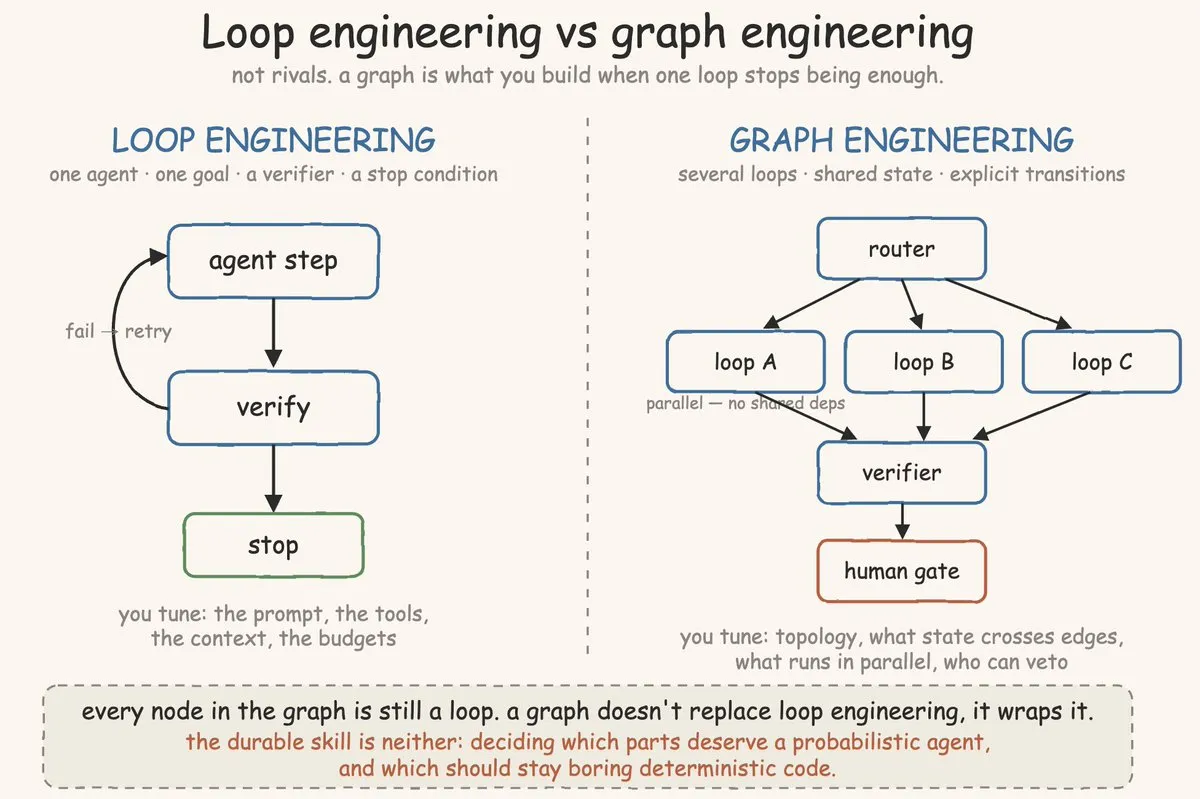
- 循环工程是一个智能体节点:一个智能体、一个目标、一个验证器、一个停止条件。
- 图工程是这些循环周围的拓扑结构:存在哪些节点、哪些转换是合法的、每条边传递什么状态。
它们不是对手。当一个循环不再够用时,你就构建图,而图中的每个节点仍然是一个循环。
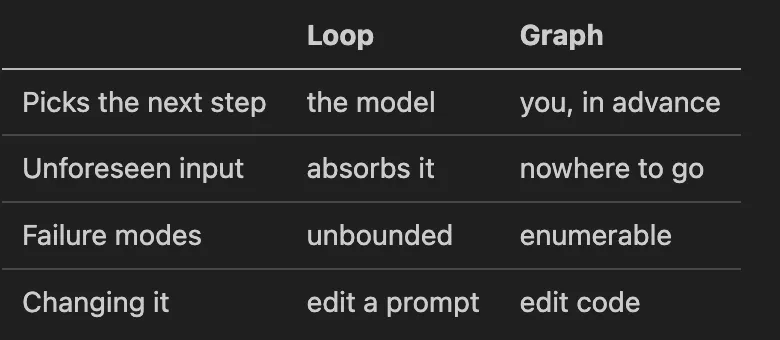
这决定了门控能承诺什么。在循环中,门控是模型选择调用的工具,因此它只与模型的判断力一样可靠。在图中,它是边上的一节点,而不可逆步骤没有绕过它的路径。
从一个循环开始。当一个决策失败的成本高到你觉得它应该不可能而不是不太可能时,把它移入图中,这通常是不可逆的决策,而且通常是最先处理的。
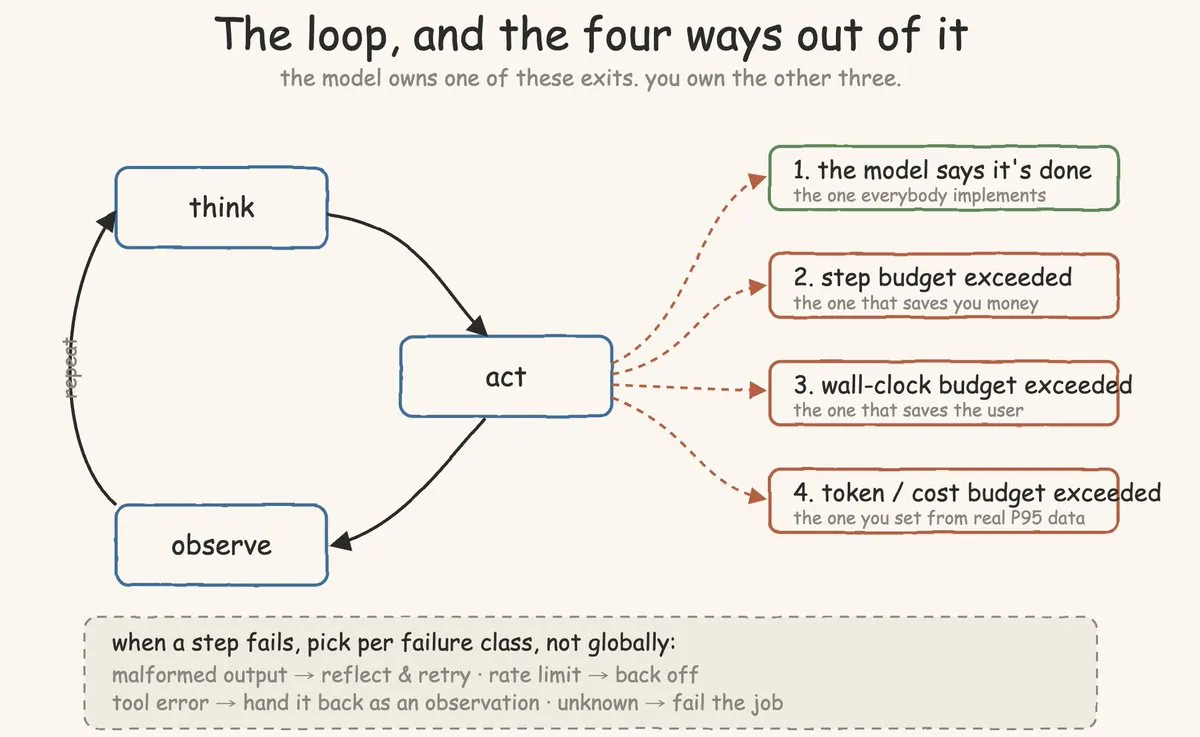
模型自己认为完成是最不可靠的停止条件。增加另外三个:步骤预算、墙钟时间预算、token 预算。模型掌握一个退出方式;你掌握另外三个。
一个停止取得进展的循环不会报错。每次调用都成功,并且大约每分钟花费一美元,直到有人注意到。
Part 3: Evaluation and Metrics(第三部分:评估与指标)
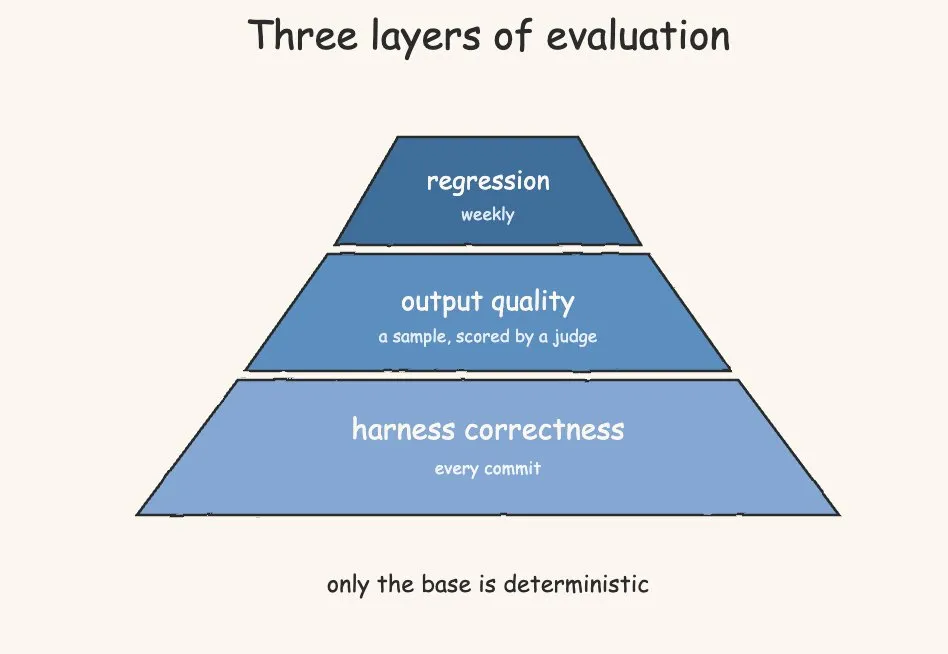
在设计智能体之前先设计评估。否则你就是盲飞。
评估框架
智能体系统产生的输出看似正确但经常出错。你无法在 CI 中测试正确性。你需要一个框架来评估质量、捕捉回归并比较变体。
三层评估:
第 1 层:框架正确性(确定性,可在 CI 中测试)
- 编排流程是否正确?
- 工具是否返回预期的模式?
- 状态是否按预期转换?
- 结果是否正确组装?
第 2 层:智能体输出质量(非确定性,基于采样)
- 输出是否符合规范?
- 事实是否准确?
- 推理是否合理?
- 格式是否正确?
第 3 层:端到端回归(自动化,定期)
- 每周通过系统运行一组固定的测试集
- 使用评判模型将结果与基线进行比较
- 在回归影响生产之前标记出来
标准指标
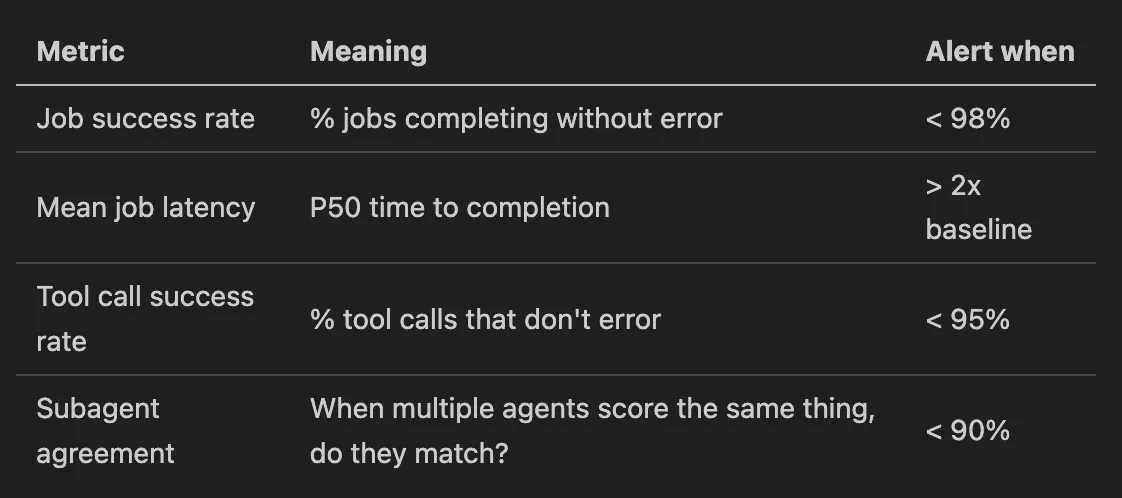
对于编排层:
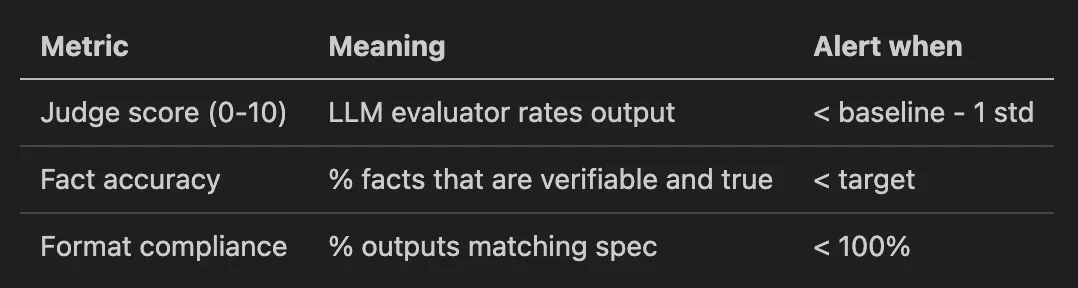
对于输出质量:
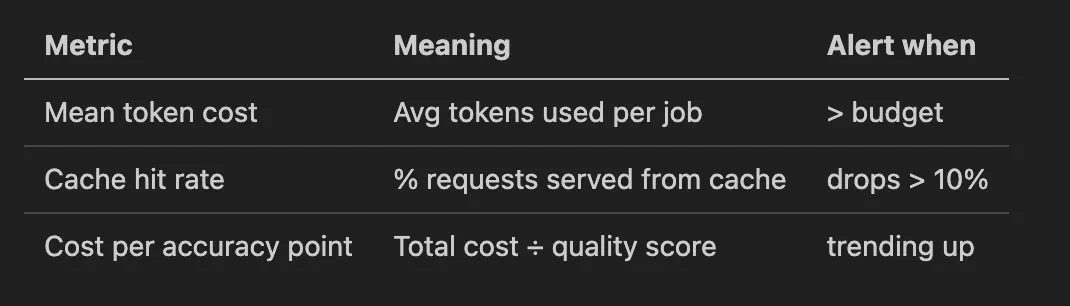
对于成本和效率:
LLM as a Judge(用 LLM 做评判)
不要让人来给智能体输出打分。用另一个 LLM。
评判者是一个专门的智能体,其唯一职责:根据评分标准评估输出。
class JudgeAgent:
    def evaluate(self, output: str, rubric: EvaluationRubric) -> Score:
        prompt = build_evaluation_prompt(output, rubric)
        response = self.model.invoke(prompt)
        score = parse_score(response)

        return Score(
            value=score.value,
            reasoning=score.reasoning,
            failures=[...],
            confidence=score.confidence
)评判者产生结构化输出:
@dataclass
class Score:
    value: float  # 0-10
    reasoning: str  # why this score?
    failures: list[str]  # what went wrong
    confidence: float  # how sure is the judge?
suggest_fix: str # what would improve it?使用评判者来:
- 对每天的输出进行抽样评分(100-200 个任务)
- 标记回归:如果今天的 P50 评判分数 < 基线 - 1σ,则发出警报
- 比较变体:在相同的 100 个测试用例上运行版本 A 和版本 B,比较评判分数
- 迭代改进:当评判者发现失败模式时,将其添加到测试集中
重要:通过以下方式测试评判者本身:
- 对已知正确和已知错误的输出进行评分,评判者应该区分它们
- 检查评判者在边缘情况上的一致性,如果两个评判实例不一致,则说明评分标准模糊
- 将评判分数与人类分数进行比较,它们应该相关
生产环境中的持续评估
每周评估运行:
# Every Monday morning
def eval_run():
    sample = db.jobs.sample(200)
    scores = []
    for job in sample:
        score = judge.evaluate(job.output, job.rubric)
        scores.append(score)

    baseline_mean = 7.2
    current_mean = np.mean([s.value for s in scores])

    if current_mean < baseline_mean - 0.5:
        alert("Regression detected", current_mean)

    db.metrics.insert(date=today, mean_score=current_mean)
通过评判员进行 A/B 测试:
def compare_variants(prompt_old, prompt_new, test_set_size=100):
    test_jobs = db.jobs.sample(test_set_size)

    scores_old = []
    scores_new = []

    for job in test_jobs:
        result_old = orchestrator.run(job, prompt_old)
        score_old = judge.evaluate(result_old)
        scores_old.append(score_old)

        result_new = orchestrator.run(job, prompt_new)
        score_new = judge.evaluate(result_new)
        scores_new.append(score_new)

    mean_old = np.mean(scores_old)
    mean_new = np.mean(scores_new)

    if mean_new > mean_old + 0.3:
        return "ship"
    else:
return "revert"The Scorecard(评分卡)
并非每个系统都构建所有这些。每个系统都有它们决定。唯一的问题是你决定了还是默认了。
- 工具:少量,每个单一动作,类型严格,带超时和日志行
- 提示词:先静态后动态,版本化,缓存键与它们一起版本化
- 记忆:工作记忆和持久记忆分开,一次播种而不是每轮重新发送
- 编排:顺序子智能体优先于并行子智能体;状态单向流动
- 人机回环:以不可逆性为门控,而非重要性;足够罕见,使门控仍有意义
- 循环 vs 图:从一个循环开始,当决策失败应该是不可能的而非不太可能时,将其移入图中
- 停止条件:四个出口,其中只有一个由模型控制
- 评估:每次提交时测试基准,输出采样并在带外评判
注意其中有多少与模型无关。在底层更换模型,这八项全部不变,这正说明应将其视为真正的工程,而非外围管道。
第 2 部分是运行所需的后端:队列、工作器、两个存储,以及为什么智能体工作负载会打破你在 Web 服务中所有的直觉。第 3 部分将其部署到 AWS 上。
Further reading(延伸阅读)
- Awesome Harness Engineering:涵盖所有这些领域的精选分类
- Agent Harness for LLM Agents: A Survey:23 个系统的比较
- Graph Engineering vs Loop Engineering: What Actually Changed:对该部分最清晰的阐述
- Agentic AI System Design Explained in 27 mins 作者 @aiwithaish
- 3 Years of Graph Engineering with LangGraph:同一论点的框架层面
- Context Engineering: Memory, Compaction, and Tool Clearing:更多关于
- The Agent Harness: Why the LLM Is the Smallest Part:本文所依托的框架
- My PoC: Agent Harness Ops
