
每个 AI 智能体演示都是从开发者在笔记本电脑上运行原始生成的代码开始的,而每次生产部署都是从安全团队询问当该代码变得敌对时会发生什么开始的。
当你赋予 LLM 访问终端的权限时,你就是在让一个不可预测的概率引擎能够编译二进制文件、安装第三方包、修改本地文件并发出出站网络请求。如果你在没有隔离的情况下在共享主机内核上运行该代码,一次内核漏洞利用或恶意包就可能危及你的整个基础设施。
在过去的几个季度里,我们一直在 Google Cloud 和开源技术栈上对智能体沙箱运行时进行基准测试、破解和运行测试。我们发现,标准的云基础设施假设在应用于自主智能体时会失效。许多智能体的行为既不像具有稳定 HTTP 流量的微服务,也不像执行完就退出的批处理作业。它们 95% 的会话时间都在等待模型推理或外部工具,中间穿插着短暂的密集执行突发。
作者:Ryan Ismert(@ryan_ismert)和 Alan Blount(@zeroasterisk)
以下是你需要了解的公共沙箱格局、隔离原语的实际对比,以及如何为你的智能体选择正确的执行基础:
- 冷启动营销数据是在空循环上测量的,而非真实运行时。
- 隔离谱系取决于与邻居共享了哪些代码层。
- 对自主智能体而言,网络出口比虚拟化层是更大的攻击面。
- 状态分叉和内存快照比原始启动时间更重要。
- 在选择沙箱技术栈之前,使用一个 4 问题决策清单。
免责声明:这专门是对最常见的智能体沙箱解决方案的评测,还有数十种更专业的用例和解决方案。欢迎提出希望在后续文章中看到的内容。
1. Cold-start marketing numbers are measured on empty loops, not real runtimes(冷启动营销数据是在空循环上测量的,而非真实运行时)
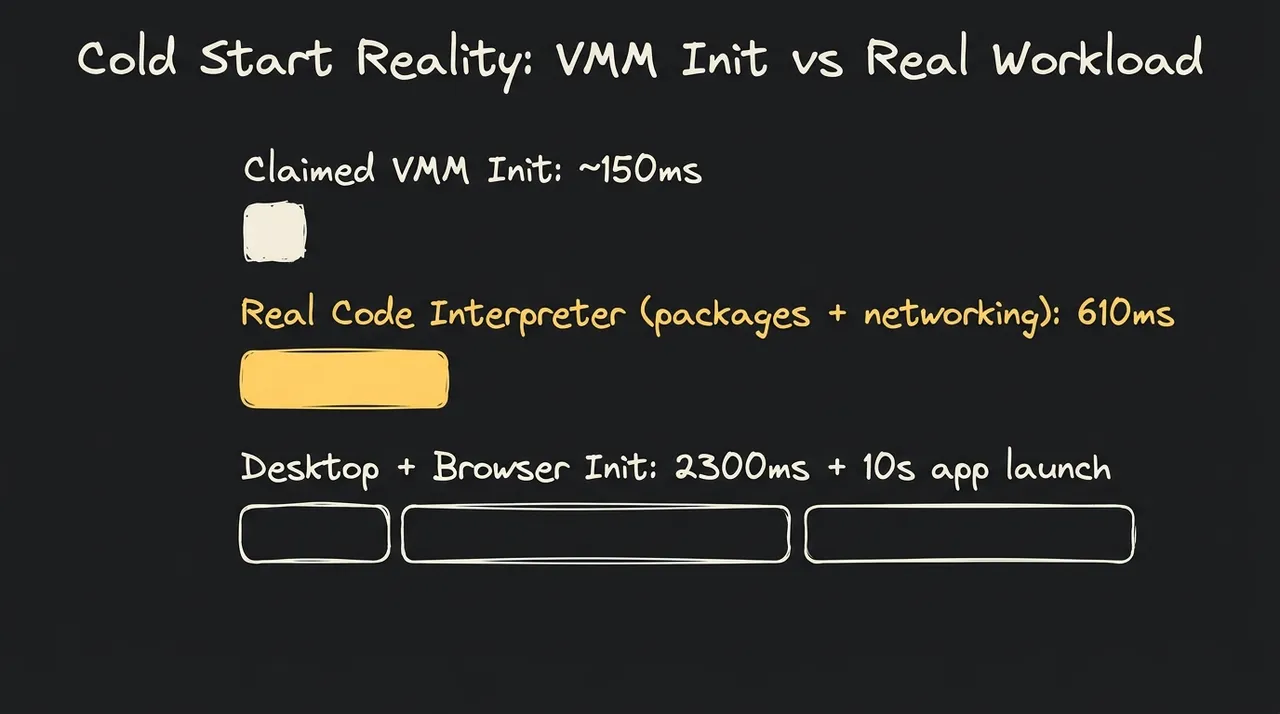
如果你最近评估过沙箱提供商,你可能见过主页上宣传 100 毫秒或 150 毫秒的冷启动时间。但当你将该沙箱接入智能体循环并执行真实脚本时,你的第一轮交互突然需要三秒钟才能响应。
差距来自测量对象的不同。供应商基准测试通常测量的是最小虚拟机监视器(VMM)启动一个精简 Linux 内核到空闲命令提示符所需的时间。那是一个空循环。在真实的智能体工作流中,你的沙箱必须挂载 overlay 文件系统、初始化 Python 或 Node 运行时、设置网络接口,并加载重型数据科学或浏览器自动化库。
在我们 2026 年 8 月使用 e2b_code_interpreter SDK 进行的测试中,引导一个标准的 2 vCPU / 1 GB 沙箱在多次运行中平均耗时 610 毫秒——大约是裸机 150 毫秒 Firecracker VMM 初始化声称的 4 倍。当你升级到 8 vCPU / 8 GB 桌面容器时,引导延迟攀升至 2.3 秒,这还不包括无头 Chromium 完全初始化所需的约 10 秒。这个成本即使只是为了加载一个 3 行的 JSON 端点也需要支付。
为了在生产环境中解决这个问题,现代智能体基础设施将运行时供应与调用解耦。像 kubernetes-sigs/agent-sandbox 这样的项目使用预热模板池(SandboxWarmPool),而 agent-substrate/substrate 等系统将活跃智能体会话多路复用到预热工作节点上。当预热池得到有效管理时,稳态分配降至 p90 200 毫秒,使交互式智能体对话保持响应迅速。
如何使用:测量真实世界的冷启动并了解你的流量形态。为最常见的环境模板实现预热工作节点池,并保持容器基础镜像最小化,这样初始化开销就不会主导你的延迟预算。
2. The isolation spectrum is defined by what code is shared with your neighbor(隔离谱系取决于与邻居共享了哪些代码层)
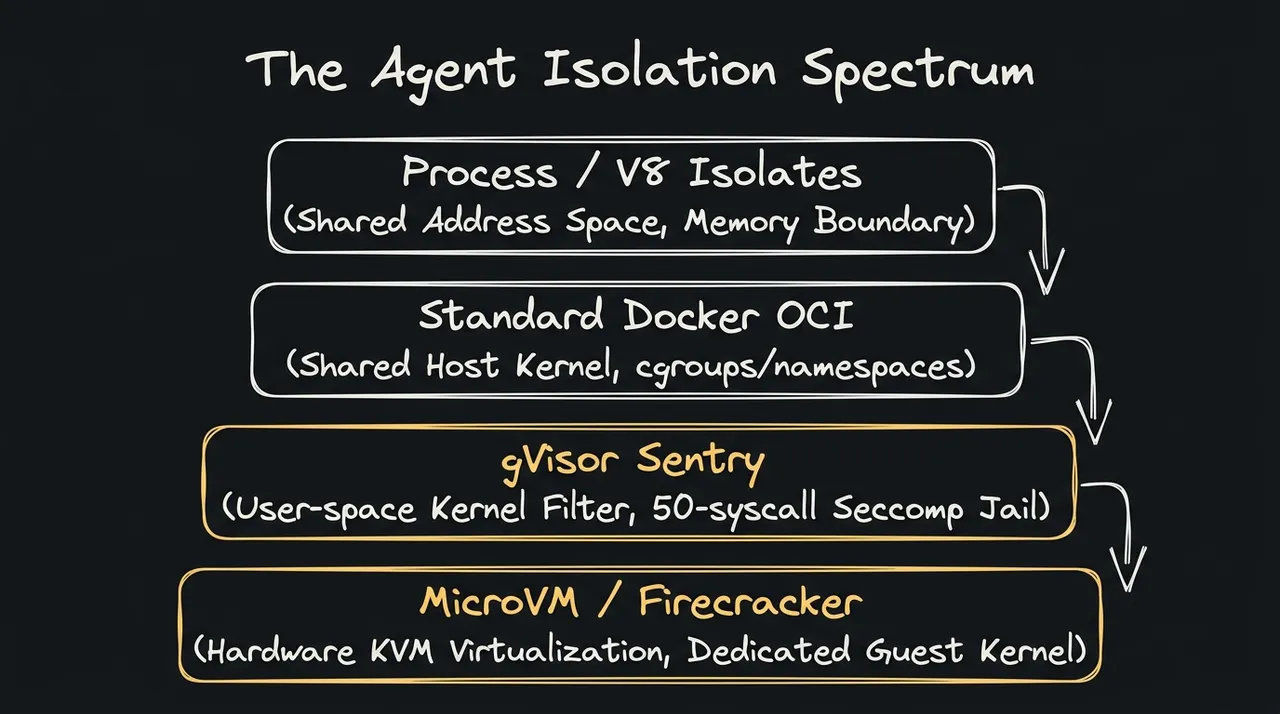
当你的安全团队询问在 Docker 中运行模型生成的代码是否适合生产环境时,答案归结为一个技术问题:不可信的智能体和底层主机之间共享了哪个软件层?
标准 OCI 容器(如默认的 Docker 或 Kubernetes Pod)共享主机 Linux 内核。它们依赖 cgroups、Linux 命名空间和 seccomp 配置文件来隔离进程。如果不可信的智能体运行了触发内核权限提升的代码(如 Dirty Pipe 或 Leaky Vessels 等容器逃逸漏洞),攻击者就能完全控制主机节点。Kubernetes 文档对此明确指出:标准 Pod 不是硬性多租户边界。
隔离格局分为四个不同的架构层级:
- 进程和 V8 隔离(如 Cloudflare Workers、Deno Core):代码在同一操作系统进程中运行于隔离的内存堆中。启动延迟极快(低于 5 毫秒),密度极高,但工作负载仅限于 JavaScript、TypeScript 或编译后的 WebAssembly。你无法运行任意的 Linux 二进制文件或 C 扩展 Python 包。
- 标准 OCI 容器(如 Docker、runc):原生执行速度和完整的操作系统兼容性,但共享的主机内核使其对多租户、不可信的 LLM 代码执行不安全。
- 用户空间内核(如 gVisor / runsc):在基于 Go 的用户空间控制平面(Sentry)中拦截应用程序系统调用,并通过严格的 seccomp 隔离过滤主机访问。它提供容器级别的密度而不暴露主机内核。虽然系统调用密集的操作(如 fork 密集的构建管道)会有虚拟化开销,但 CPU 密集型代码以接近原生的速度运行。迄今为止没有公开记录的 Sentry 到主机的逃逸事件。
- 微虚拟机(如 Firecracker、Cloud Hypervisor、Kata Containers):在硬件辅助的 KVM 虚拟化边界内运行一个专用的最小化 Linux 客户机内核。这是硬性租户隔离的金标准,尽管每个微虚拟机都会带来专用的客户机内存开销。
(在标准 rootless Docker 中运行任意的 LLM 生成的 bash 命令,基本上就是把你的集群押注在模型永远不会生成一个命中零日内核竞态条件的 C 代码片段上。)
如何使用:如果你在可信的私有代码上运行内部开发智能体,标准加固容器就足够了。如果你正在构建一个代表多个用户执行不可信代码(而且所有 LLM 生成的代码都是不可信的)的平台,选择 gVisor 或微虚拟机。绝不要仅依赖标准命名空间隔离作为你唯一的防御。还需要多层额外防御,例如使用 Model Armor 保护输入输出,或者更重要的是网络出口……
3. For autonomous agents, network egress is a bigger attack surface than the hypervisor(对自主智能体而言,网络出口比虚拟化层是更大的攻击面)
当安全工程师评估沙箱时,他们通常 90% 的时间在审计虚拟化边界,10% 在网络。对 AI 智能体而言,这个优先级是反过来的。
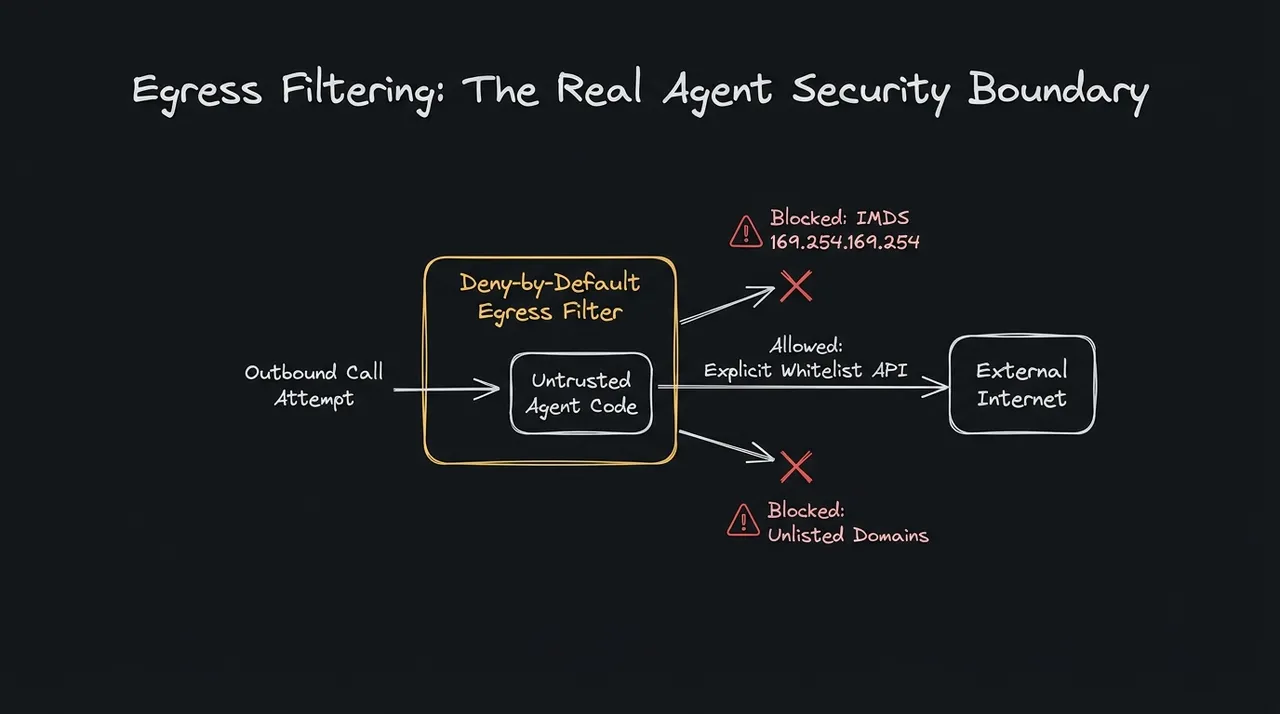
通过提示词注入攻破智能体的攻击者不需要虚拟化逃逸。如果你的沙箱具有不受限制的出站互联网访问,智能体可以窃取敏感文件、查询内部云元数据服务(如 169.254.169.254),或使用标准 HTTP 请求窃取环境 IAM 凭证,完全不需要任何漏洞利用。
而且即使发生了虚拟化逃逸,网络控制也能提供额外的纵深防御,阻止对网络上其他资源的横向访问。正如近期高能力网络智能体所展示的漏洞利用那样,仅依赖虚拟化安全性不足以限制破坏性后果。
在生产智能体环境中,网络出口必须默认拒绝。沙箱执行环境应阻止所有出站互联网流量,除非提供了显式的域名或 IP 白名单。
此外,环境凭证必须被剥离。沙箱进程不得继承父进程的环境变量、秘密令牌或对实例元数据端点的访问权限。如果智能体需要调用外部 API,这些请求应通过身份感知网关(如 Agent Gateway)路由,在沙箱边界之外强制执行令牌验证。
如何使用:对每个沙箱网络桥接应用默认拒绝的防火墙规则。显式阻止对链路本地地址(169.254.0.0/16)的访问,并对任何需要包下载或外部 API 调用的工具调用要求显式域名白名单。
4. State forking and memory snapshots matter more than raw boot time(状态分叉和内存快照比原始启动时间更重要)
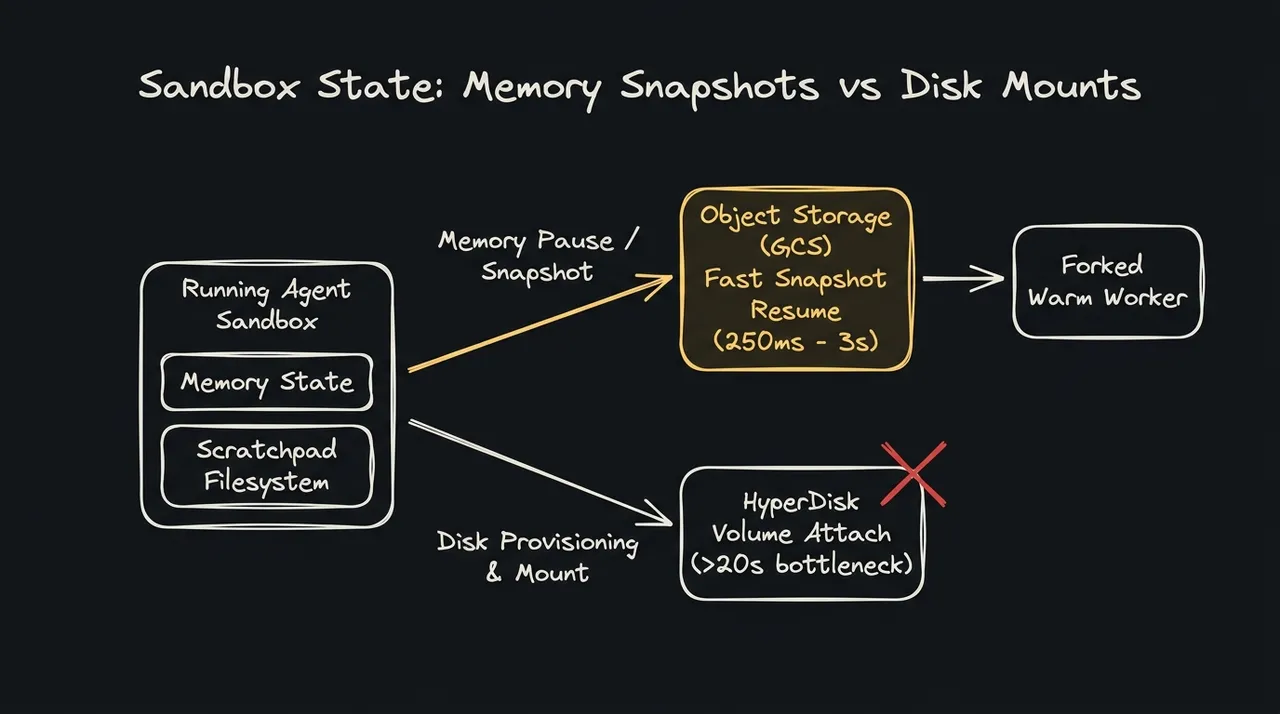
典型的智能体会话跨越多个交互轮次:检查文件、运行测试、遇到失败、编辑代码。如果你的沙箱在每个轮次都销毁状态,你的智能体就会丢失其工作区上下文。
但维护状态存在架构困境。持续运行专用虚拟机在智能体 95% 的空闲会话时间里都在烧钱。但按需将持久块磁盘附加到新实例会在每轮增加 20 多秒的挂载开销。
现代解决方案是将内存检查点保存到对象存储(如 Cloud Storage)。当智能体进入空闲状态时,运行时暂停内存状态并将增量快照写入对象存储。当下一个工具调用到达时,预热工作节点在 250 毫秒到 3 秒内恢复快照,保留工作区状态而不消耗空闲 VM 预算。
在优化后的预热多路复用工作节点池上,并发负载下的每次调用执行延迟持续降至 p50 约 50 毫秒,而相比之下无池化的串行执行后端则高达 500 毫秒以上。
如何使用: 将临时的沙箱执行与持久数据分离。将持久的智能体工件存储在云对象存储中,并在活动轮次期间为本地文件系统操作使用写时复制草稿板。这应内置在你选择的沙箱服务或平台中,并具备可审计的安全保证。
5. Use a 4-question decision rubric before picking your sandbox stack(在选择沙箱技术栈前使用 4 个问题的决策准则)
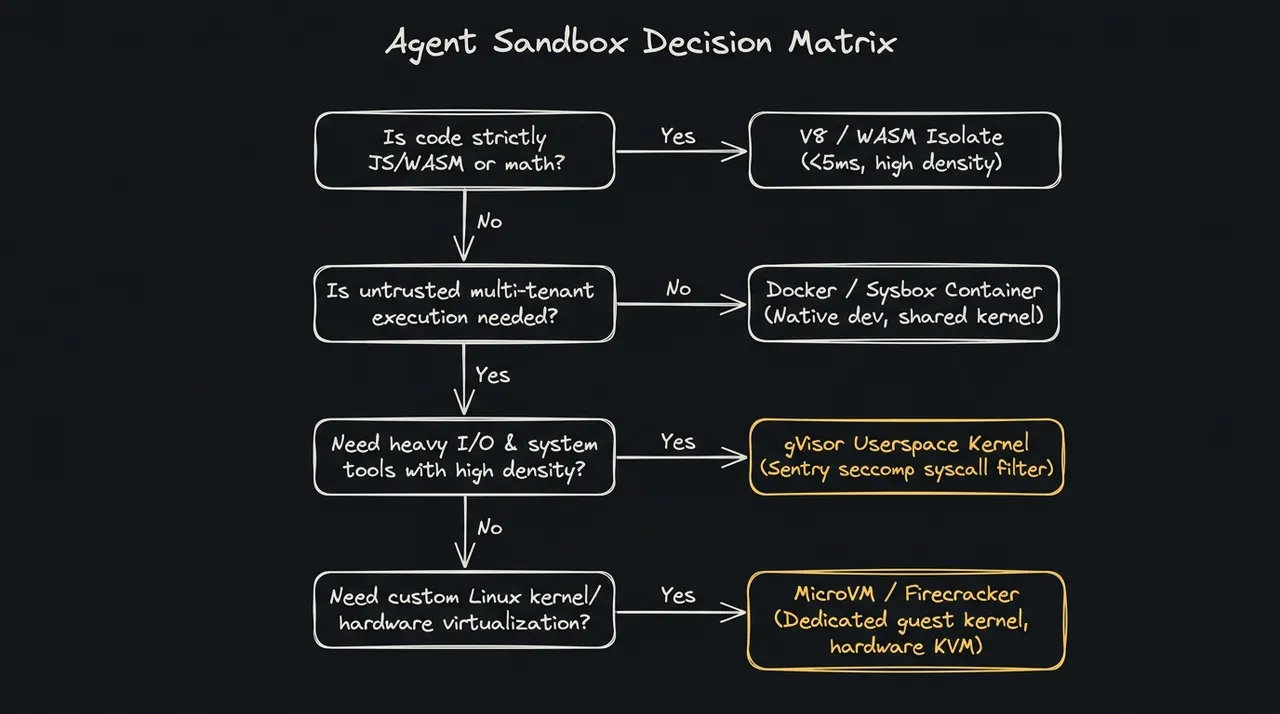
面对云提供商和开源工具中的数十种运行时选项,选择正确的沙箱归结为评估四个技术约束:语言范围、多租户、I/O 配置文件和硬件虚拟化需求。
在编写基础设施代码之前,先遵循此决策树:
- 你的工作负载是否仅限于纯 JavaScript、TypeScript 或确定性数学?选择:V8 Isolates 或 WebAssembly。你获得低于 5 毫秒的启动时间、最小的内存开销和极高的密度。
- 你是否在运行受信任代码的单租户内部开发者工作流?选择:标准的加固 OCI 容器(Docker / containerd)。你获得完整的操作系统工具、快速的构建和无需虚拟机管理程序开销的原生性能。
- 你是否需要高密度、多租户不可信执行以及完整的 Linux 用户态工具?选择:用户态内核(gVisor / Agent Platform Sandbox / GKE Sandbox / Cloud Run Sandbox)。你获得强大的系统调用隔离、低内存开销和快速恢复,而无需维护虚拟机管理程序。
- 你是否需要自定义 Linux 内核模块、专用客户机内核或硬件级隔离?选择:微虚拟机(Firecracker / Kata Containers / Cloud Hypervisor)。
(如果有人试图让你相信单一沙箱技术是以上四种用例的最佳选择,请检查他们是否在销售计算积分。)
如何使用: 首先,列出你的智能体实际运行的精确命令。如果 90% 的工具调用是使用数据分析库的标准 Python 脚本,则先部署托管用户态沙箱。如果需要更多,值得模拟真实的端到端流量,并在保护和扩展时对总拥有成本进行基准测试。
Verify it yourself(自行验证)
确保你是在进行同类比较,并确保测试真实沙箱的完整生命周期,而不仅仅是听信炒作。
- 快速入门 CLI:使用 Agents CLI 从任何本地智能体创建和管理沙箱。
- 完全托管:选择 Gemini Enterprise Agent Platform 以获得托管沙箱、出口控制和亚秒级扩展。
- 自管理 Kubernetes:使用 GKE Agent Sandbox 以对容器密度和 VPC 边界进行专用控制。
- 开源路线图:关注 Agent Substrate 以了解下一代智能体 actor 调度。
如果你觉得这篇文章有用,请查看我们之前关于 智能体循环韧性 和 长时程夹具设计 的文章。关注 @GoogleCloudTech 以获取更多来自构建者一线的深度解析。
