
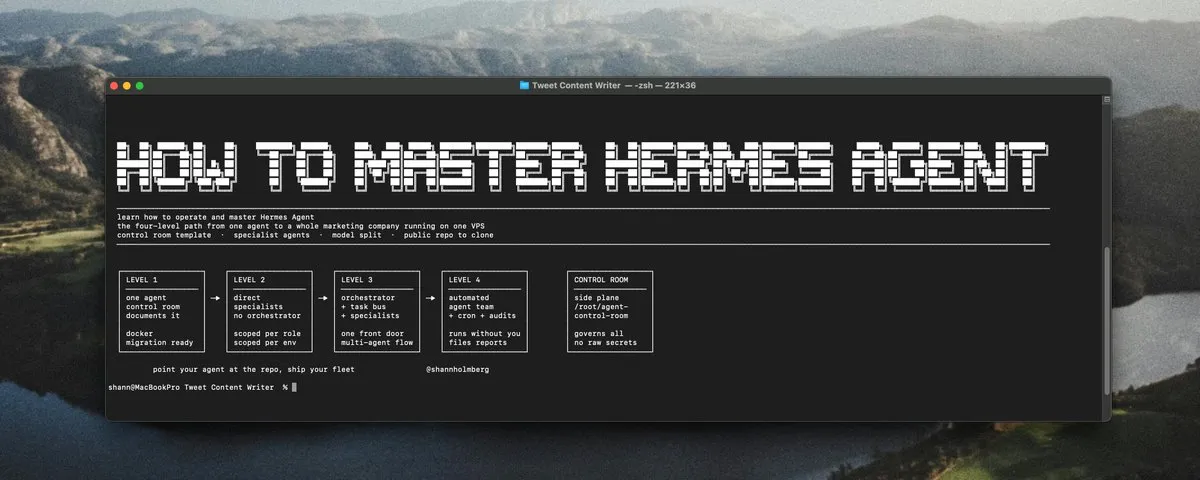
学习如何操作并掌握 Hermes Agent:搭建 Agent 控制室模板,配置专职 Agent,并从一个 Agent 扩展到一整套运行在同一台 VPS 上的营销公司。
大多数 AI 工具只是在回答问题。Hermes Agent 会端到端运行你的工作流。
它可以操作你的浏览器,执行终端命令,安排定时任务,监控收件箱,起草工作内容,并把结果发布到你实际工作的地方:Telegram、Discord、Slack,或者你正在处理的邮件会话。
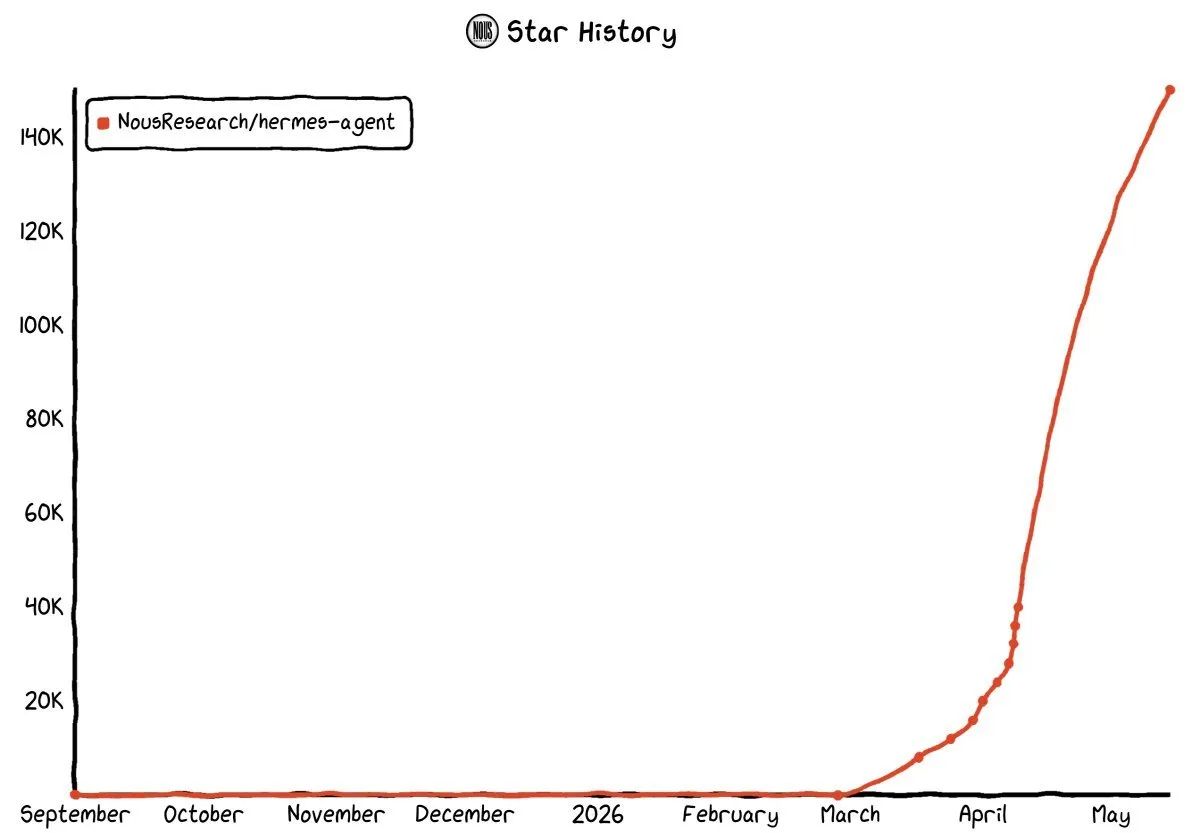
它由 @NousResearch 构建,是开源项目,GitHub 星标已经达到 150,000。目前在 OpenRouter 的全球 token 使用量中排名第 1。
过去几周,我围绕它搭建了自己的整套营销运营体系。接下来这篇文章,就是如果我今天从零开始,会如何设置它。
这篇文章会给你什么
- Hermes Agent 是什么,以及为什么营销人员(不仅仅是开发人员)应该关注它
- 面向普通读者的架构版本:大脑、个性、技能集,以及它们如何都放在同一个文件夹里
- 我自己正在 Hermes 上运行的使用场景,以及我围绕它们发布过的 4 篇文章
- 四部分心智模型:你、控制室、Agent、可选任务总线;以及从“笔记本上的一个 Agent”到“在 VPS 上运行、可用手机控制的全自动 Agent 团队”的四个设置等级
- 我用来把营销工作流从混乱想法推进到自主部署的“原型到生产”方法
- 如果今天从第一天开始,我会希望自己拥有的资源:文档、社区地图、值得关注的人、正在发生的线下活动
- 真实取舍,以及它仍然会在哪里出问题
这篇文章里我不卖任何东西。Hermes 是开源的,Nous Portal 有免费层,大部分社区生态也是免费的。你可以 fork、修改,让它变成你自己的东西。
Hermes Agent 是什么
简短版本: 一个运行越久、能力越强的自主 Agent。
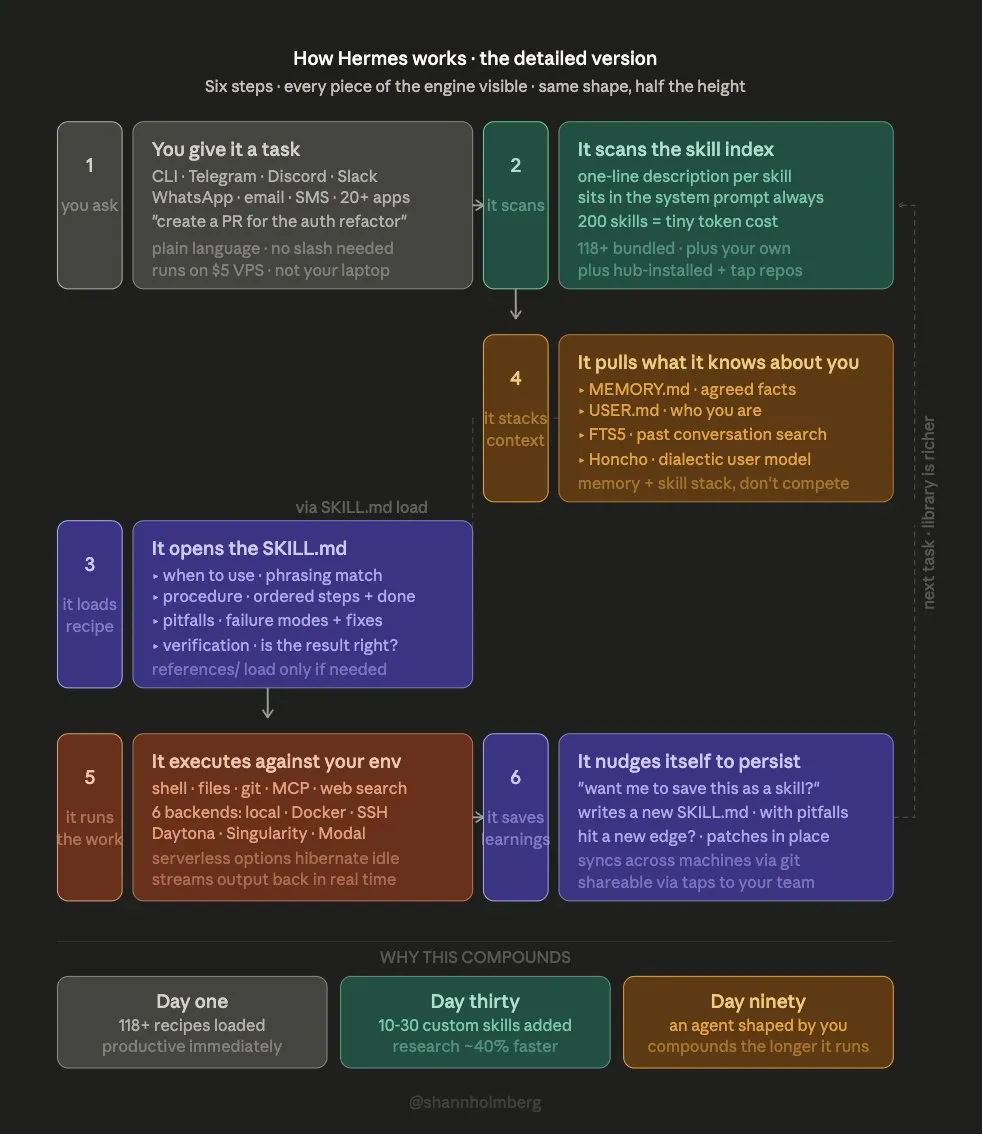
展开版本: Hermes 是 Nous Research 构建的框架,可以把一个模型变成持久化执行器。它有自己的记忆,能跨会话保留上下文。它会在工作过程中写自己的技能。它内置了 123 个已经做好的技能(GitHub 工作流、Obsidian、Google Workspace、Linear、Notion、Typefully、Perplexity、Deep Research,以及 100+ 其他能力)。它可以住在任何你放置它的地方:你的笔记本、Docker 容器、VPS、无服务器运行环境。你也可以通过 20+ 个入口和它对话:Telegram、Discord、Slack、邮件、语音模式,或者直接在终端里。
如果你用过 Claude Code 或 OpenClaw,Hermes 的形状类似,但哲学不同。
Hermes 像 Rails:带有明确取向的默认配置,开箱即用,第一天就能用很少设置进入生产力状态,Agent 会替你做更多思考。
OpenClaw 像 Linux:提供原语、保证和显式控制。Agent 只做你明确告诉它做的事,不多做。
两者都合理。我运行 Hermes,是因为它的内置默认能力会复利增长。每个用 Hermes 开始的项目,Agent 在我写任何配置之前,就已经知道如何做 100+ 件事情。对我来说,这种起步优势很值得。我也注意到,Hermes 在网关断连或出 bug 方面,远没有同类项目那么明显。
Nous Research 最近拿到的数字本身就是证明:
- OpenRouter 全球 token 使用量第 1(在平台上的所有模型和框架中)
- Hermes 仓库有 150,000 个 GitHub 星标
- 123 个内置技能,还没算 Agent 自己写的
- 网关中有 70+ 个内置工具,再加上一个订阅下的 300+ 个模型
- 6 个部署目标:本地、Docker、SSH、Daytona、Singularity、Modal
- 20+ 个消息入口:Telegram、Discord、Slack、邮件、语音
如果你是 AI 营销人员,却还没有开始运行 Hermes,那么你每周都在把会复利增长的能力留在桌面上。
它如何工作(读者友好版)
每个 Hermes Agent 都有三样东西。
一个大脑。 记忆位于 ~/.hermes/memories/。两个文件 MEMORY.md 和 USER.md 会在会话开始时注入。你的语气评分规则、品牌笔记、客户语言、上周的修正反馈,都会在第一个提示词之前加载。会话存储在 SQLite 里,跨会话召回支持全文搜索。
一个个性。soul.md 是风格气质所在的地方:简洁、讽刺、直接、正式、快速,或者深思熟虑。你可以启动 6 个 Agent,让每个都有不同的 soul 配置,底层使用同一个大脑。一个是带成交气质的外联代表,一个是喜欢长句子的研究员,还有一个是把所有内容都保持简短的助理。
一套技能集
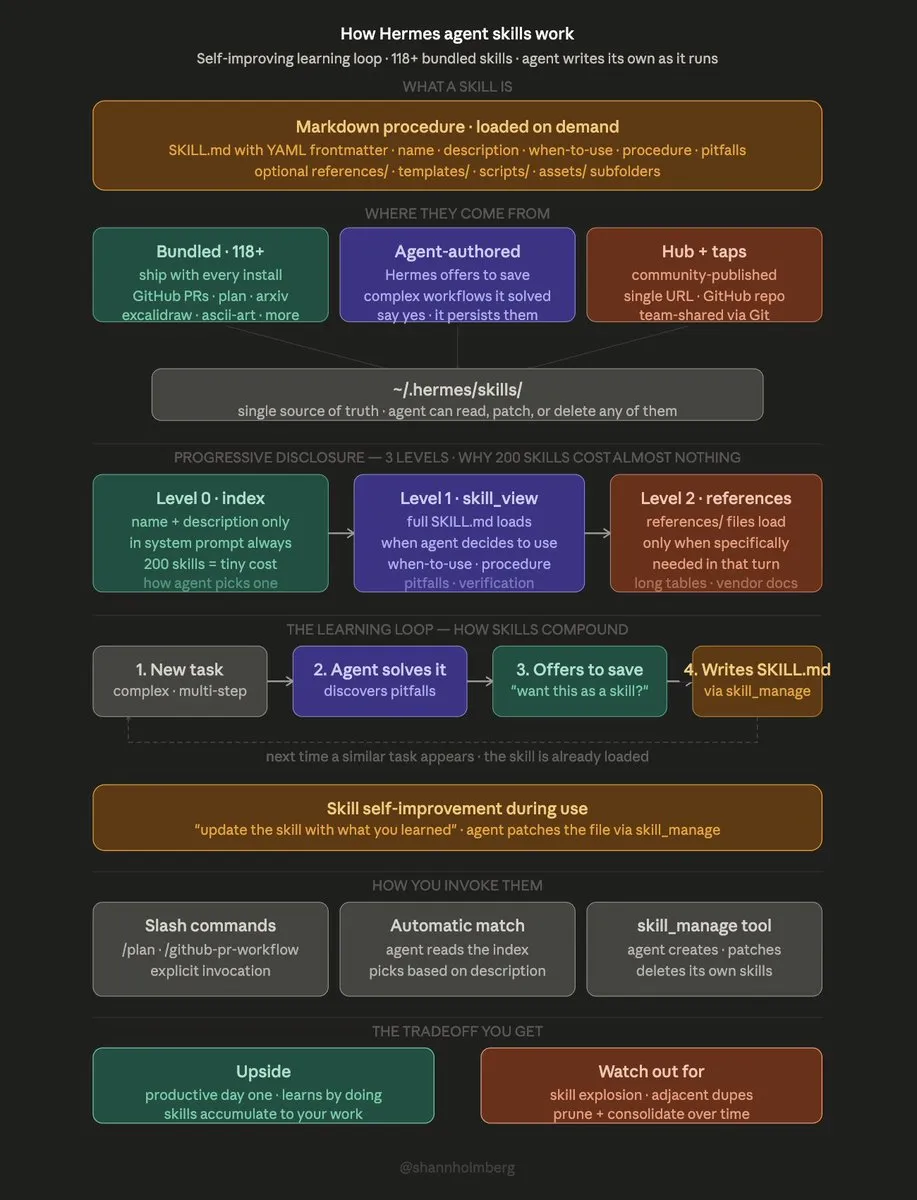
开箱即有 123 个技能:GitHub PR、Obsidian、Google Workspace、Linear、Notion、Typefully、Perplexity、Deep Research、浏览器控制、网页抓取、视觉、语音、日程调度。还有闭环学习机制:Agent 一边工作,一边写下新的技能。你的个人技能库会在这 123 个之上不断增长,而且不需要你亲自写它们。
然后是 Agent 能对接的对象。
- 工具网关:一个订阅,300+ 个模型,内置网页抓取和浏览器自动化
- MCP 集成:任何支持 Model Context Protocol 的外部服务,都能变成 Agent 可使用的工具
- 20+ 个消息入口:Telegram、Discord、Slack、邮件、语音,再加 CLI 本身
以及 Agent 可以住在哪里。
- 你的笔记本(本地)
- 一个 Docker 容器(隔离、可移植,也是我运行它的方式)
- VPS 上的 SSH 会话(这样即使笔记本合上,它也会继续运行)
- Daytona、Singularity、Modal(如果你不想管理基础设施,可以走无服务器方案)
闭环学习机制是它区别于聪明聊天机器人的地方。Agent 会观察自己如何工作,在学会你的工作形状时写新技能,定期优化自己的记忆,并用全文搜索与 LLM 摘要的组合,在多个会话之间召回过去的上下文。你下周不需要重新教它。
我告诉 Hermes 新手的一条规则是:
不要在第一天就试图自己写技能。运行真实工作,让 Agent 观察,让运行框架写技能。相比写提示词,通过实际工作构建自定义技能库会更快。
我正在 Hermes 上运行什么
我是 AI 营销人员,不是程序员。我在 Hermes 上运行的大多数东西都是营销基础设施,偶尔也有内部工具。下面是真实清单:
- 一个个人助理,同时处理业务和私人事项,住在 Telegram 里;每天早上标记 4 封值得读的邮件,安排提醒,概括我错过的会议
- 一个营销工作流原型台,用真实工作跑 2-3 次,测试新流程(引流资料、广告创意审阅、内容冲刺),再把它们提升到正式工作流
- 专职营销 Agent:SEO、外联 / BD、设计审阅、内容写作,每个都有自己的 soul 配置和职责范围
- 一个公司大脑,监控 Slack、聊天、邮件、逐字稿、语音备忘录,并让所有内容都可查询。当我问“我们上个月和那个客户关于定价说了什么”时,我能在 3 秒内拿到答案,而不是翻找 30 分钟
- 一个 SEO Agent,在一个 Docker 容器里跑完整流水线:从种子关键词到已发布文章,共 21 步,中间不需要人工介入,直到最终审阅
- 一个内容分发 Agent,把一篇长文内容(例如这篇文章)拆解到 LinkedIn、X、Threads,并使用适配各个平台的开头钩子
- 一个编排 Agent,它自己不产出工作,只是基于我的请求,把任务路由给合适的专职 Agent
我曾经发过一张蓝图来概括它:
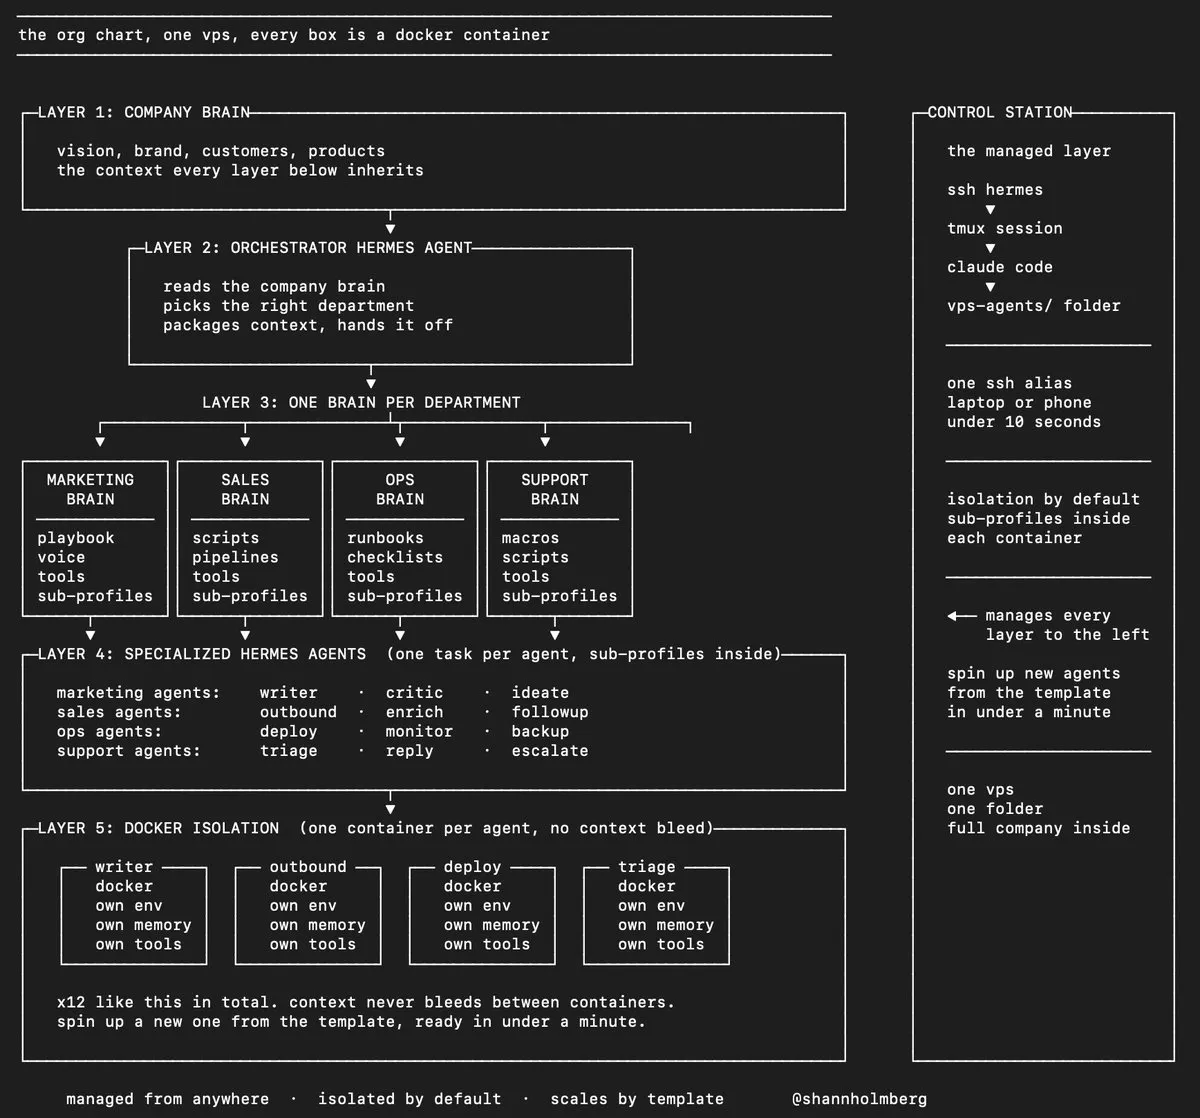
其中 SEO Agent 值得放大看,因为它是我已经公开发布的那个,也最容易映射到本文后面架构部分。五层结构,全在一个 Docker 容器里,从种子关键词到已发布文章共 21 步。
这 21 步在终端里长这样:
[调研 + 构思]
  01 种子关键词
  02 SERP 快照
  03 竞品提取
  04 意图 + 形式分析
  05 内容 + 视觉缺口
  06 内部验证
  07 外部验证

[生产]
  08 角度 + 定位简报
  09 视觉策略简报
  10 大纲
  11 初稿
  12 图像生成
  13 流程图生成
  14 视觉 QA
  15 文章 QA

[分发]
  16 发布准备
  17 Schema
  18 内链
  19 多渠道同步
  20 数据分析配置
  21 监控
这条流水线上方的层级:
- 公司大脑 位于最上层:愿景、品牌、受众、产品。每个 Agent 都会读取它
- Hermes 编排 Agent:接收主题或种子关键词,并把它路由给 SEO Agent
- SEO 大脑:排名打法手册、语气规则、内容格式、视觉风格指南、每种格式的成功标准。所有 SEO 专属上下文都在这里
- SEO Agent 内部的三个子 Agent,每个负责一个阶段
- 调研 + 构思:种子关键词、SERP 快照、竞品提取、意图和形式分析、内容和视觉缺口、内部和外部验证
- 生产:角度和定位简报、视觉策略简报、大纲、初稿、图像生成、流程图生成、视觉和文章 QA
- 分发:发布准备、Schema、内链、多渠道同步、数据分析、监控
- 一个 Docker 容器 承载所有三个子 Agent。它们共享环境、记忆和工具。子配置会按阶段切换上下文。一个进程、一个文件系统、一组凭据。
为什么用一个容器而不是三个:SEO 工作是顺序性的。调研产出简报,简报进入生产,生产进入分发。每一步都需要记住上游已经决定了什么。拆成三个容器,就意味着要跨边界搬运状态,这会变贵,也会打断链条。
公司里的其他专职 Agent 都跑在同一个模板上。克隆 SEO Agent 模板,替换大脑(SEO 大脑 → 外联大脑,或 → 设计大脑,或 → 支持大脑),你就能为任何职能得到一个具有同样五层形状的新 Agent。
这些层不是装饰。它们是 Agent 在工作越来越专门化时不丢上下文的原因。公司大脑保持稳定,执行者可以迭代。大脑层让执行者可以被替换。
最近我还在里斯本的 @EspressioAI HQ 主持了一场 Hermes Agent 之夜,邀请了 Nous Research。@yeahfortommy 来自 Nous,做了问答;Noticed.so 的 Simao 展示了一个带自动研究能力的 Agent 运行框架;我则讲了我们如何在 Espressio 用 Hermes 做增长。
如果你在里斯本并想参加下一场,我会在确定排期后发出来。
从一个 Agent 到完整编队
在讲等级之前,先讲心智模型。
这个设置有四个部分:
- 你 是操作者。你可以直接访问系统的每个部分。
- Agent 控制室 是旁路控制平面。它不是一个你用来聊天的 Agent,而是
/root/vps-agents下的一个文件夹,用来记录并治理整个 Agent 编队。管理系统时,你会打开它、编辑它、检查它,或者让 Claude、Codex、Hermes 使用它。 - Hermes Agent 是执行者。有些是专职 Agent(SEO、开发、CMO、运营)。其中一个也可以选择性地作为编排 Agent。
- Agent 任务总线 是可选的交接台,位于编排 Agent 和专职 Agent 之间。只有当你已经引入编排 Agent 后才需要它。
整体看起来像这样:
                                  ┌───────┐
                                  │  你   │   操作者
                                  └───┬───┘
                                      │
        ┌─────────────────────────────┼─────────────────────────────┐
        │                             │                             │
   控制路径                    编排路径                    直接路径
        │                             │                             │
        ▼                             ▼                             ▼
 ┌────────────────────┐    ┌────────────────────┐    ┌────────────────────┐
 │ Agent 控制室       │    │ HERMES             │    │ 专职 Agent         │
 │ /root/vps-agents   │    │ 编排器             │    │                    │
 │                    │    │ (可选入口)         │    │ SEO · 开发 · CMO · │
 │ 文档 · 规则 ·      │    └─────────┬──────────┘    │ 运营 · 生活       │
 │ 运维手册 · env-map │              │ 派发任务       │                    │
 │ · 注册表           │              ▼               │ 可直接对话       │
 │                    │    ┌────────────────────┐    │ 无需路由         │
 │ 旁路控制平面       │    │ Agent 任务总线    │    │                  │
 │ 不存原始密钥       │    │ /srv/agent-bus     │    │                    │
 │                    │    └─────────┬──────────┘    │                    │
 └────────────────────┘              │               │                    │
                                     │ 路由           │                    │
                                     └───────────────▶                    │
                                                     │                    │
                                                     └────────────────────┘

 Agent 控制室治理这张图里的每个 Agent。它是
 单一事实来源,也是你管理这支编队的地方,而不是
 让工作从这里流过的地方。
存储拆分比很多人想象得更重要:
/root/vps-agents          → 控制室:文档、规则、运维手册、架构
                            永远不存原始密钥

/srv//data    → 实时运行环境:密钥、记忆、技能、会话、定时任务
                            每个 Hermes Agent 都住在这里
控制室回答的是这些问题:有哪些 Agent、它们做什么、使用哪些端口、引用哪些凭据、每个 Agent 能做什么和不能做什么,以及如何重启、调试或重建它们。实时运行环境里装的是真正运行时的东西。
控制室是定义系统的大脑。实时运行环境是运行系统的身体。你可以从大脑重建身体,但无法从身体重建大脑。
控制室内部:
/root/vps-agents/
  README.md
  CLAUDE.md
  agents/
    /
      inventory.md
      docker.md
      env-map.md
      runbook.md
      backup.md
  shared/
    security.md
    commands.md
  api-keys-sop.md
  orchestrator-and-fleet-skills.md
每个 Agent 的运行环境位于 /srv//data/:
.env
config.yaml
SOUL.md
memories/
skills/
cron/
sessions/
logs/
state.db
三种交互方式
控制路径:
   你 ──────► Agent 控制室
              (添加 Agent、轮换密钥、更新文档、调试设置)

直接路径:
   你 ──────► hermes-seo-espressio
              (直接和专职 Agent 对话,速度最快)

编排路径:
   你 ──► hermes-orchestrator ──► 任务总线 ──► 专职 Agent ──► 你
              (一个统一入口,路由并综合多 Agent 工作)
- 控制路径 是元层。用于添加 Agent、审阅文档、检查端口、轮换密钥、调试设置。
- 直接路径 最快。当你已经知道哪个 Agent 负责这项工作时使用。
- 编排路径 是综合器。当你想要一个统一入口来跨多个专职 Agent 路由并综合工作时使用。
第 1 级:一个 Agent
你有一个 Hermes Agent。就这样。控制室仍然可以存在(推荐),但它只记录这一个 Agent。
你 → 一个 Hermes Agent

控制室 → 记录这个 Agent
适合:初始设置、你的个人 Hermes、root 安装文档、简单的 Docker 迁移。
一个已经被使用过的 Agent,会带着你调好的个性,以及开始积累的记忆。把你想要的语气写进 SOUL.md,把业务稳定事实写进 MEMORY.md,把关于你的稳定事实写进 USER.md。把它接到 Telegram 或 Discord,让它住在你日常所在的地方。开始用它做真实任务。让它接触你的工具。让它在工作过程中写自己的技能。
MEMORY.md 保存稳定事实:你的业务是什么、客户是谁、产品做什么。USER.md 保存关于你的稳定事实:时区、工作时间、周期性项目、偏好的输出格式。随着你在真实对话中纠正 Agent,它们每周都会被优化。
第 2 级:直接使用专职 Agent
你有多个专职 Agent,但你仍然直接和每一个对话。还没有编排 Agent。
你 → hermes-life
你 → hermes-seo-espressio
你 → hermes-dev
你 → hermes-cmo
控制室会记录它们全部。
适合:清晰的角色分离、测试哪些 Agent 有用、避免过早编排、让凭据按 Agent 分范围隔离。
这里要避免的陷阱,是在证明专职 Agent 真有用之前就急着引入编排 Agent。先启动两三个,直接使用它们。只有当你发现自己想要一个统一入口时,再加入编排 Agent。
什么时候该启动新 Agent,什么时候继续用已有的:
需要自己的凭据 → 新 Agent

需要自己的长期记忆 → 新 Agent

持续重复、且属于独立角色的工作 → 新 Agent

否则继续使用现有 Agent
坏模式:一个超级 Agent,塞进所有凭据和所有记忆层。你会失去隔离性,失去干净撤销访问权限的能力,Agent 也会困惑自己应该使用哪种语气。
第 3 级:编排 Agent + 专职 Agent
你加入 hermes-orchestrator 作为统一入口。你仍然可以直接和专职 Agent 对话,但编排 Agent 能够路由工作并综合结果。
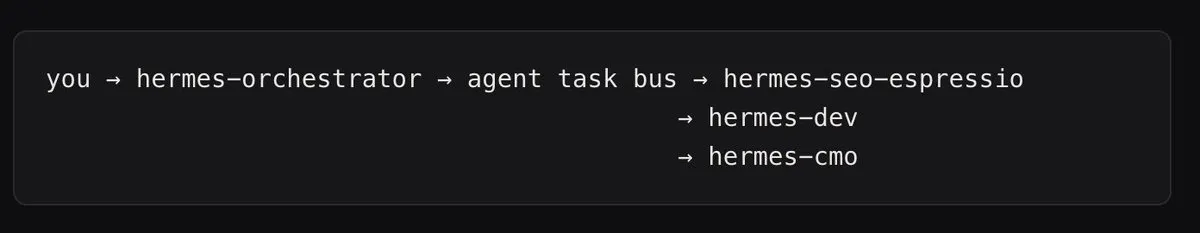
编排 Agent 会读取控制室,知道有哪些 Agent、每个 Agent 做什么、任务队列在哪里、哪些事情需要审批、哪些动作被禁止,以及文档和运维手册在哪里。它不需要问你这些,它会自己读取。
适合:跨职能工作、任务委派、概述与综合、多 Agent 工作流的单一主界面。
编排 Agent 出现的那一刻,你的设置就不再是一组 Agent,而开始成为一支团队。这也是控制室开始真正体现价值的时刻,因为编排 Agent 的能力取决于它读取的文档有多好。
我从笔记本或手机快速查看 Agent 编队状态时,大概是这样:
$ ssh hermes
welcome to hermes-vps-1.
last login: thu may 15 09:14:22

hermes-vps-1 ~ $ cd vps-agents
hermes-vps-1 ~/vps-agents $ docker ps --format \
    "table {{.Names}}\t{{.Status}}\t{{.Image}}"

NAMES                       STATUS         IMAGE
hermes-orchestrator         up 14 hours    hermes-runtime
hermes-seo-espressio        up 8 hours     hermes-runtime
hermes-cmo                  up 8 hours     hermes-runtime
hermes-outbound             up 4 hours     hermes-runtime
hermes-life                 up 12 hours    hermes-runtime

hermes-vps-1 ~/vps-agents $ cat agents/hermes-seo-espressio/runbook.md
# runbook: hermes-seo-espressio
restart:   docker compose restart hermes-seo-espressio
logs:      docker logs -f hermes-seo-espressio
shell:     docker exec -it hermes-seo-espressio bash
...
第 4 级:自动化 Agent 团队
形状与第 3 级相同,但有周期性工作流和更强的自动化。每周 SEO 报告通过定时任务运行。服务器健康检查每天触发。备份验证不需要你发起也会运行。跨 Agent 业务工作流会按计划启动。
适合:每周 SEO 报告、内容运营、服务器健康检查、备份验证、跨 Agent 业务工作流。
第 4 级就像终端里的一个营销部门。它不需要你启动一天的工作。它会自己上班、提交报告、自检,只在需要品味判断的决策上提醒你。
控制层级
随着等级上升,你要一直记住一个原则。
控制室用于配置、文档、运维手册和治理。它记录有哪些 Agent、它们做什么、在哪里运行、引用哪些凭据、每个 Agent 能做什么和不能做什么。它是整个 Agent 编队的管理面板,包括编排 Agent。它不是你去执行工作的地方。
做工作时,你直接和 Agent 对话。要么是专职 Agent(当你知道哪个 Agent 负责这项任务时),要么是编排 Agent(当你想用一个统一入口跨专职 Agent 路由时)。
设置指南:把你的 Agent 指向仓库
现在你已经理解架构。下面是如何构建它。
我发布了一个公开模板,里面包含上面描述的精确结构,以及你的 Agent 用来为你完成设置所需的技能。
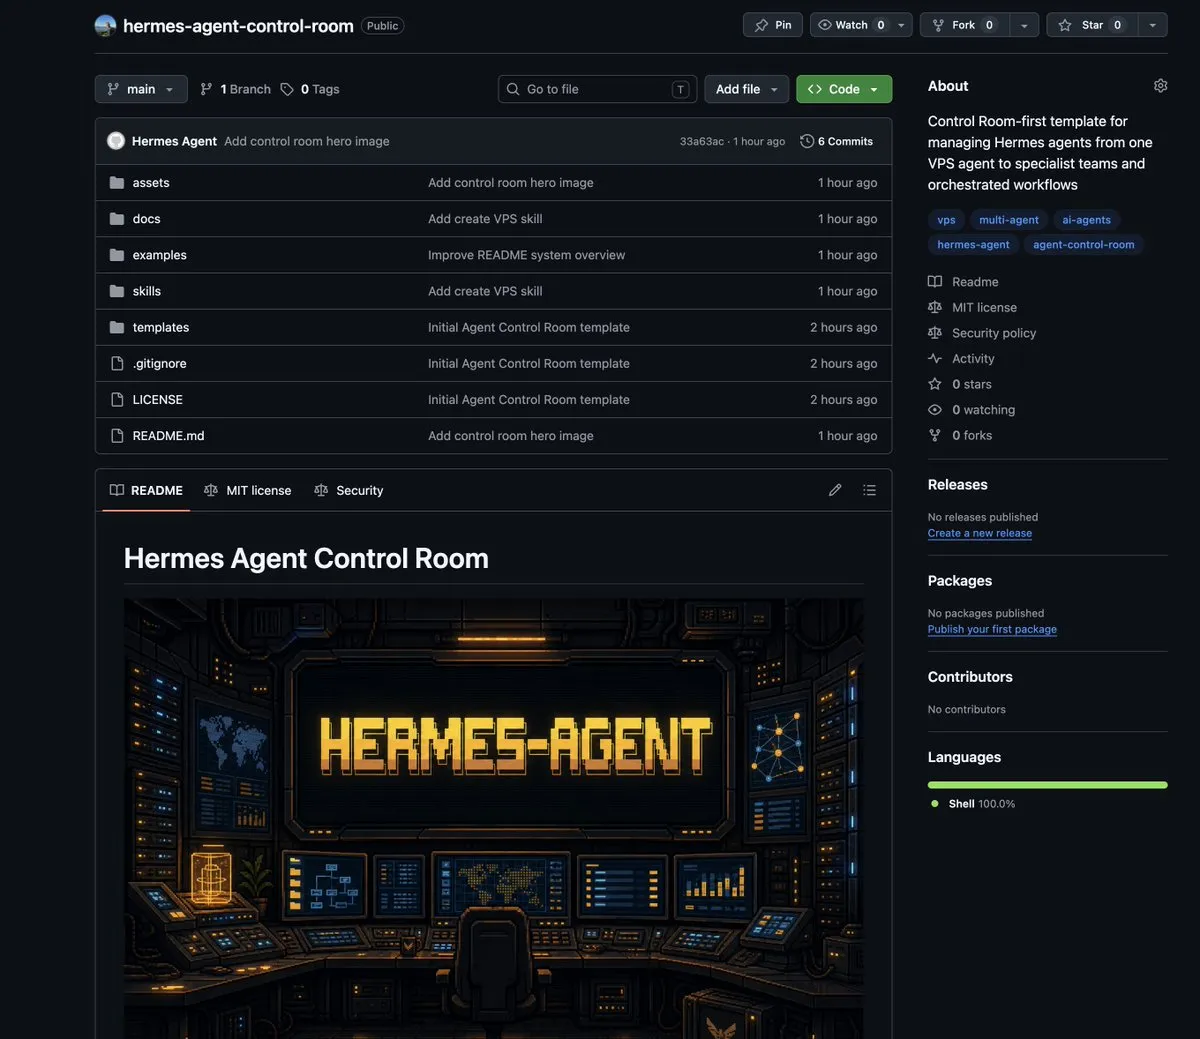
它位于 github.com/shannhk/hermes-agent-control-room。
你可以手动克隆它,但重点是你不必这么做。如果你的笔记本上有 Claude Code 或 Codex,在你交给它 Hetzner API key 后,Agent 会完成大部分工作。
自动化流程:
你   ──►  生成一个 Hetzner API key
          (5 分钟:注册、生成 token、放进你的 .env)
              │
              ▼
Agent ──►  create-vps 技能
          启动一台 Hetzner 机器,生成 SSH key,
          把别名写入 ~/.ssh/config,让 `ssh hermes` 可用
              │
              ▼
Agent ──►  setup-control-room 技能
          安装 Node、Docker、Claude Code、Codex CLI、
          Hermes Agent,然后把仓库克隆到 VPS
          路径是 /root/agent-control-room
              │
              ▼
你   ──►  在 VPS 上完成交互式认证
          (claude /login, codex, hermes)
              │
              ▼
Agent ──►  agent-control-room 技能
          在文档里注册你的第一个 Hermes Agent,
          填好运维手册,设置 env-map
              │
              ▼
          你已经到达第 1 级,并拥有一个文档化的 Agent
10 到 15 分钟内,你会得到:
- 一台新的 Hetzner VPS,安装好正确的工具链
- 控制室已克隆到 VPS 的
/root/agent-control-room - 内置技能已链接到 VPS 的
~/.claude/skills - 一个 Hermes Agent 已注册,运维手册已填写,env-map 已写好
- 笔记本上有 SSH 别名,所以
ssh hermes可以直接连接
原型 → 生产
大多数工作流一开始都不是生产级工作流。它们一开始是混乱的。一个做 SEO 调研、起草文章、排到 Typefully、再发布到 LinkedIn 的流程,不会在你脑子里一开始就完整存在。你需要通过运行来发现它。
Hermes 就是这个原型环境。我把任何新的营销工作流从想法推到自主部署,使用的是这条四步路径:
- 在 Hermes 里做原型。 打开你的主 Hermes Agent,描述你希望发生什么,然后让它尝试。第一次它大概率会做错大部分。没关系。
- 用真实工作跑 2-3 次,每次纠正偏移。运行框架会观察每次修正,并在学习工作形状时开始写技能。到第三次运行时,Agent 不用你辅导也能做出大部分你想要的内容。
- 在专用工作区里微调。 把工作流拉到一个独立 Claude Code 工作区(或者一个新的 Hermes Agent,如果你更喜欢),收紧提示词,锁定路由,加入错误处理,决定哪些应该跑在定时任务上,哪些应该触发执行。
- 按计划部署到 VPS。 一旦它能够在真实运行中稳定一周,不需要你盯着,就把它推到 VPS 上自己的 Docker 容器,设置定时任务,然后离开。
这个模式是我烧掉几个周末、试图从零写生产级 Agent 之后学到的。你无法从零写出生产级 Agent。你必须把它养出来。Hermes 让这个成长过程变快。
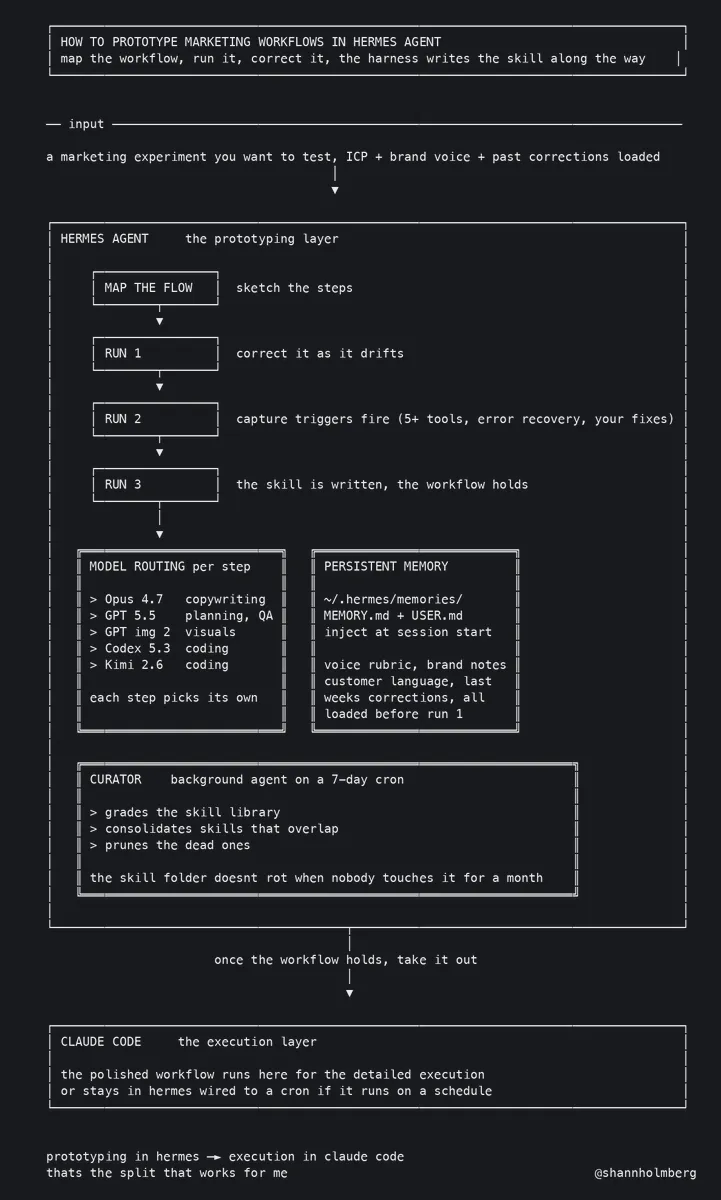
- 在 Hermes 里做原型
- 在专用工作区里微调
- 在 VPS 上自主部署
我在 Hermes 上运行的模型
Hermes 给你框架。底层模型由你选择。通过工具网关,你可以用一个订阅路由到 300+ 个模型,并按 Agent 或按任务切换。
我现在实际运行的是:
- Claude Opus 4.7 用于创意工作:文案写作、语气、开头钩子生成、内容起草,以及任何需要审美判断和写作质量的工作
- Codex(GPT 5.5) 用于结构化工作:编码、规划、多步工作流、浏览器自动化、抓取,以及任何步骤需要严密、输出需要可预测的工作
我两个都跑。Opus 写作。Codex 构建和规划。Hermes 让路由变简单:你把每个 Agent 指向适合它工作的模型。
如果你只能跑一个,答案取决于你的 Agent 编队做哪类工作。内容和文案占比高?从 Claude Opus 4.7 开始。基础设施、自动化和工程工作流占比高?从 Codex 开始。之后你总能通过同一个工具网关加入第二个模型。
真实取舍
我不会假装 Hermes 是完美的。有三个真实取舍。
1. 内置默认能力也带有取向。 Hermes 对记忆如何工作、技能如何被写入、Agent 如何使用工具,都带有强默认配置。这就是它的核心卖点。但这也意味着,如果你想要原语,并对每一步都进行显式控制,Hermes 会显得重。OpenClaw 更符合那种偏好。选择与你哲学匹配的工具。
2. 第 3 级和第 4 级确实有学习曲线。 Docker、VPS、SSH、控制室文件夹结构、编排技能,这些都不是“安装即用”。如果你还没有每天在第 1 级运行 Hermes,就不应该跳到第 3 级。
3. 模型仍然重要。 Hermes 是一个让好模型变得更好的框架。它不会把小模型变成战略家。把你能负担得起的最强模型用于关键工作:编排 Agent、策略 Agent、大脑。把便宜模型用于不关键的工作:调研抓取、初稿生成、批处理。
这些都不是魔法。它是一个会回报你的框架,因为记忆会持续存在,技能会持续积累,Agent 会保持职责清晰。把它用于尺寸不合适的模型,你会得到一支困惑的团队。把它用于合适的模型,你会得到一支团队。
资源
如果从今天开始,可以按这个顺序阅读。
- 官方文档:
hermes-agent.nousresearch.com/docs。先从安装指南开始,然后读技能页面,理解开箱自带什么 - 控制室模板(我的仓库):
github.com/shannhk/hermes-agent-control-room。就是上面描述的精确结构,已经可以克隆。它是控制室优先的模板,用来从一个 VPS Agent 管理到专职团队和编排工作流。Fork 它,让它变成你的 - hermesatlas.com:社区维护的地图,收录 100+ 个基于 Hermes 构建的开源工具、插件、工作区和集成。按领域分类:记忆提供方、工作区、技能注册表、部署、编排。也包含 Hermes Handbook,一份适合初学者的上手指南。每周更新,免费通讯
- X 上的 @Teknium:Nous Research 创始人。几乎每天发布 Hermes 更新。Codex 运行时集成、Nous Portal 上的 DeepSeek V4 Flash 免费层、pretext 技能,都是最先从他的动态里出现
- X 上的 @NousResearch:官方账号,发布官方功能公告
- 线下活动:现在已经有线下 Hermes 活动。如果你附近有一场,值得参加。90 分钟的闲聊能让你学到比读一周材料更多的东西
希望你从这里拿到了一些价值,感谢你读完整篇。
-- Shann
📎 原文信息
原帖链接:https://x.com/shannholmberg/status/2055335043904492011
