
嗨,我是 AI尹小歪 ,WaytoAGI视频板块版主。
你身边的AI工具分享家,专注挖掘实用AI工具与热门玩法,陪你用AI提效,创造更多价值。
搜索公众号 “小歪的AI工具箱” ,关注我不迷路\~
最近的视频模型,更新速度是真的有点夸张
Seedance 2.5、Flux 3.0、MiniMax H3、Wan 3.0,还有Meta Muse Video、Grok Imagine Video,一批模型前后脚出现
Seedance 2.5更偏长叙事和高画面质感的要求
但平时做15秒短剧、Vlog和舞台视频,我还是更关心 效果、抽卡和成本 能不能平衡
所以我这次派出 Seedance 2.0 fast 出战,跟 MiniMax H3 和 Wan 3.0 放在一起,用7组不同场景使用相同提示词做效果对比
其中古装微表情和两个短剧案例,我没有给人物参考图,而是直接用纯文生视频(T2V)来跑
因为在没有图像锚点兜底的情况下,人物长什么样、站位、构图、光影,全都要靠模型自己,这样更能看出它不靠参考图时的原生生成能力和基础能力边界
**1 多场景案例效果对比**
01 真人感
晨起Vlog
第一条我没有设计什么大场面,就是一个女生普通的夏日早晨
她从床边起身,去卫生间刷牙,再到厨房倒麦片和燕麦奶,最后到阳台,晨风吹来,她轻轻打了个喷嚏,揉揉鼻子笑了一下
卧室、卫生间、厨房和阳台连续换了四个空间,刷牙、倒奶、端碗、拿报纸都涉及手和物体的接触,其中一个动作穿模,或者换场景之后人物突然变了,整条Vlog就会立刻露出AI味
这类视频平时很实用,旅行记录、生活方式账号、探店和人物短片,都需要这种不那么像广告的随手拍质感
Seedance 2.0 fast VS Wan 3.0
提示词
@图片1提供了该女生的精准面部特征、发型、眼型和整体面部结构。请完全忽略参考图中的服装和背景。

生成一段连续向右平移镜头的真实夏日晨间 Vlog 片段。

参考图提供了女生的精准面部特征、发型、眼型和整体面部结构。请完全忽略参考图中的服装和背景。

0-3s – 卧室与卫生间: 女生穿着清爽的清浅色系夏日吊带睡衣,睡眼惺忪地从床边站起,画面硬切,她在卫生间,对着镜子刷牙。

3-8s – 开放式厨房:画面硬切, 她来到厨房岛台前,迅速将麦片和燕麦奶倒进碗里,双手端起碗大口喝完放下碗,擦了擦嘴角,转身推开阳台玻璃门。镜头继续平移。

8-13s – 阳光阳台: 她走到阳台,走到小茶几旁,顺手拿起上面放着的一份折叠报纸。这时,一阵晨风吹过,拂动她的发丝。她忍不住小声打了个轻微的喷嚏,随后揉了揉鼻子,有些呆萌地笑了笑。

视觉与胶片风格设置

视觉风格: 真实的 Vlog 质感,采用通透明亮的自然夏日晨光,略带一点温馨的暖色调,画面有轻微的自然手持感颗粒。 运镜运镜: 保持快速且平稳的连续向右平移镜头。

音频与环境音: 无对白。轻快紧凑的真实夏日晨间环境音(如风吹过树叶声、蝉鸣、鸟鸣、喷雾声、倒奶声、轻微喷嚏声)。小歪点评
这一条两个模型的差距确实不大,自然光和皮肤质感也都挺接近真人,没有哪一边明显把另一边拉开
Seedance 2.0 fast的优势主要在整段动作比较顺,从起床伸懒腰、刷牙,到厨房里倒麦片和燕麦奶,再端起碗喝完,最后走到阳台看报纸、打喷嚏,几个生活片段接起来比较自然,镜头也带着一点随手拍的轻微晃动,更像朋友顺手记录下来的晨间Vlog
Wan 3.0女生的皮肤、头发和晨间光线都挺真实,后面的刷牙、准备早餐和看报纸也没有太大问题,比较可惜的是Wan 3.0开场起床的位置有点不对,看起来像直接从床中间穿了出来
古装微表情
这是一条测试人物微表情和多段不同情绪,能不能在固定近景里丝滑转化的演技场景
故事里,她早就知道自己要嫁的人不是心上人,看到画面右侧来接她的迎亲队已经到了门口,她知道自己要出嫁了再也回不了头了
这条重点看人物能不能从平静、察觉、迟疑,一路过渡到失落、强撑和含泪重新面对,而不是一开场就直接演成伤心哭戏
Seedance 2.0 fast VS H3
提示词
连续单镜头人物近景表演,一个年轻的古装女子,固定机位,浅景深,焦点始终锁定人物双眼,背景柔和虚化,画面右侧边缘保留少量前景散景,暗示人物正在观察镜头外的人或事。柔和侧光照亮眼睛,保留自然皮肤纹理、细微唇纹,不过度磨皮。

【0至2秒:察觉异常】 人物像是突然注意到画面右侧的动静。视线先于头部缓慢移向右侧,停顿约半秒后,下巴和头部才轻轻抬起并随之转动。嘴角的笑意逐层消失:先是嘴角放松,随后双唇恢复平直。眼神从柔和游离转为专注留意,动作轻微,不表现为受惊。

【2至4秒:疑惑与担忧】 视线持续锁定画面右侧。双眼自然微睁,下眼睑出现极轻的紧张感,眉心略微内收,但不明显皱眉。人物短促吸气后稍作停顿,双唇轻启约一至两毫米,似乎想开口询问,却没有发出声音。喉部出现一次很轻的吞咽动作,呈现担忧、迟疑和欲言又止。

【4至6秒:失落下沉】 人物似乎从镜头外得到一个令自己失望的答案。视线先缓慢下沉,随后头部才轻轻低下。双唇重新闭合,下颌出现极轻的收紧感,嘴角完全失去笑意。人物缓慢呼出一口气,肩膀只随呼吸产生极小幅度的自然下沉。

【6至8秒:掩饰难过】 人物低头轻轻闭眼,停留短暂片刻,像是在压下即将外露的情绪。呼气结束后,双唇先轻抿一下,随后一侧嘴角极轻地抬起,形成一抹短暂、自嘲而无奈的浅笑。笑意没有进入眼睛,眼周仍保留淡淡的疲惫和失落。

【8至10秒:重新面对】 人物缓慢吸气,睁开双眼并抬起头,重新望向前方偏右的柔光。眼神逐渐恢复一点亮度,但依旧克制。泪水湿润了眼眶。唇角残留一丝温柔而委屈的淡意,像是在努力让自己平静下来。小歪点评
这一条的人脸真人感,我觉得MiniMax H3其实挺能打,皮肤、眼神和最后的泪水都更贴近真人演员的近景状态
但把10秒连起来看,Seedance 2.0 fast 的情绪转变节拍更清楚:一开始还有一点放松的笑意,接着才把视线移向右侧,嘴角慢慢收住,到了后面才低头闭眼,最后再抬起脸时,眼眶湿了,嘴角还在努力留住一点笑,这个“我没事”的感觉是成立的
H3的问题不在人脸不真实,而是情绪进得太早了,开场就已经是偏低沉、偏收着的状态,中间虽然也有闭眼、低头和落泪,但“察觉到迎亲队来了”到“自己马上要嫁给自己不喜欢的人了”的那一下转折没那么明显,整条更像从一开始就在难过
这条我不会说Seedance 2.0 fast在真人感上全面超过H3,但如果是测多段微表情和情绪递进,我会选Seedance 2.0 fast,它把五段表演拆得更开,观众更容易看懂她到底是怎么从平静走到难过的
02 短剧
人物演技之后,我又安排了两条狗血短剧
豪门反转
第一条是典型的豪门打脸戏,测试短剧节奏和剧情接力的场景,提示词给得比较简单,镜头怎么切、人物怎么站、情绪怎么往上推,基本都交给模型自由发挥
这条主要看人物站位和动作接触是否合理,以及台词情绪、切镜节奏和最后的反转,能不能撑起爆款短剧需要的强情绪和爽感
Seedance 2.0 fast VS H3
提示词
爆款豪门都市短剧,【角色】少爷、老管家、母亲 【场景】豪门家宴
0至3秒 少爷把水杯里的水泼在老管家身上。少爷:“一个管家,也配坐在主桌?”
3至11秒 母亲突然起身,一巴掌扇向少爷。母亲:“跪下,给他道歉!”少爷捂脸:“妈,你为了一个管家打我?”
11至15秒 老管家脱下工作外套,露出左边衣服的董事长胸针。母亲低声:“他是集团真正的创始人——也是你外公。”
【卡点】少爷手中的水杯落地。
全片无字幕,无水印小歪点评
这条 Seedance 2.0 fast 切镜更懂得往人物的表情上落,人物说话时的情绪张力更足,15秒看下来会更像短剧
H3的优点是真人感更好一些,人物皮肤和整个家宴环境看着更接近真人实拍,不过它的动作关系有点可惜,母亲站位有点奇怪。更明显的是,少爷脸上的红印在视频刚开始就已经出现了,有点穿帮,另外,人物说话的节奏和情绪起伏偏平,少了一点豪门短剧该有的“爽感”
Seedance 2.0 fast 也不是全对,挨打之后痕迹重了点,人物皮肤细节处理的不错,真人感和H3不相上下,不过这条短剧节奏、情绪张力和剧情反转,Seedance 2.0 fast 还是胜出的
情侣对峙
第二条换成都市情侣短剧,提示词也给的比较简单,只有台词和基本设定,其余镜头和表演都交给模型自由发挥
这条重点看模型能不能围绕矛盾升级安排情绪切镜,人物说台词时有没有真正进入状态,情绪能不能通过眼神、语气和动作演出来,同时也看整段的节奏感和冲突张力
Seedance 2.0 fast VS H3
提示词
给我出一个爆款短剧
【角色】 男生:26岁咖啡店老板,穿日常衬衫。 女友:27岁旅行摄影师,穿长款风衣。
【场景】情侣公寓
0至3秒 桌子上放着一个手机,男生把一枚男士戒指拍在桌上说:“这是谁的?”女友慌忙抱住他:“你要相信我。”
3至11秒 桌子上的手机突然响起。男生拿起桌上的手机接通电话说:“喂”,电话里传来一个陌生男人质问:“你是谁?为什么接婉婉的电话?”
11至15秒 男生愤怒的挂断电话,摘下情侣项链丢地上,对女生说:“这次不用你选,我退出。”
【卡点】男生转身离开,项链落在女友脚边。小歪点评
这条 Seedance 2.0 fast 处理明显更懂短视频里的网剧节奏,开场直接给戒指特写,马上把矛盾抛出来
Seedance 2.0 fast的切镜也更密,会在戒指、来电界面和人物表情之间来回切换,尤其陌生男人的电话打进来以后,男生从怀疑到愤怒的情绪一下就被推上去了,最后再用项链落地和转身离开收尾,整体更像我们平时刷到的都市情感短剧
H3更像一段正常电视剧,它保留了更多两个人的同框和公寓环境,镜头没有那么急,人物的皮肤和表演状态也更接近真人,最后的项链落地和男生离开同样做出来了,这部分执行并不差
不过放在15秒短剧里,H3开场没有特写戒指,镜头在两个人身上停留得比较久,冲突来得慢了一点,后面的情绪也更克制,所以虽然看起来更像真人电视剧,但少了一点短剧需要的强钩子和爽感
03 多人物
女团舞
接下来测动作
这条不只是让人物完成几个舞蹈动作,还要同时处理音乐卡点、身体重心、面部表情、镜头追焦和整个舞台氛围
Seedance 2.0 fast VS H3
提示词
严格锁定成年女团主舞 图片1的五官、发色、身材比例、妆容和舞台服装。15秒,9:16竖屏,85mm长焦户外音乐节直拍,一镜到底。舞台正在下细雨,主舞面部始终清晰,伴舞只作后景虚化陪衬。

0至4秒,主舞先专注看向镜头,随鼓点自然眨眼一次,嘴角出现明亮但不过分夸张的笑意。她双手从脸侧打开,在胸前交叉后向两侧甩开,同时向前踏两步,肩胯交替卡点;摄影机随她向前移动同步后退,胸口保持真实呼吸起伏。

4至8秒,副歌鼓点增强。她完成双臂从胸前向外甩开、两次肩胯交替卡点和连续脚步换重心。湿发贴住部分脸颊,又因动作惯性自然甩开;雨滴被舞台追光照亮。

8至12秒,她侧身压肩后快速回正,完成一次有力量感的甩发、半圈转身和身体波浪。摄影机轻微横移保持构图,焦点始终锁住面部。她的表情随节奏从专注转为灿笑,眼周、脸颊和嘴角同步参与,不出现假笑定格。

12至15秒,她向镜头前踏半步,单手停在脸侧,另一只手压住腰线,完成一次短促的肩部卡点后定住结束姿势,朝镜头自然眨眼并露出明朗笑容。发丝、耳坠和裙摆因惯性继续摆动,现场欢呼、雨声、舞台回声与原创女团流行音乐自然融合。人物是否自然开口或发声由模型自由发挥。

禁止换脸、换装、肢体穿插、脚底打滑、伴舞遮挡、失焦、乱切镜、字幕、Logo和水印。小歪点评
Seedance 2.0 fast的动作幅度更大,肩胯卡点、转身、甩发和身体重心都能连起来,人物不是站在原地摆几个姿势,能看出她在跟着音乐真正跳舞,摄影机也会随着人物移动,发丝和身上的装饰跟着动作甩起来以后,整个画面一下就有了舞台直拍的感觉
它还根据音乐自然补出了开口演唱的状态,表情也一直在变,从专注看镜头,到跟着节奏开口,再到转身以后笑起来,唱、跳和镜头互动是连在一起的。再加上细雨、追光和后方舞台环境,整体已经很接近真实的女团唱跳现场
H3的画面很清楚,人物的五官和妆容也保持得比较稳,单看某一个定格其实挺好看,但连续看下来,人物的动作幅度偏小,肩胯和身体重心变化不够明显,很多时候更像站在舞台上换姿势,表情也比较固定,少了一点跟着音乐越来越投入的状态
四人环绕豆志刚运镜
单人动作之后,我又拿四张不同的人物参考图,做了一条豆志刚运镜的女团舞台秀
这条不只测四张脸会不会串、会不会突然换成别的人,也看四个人在镜头推进里会不会少人或多出人,再看弧形运镜、焦点切换、光影、人物表情和最后定格的舞台感能不能一起撑起来
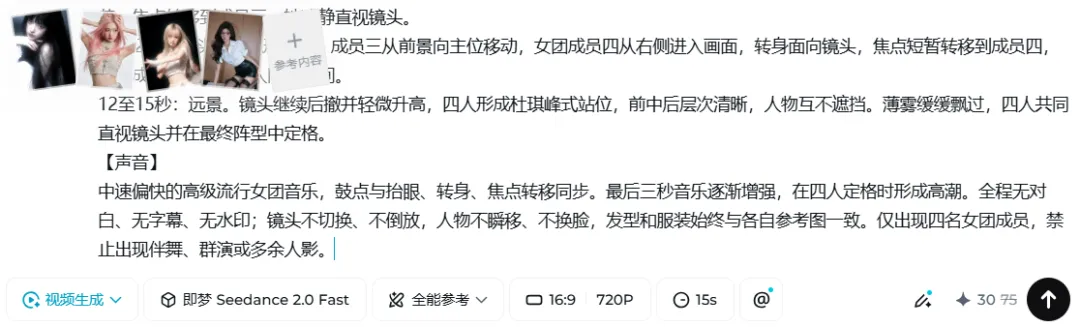
Seedance 2.0 fast VS H3
提示词
【基础设定】
女团成员一:外貌参考 图片1。超长黑色直发、齐刘海,身穿黑色微闪舞台装,气质清冷神秘。
女团成员二:外貌参考 图片2。粉色长发,身穿珍珠镶嵌短上衣与同系列舞台短裙,气质华丽甜酷。
女团成员三:外貌参考 图片3。浅金色长直发、齐刘海,身穿白银亮钻短上衣与白色舞台裙,气质明亮耀眼。
女团成员四:外貌参考 图片4。黑色长卷发、细框眼镜,身穿白色修身衬衫、黑色皮质短裙、黑色长袜与高跟鞋,气质利落冷艳。
全程仅出现四名女团成员,禁止出现伴舞、群演或多余人影。

场景:奢华午夜舞厅式舞台,顶部悬挂水晶吊灯,两侧是向黑暗深处延伸的大理石拱柱,黑色镜面地面倒映灯光,空间中漂浮淡淡薄雾。

【气氛与画质】
电影级写实质感,冷蓝环境光与暖色吊灯交织,浅景深,人物之间自然转移焦点,豆志刚式弧形环绕运镜,全程一镜到底。

【画面内容】
0至2秒:中景。镜头缓慢向左做弧形环绕。女团成员一独自站在中央聚光灯下,微微低头,随后踩着音乐节拍抬眼直视镜头,焦点锁定在她身上。

2至5秒:镜头继续向左环绕。女团成员二以模糊前景进入画面,焦点从成员一自然转移到成员二。成员二转头面向镜头,成员一逐渐虚化为焦外背景。

5至9秒:镜头开始后拉并继续向左横移。成员二退至中景,女团成员三从左侧大步走入前景,浅金长发与白银舞台装反射吊灯光芒,焦点转移到成员三,她冷静直视镜头。

9至12秒:镜头保持弧形环绕。成员三从前景向主位移动,女团成员四从右侧进入画面,转身面向镜头,焦点短暂转移到成员四,四名成员逐渐全部进入同一空间。

12至15秒:远景。镜头继续后撤并轻微升高,四人形成杜琪峰式站位,前中后层次清晰,人物互不遮挡。薄雾缓缓飘过,四人共同直视镜头并在最终阵型中定格。

【声音】
中速偏快的高级流行女团音乐,鼓点与抬眼、转身、焦点转移同步。最后三秒音乐逐渐增强,在四人定格时形成高潮。全程无对白、无字幕、无水印;镜头不切换、不倒放,人物不瞬移、不换脸,发型和服装始终与各自参考图一致。仅出现四名女团成员,禁止出现伴舞、群演或多余人影。小歪点评
这一条Seedance 2.0 fast的更自然,不仅是在运镜过程中发丝的飘动细节满满,我最喜欢的是最后的定格,Seedance 2.0 fast里四个人的站位、pose、身体方向和前后层次都有一点舞台队形的感觉,尤其站在中间的成员把姿势撑起来以后,整个画面会更有气场,不只是四个人站在镜头前
MiniMax H3的人物辨识其实挺清楚,最后四个人视觉上还是更像整齐地排开,人物大多直直站着,姿势和脚下没有太多设计感,所以定格会显得稍微有点呆
另外,H3这条的观感锐度偏高,五官、衣服和场景边缘都比较硬,画面是清楚的,但少了一点真实舞台里光线和空气混在一起的感觉
04 大场景
史前灾难片
真人、短剧和舞蹈测完,最后看大场面,这是一条测试大场景灾难特效,它不只是要生成恐龙,还要把陨石撞击、冲击波扩散、森林崩塌、火山喷发和恐龙逃生连成一段完整的末日场面
Seedance 2.0 fast VS H3
提示词
写实风格,大规模史前灾难动作电影大片,展现小行星撞击地球瞬间,巨型恐龙在史前世界末日中的震撼冲击与地貌崩塌场景。

角色:一只体型庞大的霸王龙与三角龙、腕龙、剑龙等多只不同种类的恐龙,皮肤纹理粗糙真实、肌肉紧绷,眼神中透出对天灾的本能恐惧与威严。

构图与位置:低角度仰拍与广角全景视角。前景为霸王龙屹立在开裂的原始大地中央,抬头仰望天空;中景为冲击波掀起的巨浪般尘土与崩塌的史前森林;背景为被撞击撕裂的巨大火球天幕、坠落的陨石雨与远处的火山喷发。

镜头参数:超广角电影镜头,高动态范围,配合高帧率升慢镜头呈现陨石冲击波与地表炸裂的慢动作颗粒感,极度逼真的 8K 特效与动作电影质感。

光影布光:天空中刺眼的白炽撞击火光与昏暗末日天幕形成剧烈对比,炽热的岩浆与坠落火球投下强烈的暖橙色侧逆光,勾勒出恐龙庞大的轮廓与空气中升腾的火山灰颗粒。

【时间轴】
0至4秒:【末日降临】伴随着撕裂天际的刺耳轰鸣与地底深处的震动。黄昏般的史前大地上空,一颗巨型陨石拖着滚滚浓烟与烈焰划破大气层,刺眼的强光瞬间照亮整片天空。霸王龙在开裂的大地上猛然抬头,发出震耳欲聋的咆哮。

4至9秒:【冲击波爆发】极速升慢镜头!陨石撞击远方地表,极其庞大的环形冲击波以排山倒海之势席卷而来,千年来屹立的巨型蕨类植物与巨石被瞬间粉碎,巨大的热浪与尘埃云推平史前森林。

9至15秒:【震撼定格】各种恐龙拼命奔跑。空气中无数悬浮的火星与白炽灰烬在慢动作中优雅漂浮,远方火山接连喷发,大地裂开缝隙喷出岩浆。呈现极其震撼且充满史诗感的电影级末日奇观。小歪点评
这一条不是那种一眼就能分出胜负的,两个模型都把陨石坠落、霸王龙咆哮、冲击波扫过森林和恐龙逃生做出来了
仔细看的话,Seedance 2.0 fast 的烟尘、火光和恐龙融合得更自然,画面更接近写实灾难电影
H3的恐龙轮廓和皮肤质感有点太硬,植物也排列得比较规整,看着不算差,只是更像游戏CG或者3D动画里的画面
所以这条如果比灾难元素的完整度,两边没有特别大的差距,要是重点看写实感和整体环境的融合,我会更偏Seedance 2.0 fast
**2 大家关心的成本问题**
视频都看完,再聊成本
Seedance 2.0 fast 720P 和 Wan 3.0 720P 都是0.6元/秒,MiniMax H3 768P 是0.5元/秒
换算成一条15秒视频,大约是9元、9元和7.5元
只看一抽,H3价格最低,这个很直观
但现在算视频成本,不会只看“一抽多少钱”,大家更关心的是,为了得到一条能用的成片,最后到底抽了几次
7.5元一抽,如果三次才有一条能用,总生成成本就是22.5元,9元一抽,如果第一条就能交,反而更便宜
目前来看,我这次的这几种案例场景抽卡情况大概是这样的
- vlog和微表情用 Seedance 2.0 fast 基本一次就差不多了,H3要两次左右
- 短剧的一直是 Seedance 2.0 fast 比较擅长的,也是一次抽卡就差不多了,H3要两到三次,主要容易出现人物占位问题和画面切镜不够短剧感
- 多人物 Seedance 2.0 fast 抽卡会更稳一点,差不多两次
- 大场景基本上每个模型都是抽一次卡就差不多了
**3 API与本地部署怎么选**
H3还有一个很吸引人的地方:可以自己部署
工作室和企业除了直接接在线API,也可以把开源模型放在自己的机器或云服务器上
调用量足够大时,本地部署确实有机会把单条成本摊下来,还可以接进自己的Agent、Skill或自动化生产工具里
但“模型开源”和“完全免费”其实是两码事
显卡只是第一笔成本,系统内存、模型存储、驱动环境、并发队列、版本升级和日常维护
如果只是偶尔做几十条视频,或者项目经常在不同模型之间切换,直接接API通常更省事
本地部署更适合调用量长期稳定,或者准备把模型做成固定产品能力的团队。比如把某一类视频生成能力接进自己的Agent,专门服务一个稳定业务,而不是今天做短剧,明天又临时换成广告大片
**4 最后聊几句**
现在看视频模型,我已经越来越不想只盯着“最新”两个字了
旗舰模型适合高要求内容,低价模型适合简单批量任务
最难选的反而是中间这一档: 效果要能交付,价格不能太高,抽卡还不能没完没了
我这篇文章里面做的 7 组测评,各个模型的优缺点以及差异也还是比较直观的
短剧看情绪、切镜,Vlog看真人感,女团看卡点节奏和表情动作,多人镜头看脸会不会串,大场景看画面感和视觉冲击
大家平时最常用的是什么场景呢?
感谢你看到最后
我是小歪
专注于带给大家人人都能看懂、人人都能学会的实用AI工具教程
🌟 如果这篇教程对你有帮助,别忘了点赞👍、转发📤、推荐❤️、三连支持!
想要第一时间获取最新AI资讯,了解最新最热AI工具玩法,学习AI新手入门教程,记得关注 *“小歪的AI工具箱” 加星标哦⭐*
