
H3 开源一周了。这一周,我们几乎每天都能看到社区的新玩法,大家的热情和创意远超我们想象。
H3 在 Hugging Face 里的热度持续排名前列,并已衍生出接近 300 个模型,ComfyUI 版本下载量近 700 万。
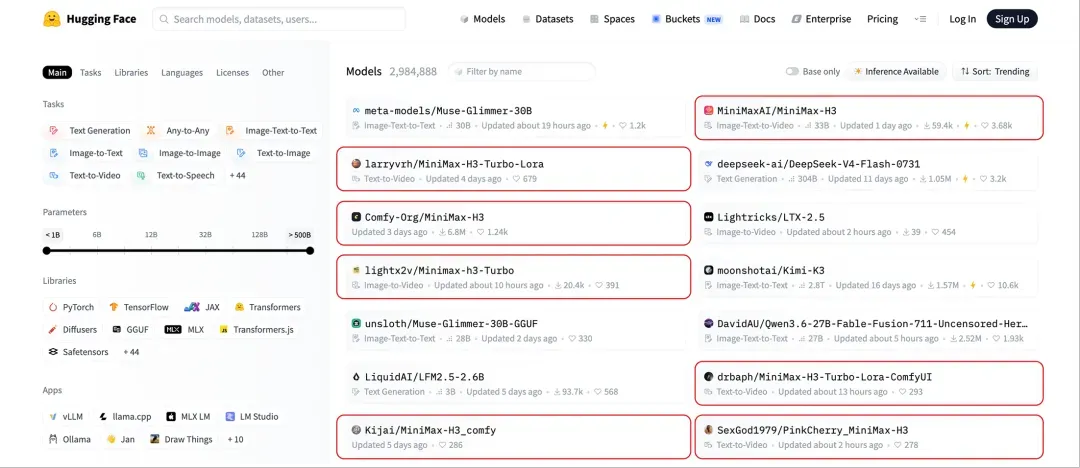
有团队把 120GB 的模型压进了消费级显卡;也有开发者为 H3 重写了面向 Mac 的原生推理引擎;有开发者打开了长视频续写和 Agent 制片的新路径;也有开发者干脆调低分辨率、缩短帧数,把一个视频模型用成了图像工具和音频工具。
H3 会跑在哪些硬件上、接进哪些工具、发展出哪些新能力?社区中的玩法还在不断更新,这些最有创造力的开发者们,开始和我们一起回答这些问题。
01
H3 在更多设备上跑了起来
H3 模型开放部分约有 60B 参数,BF16 权重约需要 120 GB 内存,远超大多数消费级 GPU 的显存。 开源之后,社区在推理效率和硬件适配上做了很多工作,在质量、速度和资源之间寻找新的平衡,让 H3 有机会跑在更多开发者手上的设备里。
ComfyUI 团队最早着手降低本地运行门槛。 他们裁去约占总参数量四成的调制权重,改用功能等价的预计算表;又加入 INT8 ConvRot 量化;再为 H3 写了一套专门降低推理峰值显存的定制 kernel。 最小模型组合的总内存占用,从全精度版本的 123.6GB 降到了 42.5GB。 再配合动态显存卸载,H3 就能在消费级显卡上完成本地推理。
与此同时,社区里也涌现出 GGUF、NVFP4、INT4 ConvRot、混合 INT4/INT8、OrbitQuant、NF4 等多种量化版本,让开发者可以按自己的显存、硬件和推理框架自行选择。
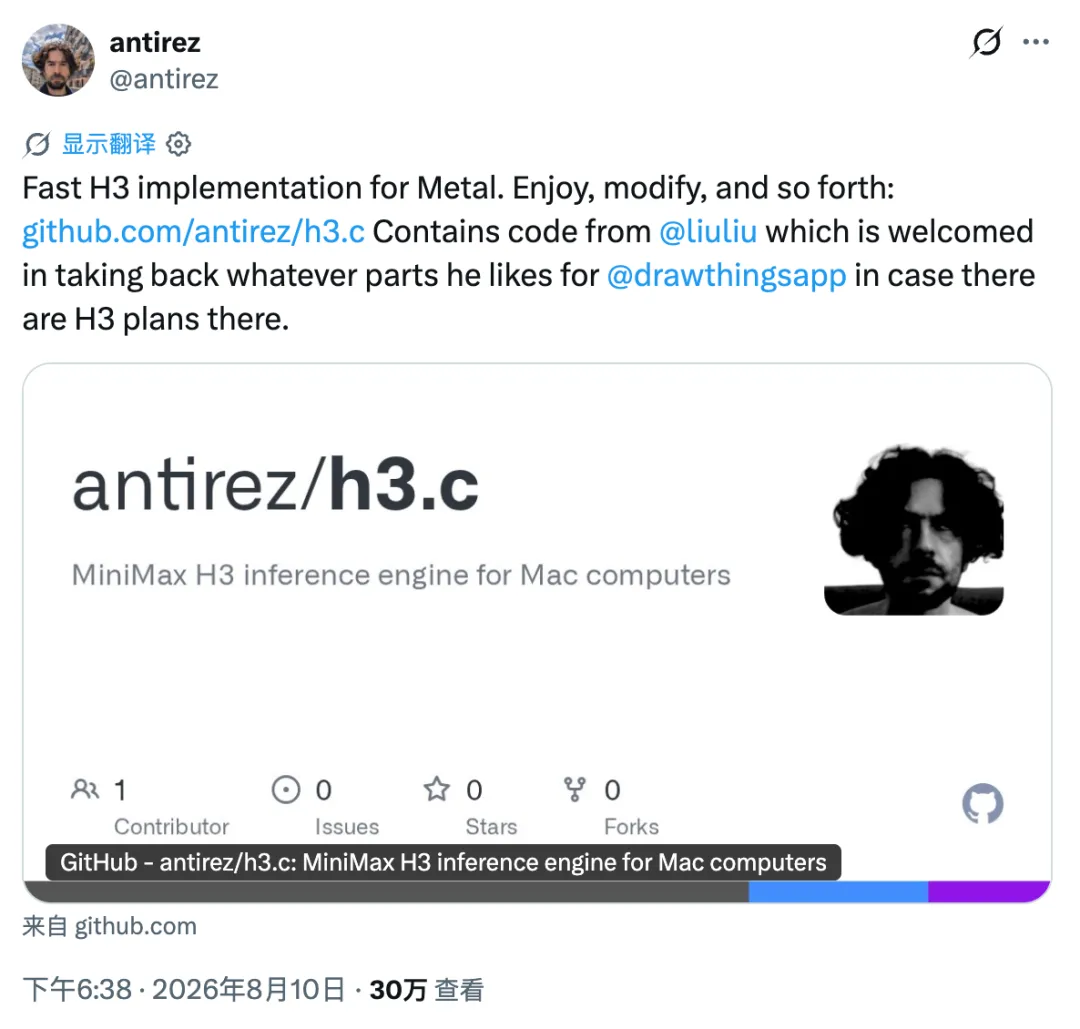
另一边,有人为 Mac 重写了整套推理链路。 闻名全球的开源 内存数据库 Redis 的创建者 antirez,为 H3 编写了一套面向 Apple Silicon 的原生推理引擎 h3.c 。
他用 C 和 Metal 从零重写了 H3 的本地推理链路——直接读取 safetensors 权重,把 Qwen 文本与视觉编码器、DiT、视觉与音频 VAE 以及最终的音视频输出,全部装进一个原生 Mac 程序里。H3 在 Mac 上不再依赖 Python 和 PyTorch,就是一个可以直接跑起来的 app。目前,h3.c 端到端支持文生音视频、首尾帧参考,以及 Ref2VA 的图像、视频和音频参考等功能。
继让模型装得下、跑得起来之后,还有开发者在积极优化 H3 的推理效率,让 H3 跑得更快。
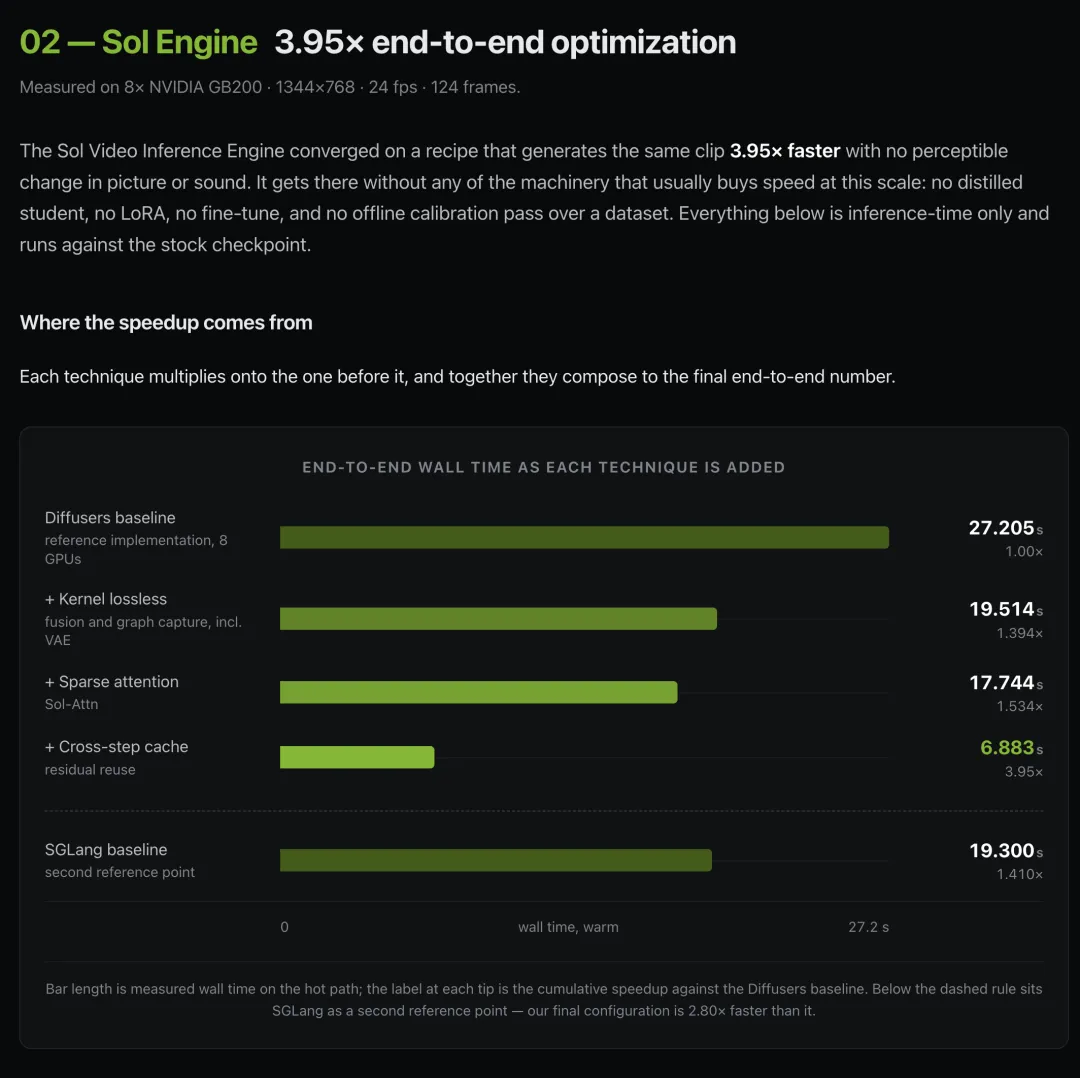
H3 开源首日, NVIDIA 的 研究团队使用 Sol Engine 在 4.5 小时内完成了首轮推理优化。 在 8 张 NVIDIA GB200、1344×768、24 fps、124 帧和 50 步的测试配置下,Sol Engine 相较 Diffusers 实现了 3.95 倍端到端加速,相较 SGLang 加速 2.80 倍。NVIDIA 的实践方案无需修改 H3 的权重,并将同一套优化思路扩展到了单机设备,开发者可以依此围绕不同硬件来优化 H3 的推理效率。
在 AMD 硬件上,开发者 charlie12345 针对 Radeon AI PRO R9700 和 ROCm 环境为 H3 编写了 ComfyUI 补丁,优化 partial RoPE、长序列注意力和模型加载方式。 在 R9700 32GB、864×480、124 帧和 20 步的测试条件下,生成时间较 ComfyUI 环境进一步缩短。
体积压下来了,平台跑通了,速度也上去了。这些工作叠加起来,进一步改变了开发者用 H3 的方式。
H3 开始真正进入更普通的个人设备,比如能够在 RTX 3060 8GB 上生成低分辨率视频 ,虽然这样的画质不适合直接出片,但足够用来调整提示词、检查分镜。 视频玩家于是摸索出一种分段工作方式:本地打样、云端成片。
动漫创作者“ジュニ@Multi AI Creator”就是这么做的。他在 RTX 3060 上生成 480p 视频用来试错,用本地设备完成预览、筛选和试错,确定满意的方案后,再到 RunPod 以 1344×768 生成正式版本并完成超分,实现了创作成本的大幅降低,减少了预览和试错阶段对云端算力的依赖。
02
H3 还有这些“冷门玩法”
模型跑起来之后,开发者很快在社区开启了新一轮探索:“H3 除了生成视频,还能做什么?”
大家尝试调整模型接收的输入、调整模型生成帧数、时间长度和分辨率,在一次次“魔改”和测试中,涌现了很多并非常规使用中的能力,比如长视频续写、图片编辑和独立音频生成等等。
长视频续写:
开发者 NikoDemon80 在 「ComfyUI-H3-Motion-Context」中提供了一种递归生成方法:直接读取上一段视频的画面与音频 latent,截取末尾 22 帧作为下一段的开头条件,并将音频重新对齐到同一条时间线上。新片段生成后,工作流再裁去开头重复的部分,与上一段拼接。相比先解码、再编码,这种方法减少了逐段转换带来的信息损失,也让动作和声音更容易接续下去。
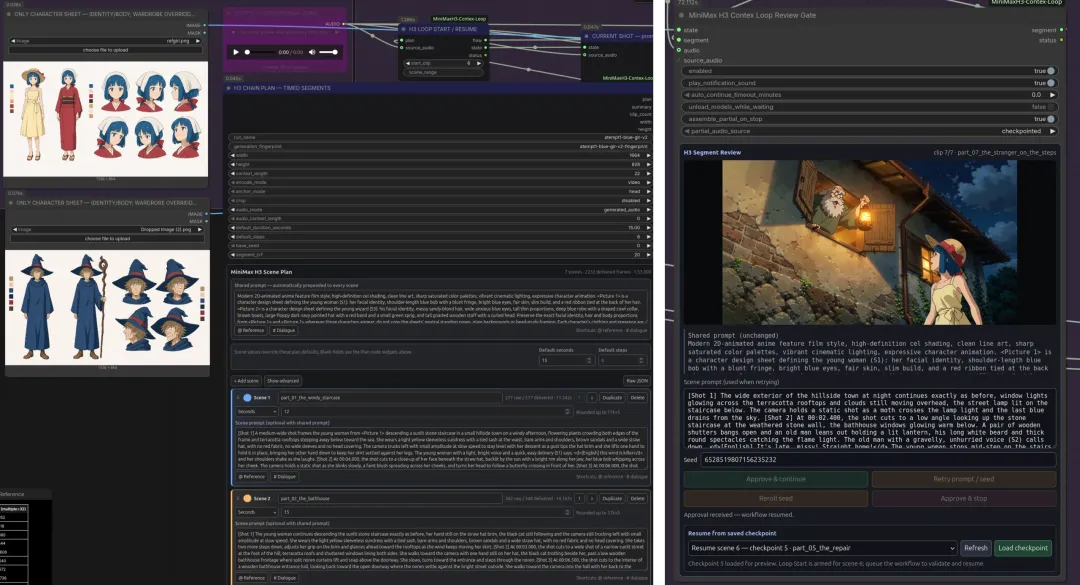
开发者 ethanfel 又把这个方法扩展成一套可审核的长视频工作流,加入了分镜规划、逐段预览、重新生成、检查点保存和自动拼接。每一段视频都可以单独检查,满意后再生成下一段。
Reddit 用户 crinklypaper 用这套工作流做了一段超过 1 分钟的视频。他先在 0.5 至 1MP 下调整提示词和镜头,再以 1.5MP 生成最终片段;同时用两张角色设定图维持人物和风格的一致。最终成片是在 RTX 5090、96GB 系统内存上,用 LightX 6 步采样和 SageAttention 完成的。
图像编辑:
把生成的时间维度缩短到一帧,社区也开始尝试用 H3 做图像编辑。「SingleFrame」项目把输入图像固定在第 0 帧,让 H3 直接生成一个单帧 video latent,再解码为图像。借助提示词,开发者可以在尽量保持原有构图和姿态的情况下,调整人物表情、服装、背景或光线。另一种模式则固定首尾两张图,让 H3 推断两者之间的变化,再从中提取一张中间帧。整套工作流没有为图像编辑做专门训练,直接调用的就是 H3 原有的能力。
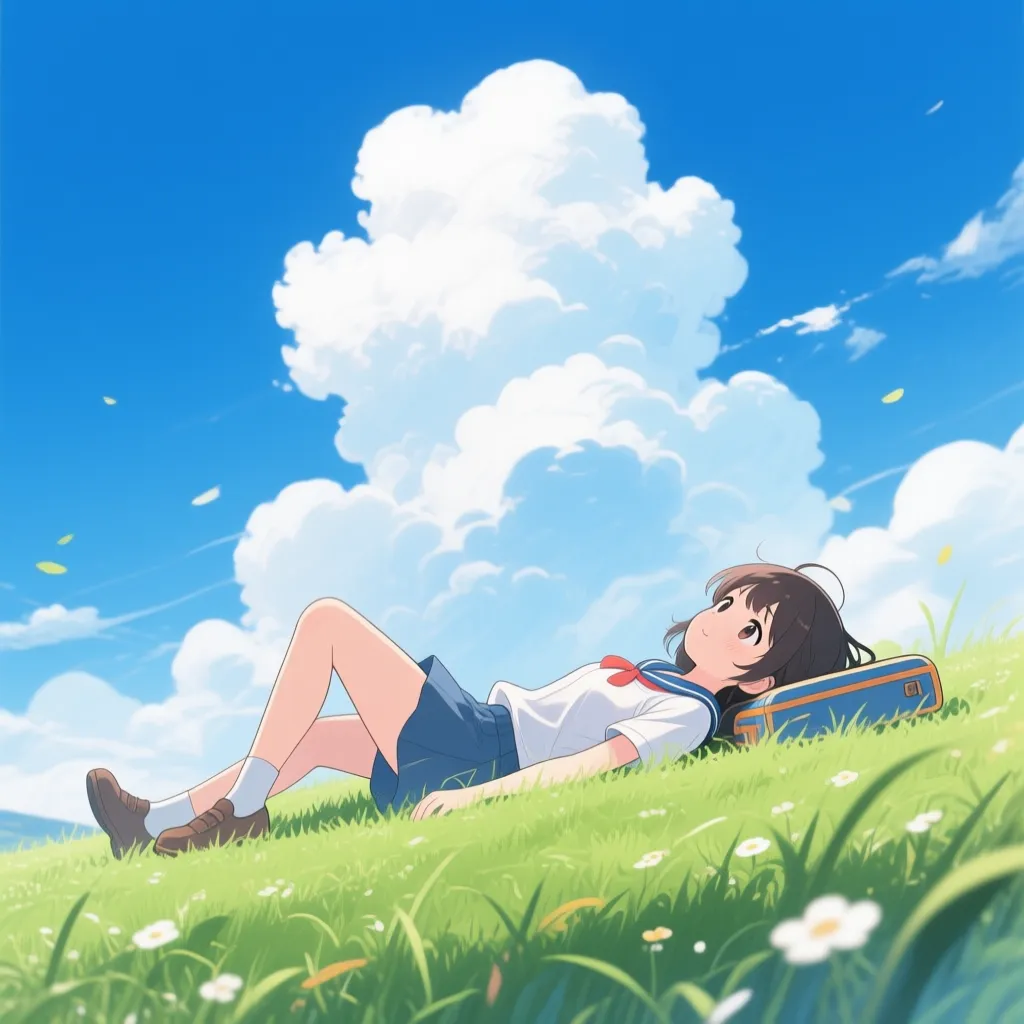
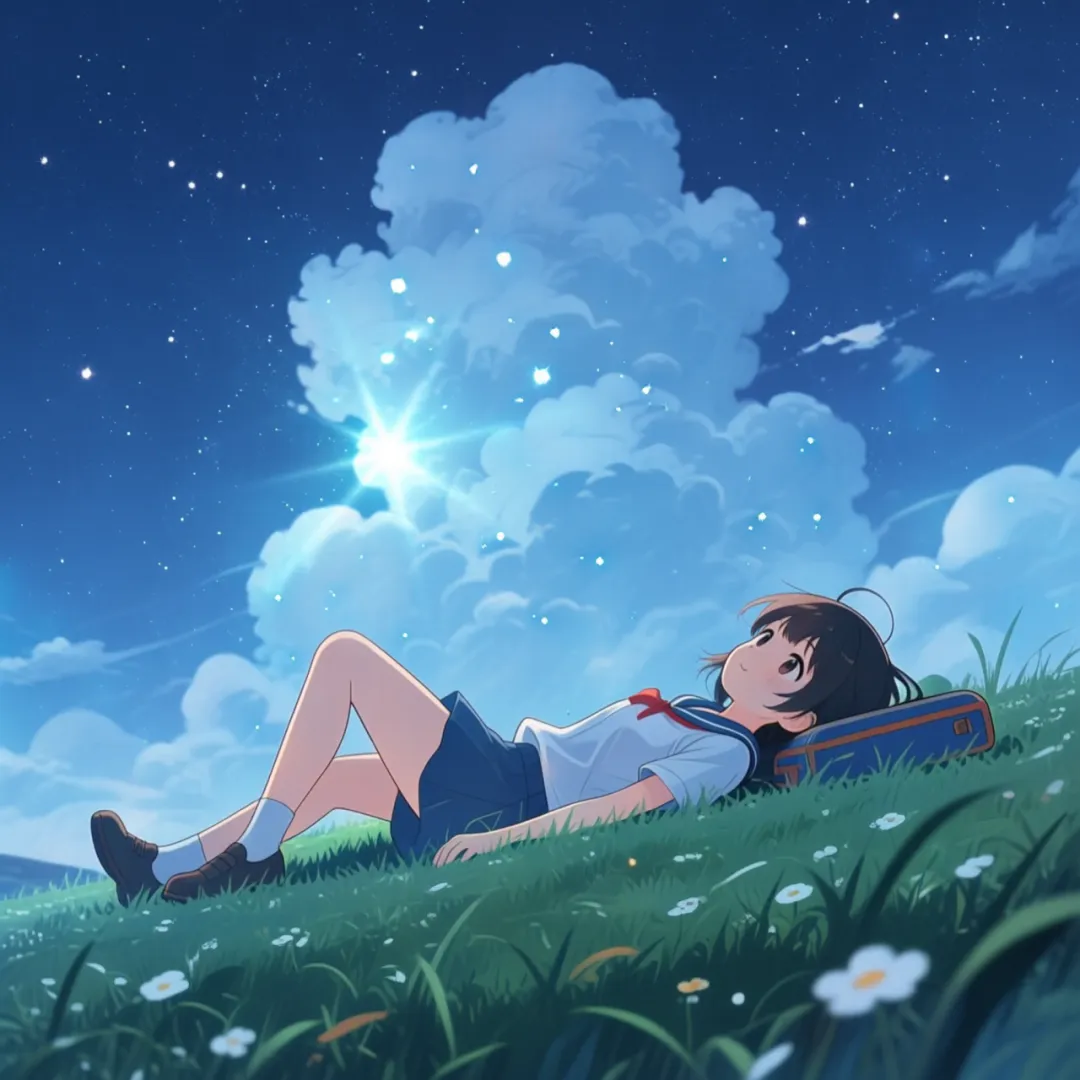
「SingleFrame」项目演示:输入图像与输出图像
音频生成:
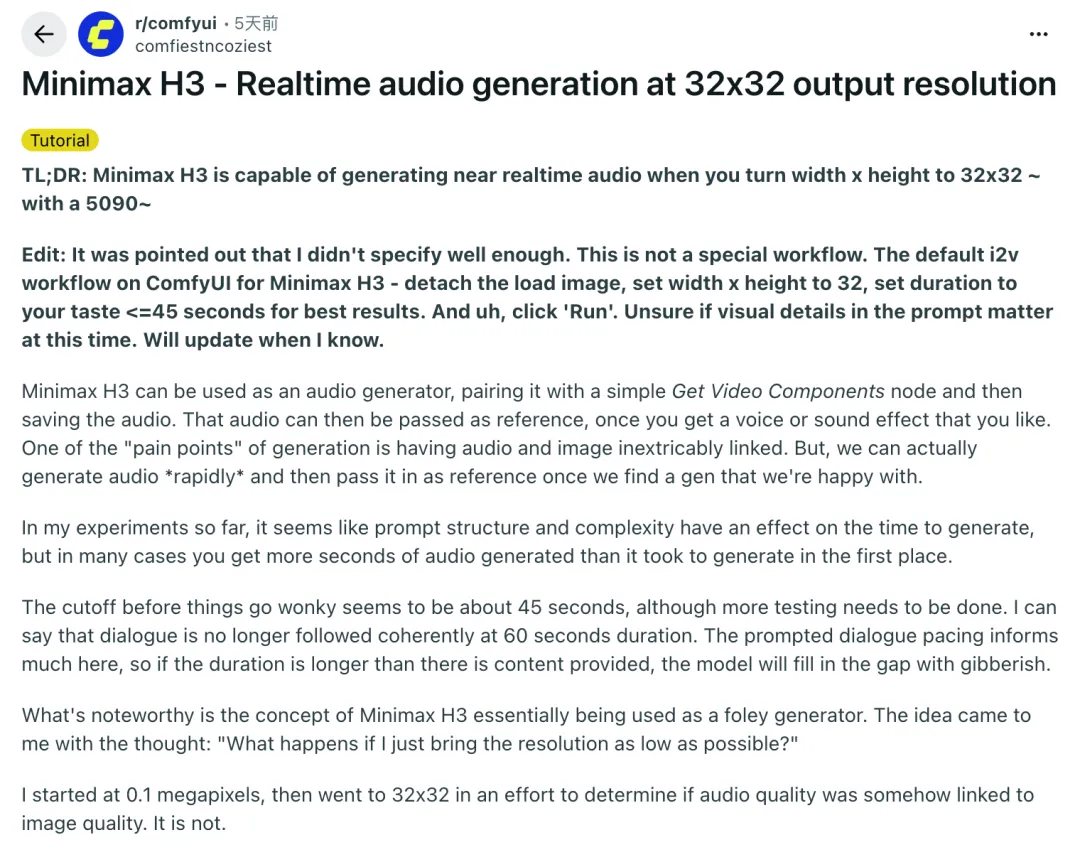
如果说「SingleFrame」压缩的是时间维度,让 H3 输出一张图,那么开发者 comfiestncoziest 则选择压缩空间维度,把联合生成的重点转向音频。他在 ComfyUI 默认 I2V 工作流中断开输入图像,将画面分辨率降至 32×32,再通过 Get Video Components 节点单独提取对白、环境声和音效,无需另外搭建专用工作流。
在开发者的多次测试中,这种方式可以实现接近实时的音频生成,生成出的音频时长甚至超过了实际等待时间。视觉分辨率从 0.1MP 降至 32×32 的情况下,音质没有发生明显变化。获得满意的声音或音效后,还可以将它作为音频参考,重新传回 H3 的视频生成工作流。
03
从单视频生成,
到自动化制片系统
在本地部署后,社区也开始尝试把 H3 接入 Agent,让它成为一套生产流程中可以反复调用的一环。 从一次生成一段视频,到进入一套自动化的多镜头制片流程,H3 的使用方式,也在被重新组织。
AI 艺术家小耳 @xiaoerzhan 用这种方式做了一部完整的作品,从头到尾没有打开一次传统编辑器。
他用 Mac 上的 Claude Code 调度 Windows 电脑里部署在 RTX 5070 上的本地模型。Mac 负责立项、事实核查、脚本、时间线、字幕、分镜和结构审核;Windows 负责模型推理,由 Flux2 生成关键帧、TTX 完成配音、H3 批量生成视频镜头,Chatcut 制作音乐,音效库补充素材。
整套流程被拆成 14 个环节,从 brief、旁白和关键帧,一路推进到批量渲染、剪辑装配、音频后期和台账回写。H3 的批量镜头生成持续了 5 到 6.5 小时,最后完成了作品《用艺术史训练审美》。
「Codex-Drama」项目把这套思路封装成了可安装的 Codex 插件。插件内置九项 Skills,通过 ComfyUI MCP 调用本地 H3,可以根据给定故事或商业 brief 出发,完成角色与场景设定、分镜和关键帧设计,再为不同镜头选择相应的 H3 工作流。镜头生成后,插件继续用 FFmpeg 完成剪辑、混音、字幕、导出和质量检查。
提示词、输入素材、工作流、候选镜头和选择结果,都会保存在项目记录里。任务中断后可以从原处继续,新的尝试也会单独保留版本。H3 的单次生成,就这样进化成了一套多镜头的制片流程。
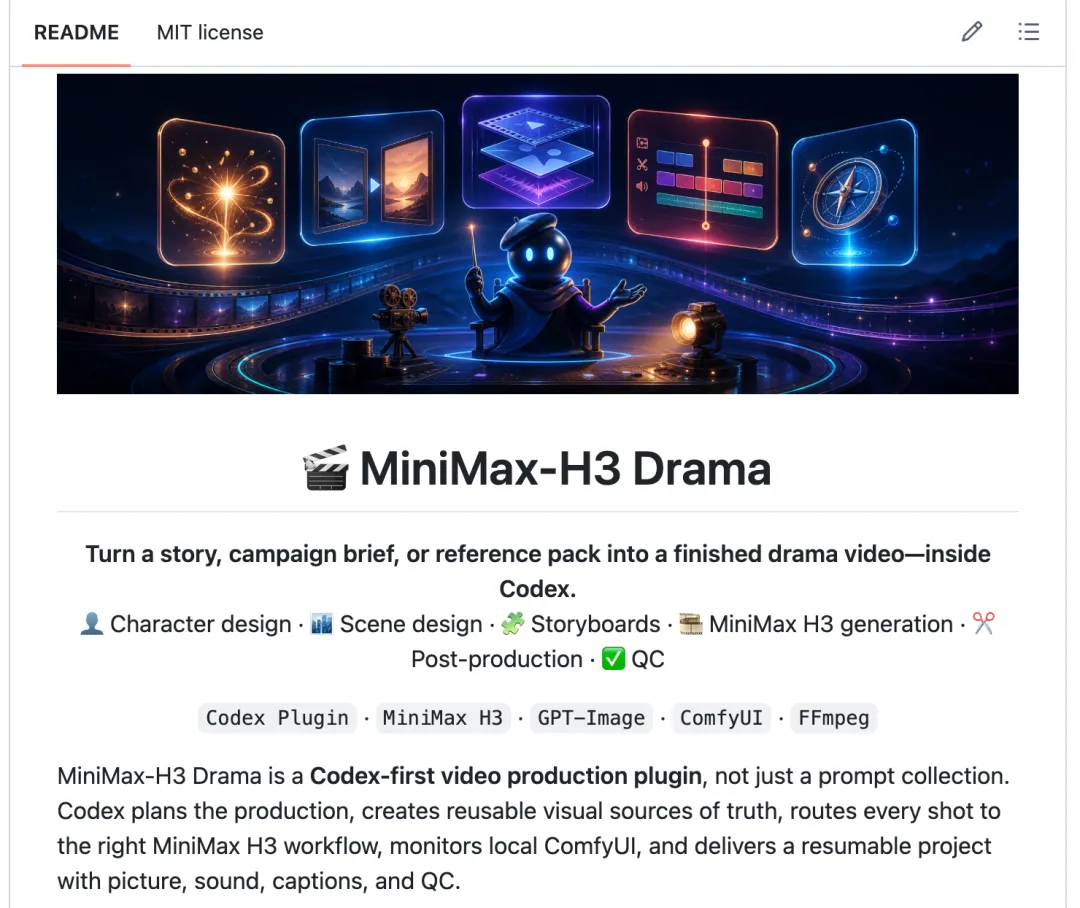
另一种做法是直接改造创作界面。「ComfyUI MiniMax H3 Director」把分段计划、条件编码、采样解码和导出整合进一个“导演台”节点,上传源视频后,用户可以手动切分、按时长均分,或通过 PySceneDetect 自动识别场景。
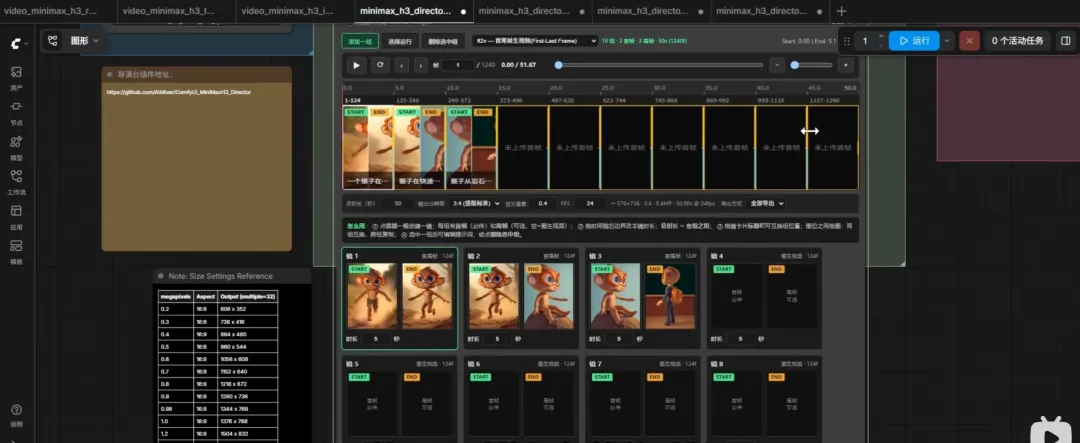
“H3 Director 导演台”
文生视频、图生视频、首尾帧、参考生成、视频编辑等任务都能在同一个节点里组织,H3 同步生成的立体声音频也一起输出。原本散落在节点图里的参数,被重新组织成镜头、素材和时间线;用户可以单独调整并重新生成选中的片段;多段生成时,导演台还能把上一段结尾的动作和音频作为下一段的上下文,保持镜头之间的连续性。
04
共同参与模型进化
在 H3 被接进创作流程之后,社区里的开发者也开始训练自己的 H3。
开发者 larryvrh 发布了 MiniMax-H3-Turbo-LoRA,把 H3 通常约 20 步的采样缩短到 4 至 8 步。他又为 ComfyUI 写了配套的 LoRA 加载节点和 Turbo Sampler,让这套权重能适配 BF16、INT8 ConvRot 和 pruned 等不同版本的 H3。
4 至 8 步是实际用起来的主要区间。4 步最快,能提速 5 倍,但在幅度大、速度快的动作里可能出现拖影;6 至 8 步会保留更多细节和音频质量。
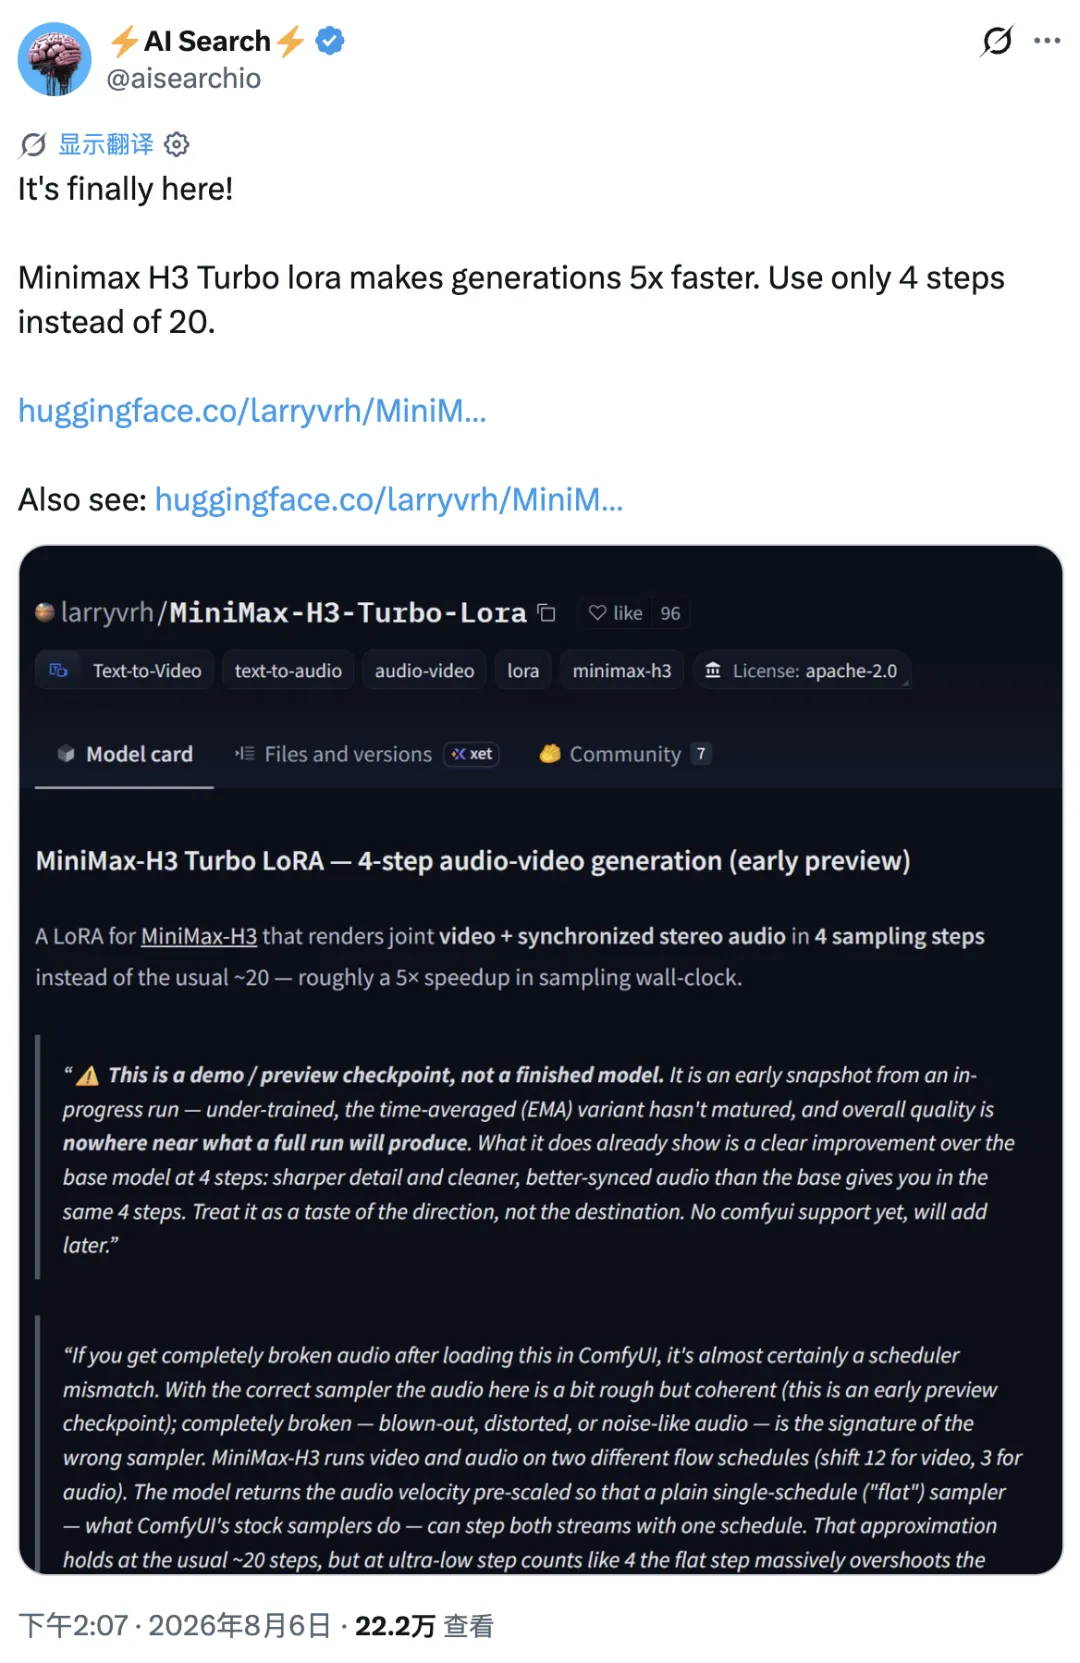
速度只是其中一层。另一批开发者想让 H3 更擅长某一种人物、某一种风格,或者某一种输入方式。
fal 把这件事做成了可以直接调用的 Ref2VA LoRA Trainer。开发者可以上传视频,再加上可选的文字描述、参考图片、视频或音频。训练时,参考素材会同时进入 H3 的视觉条件序列和 Qwen3-VL 提示词,让 LoRA 学习参考主体和目标音视频之间的关系。Trainer 也开放了帧数、分辨率、LoRA rank、训练步数和参考条件比例等设置,支持画面与声音联合训练。
fal 发布的 Realism People LoRA 是这套 Trainer 的一个实际用法。为了让 H3 生成的人物更接近真实拍摄的质感,团队筛选了 176 条真人视频,把素材统一为 24 fps,为每段视频标注人物、场景和动作。他们尝试了 16 组不同的训练步数、LoRA rank 和分辨率,再用相同的提示词和 seed 对比 LoRA 加载前后的结果。发布版本对人物近景的皮肤纹理、细微表情、光线质感和镜头运动上都有了明显的改善。
DiffSynth-Studio 发布的 LineartAnime LoRA 是另一个方向的尝试——把线稿视频作为 H3 Ref2VA 的参考输入,再根据提示词生成上色后的动漫画,实现从连续线稿到完整动漫视频的转换。项目同时开放了权重、推理代码和示例素材,开发者可以直接替换线稿和提示词,继续测试不同角色和场景。
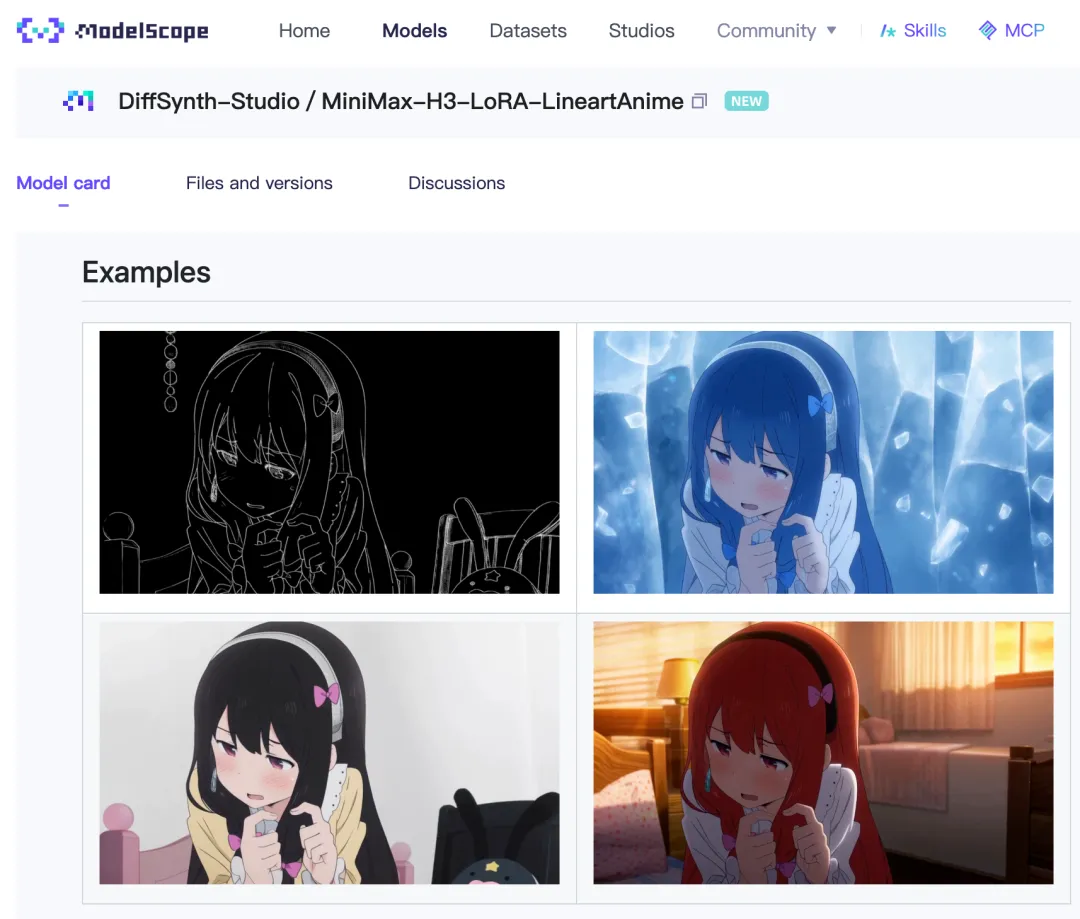
除了用现成的工具,开发者也可以直接用自己的音视频数据训练 H3 LoRA,甚至做全参数微调。
IAmIronMan42 基于 H3 的官方 Diffusers 集成,创建了一套「MiniMax-H3-FineTuning」微调工具。它按照 H3 原有的音视频生成方式,分别处理画面和声音的噪声日程,并把真实立体声音频纳入训练。项目已经在 8 张 A800 上,用 2000 多条约 30 秒、448×768 的音视频素材跑通了 LoRA 训练,社区开发者可以直接在这条路径上部署和修改,训练自己的 H3。
还有很多值得记录的项目没有被写进这篇文章,新的社区玩法也还在不断出现。更多工作流、开源工具和实战经验,已经收录在 H3 社区精选页,并将持续更新。
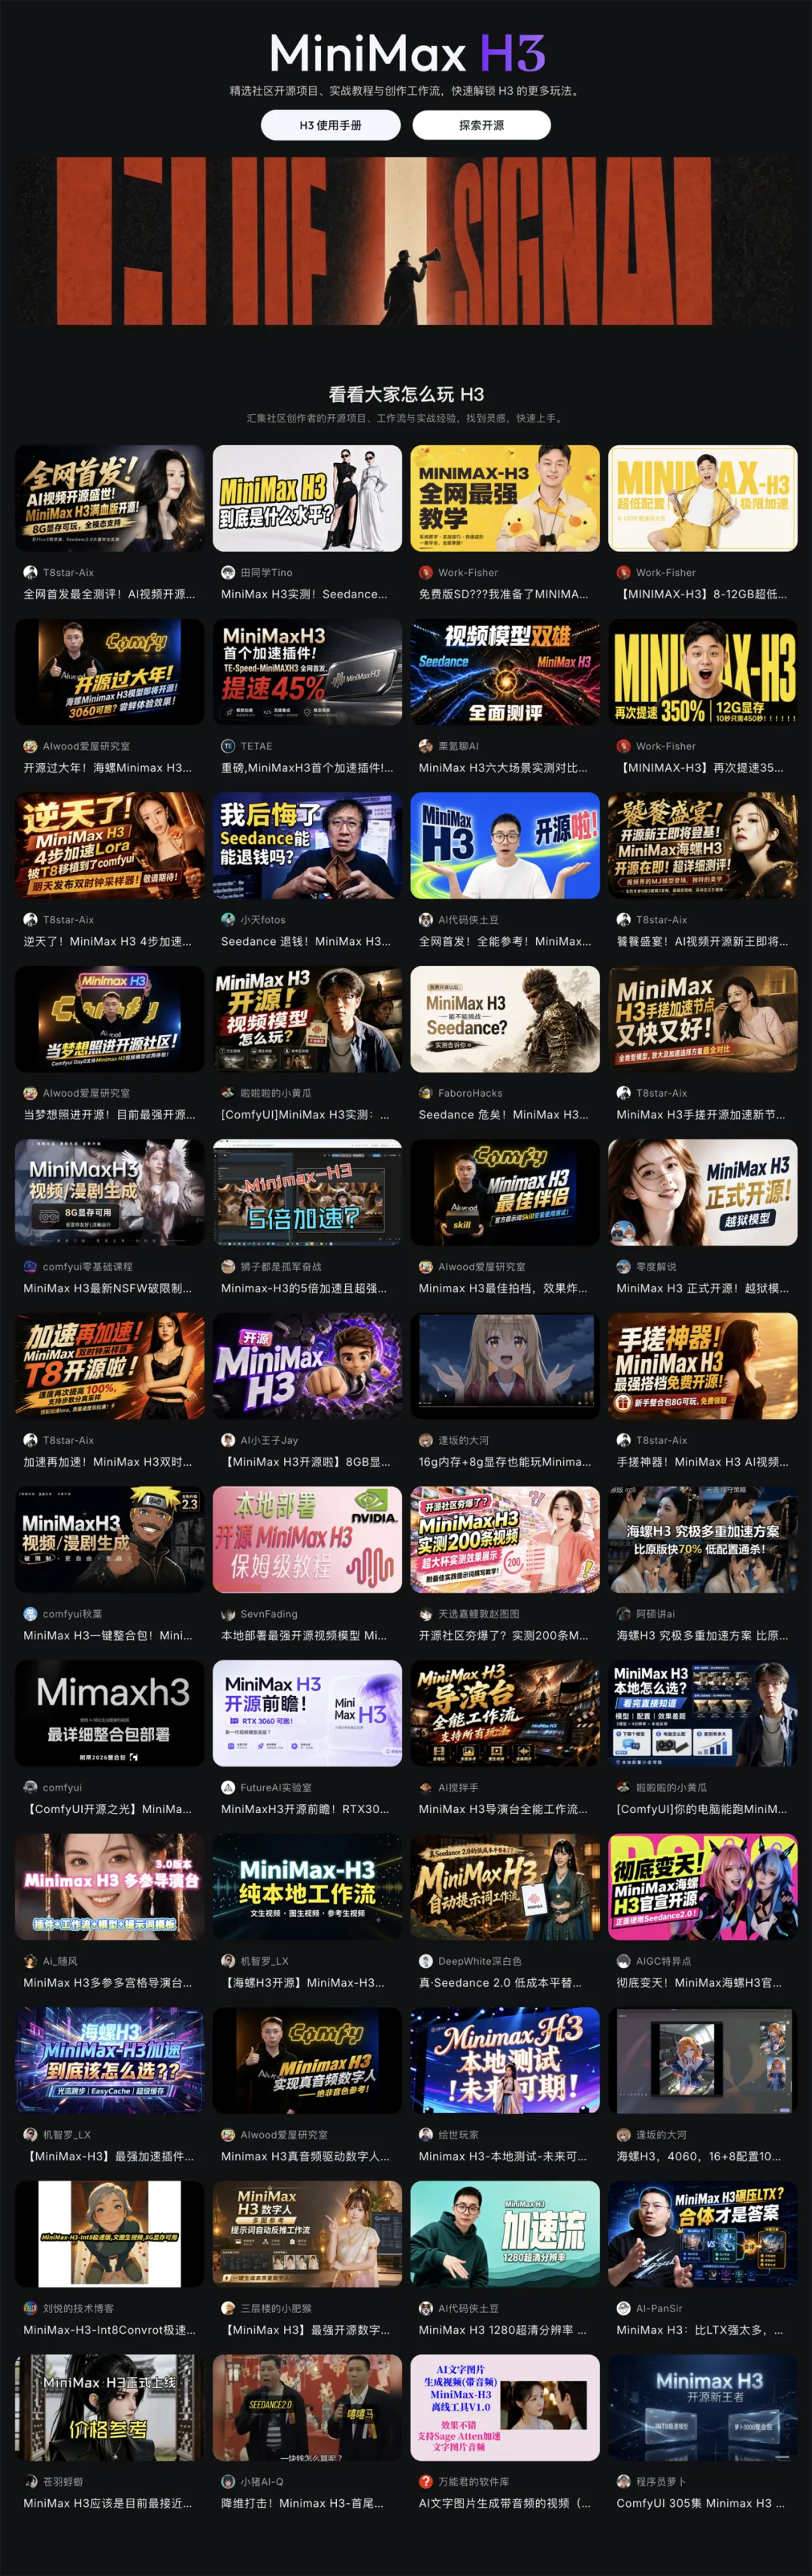
社区开源项目精选页(上下滑动查看)
精选页链接: hailuoai.com/h3-open#featured
我们看到,H3 开源之后,越来越多的创作者和开发者加入了 H3 的生态。
感谢每一位提交代码、分享工作流、参与测试,以及记录问题的开发者和创作者。这些探索和经验,为我们继续完善模型提供了重要参考。
我们也将持续迭代,保持开放,和大家一起共建更丰富的开源生态。
Intelligence with Everyone.

