
我最近上线了用AI做的《汴京十二时辰》数字博物馆,汴京十二时辰
整体反馈不错,后台有很多小伙伴问是怎么做的:涉及到哪些AI工具,具体的工作流是什么。
今天,就手把手来教大家,如何制作属于自己的数字博物馆。
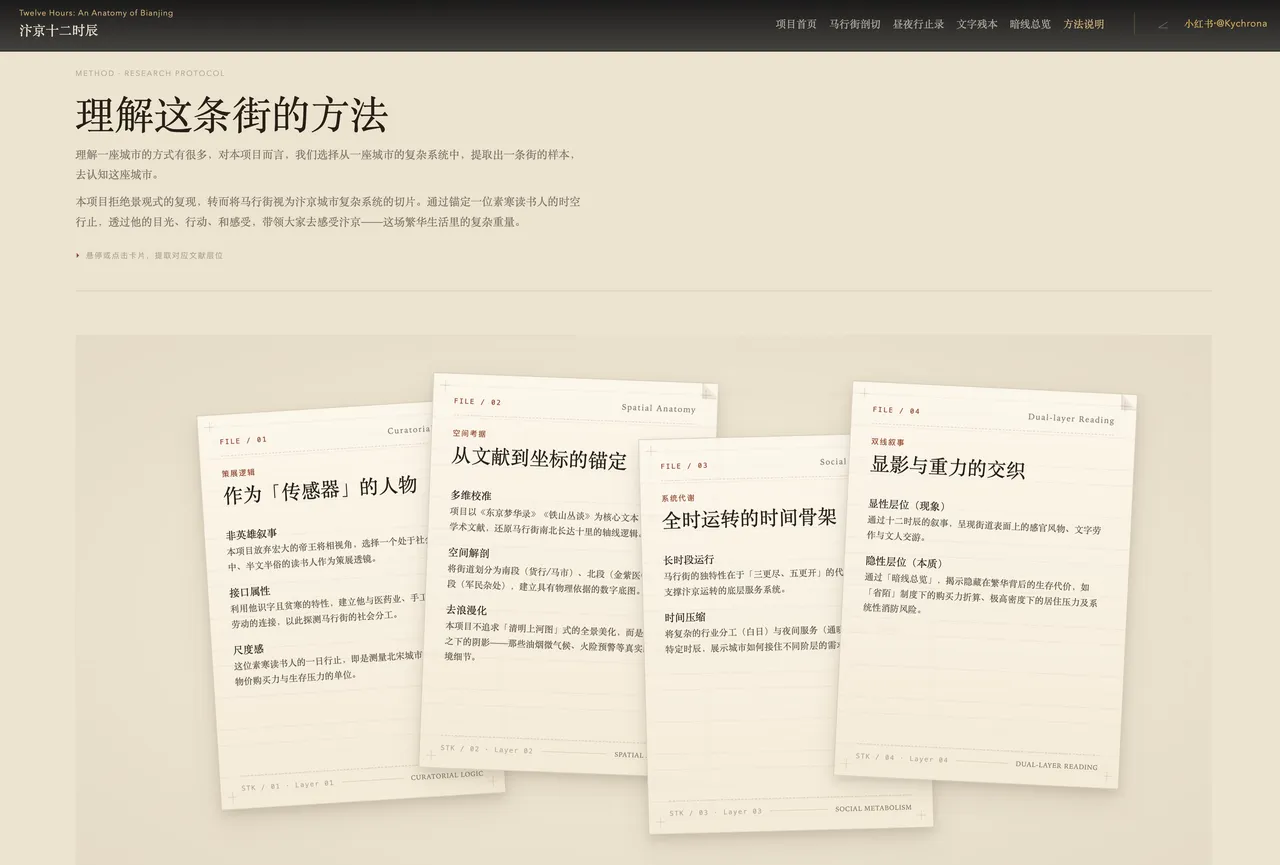
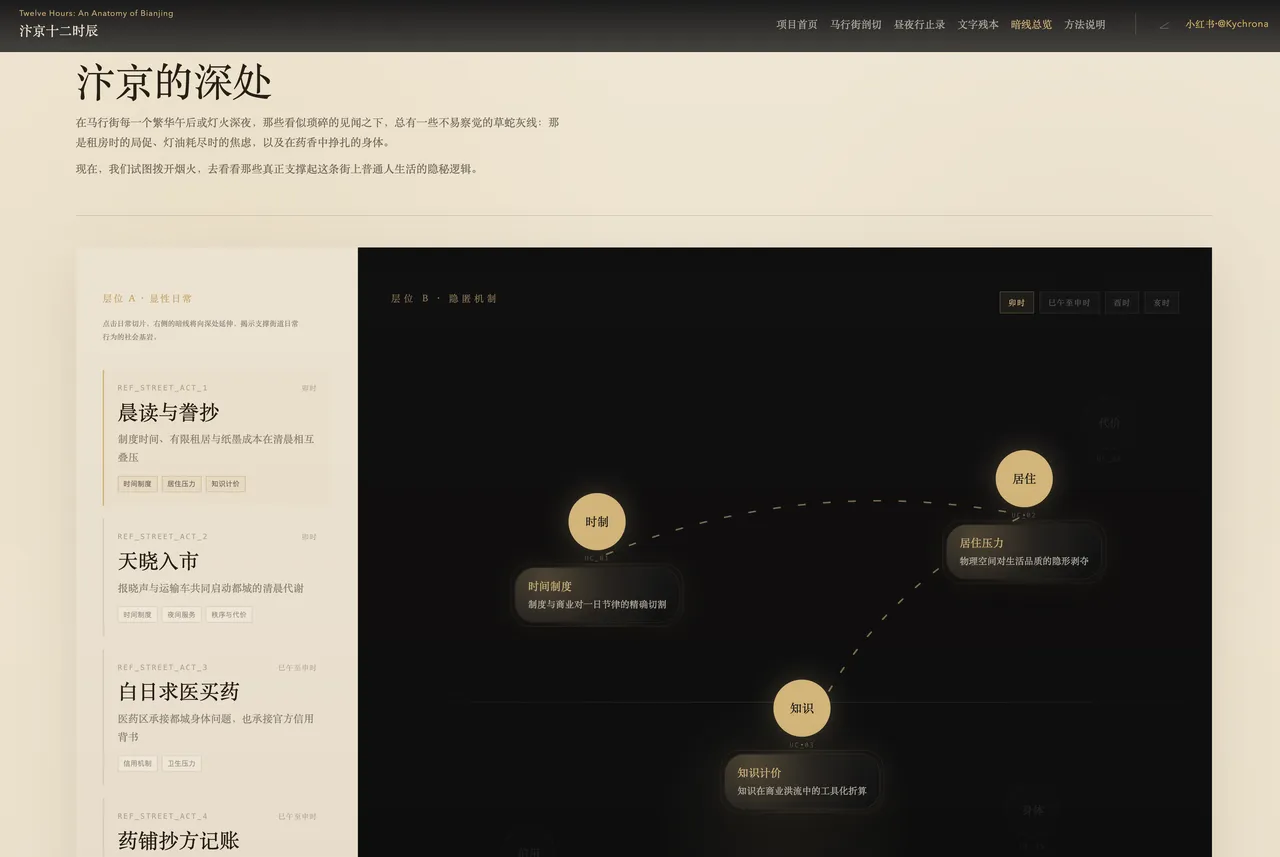
写在前面
首先,整个工作流程是这样的:
研究材料 → 策展文本 → 叙事结构 → 视觉语言 → 前端实现 → 测试部署 → 日志复盘其次,涉及到的AI工具和分工协作是:
Codex:开发主力:项目管理、文档整理、代码实现、调试、部署、多线程协作
Gemini:学术研究和前端构思:文本研究、长材料梳理、设计语言讨论、前端样式讨论、图像提示词构思
GPT Image:图像生成:前提是提示词已经讨论清楚你自己负责的则是最重要的策展判断:
这个项目在讲什么,主题是什么
文本材料和图像是如何组织的
策展的叙事结构和逻辑是什么
设计语言和交互形式是如何设计的,才能适合我们的策展叙事下面我会采用 AI工具+工作内容 的方式逐一对流程进行说明。
注:关于codex/gemini/gpt image的教程,网上视频已经很多了,所以我在此不再赘述了。
如果有小伙伴还不熟悉codex这类ai coding工具,或者对ai coding没有任何基础,推荐大家去看 NEXT蔡蔡 这位博主面向小白的编程教程。
codex:open ai公司推出的ai coding工具,你可以将其理解为一个会编程的gpt,用户通过自然语言描述,即可实现项目开发。同类工具还有cursor, claude code等,国内对标的产品是TREA。不过我还是建议大家如果有条件,使用codex会获得更好的开发体验。codex在多线程处理方面的能力,天然契合我们这种需要经常调整和回滚的项目。
gemini:谷歌开发的ai对话工具,类似豆包/kimi/deepseek,大家按自己实际情况选择一种就行。
gpt image-2: open ai最新的文生图模型,国内类似产品是即梦/可灵。一、codex+gemini:确定策展主题和研究文本
先确定项目在策展什么
做线上博物馆/线上策展,最先要确定的是策展对象——
可以是:一座城市、一条街、一个人物、一组档案、一批文物,或者某种社会机制、历史问题。
这个对象越清楚,后面的页面结构越容易稳定。
你可以从自己熟悉的领域出发,去延伸思考,进而确定策展主题。
这一阶段最适合让 Codex 或 ChatGPT 参与讨论,先抛出一个模糊的主题,让AI帮你反复追问:
这个主题真正处理的对象是什么?
从该主题中,可以发散和引申的内容是否能撑起一个复杂叙事?
先进入哪些学术材料,哪些材料暂不涉猎?
观众从什么尺度进入?
人物、物件、地点、时间、档案,哪一个更适合作为入口?
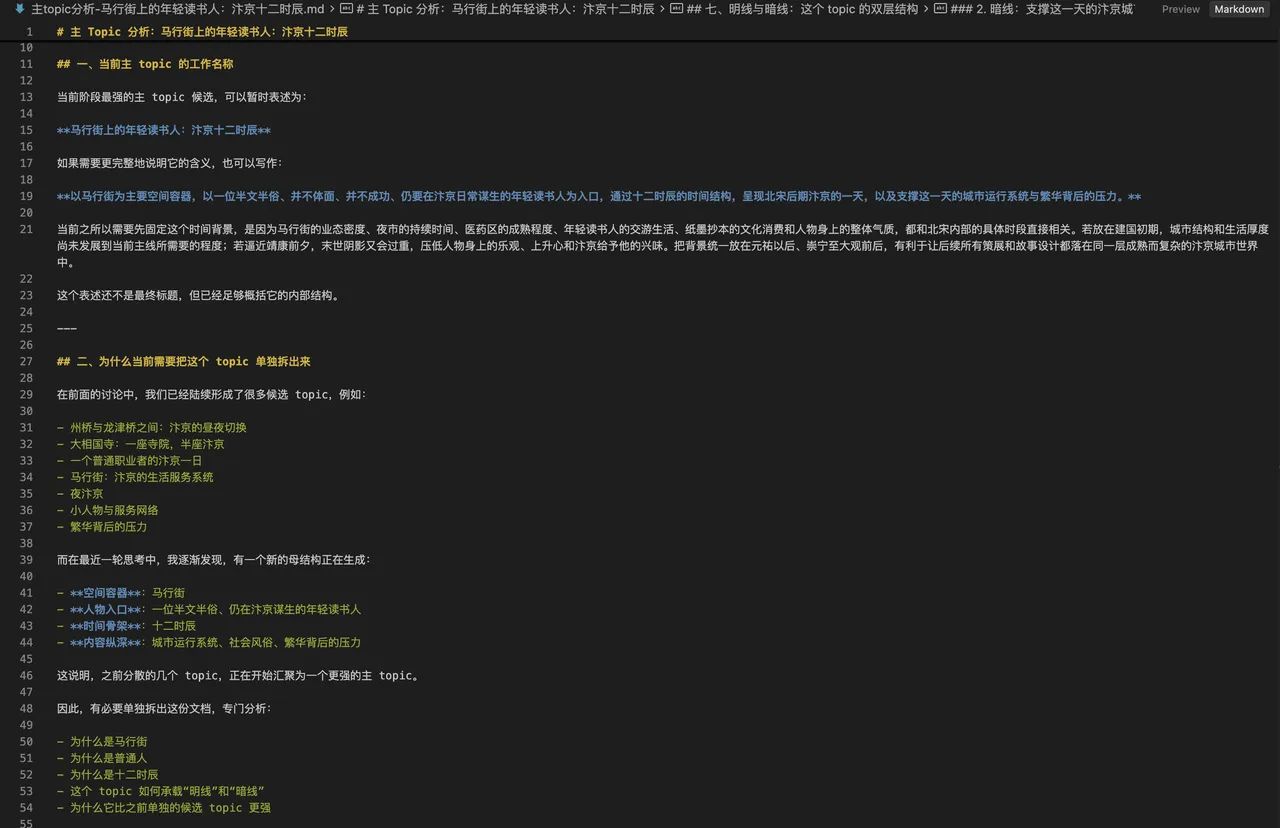
当前阶段先做到什么程度?这里产出的内容是一份简短的项目说明,它会成为后面所有工作的基础。
比如这样:
确定策展主题之后,你需要搜集相关的学术材料。只有足够丰富的信息密度,才能支撑的起一个策展,否则会滑向文章阅读。
在我的实践里,学术研究和材料搜集主要交给 Gemini-research,gpt-thinking也可以。它们适合做历史背景、材料线索、空间信息、相关论文的系统梳理。
注意这里一定要让ai给出材料来源。对于数字策展来说,页面上的每一段文字、每一张图、每一个交互入口,都应该有研究基础。
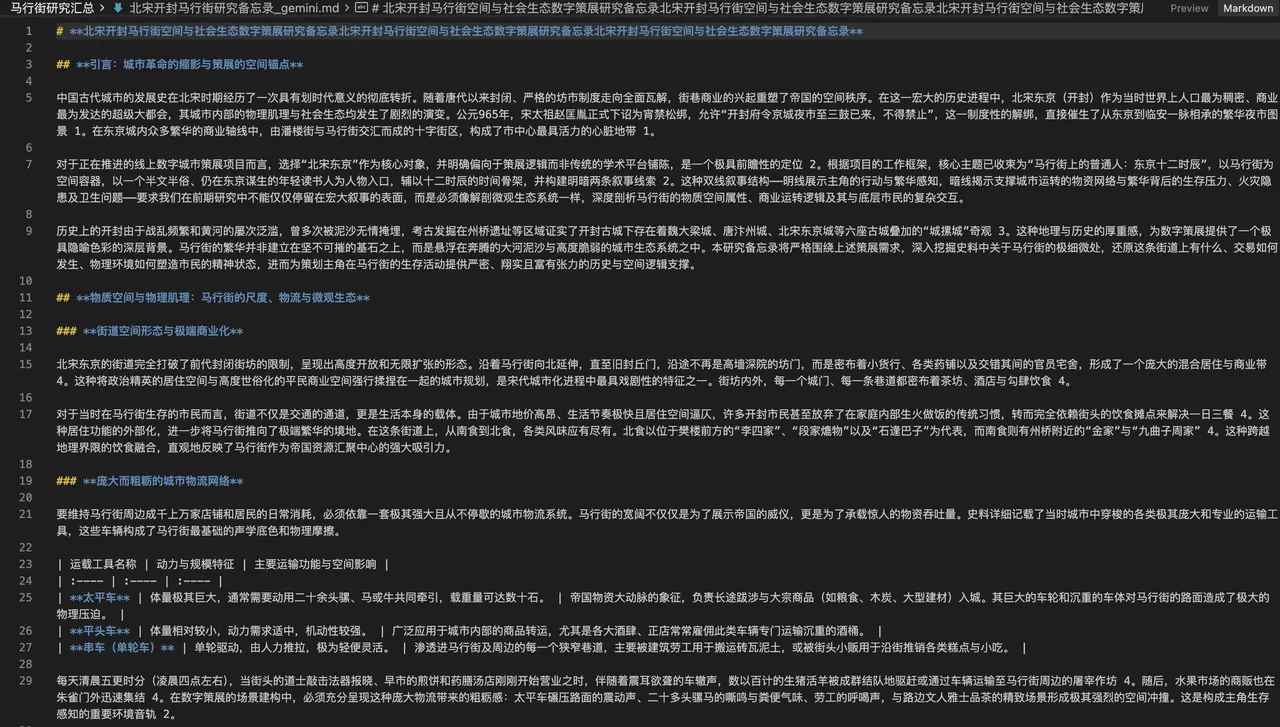
这里的产出是一份详细的研究稿件和材料整理。
类似这样:
但是,研究稿本身还不是网页内容,这就进入到下一步,策展文本转译。
二、codex:形成策展文本
把研究材料写成能进入页面的内容
研究稿通常是给自己看的,它可以长,可以保留复杂背景,也可以有很多细节,但是不能直接作为策展网页。
网页上的策展文本需要另一种写法:它需要能直接落到页面模块里,比如标题、导言、主题卡片、正文、图注、资料入口。
所以第二步,是把研究材料转成策展文本。
以《汴京十二时辰》为例,一个高光时段页会从人物经验进入,比如年轻读书人在马行街药铺做文字劳动。接下来页面会把它转成策展主题:医药区的空间集聚、城市身体与卫生压力、文字劳动如何在街市中被计价。最后再接入史料和研究来源。
你可以让 codex 把研究稿拆成这样的结构:
项目主入口
观众进入层(一个人物动作、一件物品、一个地点或一个问题)
策展主题(这一页真正处理的问题)
主题展开正文
资料入口
可选配图说明这个过程里,Codex 很适合做内容结构整理,它可以长期保存项目文档,并把研究稿、页面结构、前端代码、设计规范放在同一个工作区持续推进。
策展文本完成后,不要马上进入视觉设计,而是先拆叙事结构。
三、codex:叙事页面拆分
把策展文本拆成页面和模块
对于宣传类/展示类产品,网页开发很早就会开始问"这个页面应该怎么设计",但是数字策展要先问"这些内容应该被拆成哪些页面和模块"。
一个研究型数字展览通常不止一种页面:
入口页
主索引页
核心专题页
跨主题分析页
资料页
方法说明页不同页面承担不同任务。入口页负责让观众进入项目,索引页负责组织路径,专题页负责展开内容,分析页负责总结关系,资料页负责回到证据和来源。
比如,在《汴京十二时辰》里,首页承担“进入汴京”的任务,马行街总页承担“进入主舞台”的任务,高光时段页承担“深入阅读”的任务,暗线页承担“结构抽取”的任务,资料层承担“回到依据”的任务。
当页面类型确定后,你就能知道每一页的主角是谁,图像放在哪里,文字有多重,交互让观众进入哪一层,那么后续的前端实现就会顺很多。
这一阶段可以用 Codex 来做。你可以让它帮你生成页面类型表、模块字段、导航关系和数据结构。
你可以这样提问:
请根据这些策展文本,拆解这个数字展览需要哪些页面类型。
每一类页面的任务是什么?页面主角是谁?需要哪些模块?
观众如何进入和返回?哪些内容适合作为资料层?这一阶段的产出,最好是一份页面结构文档,它会直接指导前端代码。
类似这样:
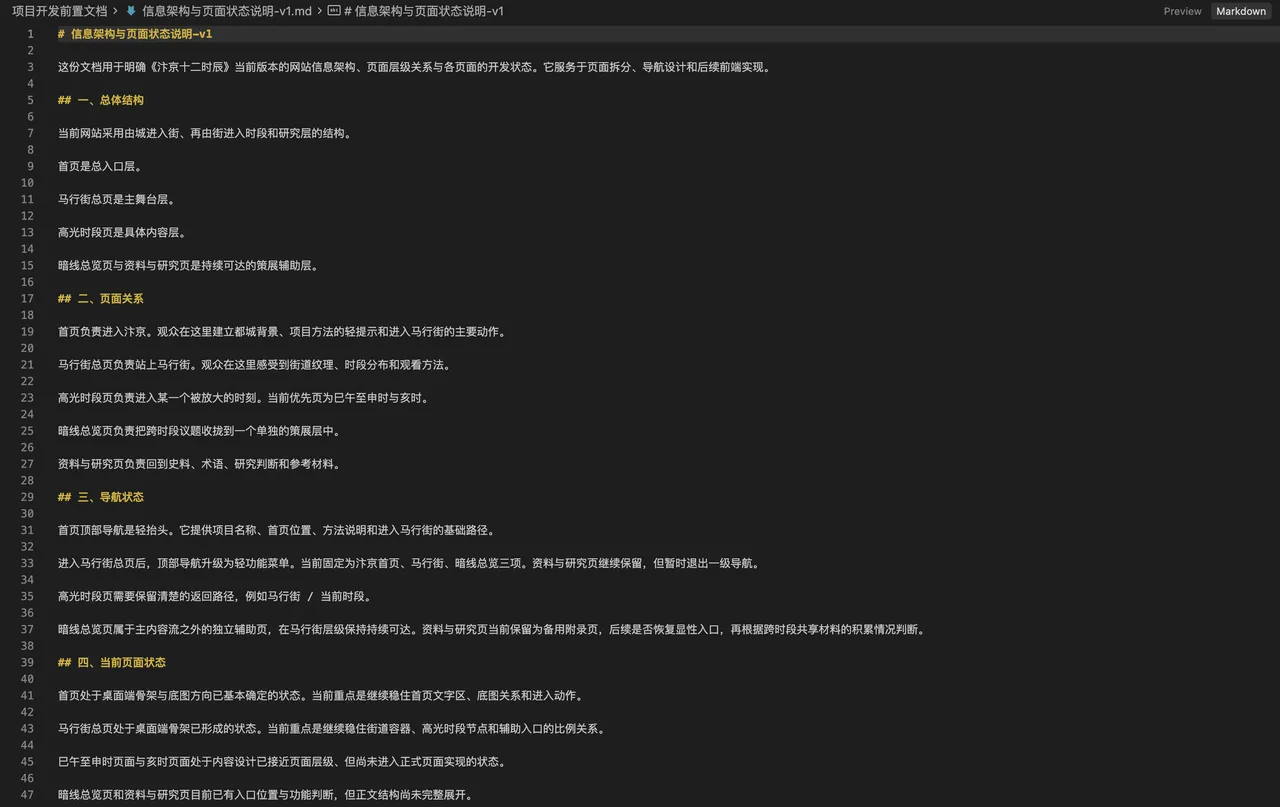
同时,这一阶段也要判断交互逻辑。滚动、点击、地图热区、时间线……每一种交互都要对应某种策展关系:进入、比较、查看证据、返回上一级。如果没有对应的内容层级交互,就会干扰阅读。
四、codex+gemini+gpt image-2:视觉语言呈现
先确定设计语言,再做具体页面
视觉设计要在页面结构清楚之后才进入。
这里所说的设计语言,它回答的是:
这个项目用什么视觉和编辑秩序来组织内容?文字、图像、地图、档案、材料之间是什么关系?
比如,《汴京十二时辰》最后确定的设计语言是“当代学术编辑式”:文字是主角,图像和历史材料作为证据或分析材料进入页面,交互服务阅读路径,而不是为了展示技术。
这个判断非常重要。因为历史类项目很容易陷入复古装饰、古画拼贴、地图铺满背景。看起来有历史感,但页面结构可能会被图像拖走。
这里的产出是一份设计原则和视觉规范文档。
类似这样:
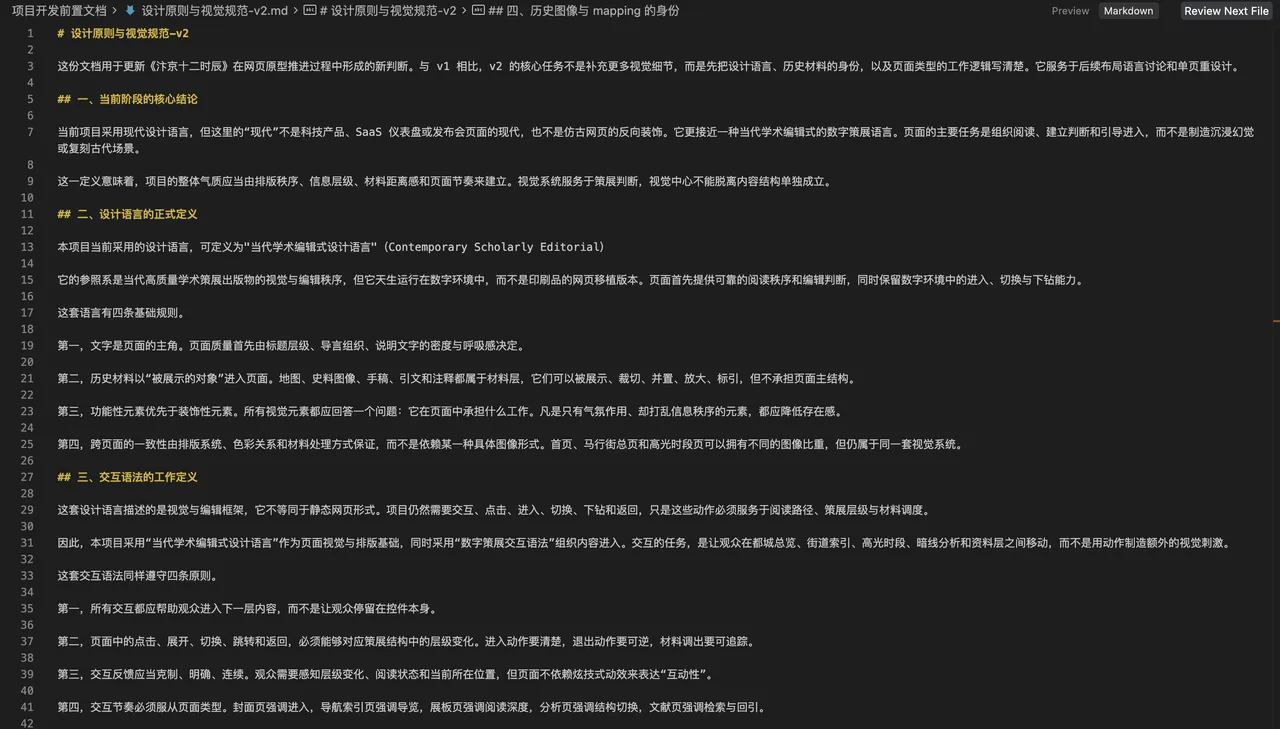
设计语言确定之后,你才能继续判断:
地图是背景,还是材料?
图片是氛围图,还是证据图?
配图是复原图,还是分析图?
交互是为了制造效果,还是为了让观众进入下一层内容?这个阶段我主要和 Gemini 讨论,它的审美判断算是所有ai中最强的,你可以在对话里开启 canvas 直接看效果。方案稳定后再交给 Codex 落地实现。
当然你也可以参考 Figma、设计网站、或者Google Stitch 这类工具。如果有 MCP 接入,AI coding agent 也可以直接读取设计稿或参考页面。不过工具只是辅助,真正关键的是你要先知道项目需要什么样的视觉语言。
配图
这里单独说一下配图/图片生成。
数字策展里的配图,目的是帮助观众理解某个策展主题。利用AI 生成图像之前,你自己要有基本判断。你需要知道这张图服务哪个主题,最重要的信息是什么,应该用什么图像语言。否则 AI 很容易生成漂亮但没有策展功能的图片。
我的制图流程是这样的:
先确定图片主题
确定核心信息
确定制图语言
再和 Gemini 讨论提示词
最后用 GPT Image 生成具体来说:
- 一张图只表达一个核心信息。如果塞进太多信息,图片就会很吵闹,观众不知道该看哪里。
- 确定制图语言:它是 mapping/剖面图/轴测图/热力图/网络图?不同制图语言的线条、构图和信息组织完全不同。
- 之前两步确定后,再写提示词。我的做法是先和 Gemini 讨论图像风格和提示词,确定后,再放进 GPT Image 生成,GPT Image 对成熟提示词的承接能力是最好的。
五、codex: 代码实现
用 codex 把结构和视觉落地
这个项目里,Codex 基本负责了全流程推进,包括前期构思、整体架构、代码实现、部署和测试。
在代码实现之前,你需要和codex明确相关开发构想,这些信息会直接决定项目的技术架构和实现方向。
平台载体是什么:web/app/pwa
是否涉及云存储和用户信息同步
项目部署的平台是什么这里的产出是一份技术架构与实现说明文档。
类似这样:
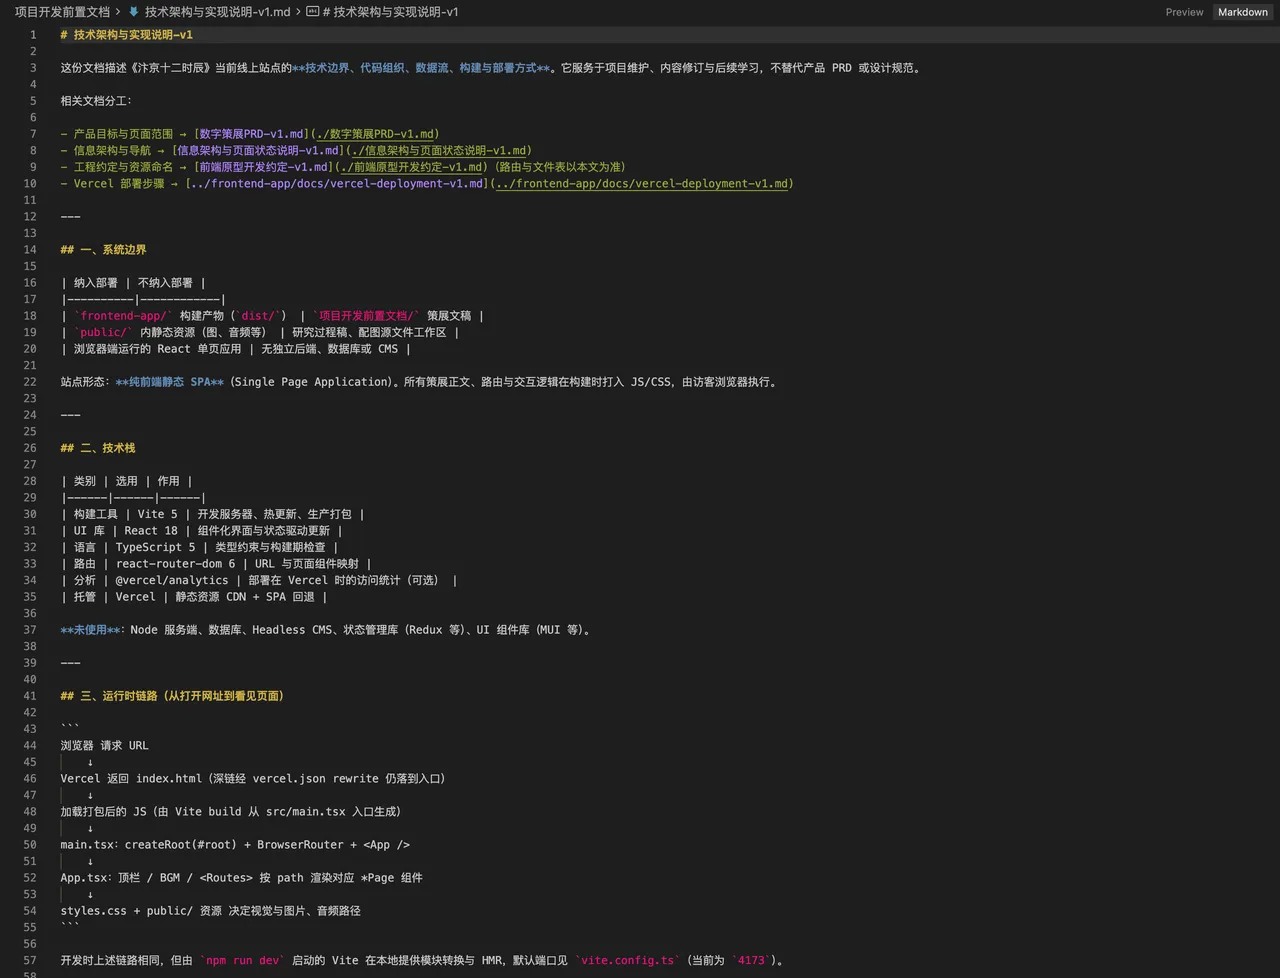
这里我采用的是静态网站架构,Vite + React + TypeScript,不涉及后端数据存储,本地打包后由vercel托管,供大家参考。
另外,Codex 的多线程设计,特别适合这类研究型数字策展项目:
技术架构通常没有特别复杂的数据逻辑,但确定性较弱。你会不断调整文案、页面结构、交互细节、视觉层级,还需要把策展材料和代码同时推进。
在这种场景里,codex的多线程设计就很适合把任务分开,防止上下文污染。
比如我的线程设计是这样的:
Thread A:材料研究
Thread B:页面布局和组件
Thread C:Canvas 或可视化逻辑
Thread D:读取研究报告并整理页面文本
Thread E:部署和构建
Thread F:错误修复同时,Codex 最近的更新也支持在 app 内对页面内容直接做批注和修改。你直接指出某块文案或某个布局的问题,让它直接进入对应代码修改。
比如这样:
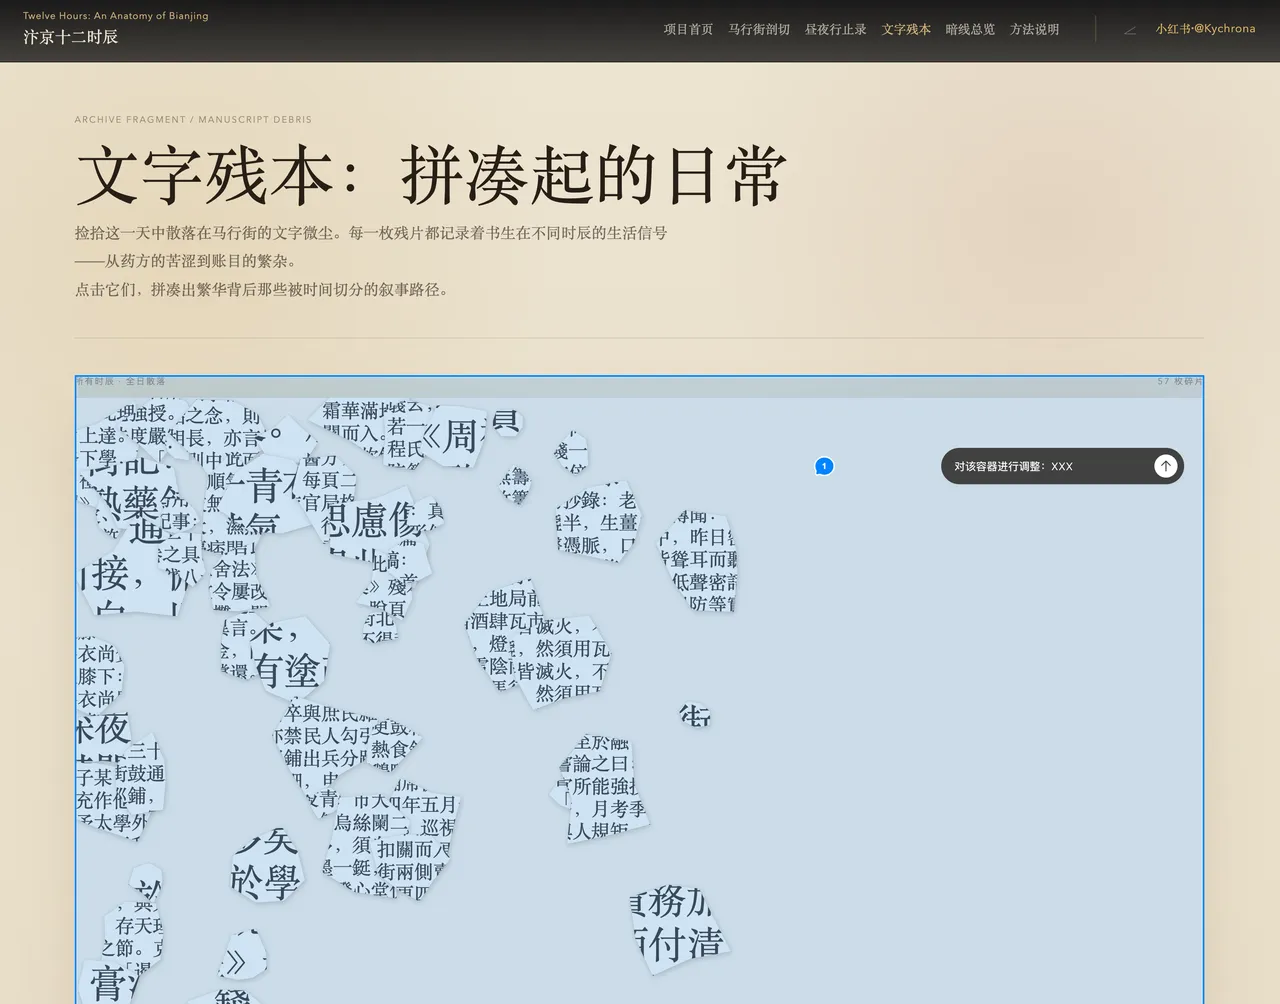
前端实现时,我建议先做一个标准页。
你可以选择一个内容最成熟、结构最完整的页面,用它来测试文字密度、主题卡片、资料入口、图像栏和响应式布局。标准页成立后再扩展到同类页面,效率和稳定性会大大提高。
六、codex: 测试部署
代码实现后,进入测试和部署。
以下是几个重要的测试维度:
内容:这一页到底在讲什么?
结构:页面模块是否对应策展层级?
视觉:图像、字体、颜色、交互是否服务阅读?
导航:观众能不能进入、返回、继续下钻?
响应式:桌面端和移动端是否都能读?
资料:来源、术语、引用和证据是否清楚?部署前需要确认目录边界——
注意你真正部署的是前端工程目录,研究资料和前置文档不要进入线上站点,否则后续的迁移和维护都会混乱。
七、codex: 日志复盘
这里,我们的开发日志只记录关键判断:
这轮在测试什么?
为什么这个方案失败?
为什么某个结构被固定?
哪些规则以后继续沿用?
下一步做什么?类似这样:
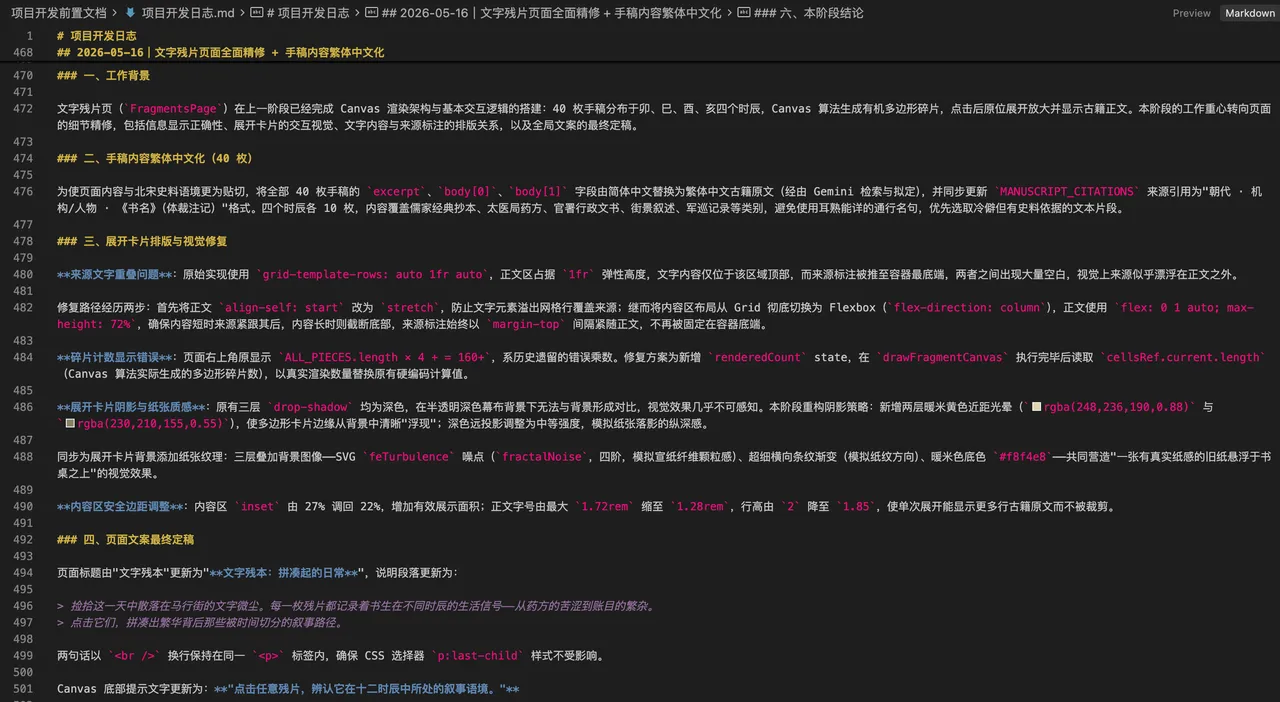
建议每完成一轮推进,就让 AI 帮你写一次日志。
项目结束后,也可以让 ai 为你总结哪些流程可复用、哪些工具组合最有效,方便你下次直接从这里出发。
比如在汴京十二时辰项目中,我就让codex为我总结了一套数字策展skills。
八、几个常见问题
- 太早进入视觉。 如果展览对象和页面结构还没想清楚,就开始进行调配色、字体、动效等具体动作,那么会导致后期方向始终不稳定,频繁修改。
- 研究稿直接进入页面。 线上策展需要进行页面化转译,处理好不同页面层级之间的关系,不能把研究稿直接贴进去。
- 交互抢走内容。 如果在视觉语言和布局规范还没确定的前提下,就进行交互设计,容易导致交互混乱,让观众迷路。
- 图像过载。 一张图塞太多信息,就容易变成装饰性海报,失去信息承载的意义
- 没有记录。 AI 在项目推进上的速度是很快,如果没有日志进行记录和校准,项目很容易失去判断来源,导致开发失控。
九、关于审美和品位
很多人在谈论产品的时候,都会提到 sense and taste,也就是判断力和品位。
在我看来,对于这种有研究性质的数字文化表达:首先是你是否有专业敏感性,是否真的在相关领域里有一定积累。其次才是审美能力。
专业敏感性首先体现在对主题和文本的判断上。你要能看出一段研究材料里真正有价值的判断是什么,哪些细节应该保留。它需要在准确和可读之间找到平衡。
然后才是设计审美,这也是长期积累的。虽然现在AI 可以帮很多忙,但是你始终需要判断哪个方案才是真正服务这个项目的。
只有这两个能力层叠在一起,才是研究型数字策展真正需要的 taste。
写在最后
总的来说,用 AI 来做线上博物馆,核心之一,是把项目拆成一条清晰的工作流:
先做主题研究,再写策展文本;先拆解结构,再做视觉涉及;先建立标准页,再扩展页面;每一轮都记录判断。
其二,是善用不同的AI工具,让协作效率达到最大化。
祝大家都能打造属于自己的数字博物馆。
