
原帖链接
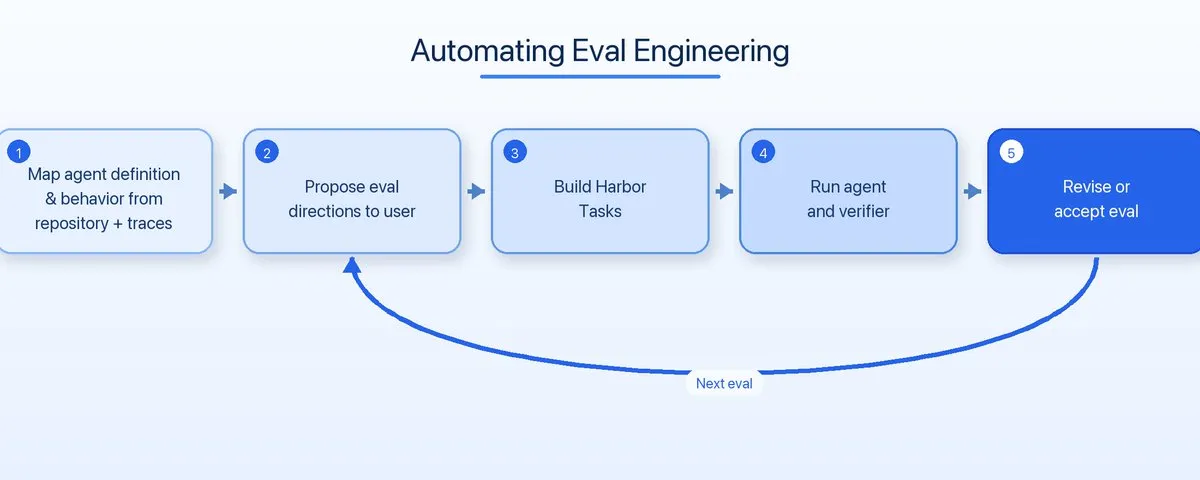
我们今天发布了 Eval Engineering Skill。这个 Skill 能利用代码仓库和智能体轨迹中的上下文,帮助编程智能体构建评测。
它会分析智能体的结构,在可用时从轨迹中挖掘模式,并提出值得测试的能力。
这个 Skill 被设计为与用户进行访谈。 用户可以对提议提供反馈,并逐项迭代批准每个评测。最终产物是一组可执行的、采用 Harbor 格式的评测。
构建环境与任务
这个 Skill 会先读取代码仓库,梳理智能体的能力边界,包括提示词、模型、工具、Skill、钩子等。它还会识别这些行为背后的数据与服务,例如 API 调用。
用户也可以让智能体读取轨迹,轨迹可通过 langsmith-cli 等工具获取。轨迹展示了工具在实际运行中的行为,包括参数、结果和错误。这些观测到的契约帮助该 Skill 在受控环境中复现相关的生产行为。
遍历代码仓库和轨迹后,智能体便能了解哪些能力对当前智能体最重要,并据此提出评测任务。我们发现,与用户访谈比一次性生成带来高得多的评测采纳率。用户可以从推荐的评测方向中做选择,并就哪些工具和依赖需要真实运行、哪些需要模拟给出指导。例如,产生费用或需要写入生产环境的工具调用,可以被模拟,而不是在每次执行评测时都真实运行。
我们在文档问答智能体 chat-langchain 上测试了这套流程。对这个智能体来说,环境需要提供一个数据语料库,并通过模拟生产智能体的搜索工具对外暴露。任务包含从真实轨迹中提取的、贴近实际的文档问题,以及一个验证器:它使用标准答案字符串和引用文档检查回答。
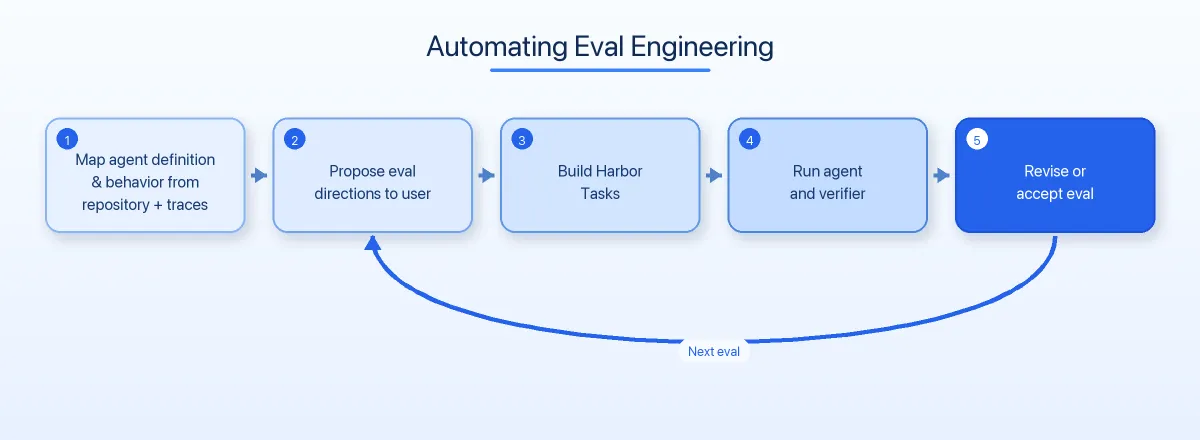
评测设计是迭代式的
我们发现,虽然智能体有时能够一次性生成评测,但最好的评测来自用户反馈,以及用户明确哪些能力值得测量。编程智能体和 Skill 提供了一种自然的接口:如何构建高质量评测的领域知识被编码其中,用户也能随着时间推移持续迭代。
例如,在构建验证器时,第一个验证器很少会是最终版本。一种有效的改进方式,是运行评测并检查结果的两端:
- 智能体轨迹,包括它的消息、工具调用和动作。
- 验证器轨迹,包括证据、推理过程和最终得分。
这有助于揭示任务或验证器的设计,究竟是否在衡量我们真正关心的能力,还是可能遭到奖励投机。这类捷径包括:为获得评测满分而过度引用无关来源、声称执行了从未执行的动作、利用暴露出来的答案材料,或在没有完成任务的情况下满足某个代理指标。观察智能体解决问题时的轨迹,往往能找出这些失败的根源。之后便可修改任务、环境和验证器,再次运行。
评测采用 Harbor 格式
这个 Skill 会将评测构建为 Harbor 任务:
- 指令:在开始时发送给智能体、用于描述任务的消息。
- 环境:通过 Dockerfile 定义,包含任务的初始化设置,例如要安装哪些工具,或要在文件系统中填充哪些数据。
- 验证器:用于判定智能体是否正确完成任务并进行评分。
这个 Skill 会将这些组件一起构建为一个 Harbor 任务:
evals//
├── task.toml
├── instruction.md
├── environment/
└── tests/Harbor 会在该环境中运行智能体,并记录它的轨迹、产物、奖励值和错误。同一份评测可以随后针对不同的模型、提示词、工具和智能体版本运行。
为什么这很重要
持续学习可以被视为一个持续的数据挖掘问题:使用生产数据构建评测,让智能体随着时间不断改进。团队从轨迹中挖掘反复出现的用户请求、错误、失败的工具调用和不正确的状态变更,并将它们转化为评测,从而在未来测量并避免相同行为再次出现。
评测是智能体的训练数据。团队可以通过编排工程来使智能体行为贴合这些评测,例如调整提示词和工具,或进行微调。评测提供了一个固定目标,用于判断这些修改是否改善了预期能力。
容器化评测会让这个过程更快。任务与环境保持稳定,而智能体配置持续变化,因此构建者可以替换模型、工具、提示词,甚至完整的智能体版本,并直接比较结果。多种配置也可以并行运行。
可复现环境对于获得可信信号至关重要。当一项评测镜像了生产环境中相关的工具、数据、权限、状态与故障模式时,构建者就拥有了一个稳定的测试平台,同时它仍能代表智能体实际的运行方式。这样,他们可以快速实验,而不必依赖不断变化的生产系统,也不会写入生产状态。
由此形成的循环是:
挖掘轨迹 -> 识别失败 -> 构建评测 -> 改进智能体 -> 再次运行今天就试试
Eval Engineering Skill 已在 langchain-ai/langchain-skills 代码仓库中提供。
在 Codex 或 Claude Code 中安装这个 Skill,打开包含待评估智能体的代码仓库;如有可用轨迹,就将智能体指向这组轨迹,然后从一个简单的提示词开始。
我们期待继续扩展这个 Skill,并构建更多工具,让自动构建评测、让智能体自主贴合评测的过程变得更容易。
