这两天还在外面,今天给大家发一篇之前已经写好的,重读经典论文系列第二篇。
第一篇发出后,对于内容,大家大部分还都是肯定的,也有不少小伙伴说太长了。
实话实说,如果是让我看一篇八千多字的文章,也确实很有压力。
所以还是要尊重读者的意见和传播规律,今天这篇就在文章精华保留的基础上,把文章的字数进行适当的压缩。
好了,继续上车。
上回说到,Transformer 让模型把语言从一条线变成了一张关系网,但光会读还不够,最终听懂了还是为了干活的。
你让它写点东西,你说写得好一点。
它给你一篇大路货。
你洋洋洒洒写了几百字要求,它还是差点意思。
然后你急了,随手贴了一段自己以前写的爆文,说照着这个感觉来。
它突然就一下子给出了一篇你想要的效果。
是 Prompt 写得更好了吗?
不是。是你无意中触发了一个在 2020 年就被论文验证过的机制。
这件事,就是我们今天要聊的。
先交代一下背景:GPT-3 出现之前,大家是怎么干的
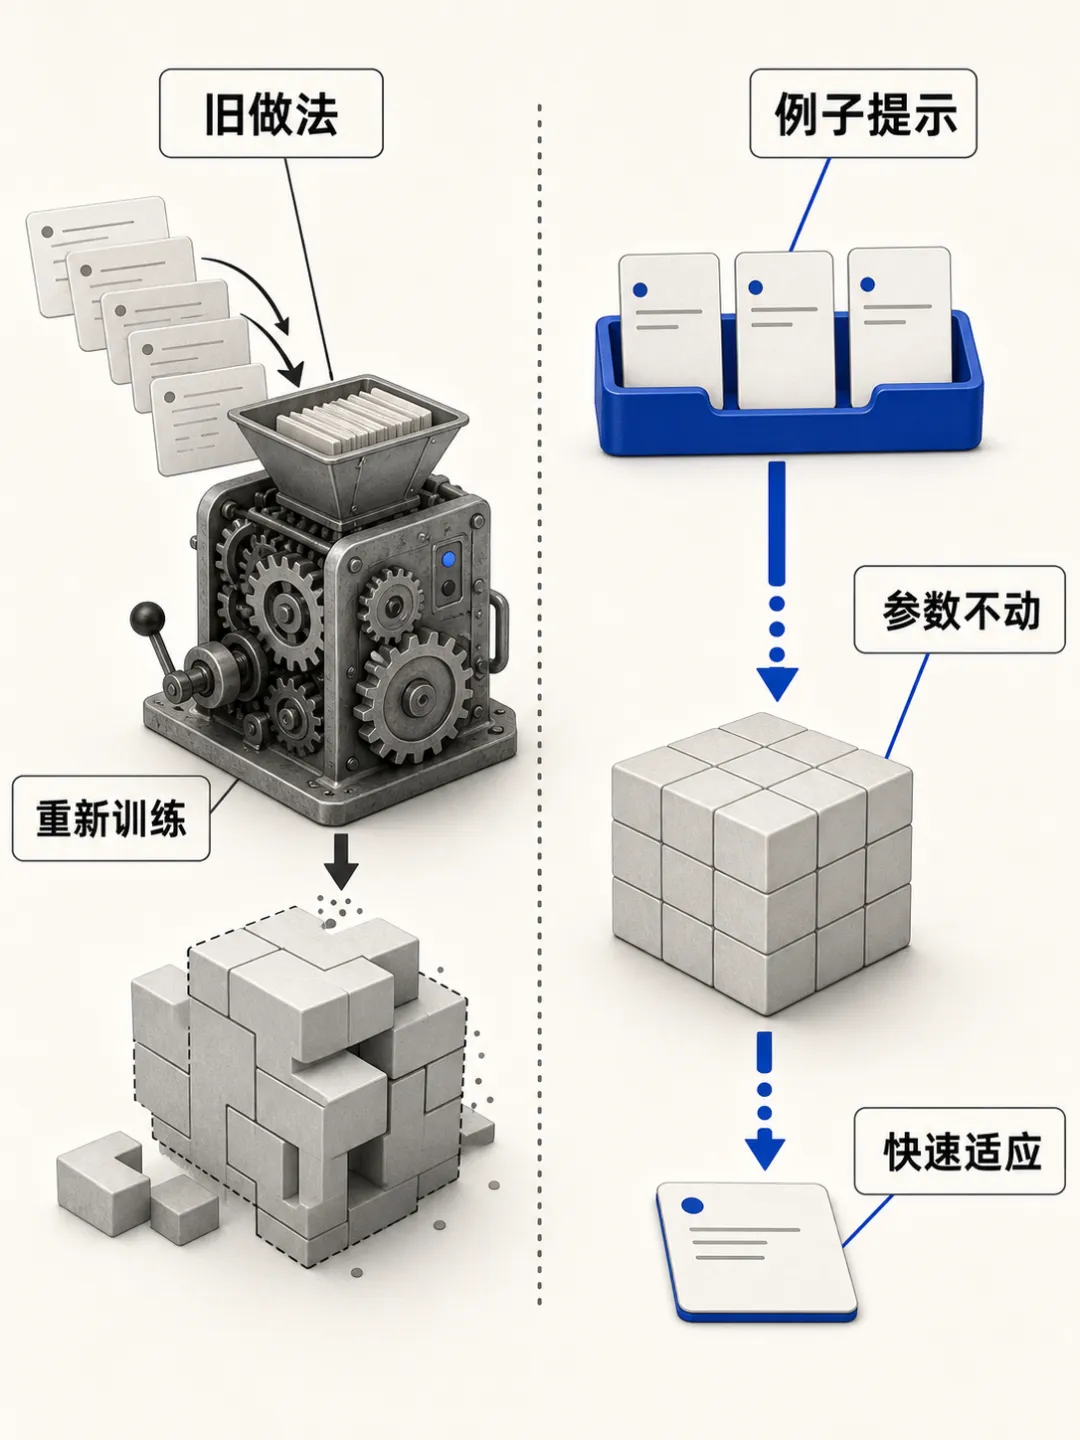
2020 年以前,如果你想让一个语言模型学会新任务,标准做法叫微调。
啥意思呢?你得准备几百条问题加标准答案的训练数据,然后让模型重新训练一遍,然后模型学会了你的任务。
但同时它也变成了一个只能干这件事的专用版本。
换个任务?再来一套数据,再训一遍。钱花了,时间烧了,折腾完了还得保佑别过拟合。
这就是当年 AI 落地的真实困境:模型很强,但每落地一个新场景都要脱一层皮。
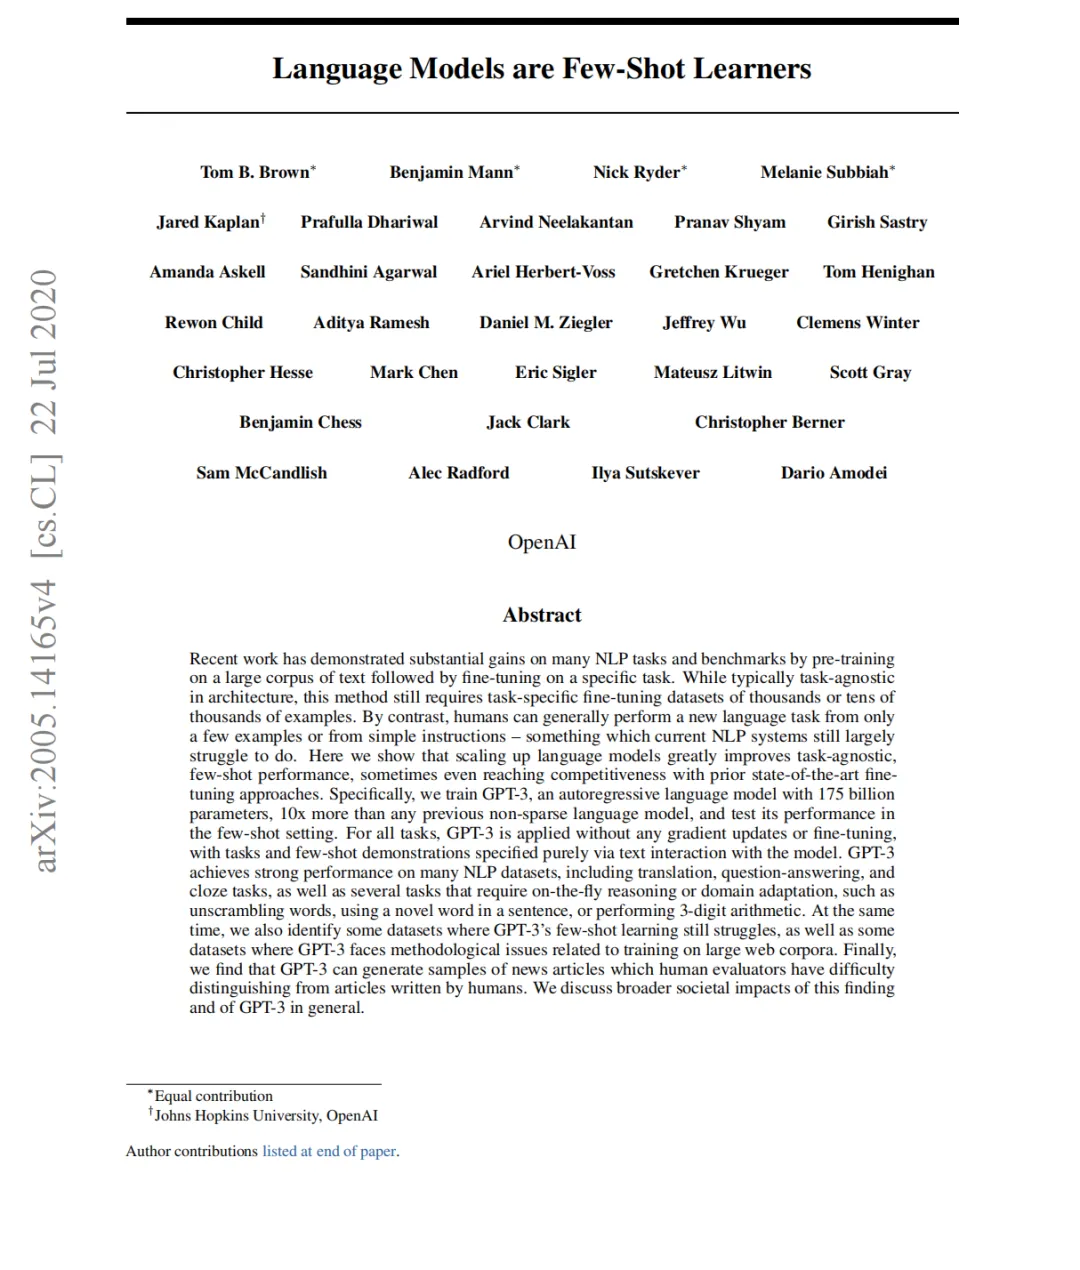
然后 OpenAI 发了一篇论文。
论文:arxiv.org/abs/2005.14165
标题直接一句话:Language Models are Few-Shot Learners。
翻译过来就是:语言模型,就是少样本学习者。
不用微调。不用训练数据。不用更新参数。你在 Prompt 里放几个例子,它自己就适应了。
这篇论文的作者足足有 31 位,占了半页, 2020 年 5 月发布。这篇论文的代号你肯定听过:GPT-3,1750 亿参数。
插一句题外话。
这篇论文发出来的时候,OpenAI 还不是今天这个估值万亿的巨无霸。他们当时更像一个理想主义的研究实验室,把论文、模型参数、训练方法全部公开,那时候是真的 open。
GPT-3 发了之后,微软直接砸了 10 亿美元进来。后面的故事,你都知道了。
所以说,有时候一篇论文不光改变技术路线,还改变一家公司的命运。
说回正题。这次炸场的是那句话:Few-Shot。
它是怎么学会例子的?
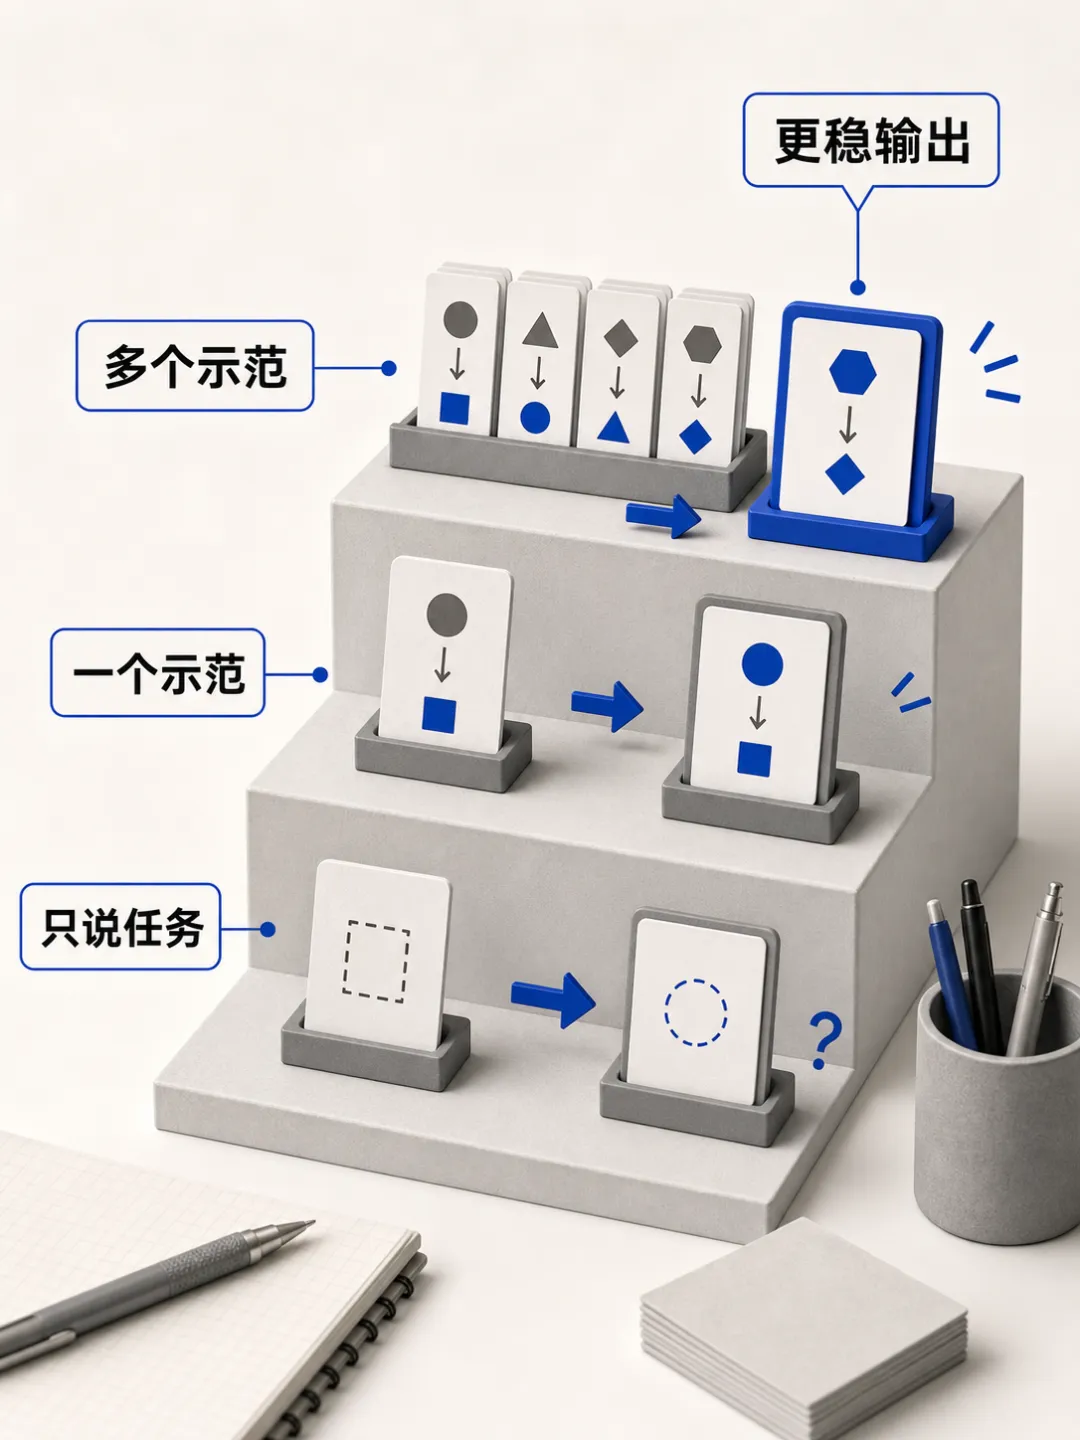
论文把这件事分了三档来说。
Zero-shot(零样本):你只说任务,不给任何示范。
把这段翻译成鲁迅风格。
模型能干活吗?能。但质量像开盲盒。论文里 Zero-shot 在很多任务上已经超过了当时的专用模型,但稳定性不行,翻车率你无法预测。
One-shot(单样本):你给一个示范。
这是我想要的,照着来。
模型直接上了一个台阶。论文的实验数据里,几乎所有任务 One-shot 都比 Zero-shot 有明显的分数跳升。
Few-shot(多样本):你给好几个示范,不同风格的、不同类型的,甚至还贴了一个反例:注意千万别写成这样。
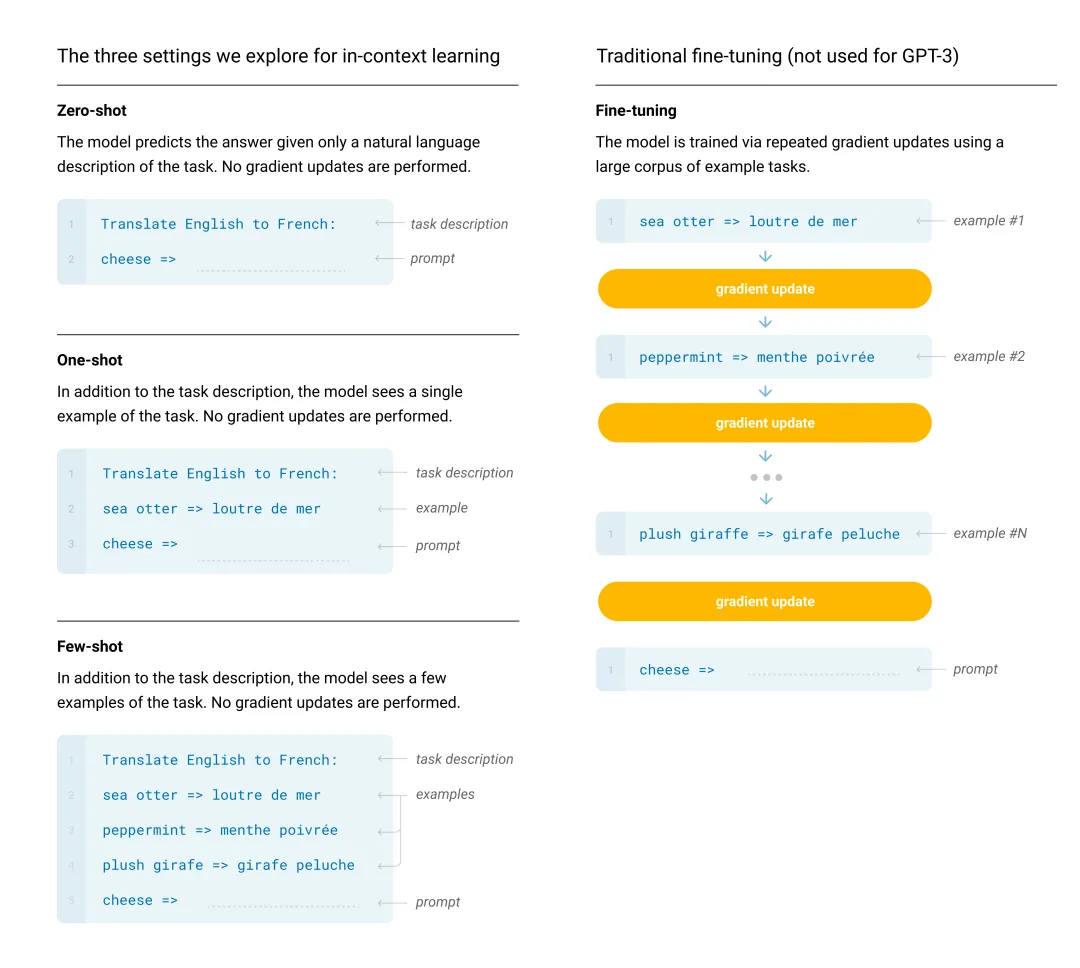
这时候模型基本不会跑偏了。
讲到这里插一句,如果你还记得我之前的文章仿写提示词,就应该明白,那就是一个很好理解的案例佐证。
你让它模仿谁的文章风格,不如直接给它一部某个人的作品集,提取出的文章风格是最准确的。
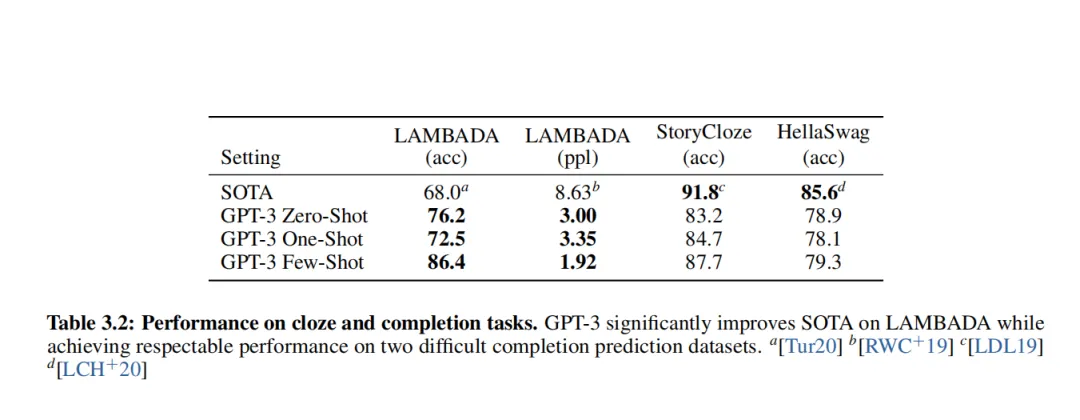
论文拿了 LAMBADA 语言理解任务做对比,从 Zero-shot 的 76.2% 到 Few-shot 的 86.4%。十个百分点的差距,就是给例子这三个字的价值。
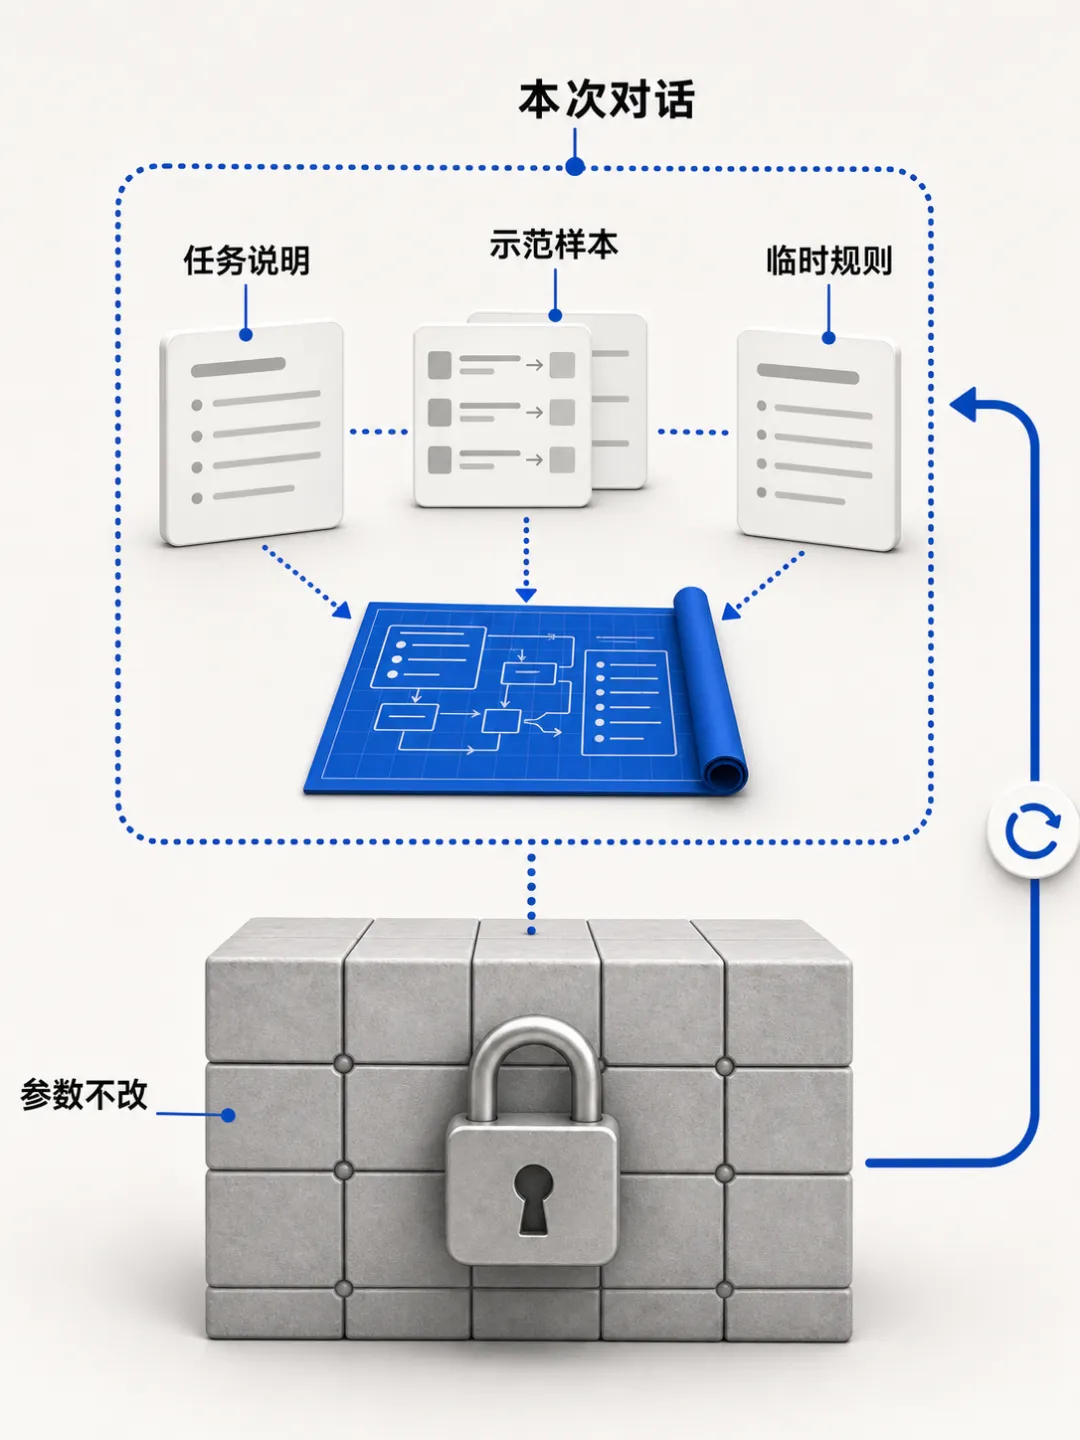
最要命的是,整个过程里模型的 1750 亿参数纹丝不动。
Ok,论文还做了另一个关键实验。
他们同时训练了从 1.25 亿到 1750 亿一共八个不同规模的模型,然后比较它们从 Zero-shot 到 Few-shot 的表现变化。
结果很清楚:模型越大,从例子中获得的提升越猛。
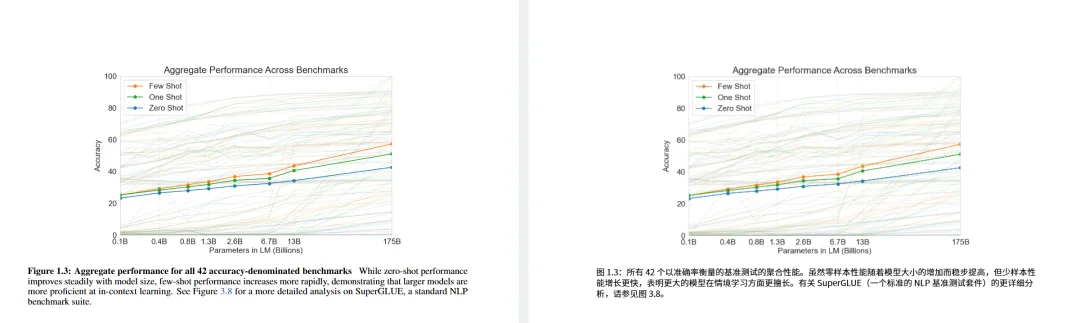
小模型给不给例子差别不大,大模型给几个例子直接起飞。
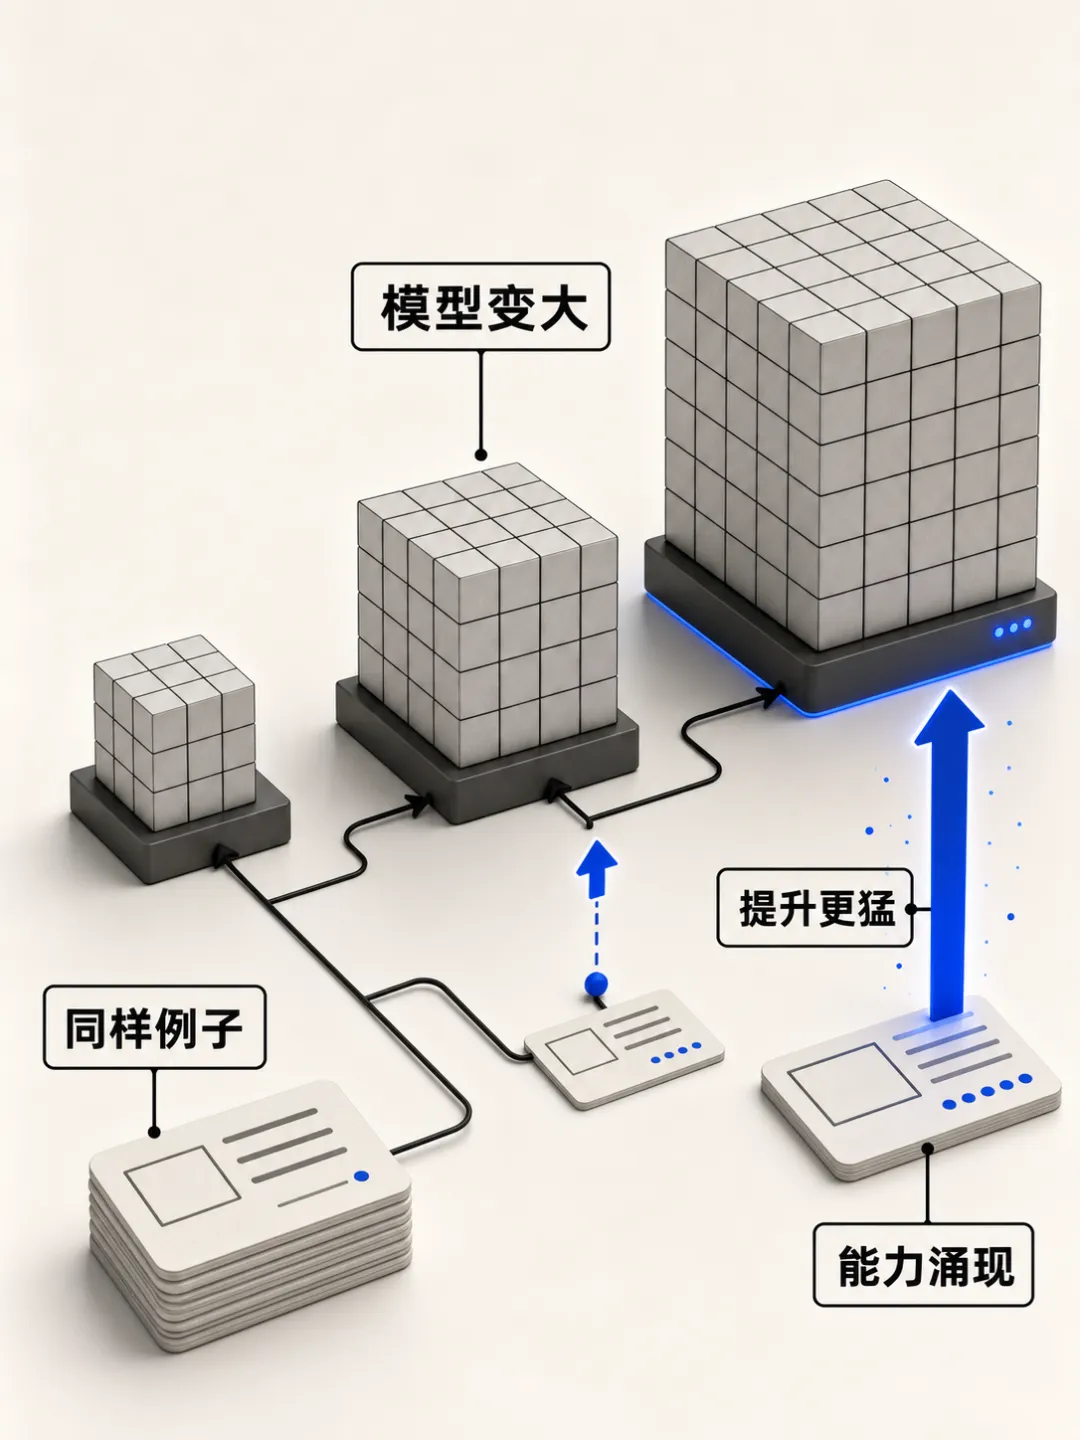
这也是为什么今天你给 ChatGPT 贴例子效果好得离谱,给一个小模型贴同样的例子效果平平。Few-shot 的能力不是凭空出现的,它是被规模这个变量喂出来的。
所以论文的核心发现就一句话:In-context learning。
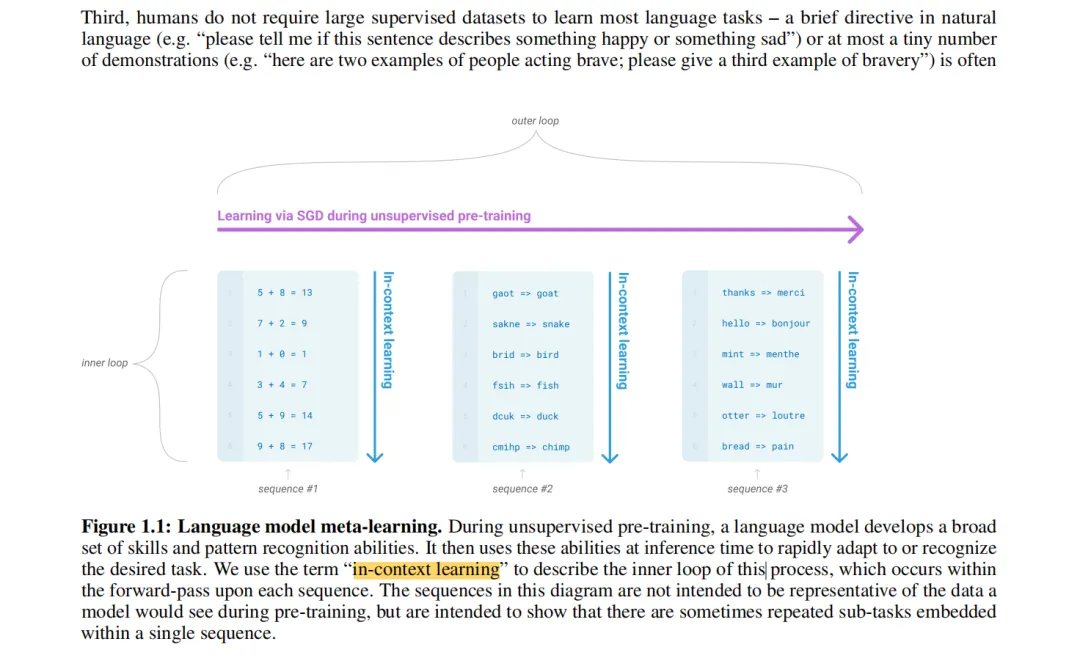
模型不需要重新训练。它在你这次对话的上下文里,用你给的例子临时搭了一个任务说明书。任务描述、示范格式、预期输出,三样东西凑在一起,就构成了一个临时的执行环境。
下次新对话你不贴例子了,一切归零。
重点来了:对今天的你来说,这件事意味着什么
如果你觉得前边的内容看起来有些枯燥,也可以跳过不看,直接看下边的这一部分。
1. 写 Prompt 的第一原则不是措辞,是给参照物。
大多数人用 AI 的习惯是上来就写要求。
帮我写一篇小红书文案,语气轻松一点,要有网感
AI 给你的是一篇最大公约数。
原因很简单。AI 没见过你写的东西,不知道你的好长什么样。它只能从训练数据里猜一个平均值出来。一千个用户跟它说写得好一点,它就给你一千个人的平均好。
你加上一段你自己写的范文,它就有了靶心。
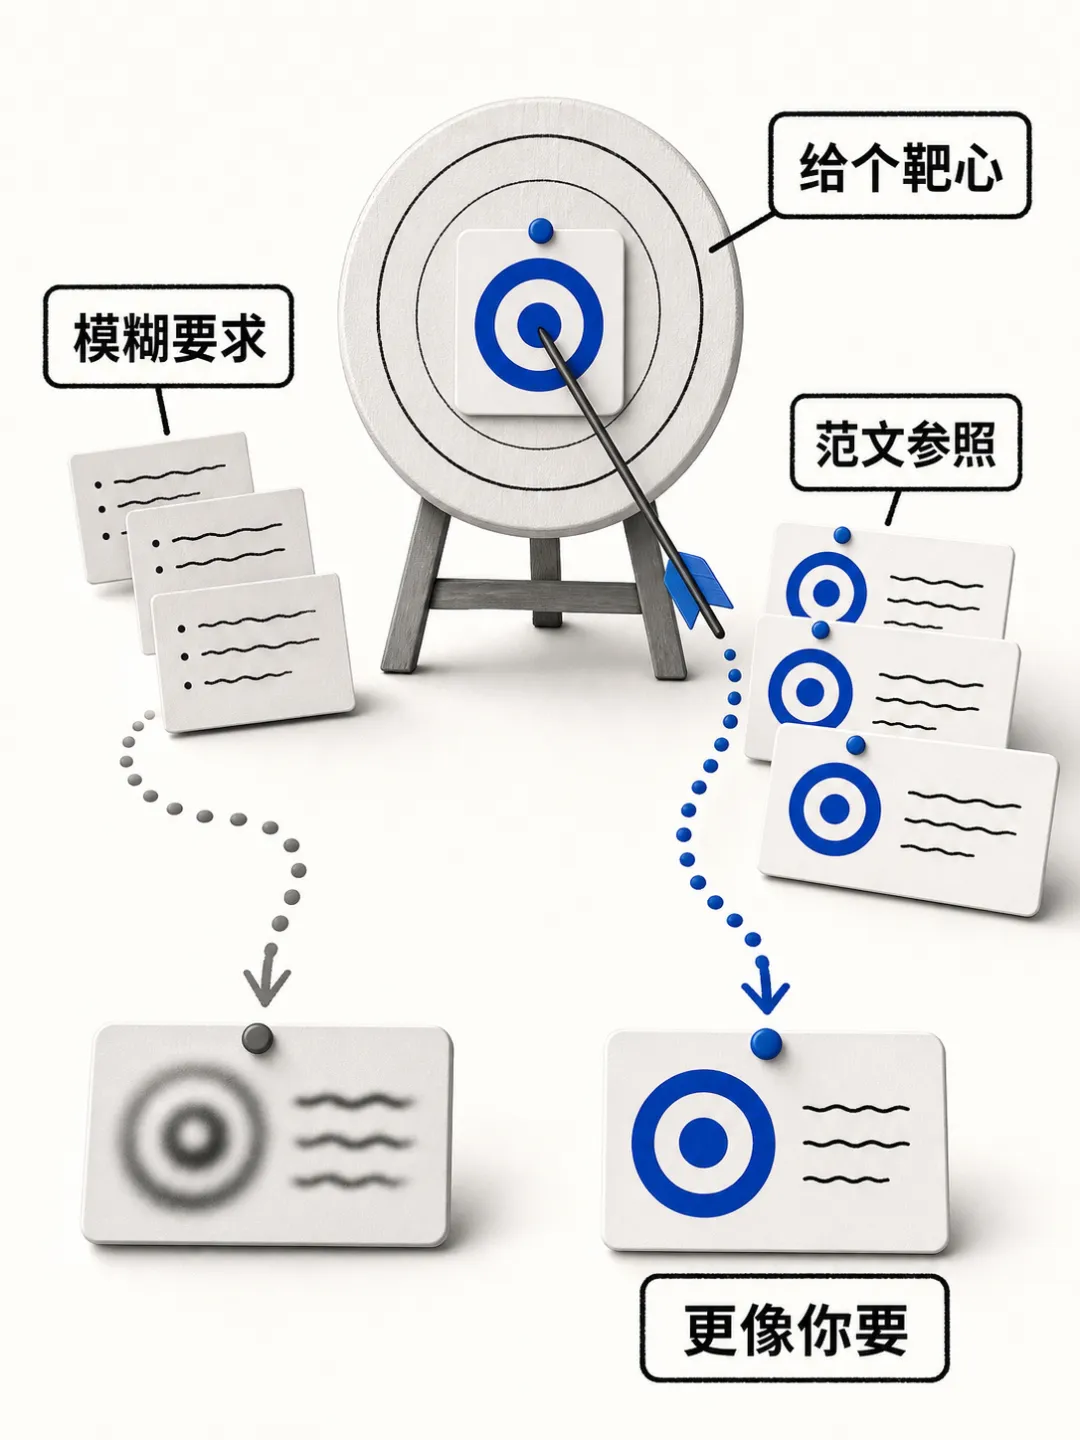
论文的实验曲线验证了同一件事:模型越大,从例子中获得的好处越明显。不是你的 Prompt 写得不好,是你没给它看它应该瞄准什么东西。
2. 你给的例子就是标准答案。例子里有什么毛病,它就照抄什么毛病。
这是 Few-shot 最阴的坑。
你贴了一篇范文,里面用错了一个成语。模型不会觉得这是个错别字我要帮他纠正。它会认为你是对的。因为在你给的所有信息里,这就是正确答案。
它稳准狠地帮你抄进正文,你看了想打人。
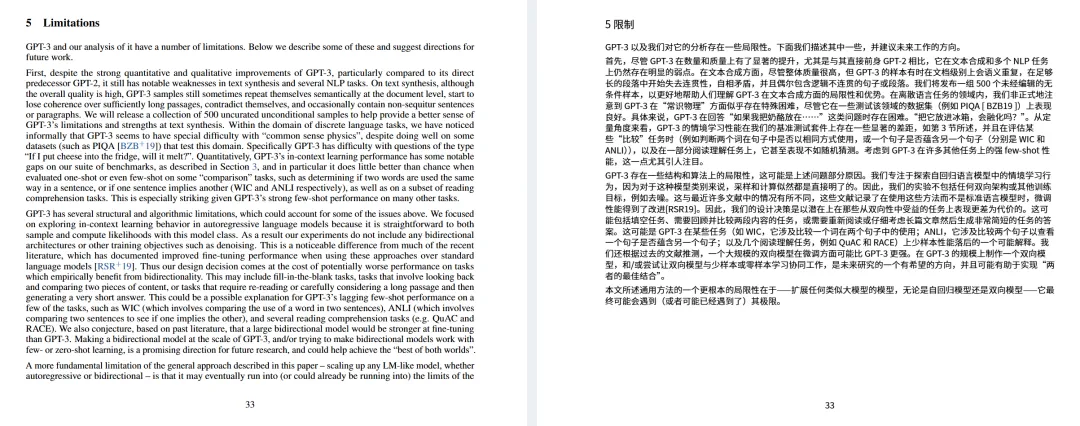
论文在局限性部分也老实交代了:模型没有外部事实校验机制。它不是在理解,它是在匹配模式。你喂什么,它就学什么。
懂了没有?就这个意思。
所以在贴例子之前,有一个动作比反复改 Prompt 重要十倍:先检查你的例子本身有没有问题。
你给的范文里有逻辑漏洞,它给你复刻一份逻辑漏洞。你给的范文里结论偏激,它给你复刻一份偏激。这不是 AI 的 bug,这是 Few-shot 的设计特性。
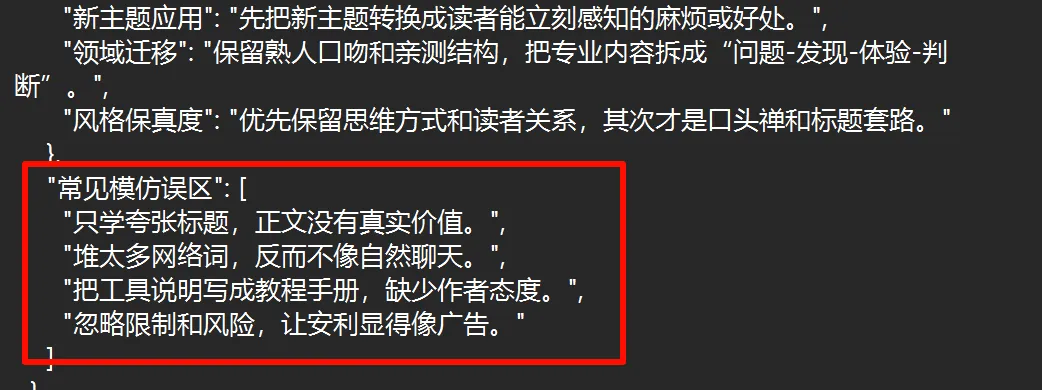
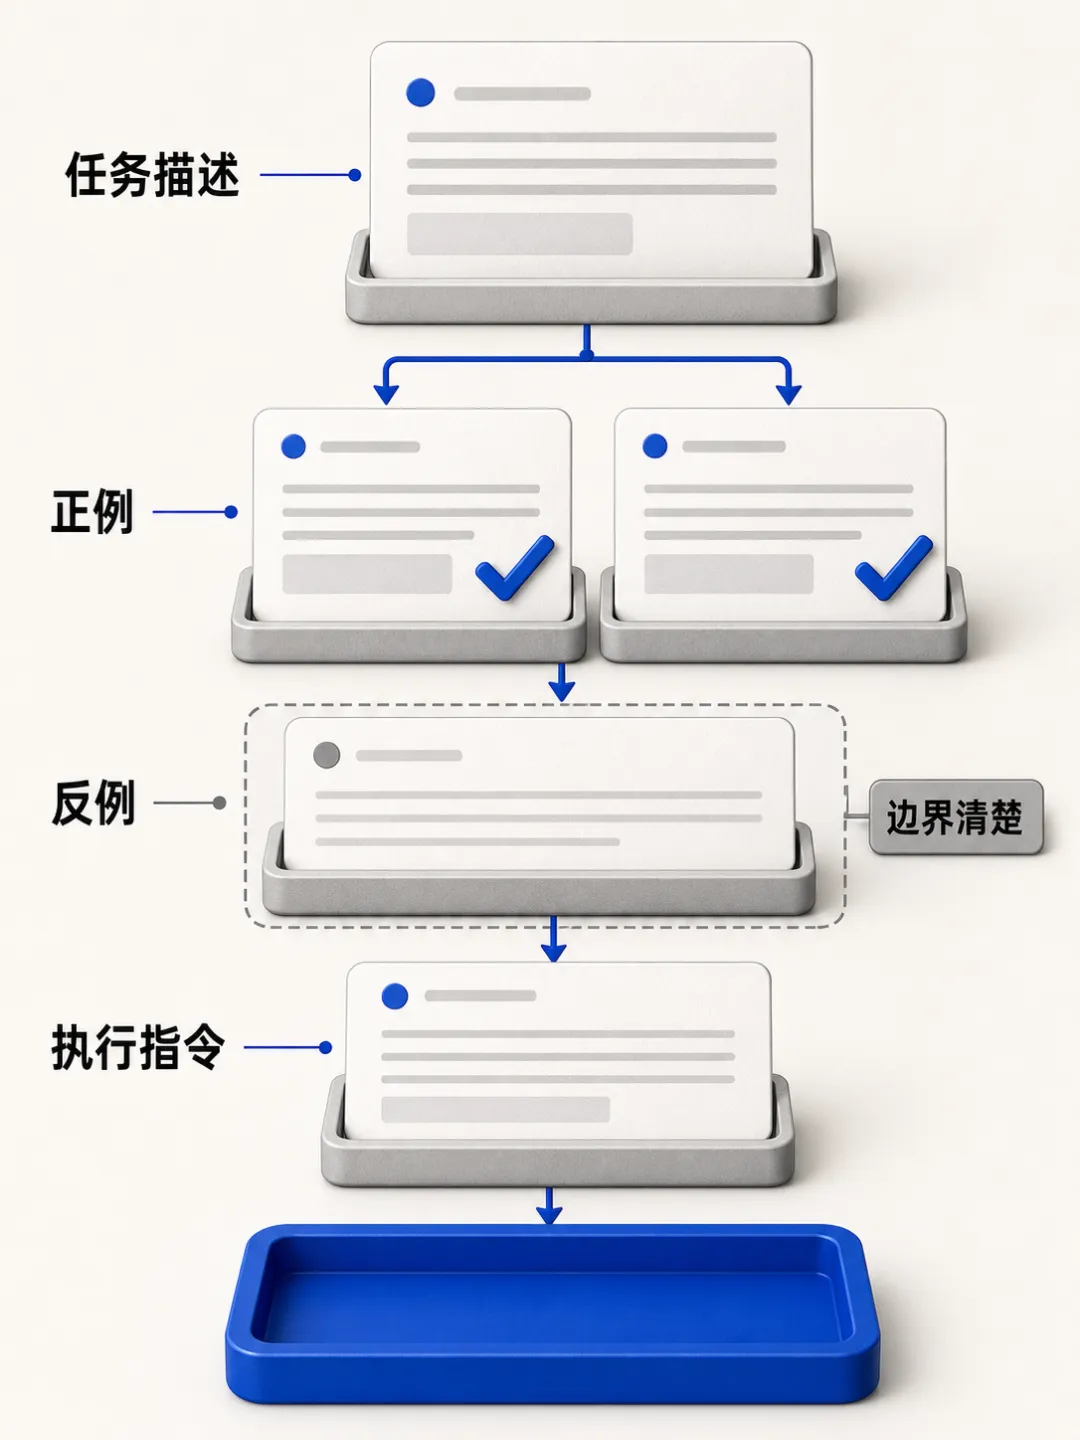
3. 正例告诉它要这样,反例告诉它别这样。两个都给的杀伤力翻倍。
很多人只会给正例。照着这篇写,效果不错,但还有空间。
你只给正例,它知道什么是好的,但不知道边界在哪儿。它可能为了模仿你的风格,把不该学的东西也学了。
加上反例就不一样了。
这篇感觉是对了,但注意千万不要写成下面这种腔调。
还用我那个提示词来举例:
就是这样的效果。
所以一个成熟的 Few-shot Prompt 长这样:两个好例子加一个坏例子,然后说请按前两篇的风格来,避开第三篇的问题。
三篇加起来可能不到五百字,比你写两千字的要求说明效果好得多。
你看,这套写法没那么玄。
4. 它的上下文学习是一次性的。关了对话,从头来过。
这一点最容易误解。
你花了一个小时,贴了好几轮例子,终于把 AI 调到了你想要的风格。然后你关了窗口,明天打开新对话说继续按昨天的风格写。
它一脸懵逼。
因为 Few-shot 不是训练,是演示。你每次新对话都要重新贴。
怎么破?两个办法。
要么每次新对话开头贴一套固定说明,把你的风格偏好、项目背景、核心约束写成一个文本块,Ctrl C 加 Ctrl V。
要么用知识库、RAG、项目文件这类外部记忆工具,让模型每次自动加载你的偏好。这就是我们后面要讲的内容。
结语
这篇原论文很长,75页,对于我们来说,了解上面几句就足够用了。
原来,很多时候大家都以为跟 AI 交流的最高境界是把话说清楚。把要求写详细、写精准、写全面。
但最高境界不是说清楚,是示范对。
你用一千个字描述你要什么,不如丢给它一段现成的文字说,我要的是这味儿。
这个结论在 2020 年之前不是业界共识。当时所有人都认为,模型要适应新任务,必须重新训练或者至少微调。Few-shot 的发现把这条规则直接打穿了:模型不是在学会你的任务,是在你的例子里找到了模式。
所以我现在的习惯是:每次想让 AI 干一件新的、对风格有要求的活,比如说是写作任务,或者是设计任务。
我会先花很长时间找两个好例子,例子找好了,给出的效果就会很容易接近你的要求。
所以如果你在实际任务中,试了好几次得不到满意的效果,不妨可以试试今天介绍的这篇论文的结论。
回过头想,这篇论文真正厉害的地方,不是它造出了 1750 亿参数的模型。而是它证明了一件反直觉的事:
你不用教 AI 规则,你给它看几个正确的结果,它自己就能归纳出规则。
这个发现影响了之后整整四年 Prompt 工程的发展方向。你每天在用的系统指令、角色设定、风格模版,骨子里都是 Few-shot 思想的延伸。
当然,例子能让模型学会格式和风格,但有些事光给例子还不够。
比如你让 AI 解一道复杂的数学题,你给十个例题它依然可能算错。但如果你在 Prompt 里加一行让我们一步一步来,正确率突然就上去了。
这不是玄学。这是下一篇论文要讲的事。