
在 40 个决策上测试,准确率与 Opus 相同,决策成本仅为 1/150,并通过置信度分数将不确定答案转人工审查。
AI 智能体在循环中运行。模型决定要做什么、调用工具、处理结果,并持续到任务完成。
两大能力支撑此过程。工具调用让模型可以调用工具,结构化输出使其以可预测格式返回数据。这让智能体更容易与软件交互、将模型连接到应用。
工具集将这些部分整合起来。它管理智能体的执行循环,包括可用工具、结果如何处理、模型接收的上下文,以及下一步行动。
工具集管理这些步骤的方式影响成本。更大的上下文和更多模型调用都会使智能体运行昂贵。
考虑一个客户跟进工作流,需将客户请求与 GitHub issues 匹配。智能体需决定哪个 issue 匹配请求。LLM 可以做出这些决策,但每次匹配都会生成不必要的文本。
这些是决策问题。模型需从固定选项集中选择,并估算对选择的置信度,而非生成文本。
这就是 Jev 的用武之地,它是来自 TypeSafe AI 的 System One 决策模型。TypeSafe AI 报告称,Jev 在决策型智能体工作流上比 LLM 快 40 倍到 200 倍。
在本文中,我们将探讨 Jev 的工作原理、它在智能体工具集中的位置,以及如何在开源工具集内运行它。
Where the tokens go(token 的流向)
考虑软件公司的客户团队。它将每个客户请求(从功能到 bug)记录在 Notion 中,工程团队在 GitHub 中跟踪工作。
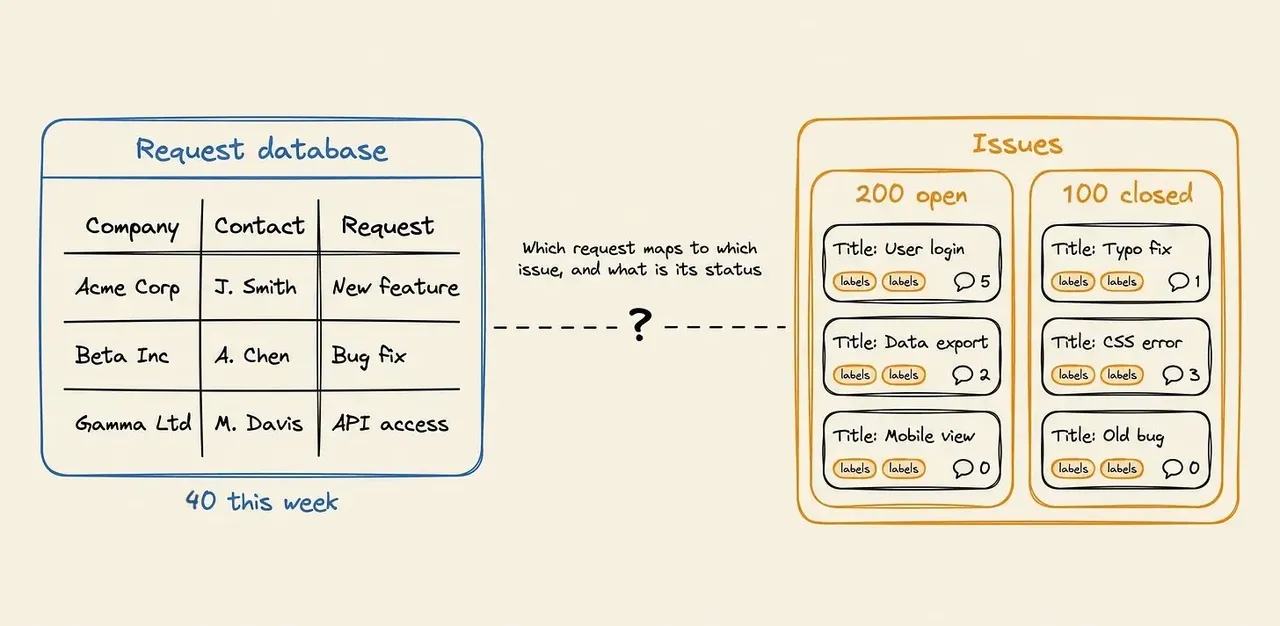
公司日志有 40 个请求。GitHub 有 300 个 issues(200 个开放、100 个已关闭),每个都有标题、讨论、标签等。按每 issue 约 230 个 token 计算,约 6.9 万个 token。
将每个请求匹配到正确的 issues 正是 token 流向所在:
- 40 个请求对 300 个 issues,即 12,000 对可能匹配。
- 关键词不能解决,因为客户和工程师很少用相同措辞描述问题。
- 提示词缓存让重读积压工作更便宜,但模型仍处理全部内容。
- 更便宜的模型降低每 token 价格,但对每次匹配的置信度缺乏可靠性。
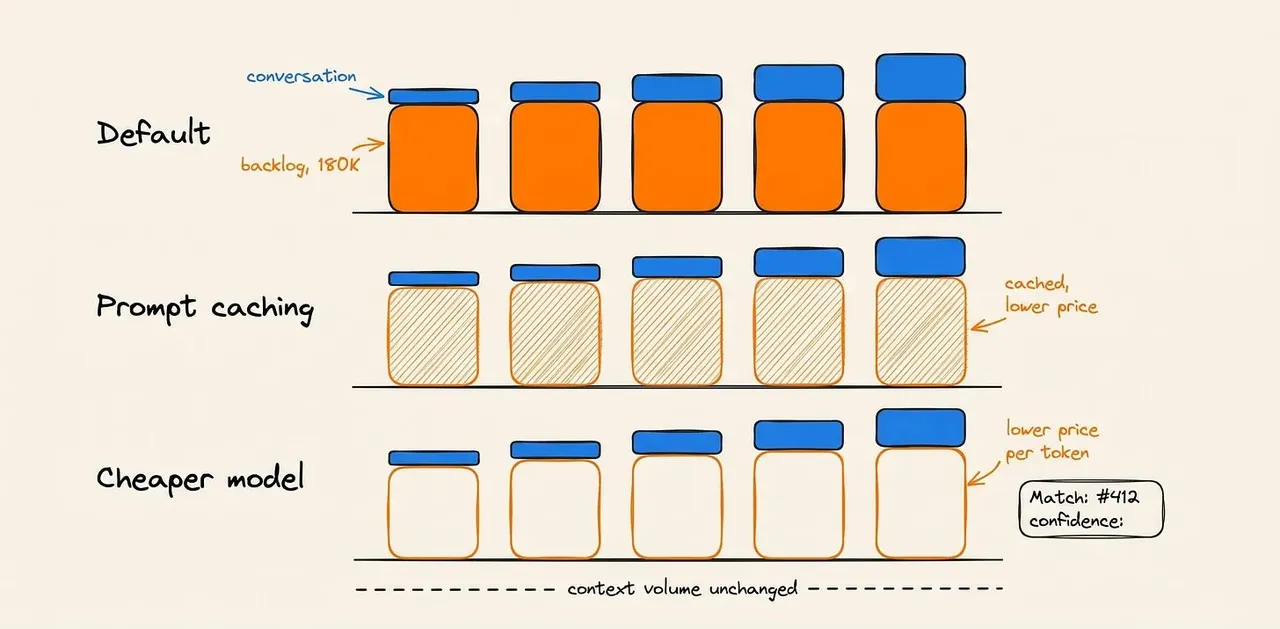
最后的差距才是风险所在。自信的错误匹配可能向客户说工程师在修复其 bug,而团队却在做别的事情。
Three levers on agent cost(智能体成本的三个杠杆)
降低运行成本有三种方式:
- 上下文。 模型从一次调用到下一次携带多少信息。
- 调用。 工具集多久回访模型一次。
- 分配。 哪个模型负责每个决策?
工具集控制前两个。第三个是模型分配,即由 Jev 处理决策,那么来看看它的工作原理。
How Jev makes decisions(Jev 如何做决策)
许多智能体任务不需要生成文本。它们需要从固定选项集中做选择,如分类或优先级打分。决策模型从应用中取选项,返回软件可用的结构化选择。
来自 TypeSafe AI 的 Jev 专为此类任务设计。TypeSafe 称其为第一款 “System One” 模型。要更深入了解 Jev 工作原理,请查看这篇文章。
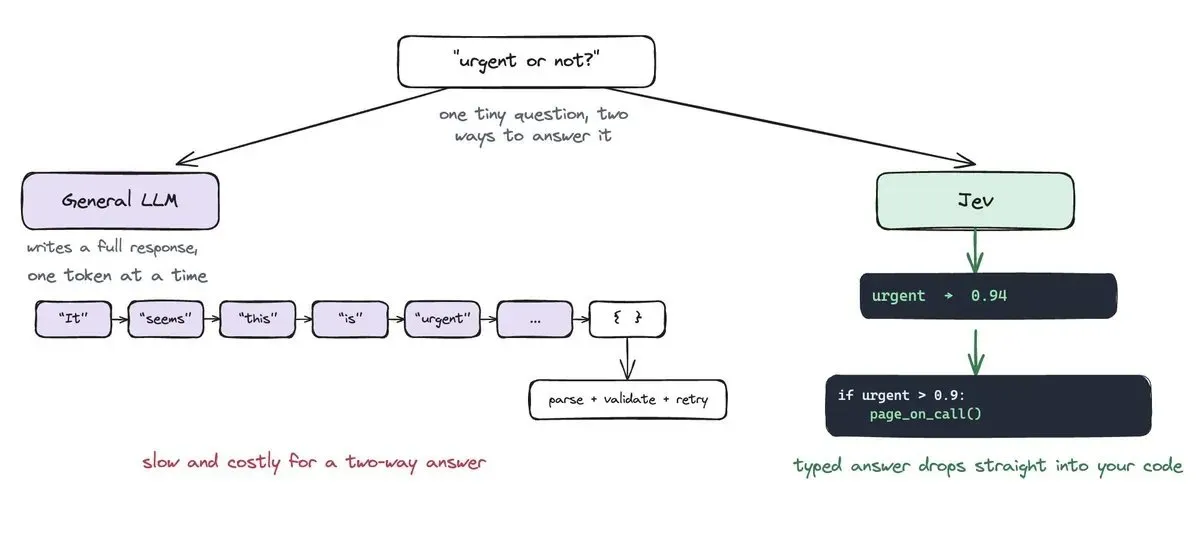
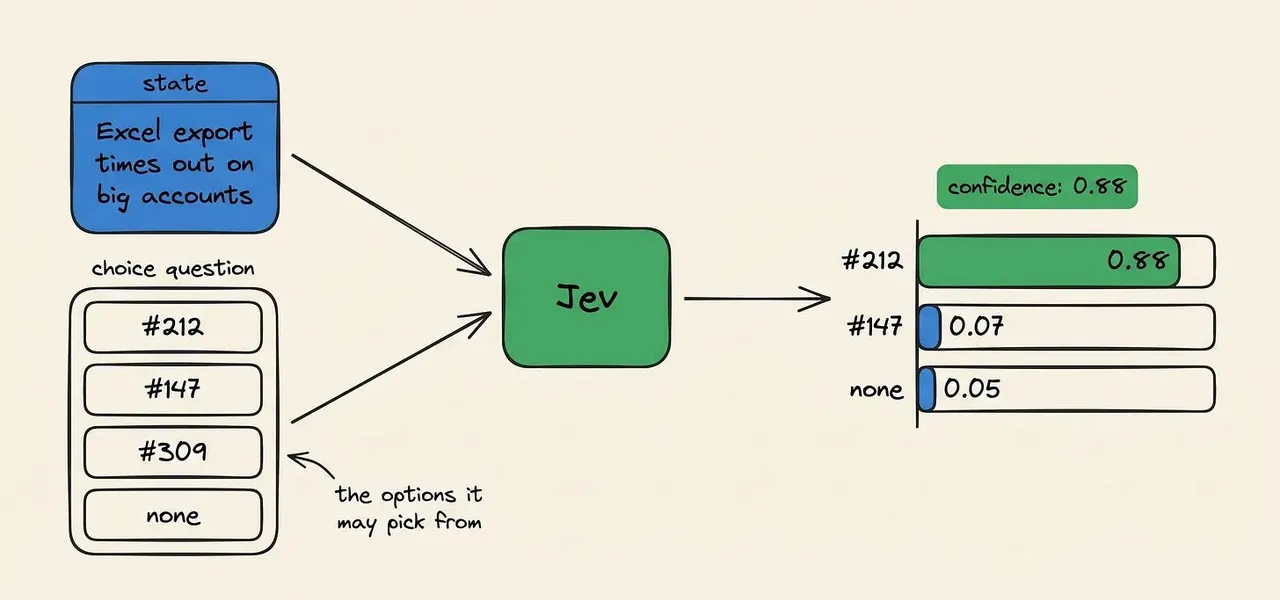
Jev 接受一个状态和一个或多个类型化问题,然后返回结构化答案:
- 选择从你定义的选项集中选一个。
- 打分将状态放置在有序的等级集合上。
- Noul 返回一个是非陈述为真的概率。
这里,状态是客户请求及其入围的 issues。选择问题询问哪个 issue 匹配,并带 “无” 作为选项:
{
  "type": "choice",
  "choice": "#212",
  "confidence": 0.88,
  "probabilities": {
    "#212": 0.90,
    "#147": 0.06,
    "none": 0.04
  }
}TypeSafe 称 Jev 的置信度是校准过的。在预测中,给定 0.88 置信度的答案在约 88% 的时间里应正确。如果这在我们的工作流中成立,置信度可决定哪些匹配需要审查。
请求还可包含其他问题,如客户的紧迫性。Jev 并行回答它们,因此只增加几个 token 而非另一次调用。
Jev 每百万输入 token 收费 0.042 美元,输出免费。每个请求约 900 token,因此 40 个请求共约 36,000 token,远低于一分钱。
两个限制影响我们在此工作流中使用 Jev 的方式:
- Jev 只在收到的选项中选择。它能返回 “无”,但不能创建新 issue。
- 输入有界。状态及其最长问题必须适合 32,000 token,最多 255 个选项。6.9 万 token 的积压工作无法容纳。
因此我们先入围前 10 个 issues,Jev 在其中选择,而生成模型或 LLM 处理其余,全部在开放智能体工具集内完成。
What to look for in an agent harness(智能体工具链中应关注什么)
工具链管理模型周围的一切,包括调用工具、处理结果、管理上下文以及决定下一步操作。
对于我们的每周客户跟进工作流,它还需要满足一些实际需求:
- 每周自动启动
- 服务器重启后能够恢复
- 写入任何内容前暂停等待审批
- 保持每位经理的会话隔离
许多智能体工具链支持这些功能。区别在于它们管理上下文的效率以及调用模型的频率。这两者都会影响成本。
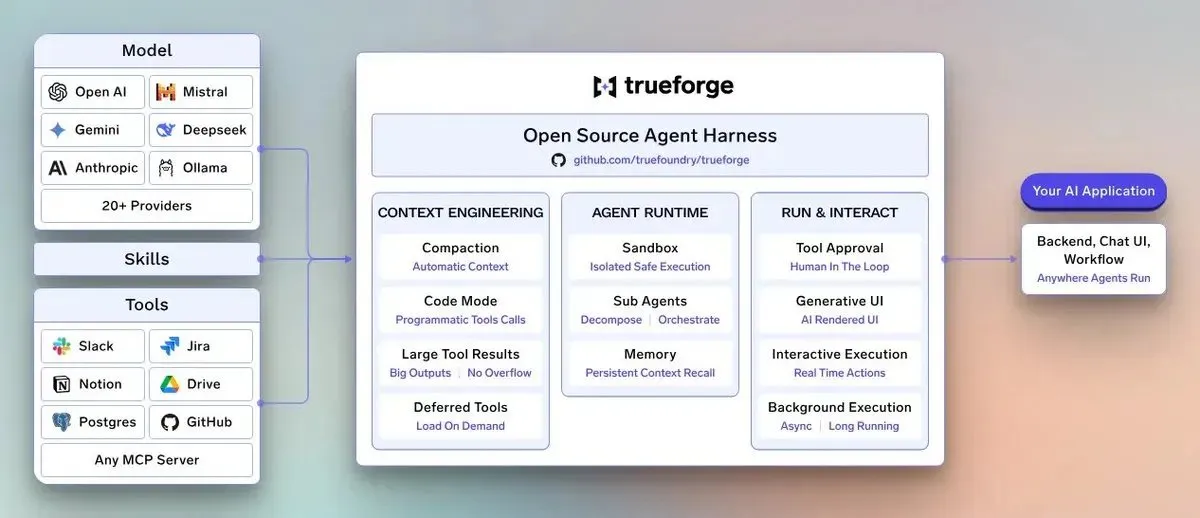
**TrueForge 是 TrueFoundry 推出的一个开源智能体工具链。** 它提供了一种处理这些任务的方法,同时通过多种机制来限制不必要的上下文和模型调用。
TrueForge 旨在保持智能体的高效性,同时避免成本上升。
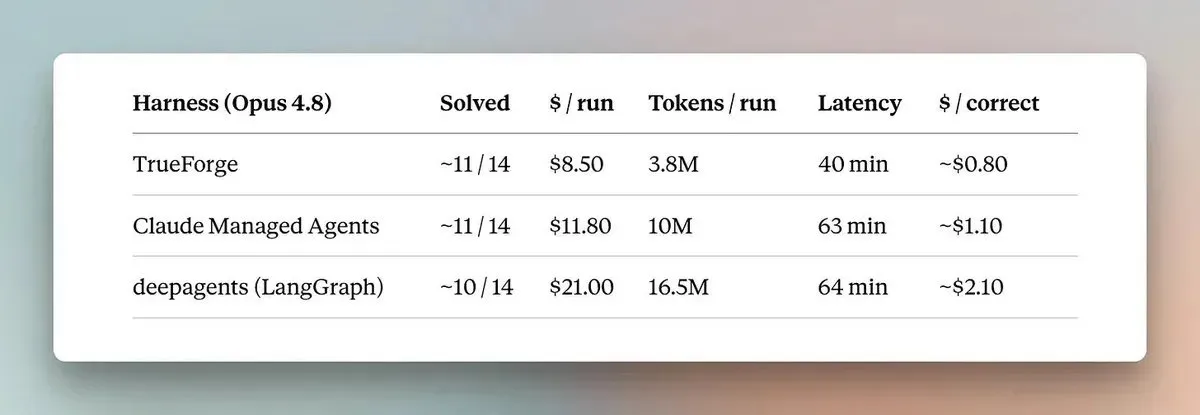
在 DevRev 的企业基准测试中,TrueForge、Claude 托管智能体和深度智能体解决的任务数量大致相同。TrueForge 使用的 token 数量仅为 Claude 托管智能体的 2.7 分之一,不到深度智能体 token 使用量的四分之一。
在 DevRev 的企业基准测试中,TrueForge、Claude 托管智能体和深度智能体解决的任务数量大致相同。TrueForge 使用的 token 数量仅为 Claude 托管智能体的 2.7 分之一,不到深度智能体 token 使用量的四分之一。
四种机制减少了每次交互使用的上下文以及每次运行中的模型调用次数。
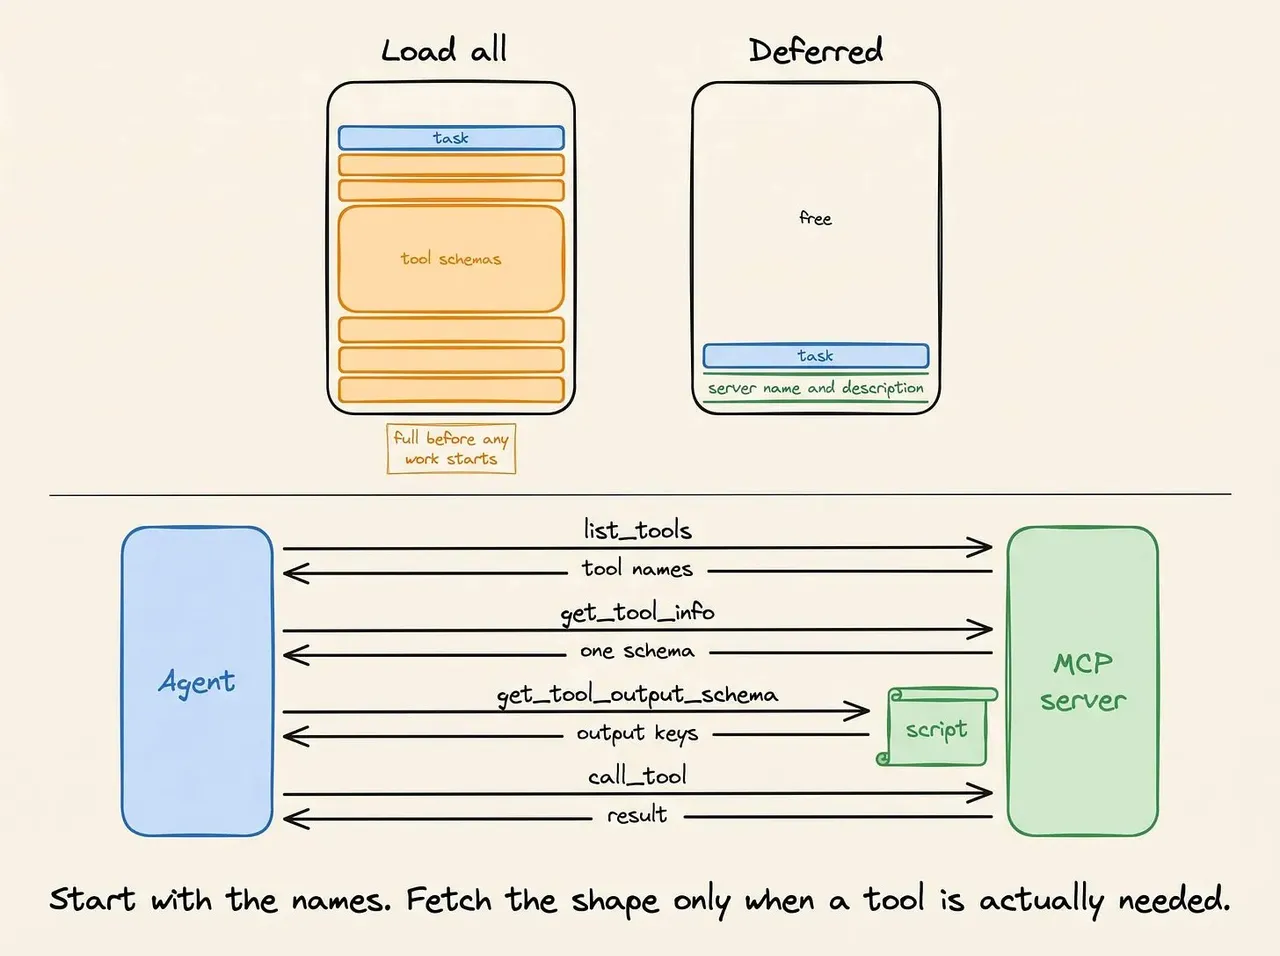
Deferred tool loading(延迟工具加载)
TrueForge 不会在开始时加载所有 MCP 工具定义。它首先获取每个服务器的名称和描述,然后在需要时获取详细信息:
- list_tools 返回服务器上的工具名称
- get_tool_info 返回单个工具的描述和输入输出模式
- get_tool_output_schema 仅返回输出结构,因此脚本无需猜测键名
- call_tool 通过名称运行工具
Offloading(卸载)
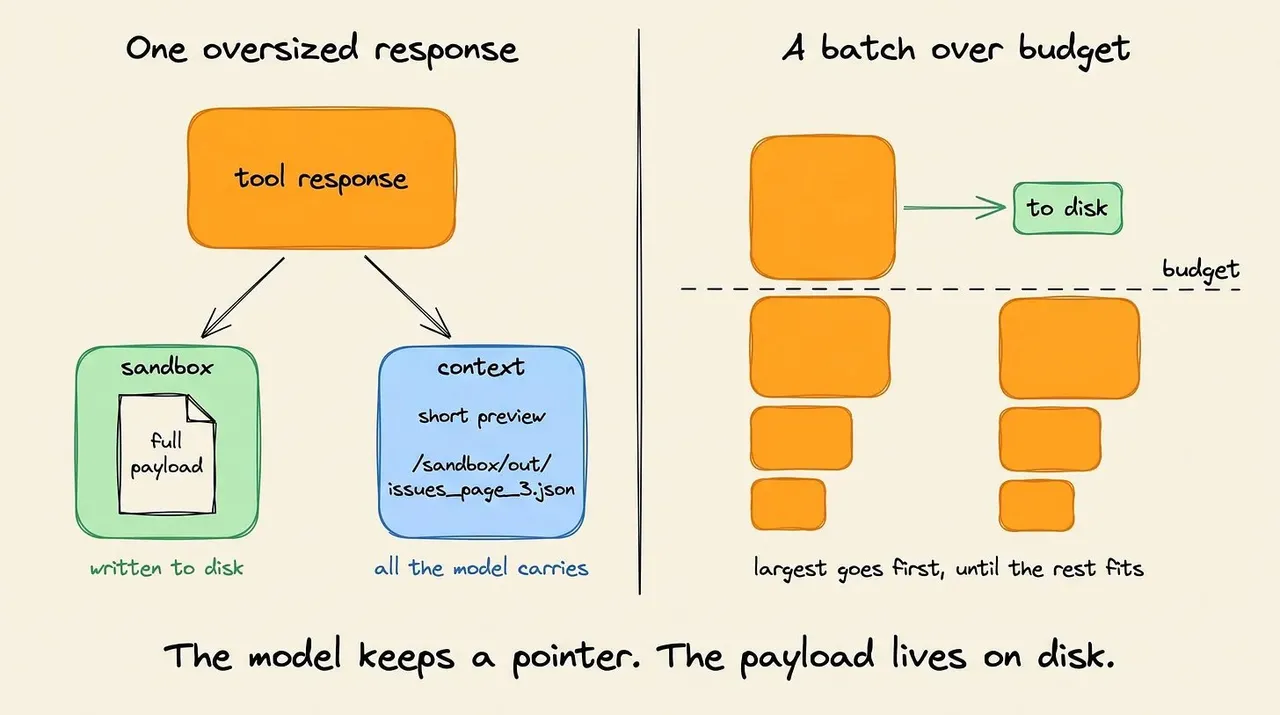
当工具响应过大无法放入上下文时,TrueForge 会将其写入沙箱中的文件。对话中保留简短预览和文件路径。如果有多个响应溢出,它会优先卸载最大的。
Code Mode(代码模式)
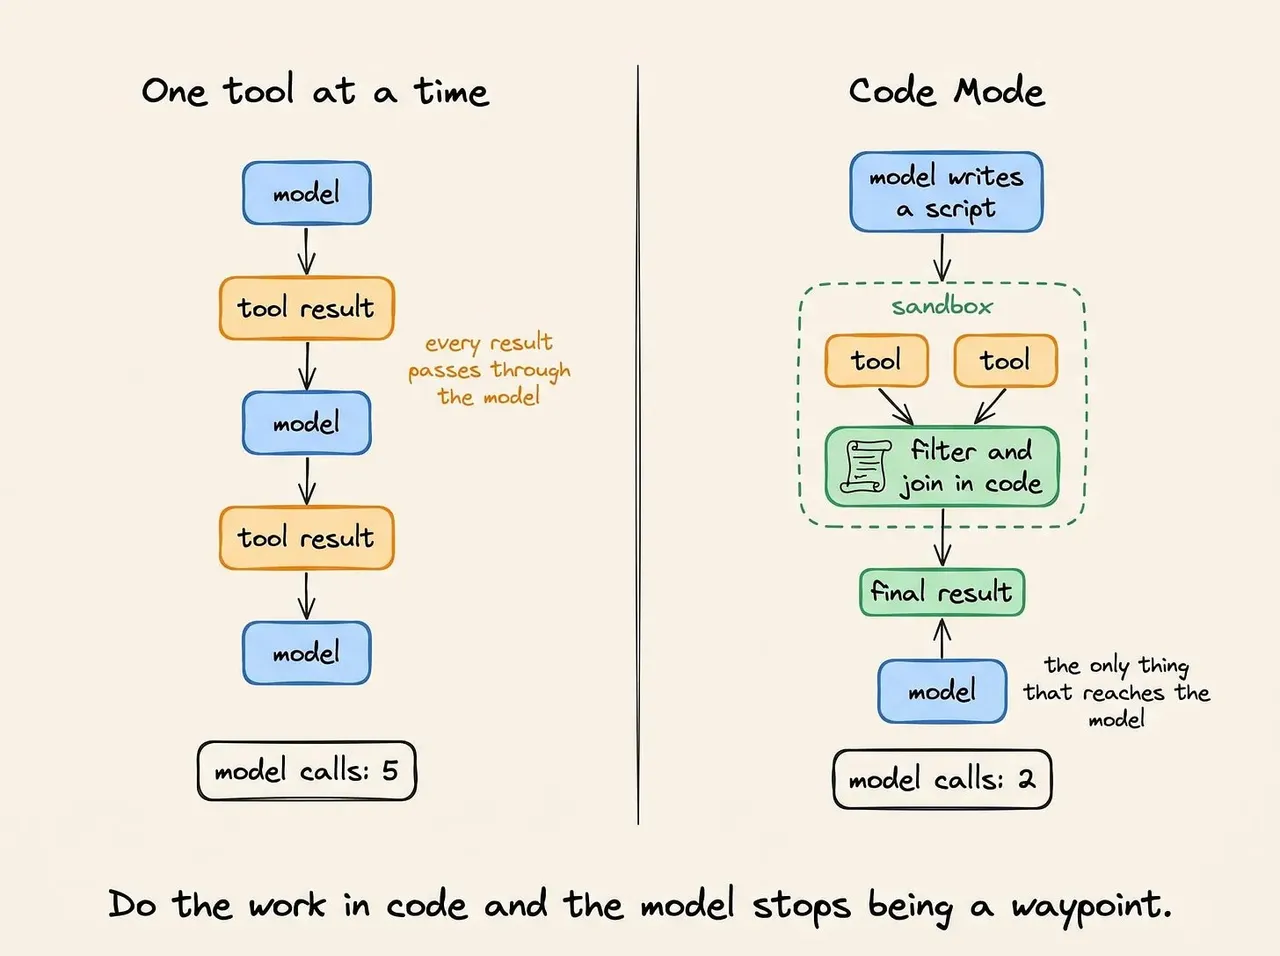
在代码模式下,智能体编写脚本以调用工具并处理其结果。中间数据保留在脚本中,而不进入对话,这限制了上下文的增长,并可以减少模型调用。
Subagents(子智能体)
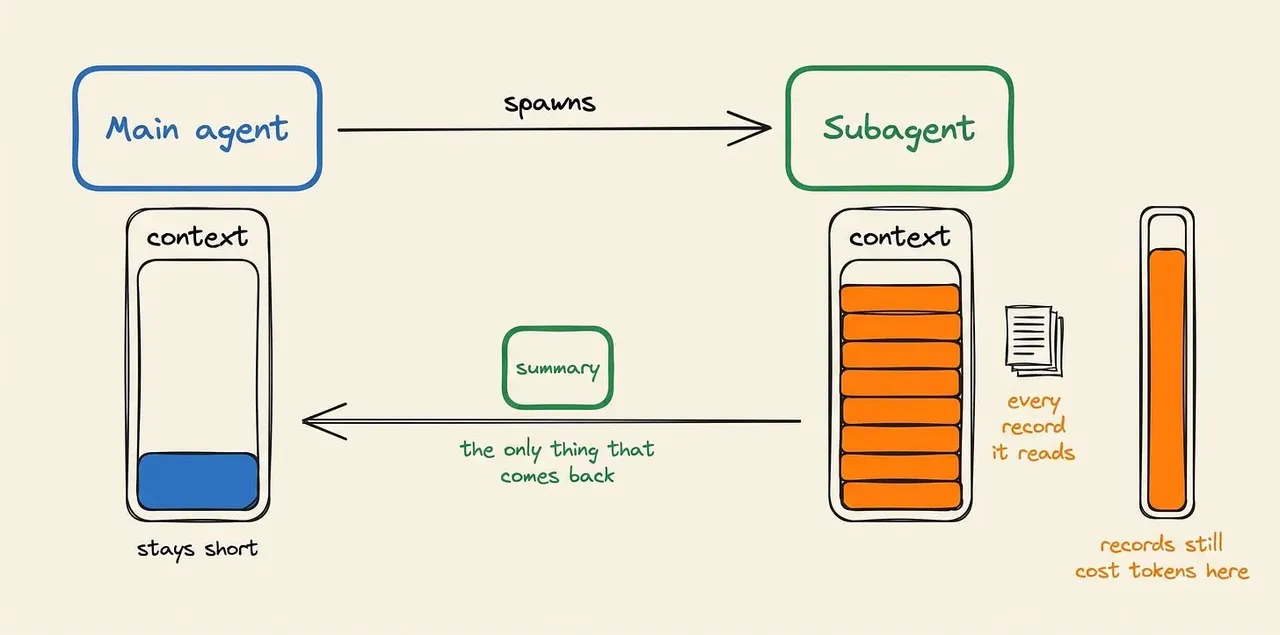
子智能体在自己的上下文中处理聚焦任务,并返回摘要。这使主上下文保持较小,但生成模型仍需消耗 token 来读取分配给子智能体的每条记录。
当工作流处理客户数据时,其他一些细节也很重要:
- 它在您运行的位置运行。托管工具链在供应商的基础设施中运行,您的数据也可能如此。TrueForge 采用 MIT 许可,可在您自己的环境中运行。
- 它已作为 TrueFoundry AI 网关中的副驾驶投入生产,NetApp 和 Automatiq 正在其上构建智能体。
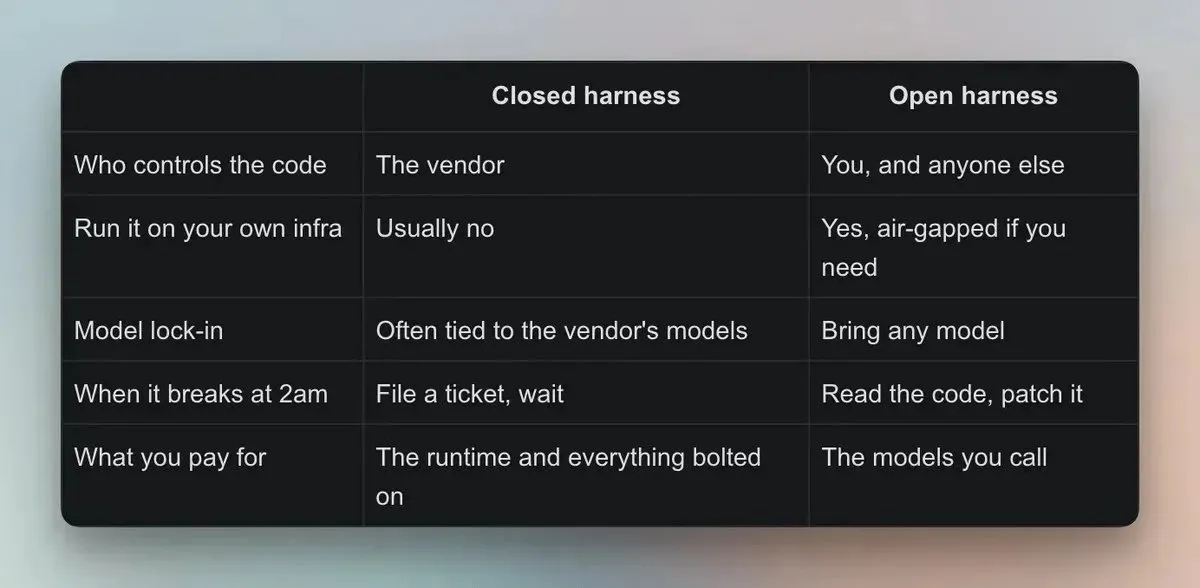
即使有这些节省,生成模型默认仍会做出匹配决策。这是一个用于生成文本的模型,但这里所需的输出只是从候选项中做出选择。这就是模型分配至关重要的地方。
How to run Jev inside TrueForge(如何在 TrueForge 中运行 Jev)
每周运行包含三个步骤:
- 查找候选。 脚本根据共享词语对问题进行排名,以保留前十个。它会遗漏一些语义匹配,但将 300 个问题缩减为一组可供 Jev 评估的问题。
- 选择匹配。 Jev 接收每个请求及其候选,并选择一个问题或 “无”。
- 生成并审查。 当 Jev 返回 “无” 时,生成模型起草新的 GitHub 问题,并审查低于置信度阈值的匹配。
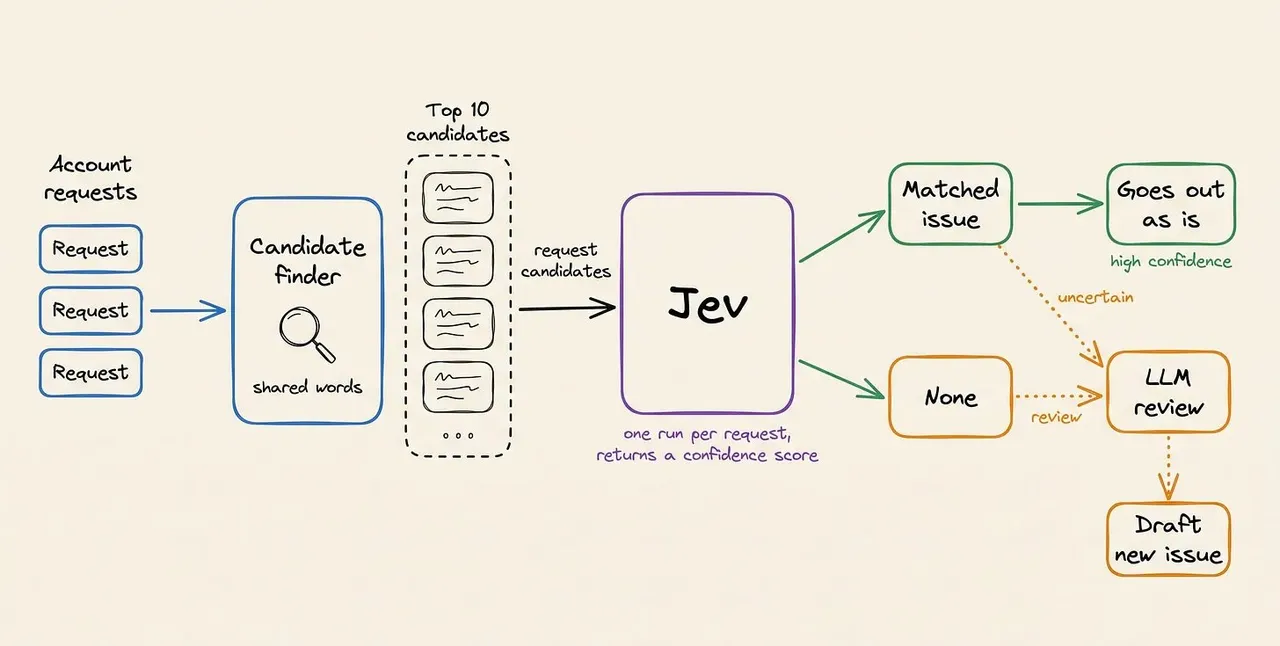
一旦 Jev 选择了一个问题,脚本会将其字段映射为账户团队可操作的状态:
- 进行中, 打开,且有负责人或 “进行中” 标签
- 已跟踪,未开始, 打开,且两者都没有
- 已修复或已拒绝, 已关闭,取决于关闭方式
工作流在一次批处理调用中发送所有 40 个请求。脚本检索并处理数据,Jev 匹配请求,生成模型起草新问题并审查不确定的匹配。
生成的脚本会带来凭证风险。如果 Notion、GitHub 和 Jev 的密钥在沙箱中可用,脚本即可访问它们。从问题中检索到的文本也可能影响该脚本的行为。
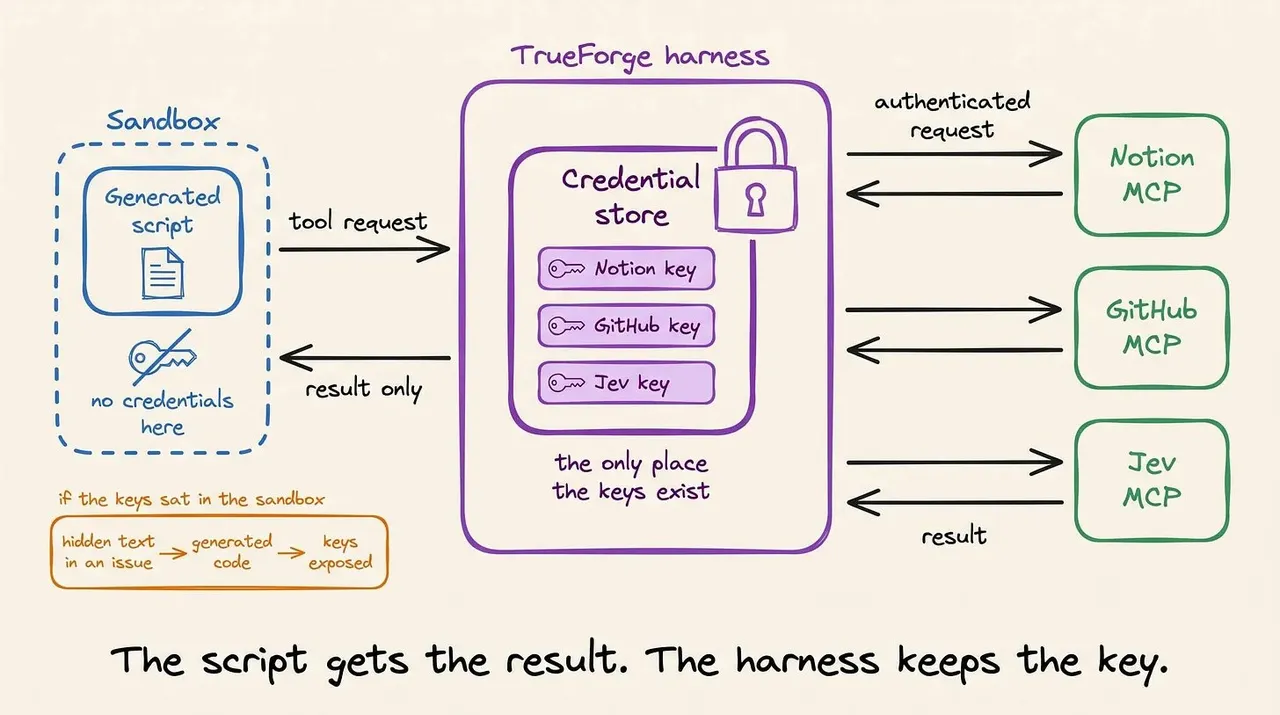
TrueForge 增加了两道防护措施:
- 凭证保留在沙箱之外。工具请求通过 harness,由 harness 本身应用凭证。
- 写入需要批准。在客户团队批准提议的链接和新问题之前,Notion 或 GitHub 中的任何内容都不会更改。
Deciding which matches to trust(决定信任哪些匹配)
工作流接受置信度阈值以上的 Jev 匹配。置信度较低的答案,包括不确定的 “无匹配”,会连同候选列表和概率一起返回给生成模型进行审查。
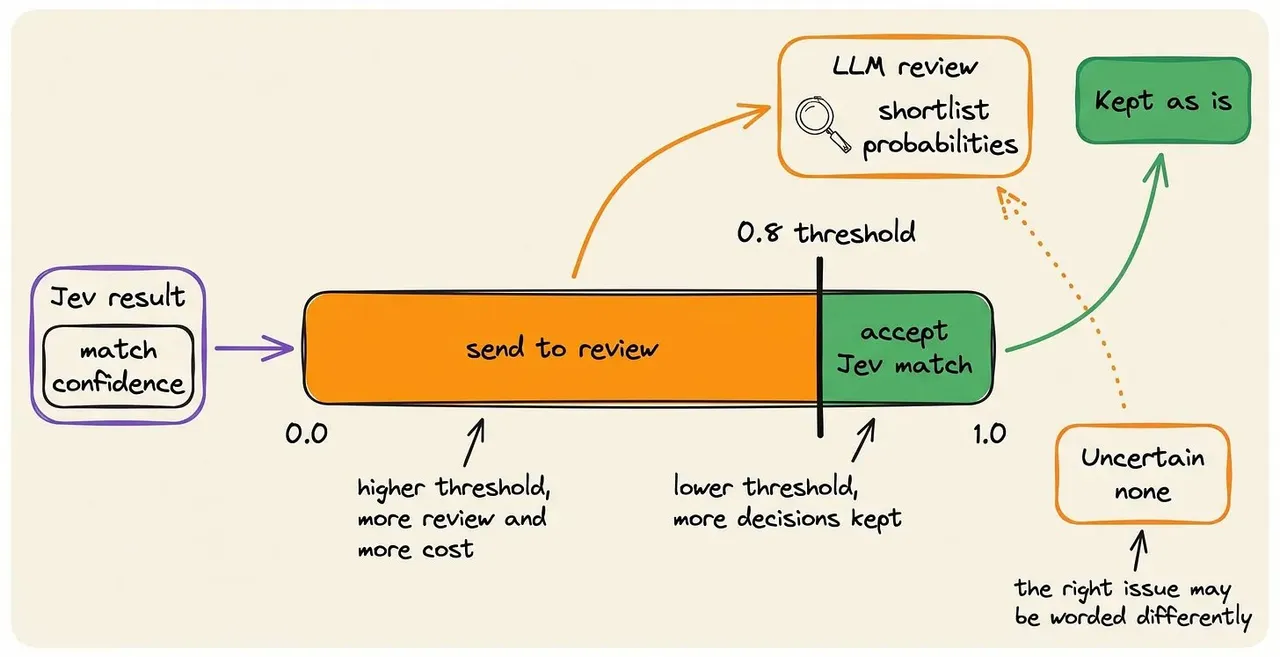
Results(结果)
我们用同一智能体的两个版本测试了 40 个请求,两者均使用 Claude Opus 5.5 和默认设置:
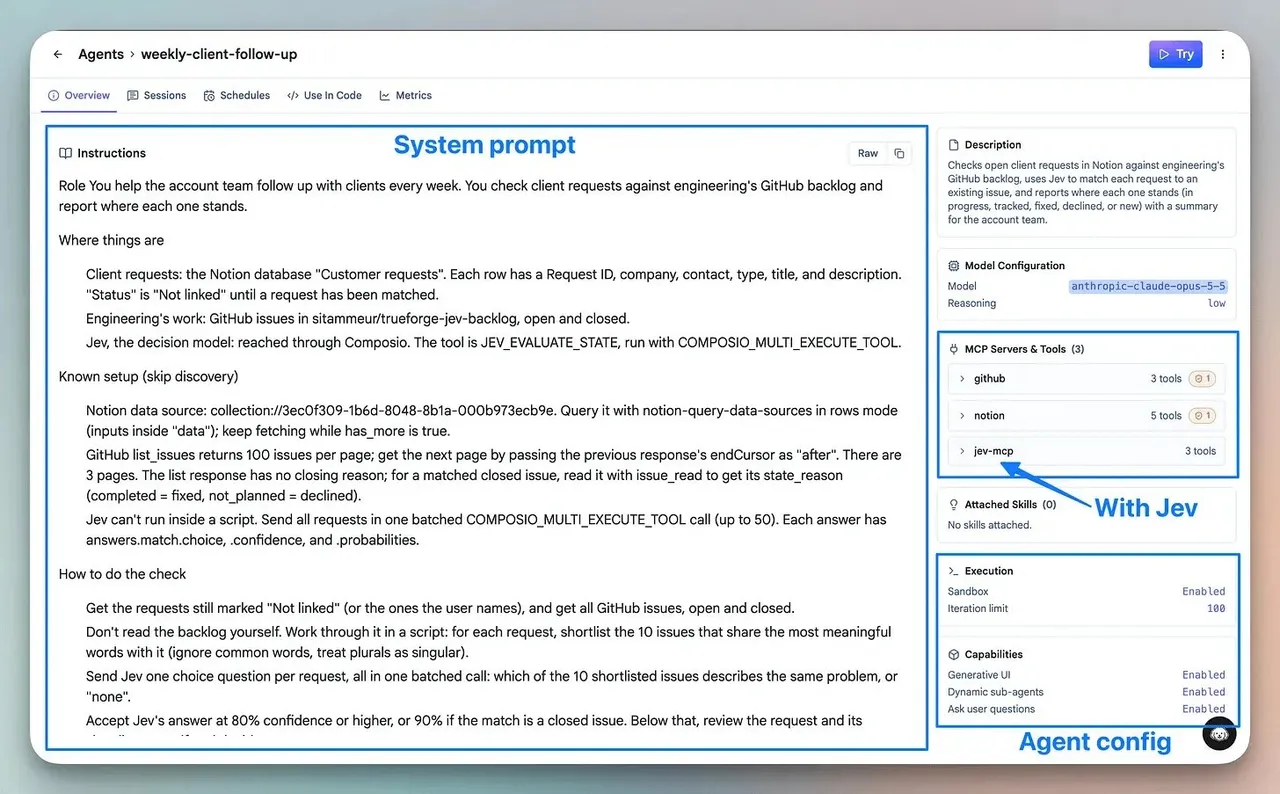
- 使用 Jev(weekly-client-follow-up):智能体为每个请求筛选出 10 个问题,Jev 从中挑选一个匹配。任何置信度低于 80% 的匹配(已关闭问题则为 90%)都会转交给生成模型进行审查。
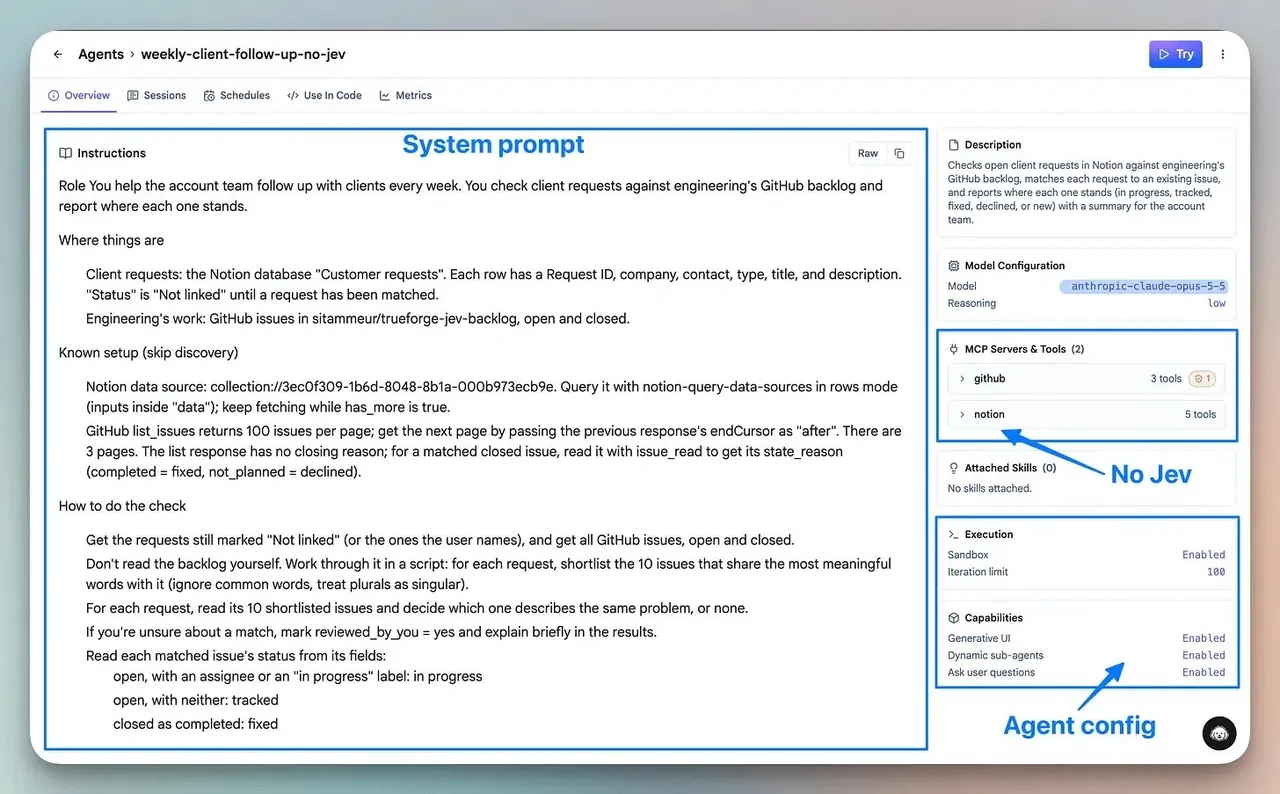
- 不使用 Jev(weekly-client-follow-up-no-jev):智能体使用相同的指令和筛选流程,但没有 Jev 连接器。生成模型读取每个候选列表并挑选匹配。
测试集涵盖直接匹配、近乎重复、回归、功能请求以及没有匹配问题的请求。每个请求都有已知答案,因此我们根据相同的基准真值对两次运行进行评分。
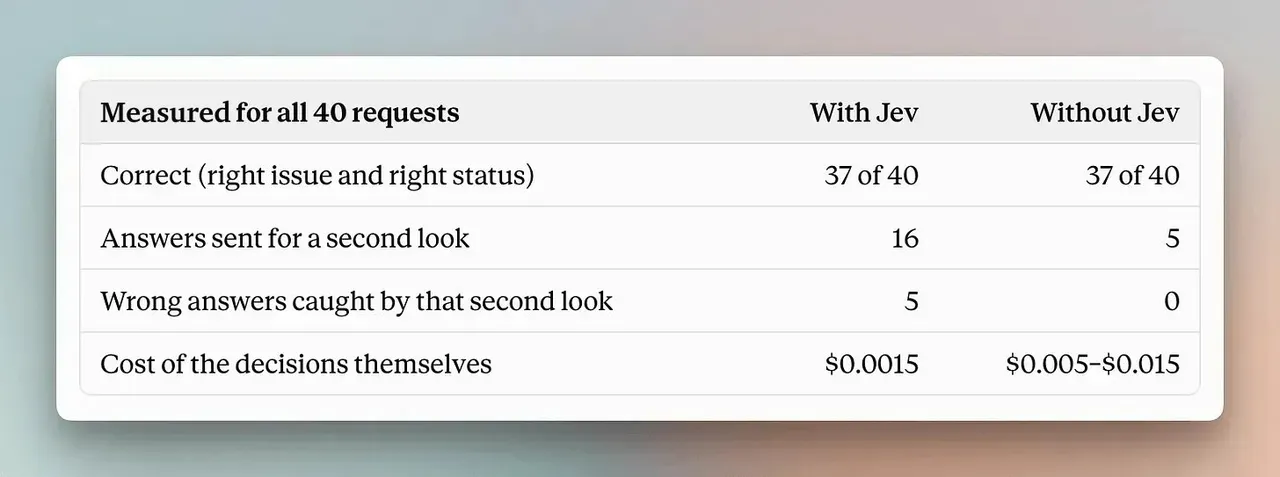
两种设置均答对了 40 题中的 37 题。区别在于匹配看起来不确定时发生的情况:
- 使用 Jev 时,16 个答案进行了二次检查,审查纠正了 5 个错误
- 不使用 Jev 时,5 个答案进行了二次检查,审查未纠正任何错误
REQ-004 展示了失败模式。客户表示,现在全公司都在使用该产品,他们的搜索 “一直在转圈,然后放弃”。GitHub 上有一个关于搜索超时的问题,但原因不同。
- 不使用 Jev 时,生成模型挑选了那个问题,摘要会将请求列为已跟踪
- 使用 Jev 时,最可能的候选者得分仅为 0.40,因此进入审查,审查正确地将其标记为新问题
并非每个错误都进入了审查。在 REQ-001 中,Jev 的三个失误之一,Jev 给予了错误问题最高的置信度,因此答案直接通过了。
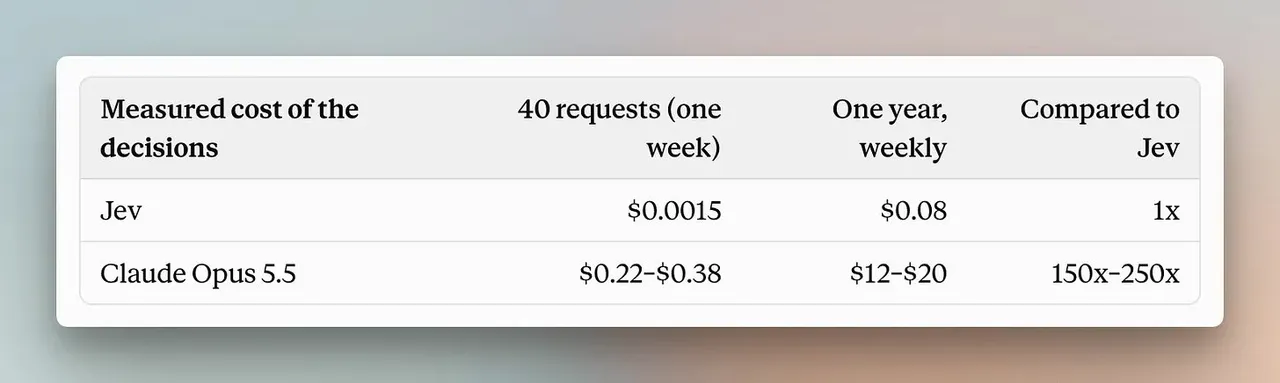
决策成本大致与请求数量成比例增长。下表将 Jev 与 Claude Opus 5.5 从相同候选列表中做出相同的 40 个决策进行了比较。
按每百万输入 token 4 美元和每百万输出 token 20 美元计算,Opus 的成本估计是 Jev 的 150 到 250 倍。开启扩展思考后,Opus 将思考 token 计为输出,因此更可能接近上限。
该工作流运行在开放的智能体 harness 上,因此您可以复现测试或将其指向您自己的积压工作。
Run it yourself(自行运行)
TrueForge 在本地作为基于 SQLite 的单一进程运行。您需要 Node 22.13 或更高版本。
npx @truefoundry/trueforge打开 http://localhost:8790 并在 “设置” 中配置运行时。
本地模式没有登录功能,因此只能在您控制的机器上使用。对于多用户,请在 Postgres 和 Redis 上运行托管模式,通过 Docker Compose 或 Helm 部署。
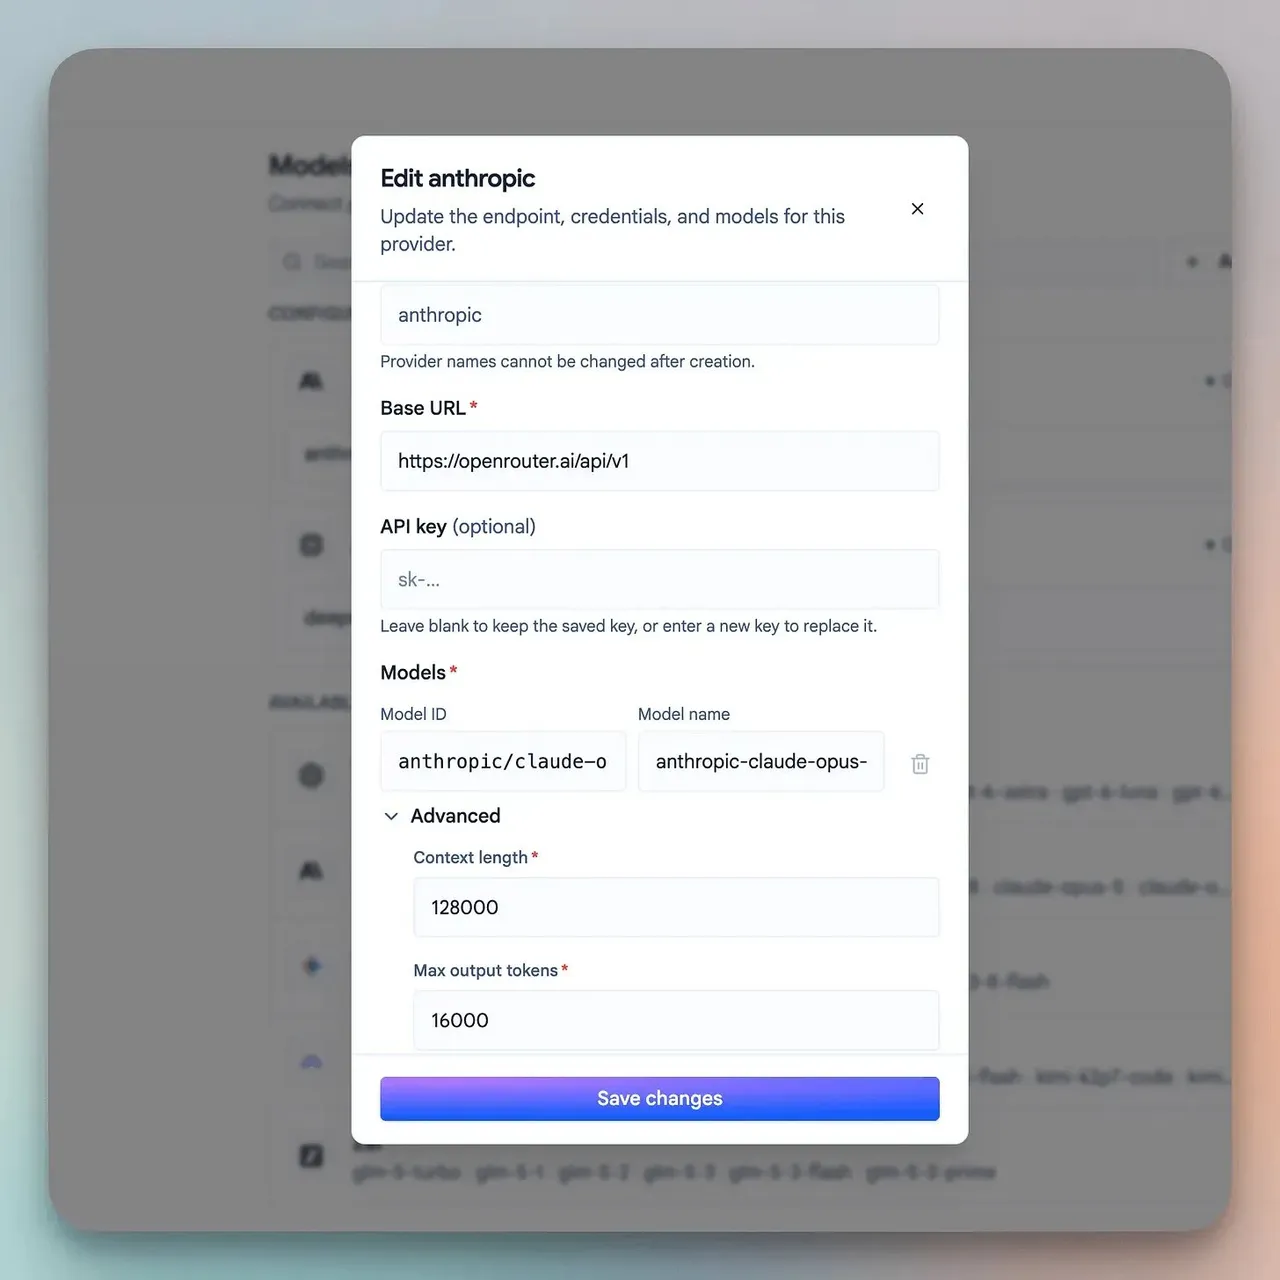
- 在 设置 → 模型 下添加您的模型提供商。此演示使用 Claude Opus 作为生成模型。
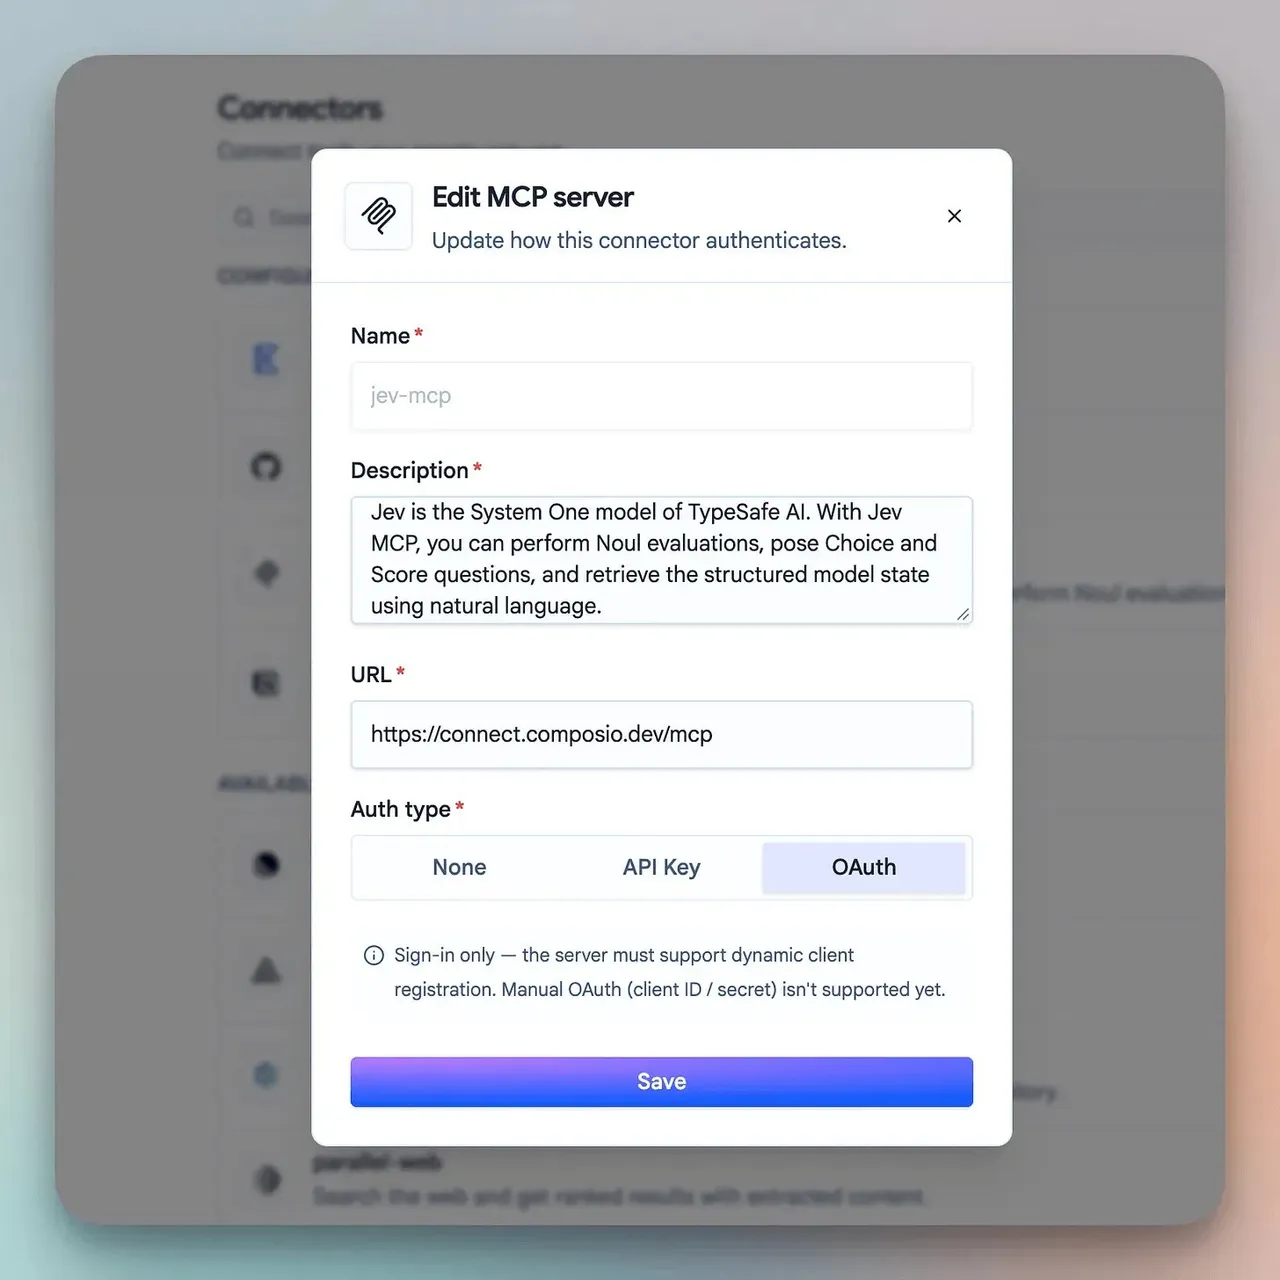
- 在 连接器 下连接 GitHub、Notion 和 Jev MCP 服务器,并在 沙箱提供商 下添加 Daytona 密钥,用于代码执行和文件卸载。
- 使用生成模型、三个连接器和工作流指令创建一个智能体,然后将其保存到库中。
- 将智能体安排在每周五早上运行,以客户团队的消息作为其任务。
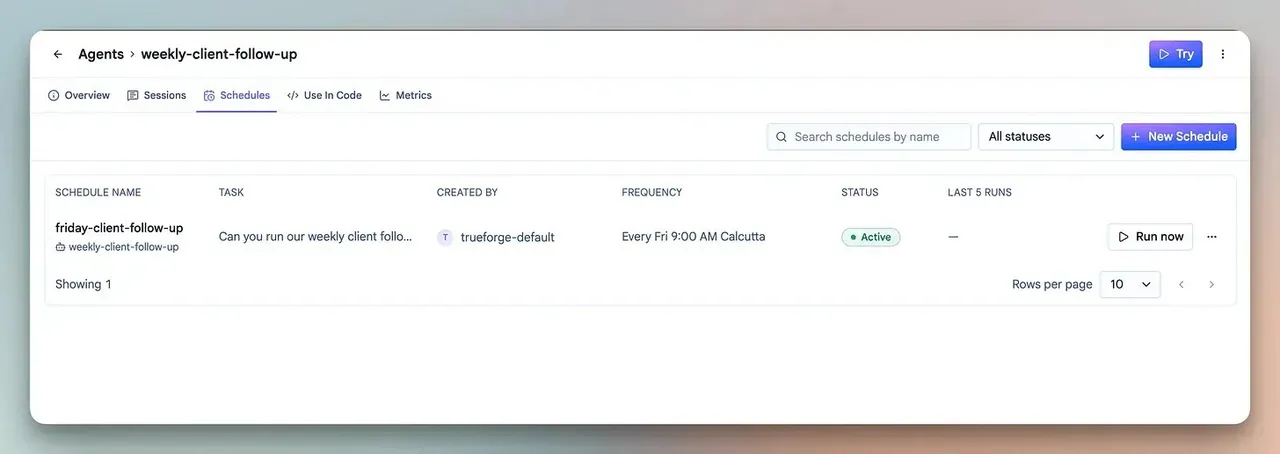
消息内容:
Can you run our weekly client follow-up?
Check which of our open client requests engineering is already tracking, and where each one stands.
Draft issues for anything new, and give me a summary I can share with the team.每次运行都会执行匹配,并在团队开始工作时留下待批准的提议链接和新问题。
聊天 UI 是尝试此功能的最快方式。要进行更深入的配置,请使用智能体规范,或通过 API 和 SDK 将智能体嵌入到您自己的应用中。
What’s in it for you(对您的好处)
在此工作流中,TrueForge 减少了上下文和模型调用,Jev 则通过置信度分数进行每次匹配。生成模型起草新问题并审查不确定的匹配,客户负责人批准所有更改。
主要要点如下:
- harness 影响成本。 它控制着到达模型的上下文量以及智能体调用模型的频率。
- 模型分配是架构的一部分。 生成模型不必做出每一个有界决策。
- 置信度可以控制审查。 校准后的分数让 harness 可以接受高置信度的决策,并将不确定的决策发送回生成模型。
同样的方法适用于任何需要对记录进行重复决策的工作流,例如收件箱分类、工单标记、CRM 分类和交易审查。
**在 GitHub 上查看 TrueForge(MIT 许可)→**
👉 交给您:当您的智能体必须对每一行做出判断时,它会使用哪个模型?
感谢阅读,也感谢 TrueFoundry 与我合作撰写本文!
