
2023 年,Karpathy 解释了为什么本地 LLM 运行缓慢。当模型在你自己的电脑上生成一段文本时,芯片的大部分时间都在等待权重从内存中到达,而计算单元则处于闲置状态。
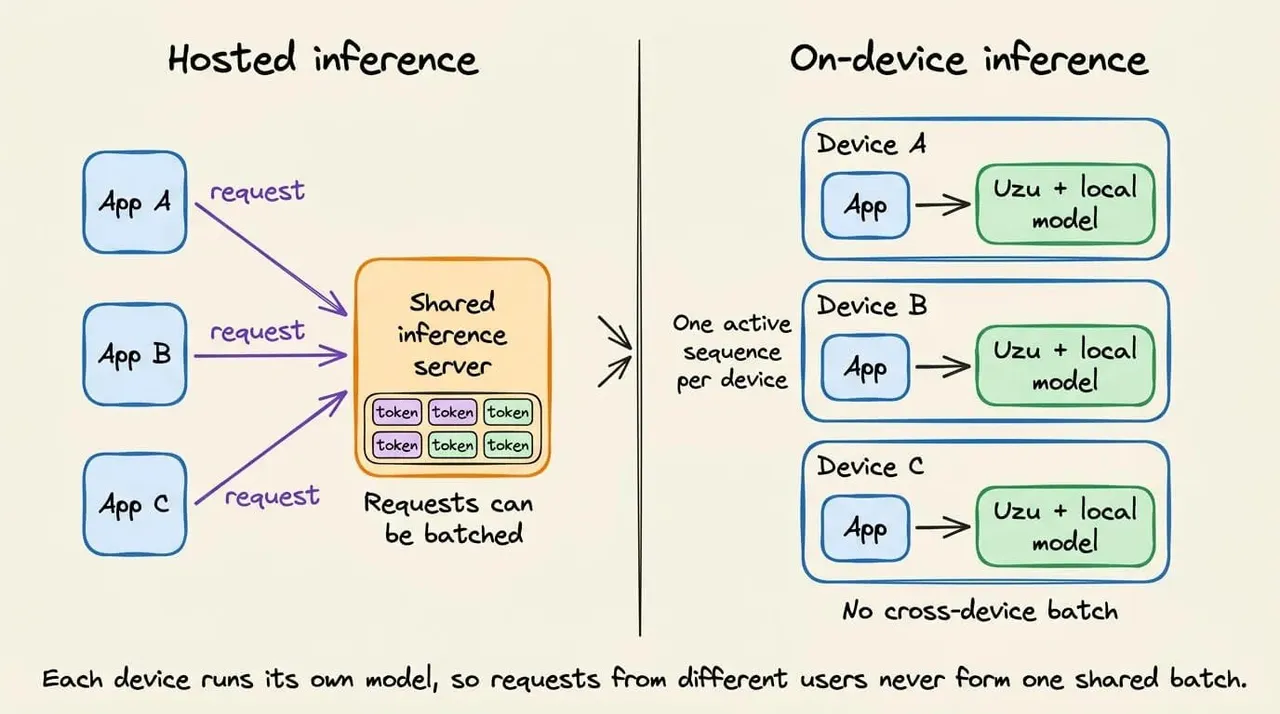
几周后,他描述了绕过这一问题的方法。一次遍历中检查多个 token 的成本与检查一个 token 大致相同,因此一个小的草稿模型可以提前猜测,主模型可以一起验证这些猜测。
第一个观点至今仍设定着天花板。基础版 Apple M5 芯片每秒移动 153 GB 数据,而 4 位 Qwen3.5 9B 模型大约重 5.2 GB,因此在每次遍历生成一个 token 的情况下,该芯片最高可达每秒约 29 个 token。
llama.cpp 和 MLX 都正好落在这条线之下,在同一个编程提示词上分别达到每秒 22 和 25 个 token。
第二个观点才是发挥空间所在,但像 llama.cpp 的 MTP 模式这样的本地方案每次只能草拟三到四个 token。
来自 Mirai 的开源推理引擎 Uzu 在 Apple Silicon 上把这种方法推得更远。它最多提前草拟 16 个 token,保持这些猜测彼此连贯,并在为 M5 编写的内核上一次遍历中验证它们。
在同一台 M5、同一模型和同一提示词下,Uzu 写入了每秒 92 到 117 个 token。
让我们来梳理一下天花板的来源、Uzu 如何突破它,然后用一个可以指向你自己提示词的基准客户端,将其与 llama.cpp 和 MLX 进行对比测试。
Why batch-one decoding is memory-bound(为什么批大小为 1 的解码受内存限制)
LLM 推理有两个不同的阶段。
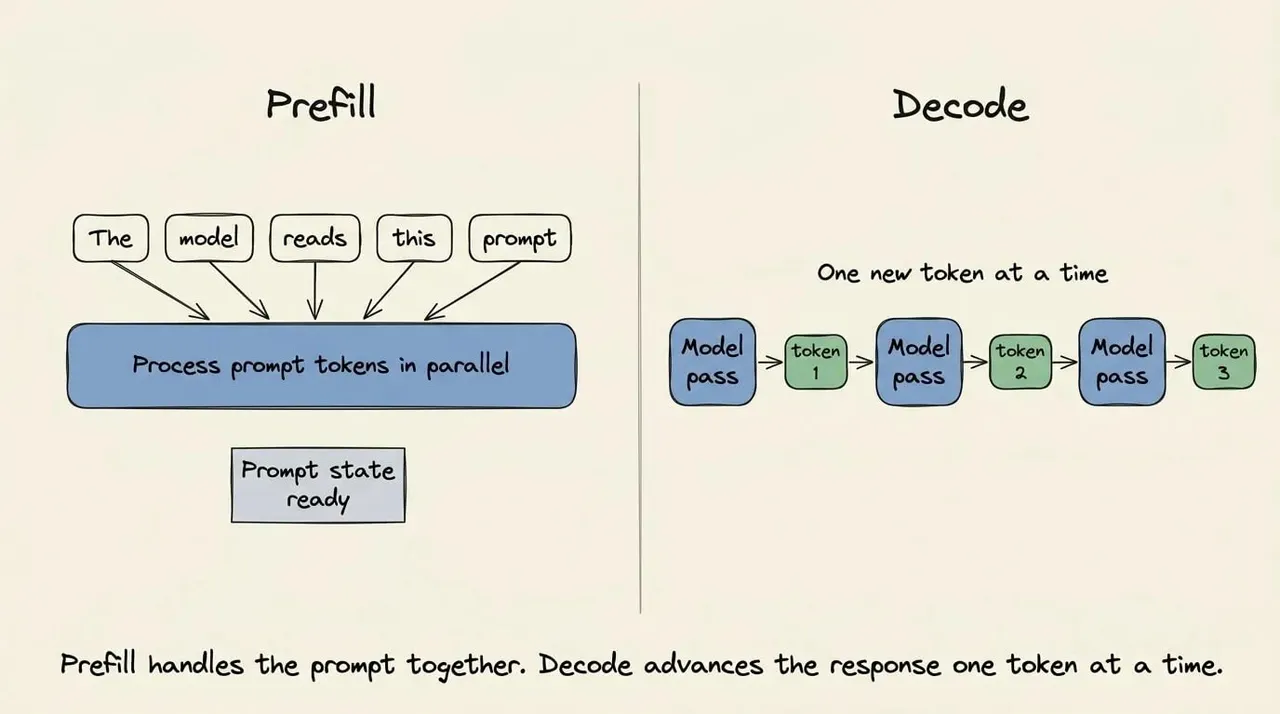
- 预填充阶段并行处理提示词 token。
- 解码阶段逐个生成响应 token。
解码是相关的阶段,每个新 token 都需要一次额外的模型遍历。在遍历期间,运行时读取权重块并计算下一个 token 的分数。
在批大小为 1 时,一次前向传播只推进一个序列。
相对于移动的权重数据量,整体运算量很小。为了产生一个 token,芯片将模型的每个权重从内存一次性流式加载到 GPU 中,并对每个权重做大约一次乘加运算。
GPU 可以在内存带来下一个权重块之前完成这些计算。因此计算速度往往受限于内存带宽。
这就给出了一个硬性上限。基础版 M5 每秒从内存移动 153 GB 数据。4 位 Qwen3.5 9B 检查点大约重 5.2 GB。如果每次遍历产生一个 token,那么该芯片上模型每秒最多只能写出 153 ÷ 5.2 ≈ 29 个 token,无论 GPU 计算多快。
实际引擎的表现略低于这个上限,因为每次遍历还会读取其他数据,例如早期 token 的缓存。
量化是改进这一点的标准技术,通过使用更小的权重来减少每次遍历读取的字节数。
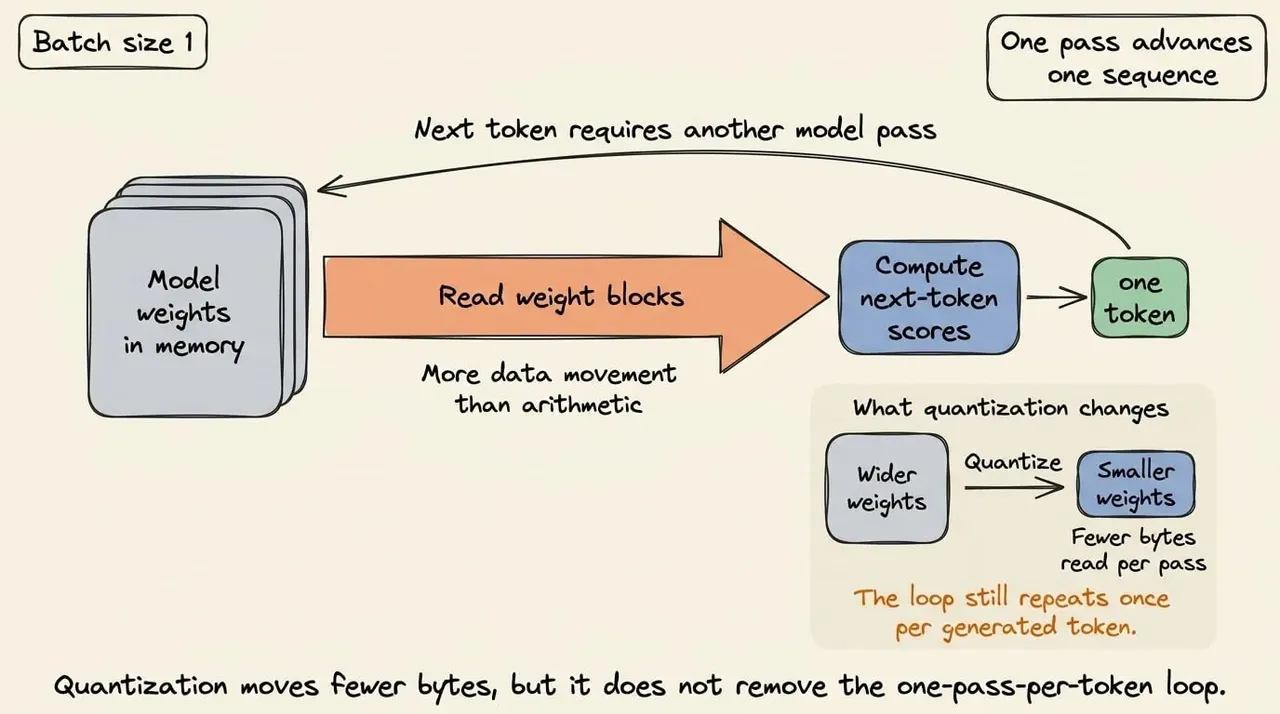
然而,量化仍然优化的是同一个单 token 循环。主模型必须为每个生成的 token 再次运行。
事实上,量化已经相当普遍,所以现在让我们来理解是什么让 Uzu 作为推理引擎与众不同。
How Uzu optimizes bytes and tokens per pass(Uzu 如何优化每次遍历的字节数和 token 数)
Uzu 针对解码循环中的两个量进行优化。它减少每次遍历传输的字节数,并增加每次遍历被接受的 token 数。
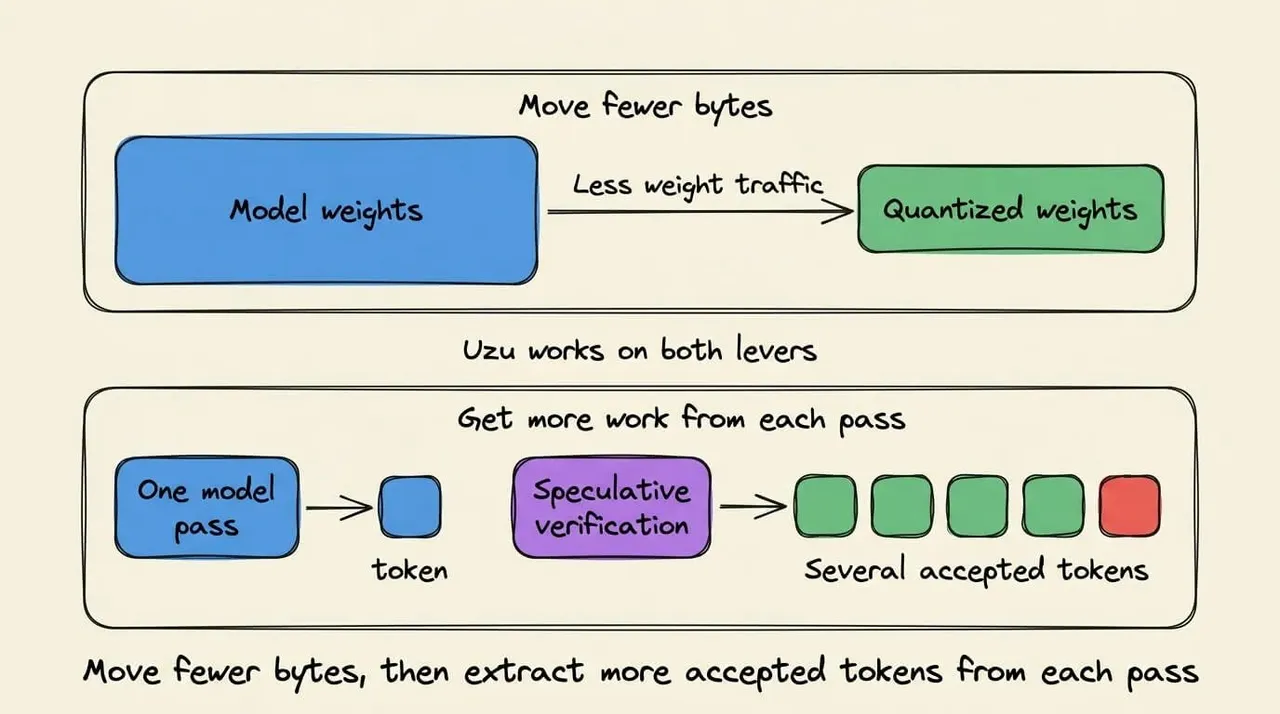
- 量化处理第一个量。它以更少的位存储模型权重。更小的检查点需要更少的内存流量,并为上下文和应用程序状态留出更多统一内存。
- 投机解码处理第二个量。它一起验证多个候选 token。如果多个候选被批准,序列就会前进多个 token。
许多本地引擎已经支持 4 位权重。Uzu 的区别在于围绕该格式的硬件路径。
Mirai 为同一个基础模型发布了多个优化的检查点。它按大小层级标记它们。M 表示 Medium(中等),而 L 表示 Large(大型)。
这些标签描述的是检查点,而不是不同的模型架构。
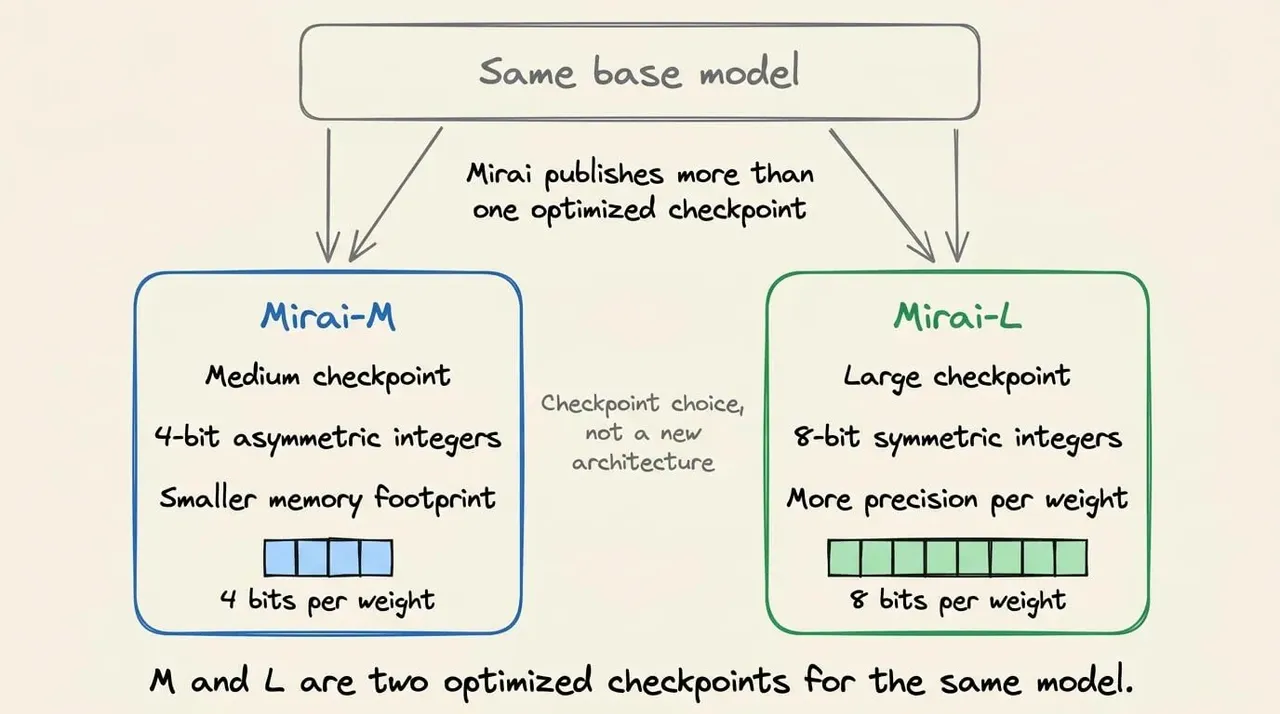
- Medium 检查点使用 4 位非对称整数量化。
- Large 检查点使用 8 位对称量化。
Medium 偏向更小的内存占用,而 Large 为每个权重保留更多位。Mirai 的 **量化详解** 描述了它如何将训练后量化与量化感知蒸馏结合起来。
使用整数格式是刻意为之,因为它同时有利于硬件和压缩。
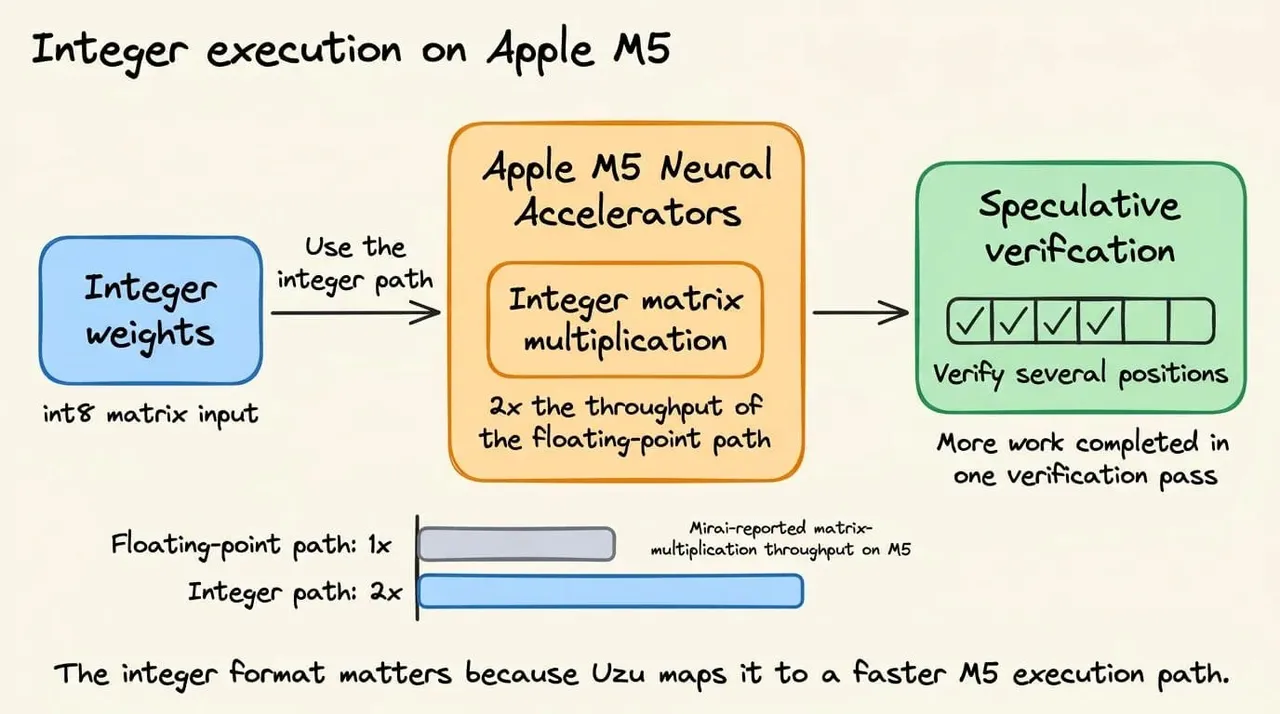
更具体地说,与旧款 Apple GPU 不同,M5 在 int8 下达到最高的算术吞吐量。
因此 Uzu 也实时将激活值(层之间传递的中间值)量化为 8 位。当每次矩阵乘法的两侧都以整数存储时,投机验证步骤就在 M5 的硬件加速 int8 矩阵路径上运行。
更低的精度带来了另一个问题。
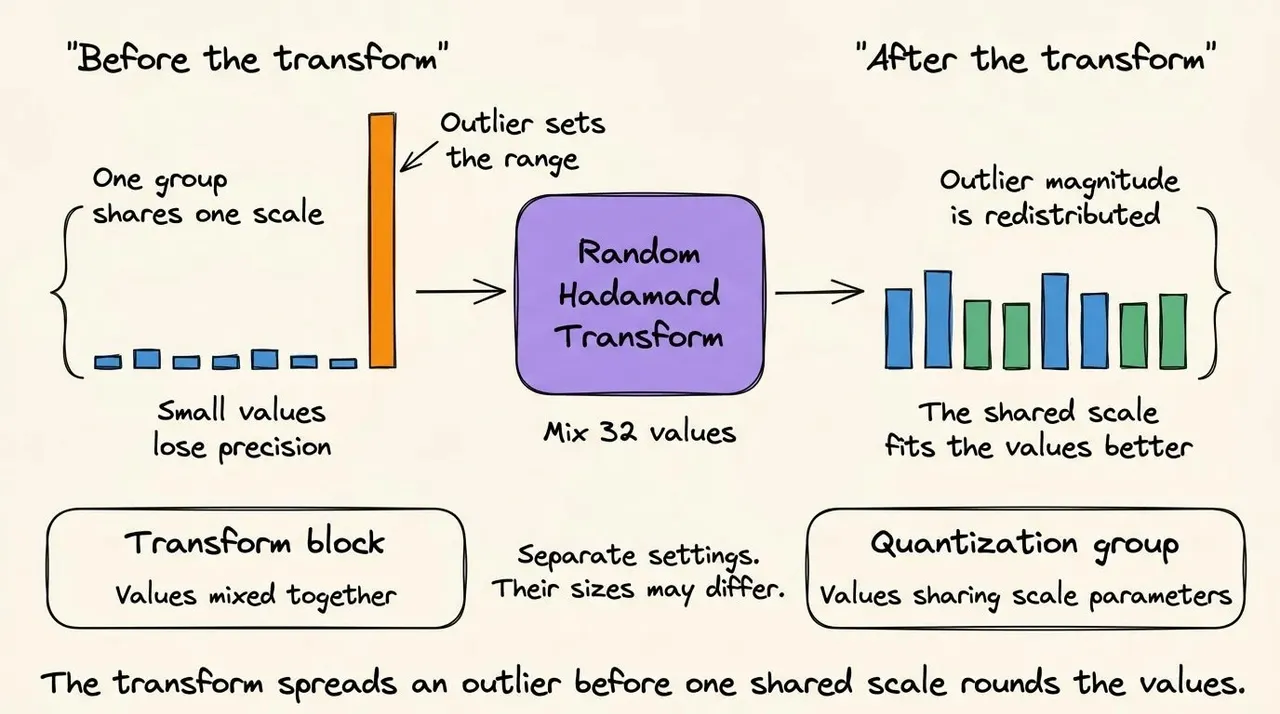
更具体地说,分组量化在一个组包含异常值时会产生舍入误差。
组内每个值共享一个缩放因子。该缩放因子必须表示最大幅值。较小的值于是使用更少的整数级别,并产生更多的舍入误差。
Uzu 在量化之前应用块对角随机 Hadamard 变换。Hadamard 矩阵只包含 +1 和 -1 条目,外加一个整体缩放因子。
将权重块乘以它会将每个值混合到每个位置,因此一个大的异常值会变成许多中等大小的值。
“随机” 指的是在混合之前应用的随机符号翻转,“块对角” 则意味着每 32 个值的块独立进行混合。该变换完全可逆,因此除了舍入误差外,它不会改变模型的计算结果。
Mirai 选择了 32 个元素以匹配 Apple GPU 内核的 SIMD 宽度。SIMD 意味着一条指令同时运行在 32 个 GPU 线程上,因此一组线程可以变换一个块。
变换块和量化组控制着不同的操作。
- 变换块定义了 Hadamard 矩阵混合哪些值。
- 量化组定义了哪些值共享量化参数。
这些大小不需要匹配。
Uzu 的差异化在于对数值格式、变换和运行时内核的联合设计。量化减少了每次模型传递中的内存流量和计算量。
然而,普通的解码每次目标模型传递仍然只返回一个 token。投机解码是它用来改善这一瓶颈的下一个杠杆。
Producing several tokens from one model pass(从一次模型传递生成多个 token)
投机解码在主模型旁边增加了一个小型草稿模型。
草稿(小型)模型以低成本提出未来的 token。主模型同时检查这些位置。它接受有效的前缀,并从第一个被拒绝的 token 处继续。
假设草稿模型提出五个 token,主模型同意前四个。那么这一次验证传递就使序列推进了五个 token——四个被接受的草稿加上主模型在第五个位置自身的 token。
普通解码生成相同文本需要五次独立的主模型传递。
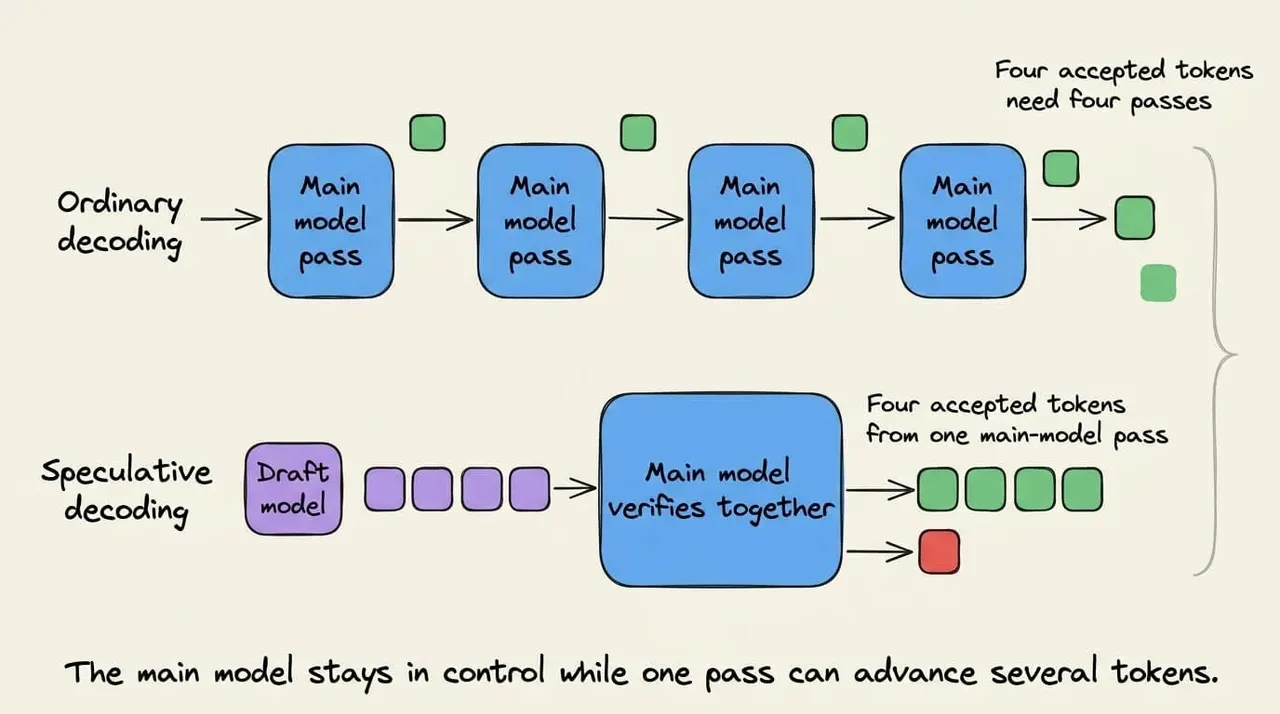
主模型仍然控制最终输出。草稿模型只提出可以并行检查的 token。正确的接受过程保留了目标模型的输出分布。
验证步骤比单 token 解码需要更多的计算。
但这条路仍然更受青睐,因为本地批量为一的推理在权重通过内存移动时,往往有闲置的算术容量。
投机解码利用这些闲置的算术能力来减少主模型传递的次数。
这种权衡取决于接受率。更长的草稿产生更大的验证批次,也带来更多早期错误使后续 token 失效的机会。
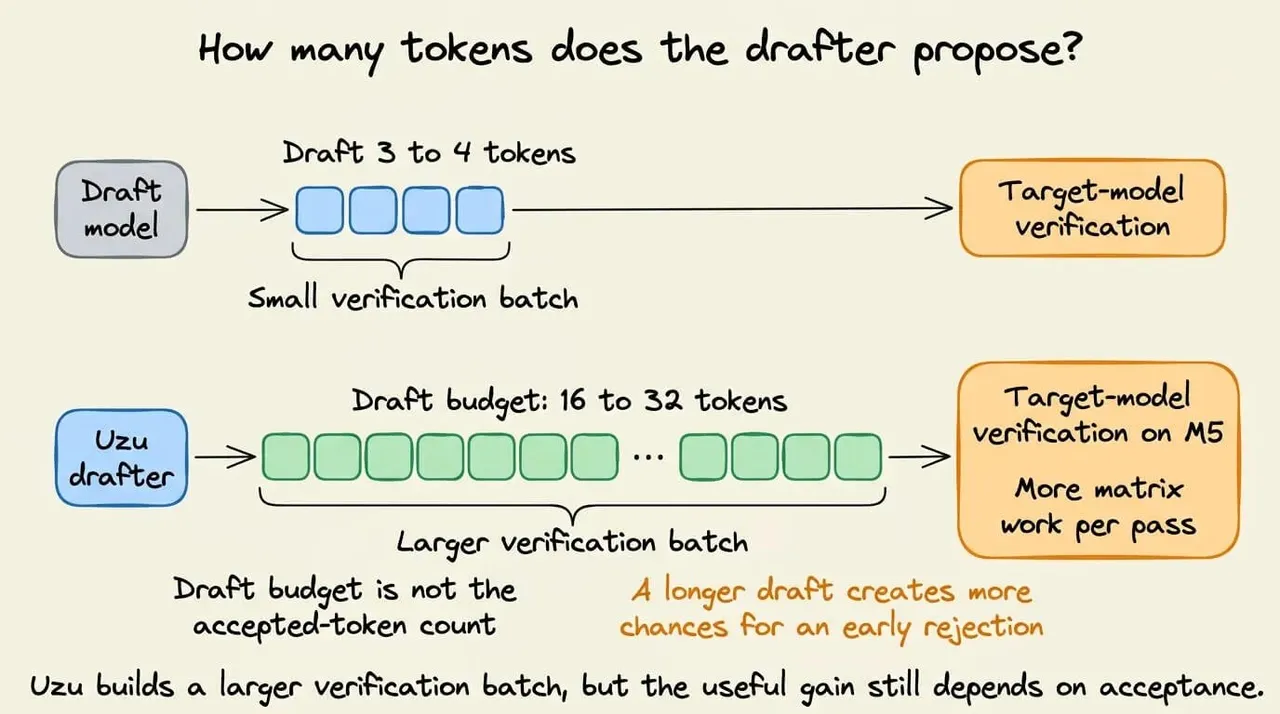
许多模型原生系统草拟三到四个 token。一个常见的例子是多 token 预测(MTP),即在模型本身中训练额外的预测头来猜测接下来的几个 token。
Uzu 在其 M5 路径上使用 16 到 32 个 token 的预算。本文后面使用的 Qwen3.5 9B 检查点配备了针对 M5 系列芯片的 16-token 树预算。
这些更大的批次给 M5 的神经加速器提供了足够的工作量。这些是构建在每个 GPU 核心中的矩阵单元,只有矩阵乘法有大量行时它们才划算。一次检查 16 个候选 token 给它们 16 行工作,而不是 1 行。
更长的并行草稿带来了连贯性问题。
Issue with parallel draft generation(并行草稿生成的问题)
快速的并行草稿器一次性预测多个未来位置。
如预期,每个位置都看到现有上下文,但看不到在更早草稿位置选择的 token。
考虑一个以 “She went to the store to buy.” 结尾的提示词。独立的位置可能偏好 “a”、“few”、“of” 和 “milk”。每个 token 单独看都看似合理。组合在一起却产生 “a few of milk”。
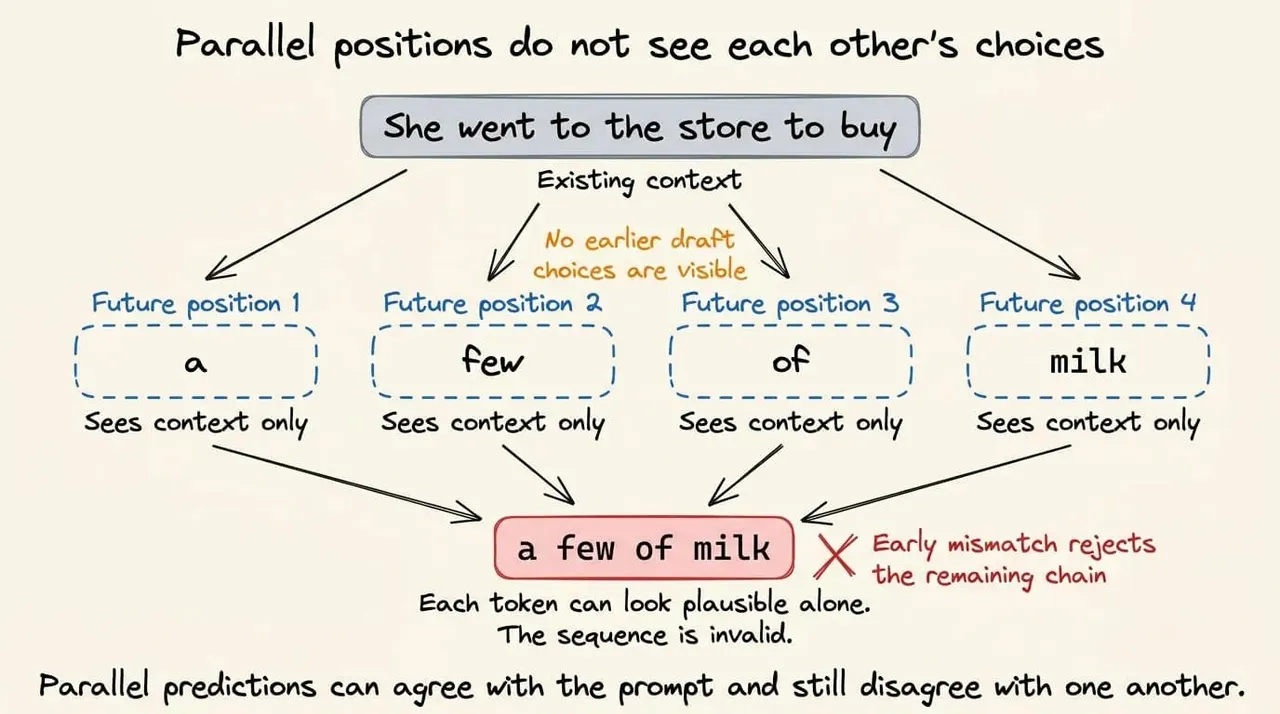
早期的失配会拒绝后续的链。这就是随着并行草稿增长接受率趋于下降的原因。更多位置为单独看似合理的 token 形成无效序列创造了更多机会。
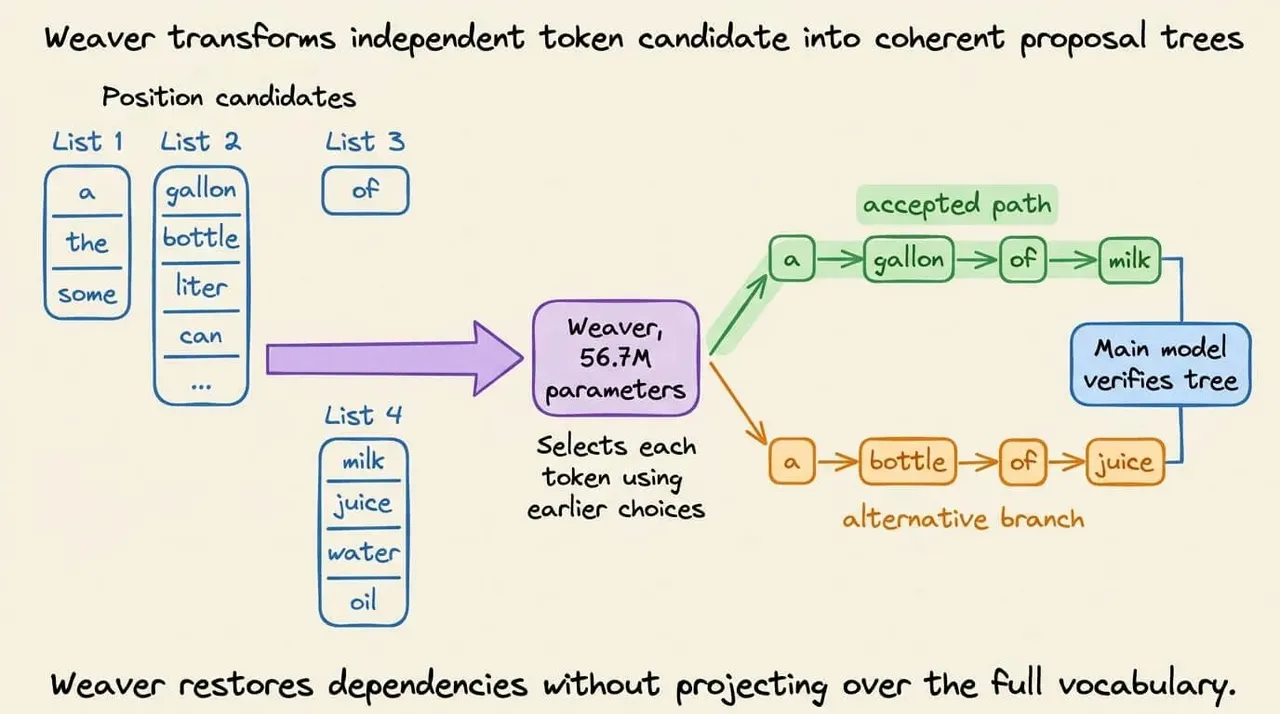
**Trees from Marginals 论文**引入了 Weaver 来修复这一弱点。Weaver 是论文研究设置中的一个 56.7M 参数的自动回归适配器。它操作于候选候选列表,而不是在全词汇表上进行投影。
并行的 DFlash 草稿器首先一次性预测每个未来位置的可能候选。Weaver 然后按顺序从这些候选中选择。每次选择都可以依赖于更早的选择。
之前的例子现在可以变成 “a gallon of milk”。后来的选择遵循已经选择的路径。
Weaver 还可以保留多条连贯路径。一个分支可能包含 “a gallon of milk”。另一个可能包含 “a bottle of juice”。主模型验证树并接受最长的有效路径。
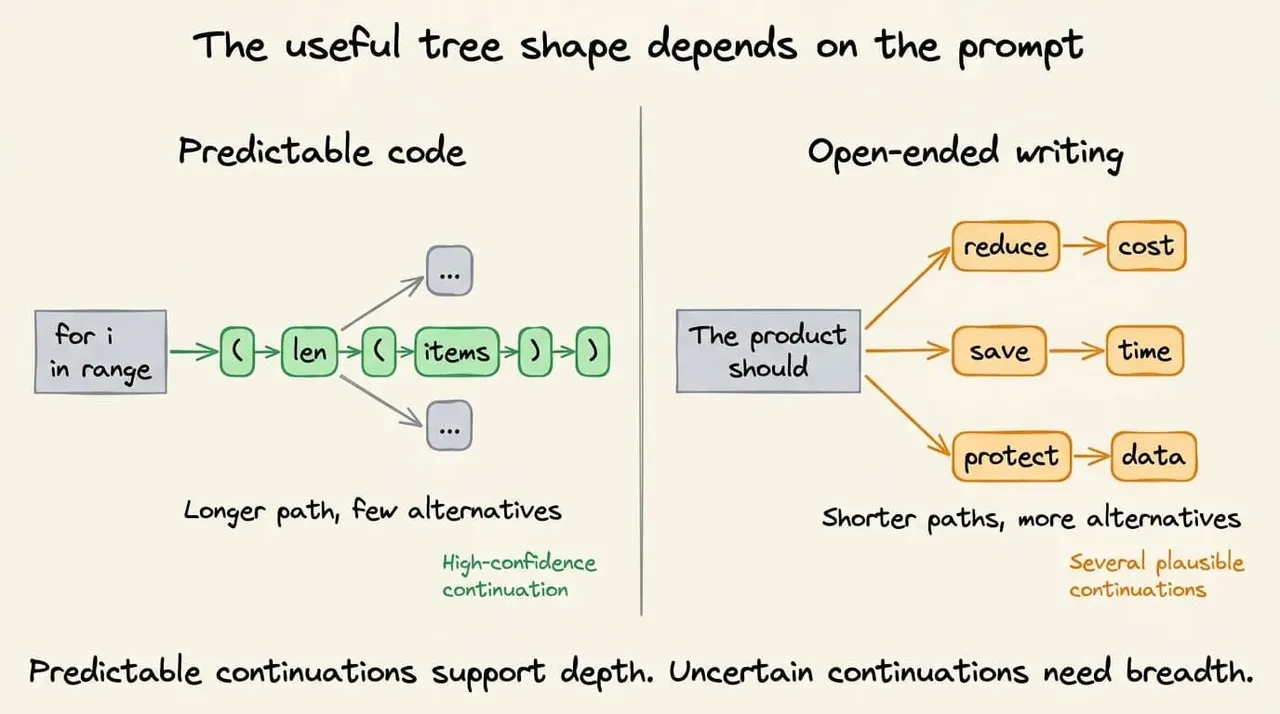
树的形状可以适应提示词。可预测的代码可以支持长而窄的分支。开放式写作可能需要更短的分支和更多替代方案。
论文报告称,相比优化后的 DFlash 基线改善了 24.7%。它还报告了相比自动回归解码 4.37 倍的加速。那些实验使用了 CUDA 和 SGLang。它们是研究结果,不是普遍适用的 Uzu 测量。
Uzu 将相同的草稿思想应用于其面向 Apple 的运行时。剩余的问题是在目标模型上高效地验证树。
Verifying a draft tree without restoring model state(在不恢复模型状态的情况下验证草稿树)
一些模型层维护一个持续的内部状态。每个新 token 读取该状态并更新它。对于单序列,运行时按顺序应用这些更新。
草稿树产生了几个可能的后续序列。每个分支都会以不同方式更新状态。如果运行时在检查一个分支时更新其实时状态,它必须在检查另一个分支之前恢复先前的状态。在大树上重复该过程会增加内存操作和重复工作。
Qwen3.5 和 Qwen3.6 包含称为 Gated DeltaNet 层的有状态层。注意力层维护一个不断增长的过去每个 token 的缓存。Gated DeltaNet 层则将其所见的一切压缩成固定大小的状态,而每个被接受的 token 都会改变该状态。
在 Qwen3.5 9B 中,32 层中有 24 层是这种类型。
Uzu 将检查分支与提交其状态分开。在验证期间,它计算每个候选分支所需的值,而不改变实时状态。主模型然后选择被接受的路径。Uzu 仅对被接受的 token 应用状态更新。
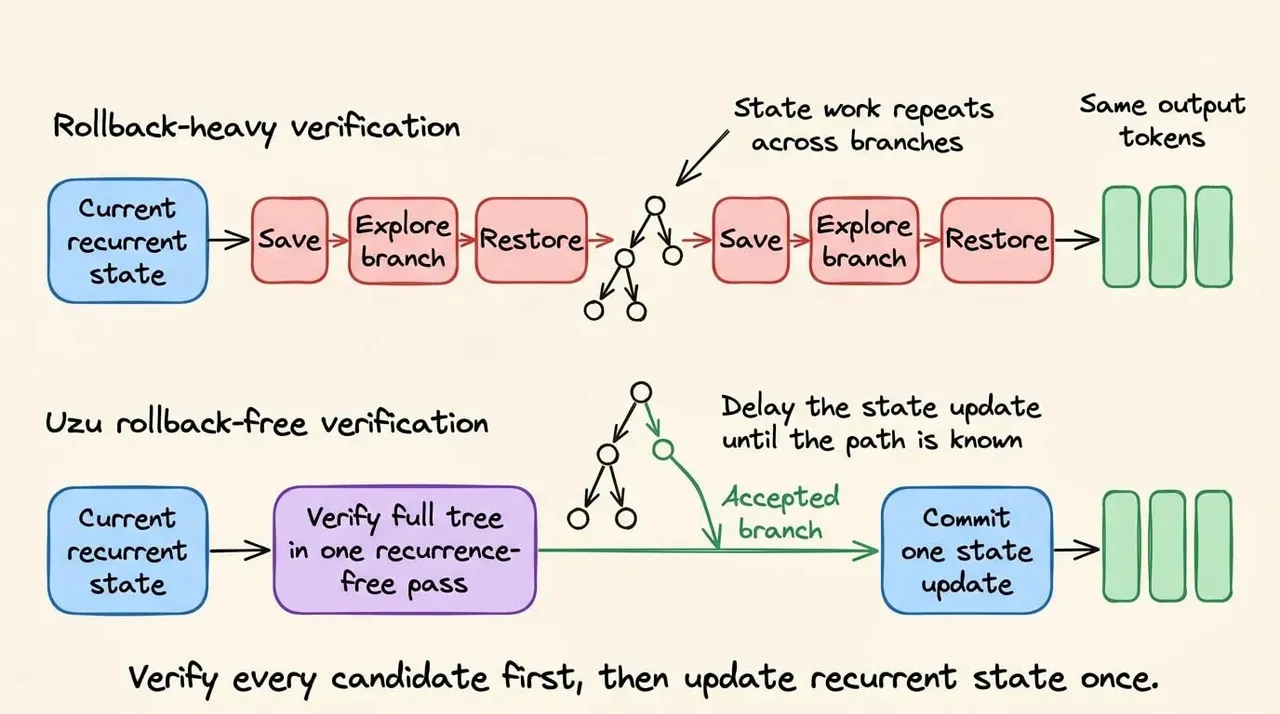
这份 **Uzu 实现说明**将其称为免回滚树验证。其 Metal 内核以单次无循环遍过程计算整棵树的 DeltaNet 输出,而非逐分支逐 token 地推进。
随后,状态仅沿选定路径提交,因此永远不会出现需要回滚的错误更新。
这一点很重要,因为只有当验证成本低于逐 token 常规解码时,投机解码才有意义。反复恢复状态会消耗掉部分收益。
Weaver 与免回滚验证相结合,使 Uzu 能够提出长 token 序列,并在不反复恢复模型状态的情况下对其进行校验。
What this looks like on a base M5(在基础款 M5 上的表现)
为了对比常规解码、传统投机解码和 Uzu 方法的差异,我们在配备基础款 M5 芯片和 16 GB 统一内存的 MacBook Pro 上,用三种方式运行了同一个 Qwen3.5 9B 模型:
- llama.cpp,无投机解码
- llama.cpp,使用模型内置 MTP 头提前起草 3 个 token,即传统配置
- Uzu,搭配 DFlash 和 Weaver
三者均使用 4-bit 权重和相同的提示词:「编写一个 Python 函数,用于合并两个已排序列表。」
Published benchmark comparisons(已发布的基准对比)
目前已有一些针对 Uzu 的公开基准,用于衡量输出速度、输入速度、内存占用和量化质量。
以下投机解码结果使用 **Qwen3.6 27B Mirai-M**。该检查点占用 15.6 GB。Mirai 在配备 128 GB 内存的 M5 Max 上进行了测量。
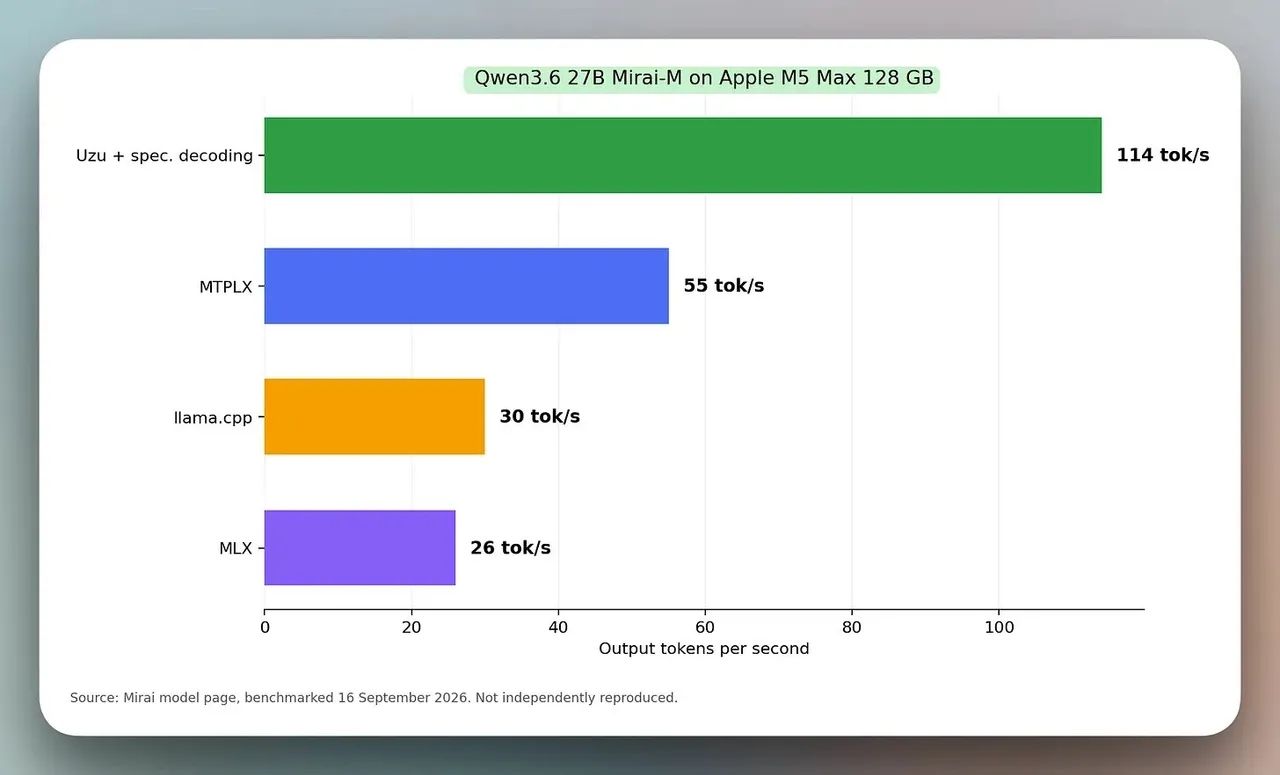
这些数据显示 Uzu 的速度为:
- MTPLX 的 2.1 倍
- llama.cpp 的 3.8 倍
- MLX 的 4.4 倍。
此外,Uzu 在无投机情况下每秒可达 35.54 个 token。其投机解码结果达到每秒 114 个 token,这意味着投机路径带来了 3.2 倍的增益。
还有按提示词类型划分的输出生成速度结果。
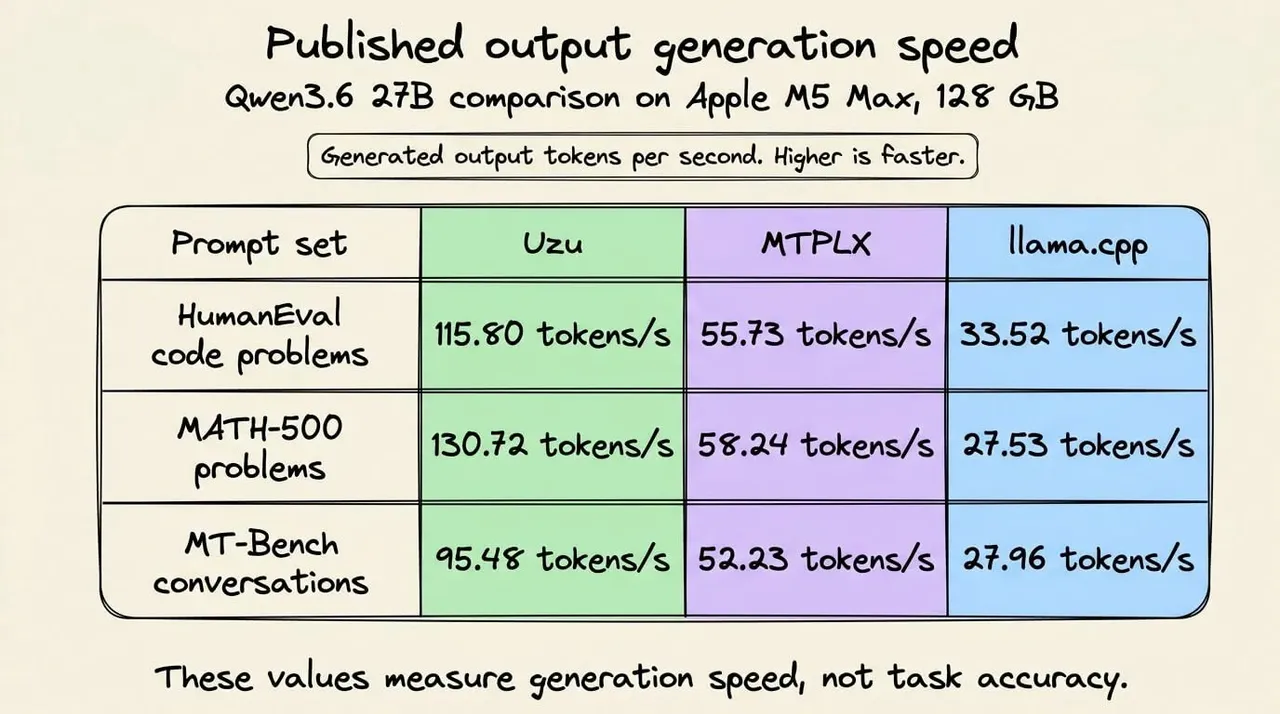
代码和数学中包含大量可预测的延续内容。开放式对话给起草者提供的可靠 token 则较少。因此,投机速度是工作负载属性,而非固定模型参数。
Run a model locally and inspect the runtime(本地运行模型并检查运行时)
体验 Uzu 最快的方式是其命令行工具。它通过 Homebrew 安装,并在首次使用时下载所选模型。
brew install mirai

mirai --model trymirai/Qwen3.5-9B-M \
-m "Write a python function to merge two sorted lists"我们使用 Mirai CLI 0.6.1 在配备基础款 M5 芯片、16 GB 统一内存、运行 macOS 26.6.2 的 MacBook Pro 上进行了测试。首次运行会下载模型。
以下是实时运行情况:
输出答案后,CLI 打印了以下统计信息:
time to first token: 0.12 s
prefill speed: 161.11 t/s
generation speed: 98.10 t/s
tokens per forward pass: 8.39 t/f
memory used: 5.77 GB
total energy: 114.90 J
input energy per token: 0.11 J/tok
output energy per token: 0.16 J/tok
duration: 7.36 s这些数字的含义如下:
- 首个 token 时间指答案第一个 token 出现前的等待时长,其中大部分时间用于读取提示词。
- 预填充速度指引擎读取提示词的速度,单位是每秒处理的提示词 token 数。我们的提示词仅约 20 个 token,太短,这个数字说明不了太多问题。提示词越长,该数值会越高。
- 生成速度指答案写入速度,单位是每秒输出的 token 数。这就是前面提到的解码阶段,受内存带宽限制。
- 每次前向传播的 token 数指 9B 模型每次前向传播平均产出的输出 token 数。常规解码恰好为 1.00。
- 内存使用指引擎占用的统一内存,主要是模型权重加上起草者和缓存。
8.39 t/f 的数值体现了投机路径的作用。平均每次 9B 模型的前向传播产生约 8 个 token。这就是在单 token 限制约 29 的芯片上生成速度能达到 98 tok/s 的原因。
不同运行之间速度略有差异。在我们对该命令的多次运行中,生成速度在 92 到 117 tok/s 之间,每次前向传播产出 7.5 到 9.6 个 token。
投机按芯片启用。该检查点的投机器配置列出了 M5、M5 Pro 和 M5 Max,因此在 M1 至 M4 Mac 上,同一命令运行时不带起草者,并报告 1.00 t/f。
CLI 会输出延迟、吞吐量、内存、能耗和投机数据。现在我们可以从应用程序中调用相同的运行时。
Call Uzu through a local application endpoint(通过本地应用程序端点调用 Uzu)
Uzu 可以暴露一个兼容 OpenAI 的 HTTP 端点。模型仍然运行在用户 Mac 上,HTTP 请求仅经过本地回环接口。
在一个终端中启动服务器:
mirai server --model trymirai/Qwen3.5-9B-M --port 8000 --no-prefix-cache服务器加载一个本地检查点,并在 127.0.0.1 上监听,同一台 Mac 上的进程可以调用它。这对于已经通过 OpenAI 聊天协议交互的现有应用程序非常有用。
默认情况下,Uzu 保留前缀缓存。它存储先前提示词已处理的开头部分,因此重复的提示词可以跳过大部分预填充。--no-prefix-cache 可关闭此功能,使每次测试请求都执行完整工作,重复运行保持可比性。
现有应用可以通过将 OpenAI 客户端指向 http://127.0.0.1:8000/v1 来切换到 Uzu。下一节将使用一个小型客户端,以完全相同的方式对 Uzu、MLX 和 llama.cpp 进行计时。
为 Uzu、MLX 和 llama.cpp 使用同一个客户端
以下是在基础版 M5 上通过每个引擎运行的相同提示词。每个引擎独立运行,机器上没有其他任务。
llama.cpp 和 MLX 都低于每秒 29 个 token 的限制,这符合每轮仅产生一个 token 的预期。在这次记录中,Uzu 在同一芯片上的写入速度约为 MLX 的 3.7 倍。
要使用自己的提示词进行此比较,请将每个引擎作为本地服务器启动,并使用一个客户端对三者进行计时。
本地服务器接口为我们提供了一种实用的比较方法。
Uzu、MLX LM 和 llama.cpp 都可以提供 OpenAI 风格的聊天端点。我们可以将 Qwen3.5 9B 运行在三个引擎上,并向每个服务器发送相同的提示词。
使用 Mirai 的 4 位 Medium 检查点 启动 Uzu:
mirai server --model trymirai/Qwen3.5-9B-M --port 8000使用同一基础模型的 4 位 MLX 转换 启动 MLX LM:
brew install uv
uv tool install mlx-lm
uv tool update-shelluv tool update-shell 将包含 mlx_lm.server 的目录添加到您的 shell 路径中。
运行后打开一个新终端,然后启动服务器:
mlx_lm.server --model mlx-community/Qwen3.5-9B-4bit --port 8001使用 Mirai 已发布比较中使用的 Q4_K_S GGUF 检查点 启动 llama.cpp:
brew install llama.cpp
llama-server --version

llama-server \
  -hf unsloth/Qwen3.5-9B-MTP-GGUF:Q4_K_S \
  --alias qwen3.5-9b-q4-k-s \
  -ngl 99 -fa on -c 8192 -np 1 \
--port 8002-c 8192 防止 llama.cpp 预留模型的完整 262K 上下文,因为这在 16 GB Mac 上无法与权重共存。 -np 1 运行单个槽位。要像第一个视频中那样启用 llama.cpp 的 MTP 起草,请添加 --spec-type draft-mtp --spec-draft-n-max 3。MTP 需要 -np 1。
每个服务器首次启动时会下载其检查点。请一次运行一个服务器,以便在测量期间只有一个 Qwen3.5 9B 副本占用统一内存。
这三个检查点来自同一个 Qwen3.5 9B 模型,但它们不使用相同的文件格式或量化配方。Uzu 使用 Mirai-M,MLX 使用自己的 4 位转换,llama.cpp 使用 Q4_K_S。因此,这是对开发者可以运行的完整引擎路径的比较,而非仅限内核的测试。
对端口 8000、8001 和 8002 运行基准客户端,每次一个服务器。
测试工具应保持提示词文本、输出限制、采样设置和运行次数固定。使用可比的量化质量,而不仅仅是相似的位宽。在端到端客户端时间之外,记录原生引擎指标。
最后,这是一个独立的客户端。将其保存为 compare_client.py。它仅使用 Python 的标准库,并向任何兼容 OpenAI 的本地端点发送相同的确定性提示词。
它关闭思考功能,使每个引擎直接回答,并询问每个服务器的 token 使用情况。它报告首个 token 的时间、端到端时间和解码速度。
Uzu 还会报告其运行的目标模型遍数,因此对于 Uzu,脚本也会打印每遍的 token 数。
import json, os, sys, time, urllib.request

PROMPT = "Write a Python function that merges two sorted lists."

body = json.dumps({
    "model": os.environ["MODEL"],
    "messages": [{"role": "user", "content": PROMPT}],
    "temperature": 0,                                    # same answer every run
    "max_tokens": 1024,
    "stream": True,                                      # tokens arrive as they are made
    "stream_options": {"include_usage": True},           # server reports token counts
    "chat_template_kwargs": {"enable_thinking": False},  # answer directly, no thinking
}).encode()
request = urllib.request.Request(os.environ["ENDPOINT"], body, {"Content-Type": "application/json"})

start = time.perf_counter()
first = last = None
usage = {}

with urllib.request.urlopen(request, timeout=600) as response:
    for line in response:
        line = line.decode().strip()
        if not line.startswith("data:"):
            continue
        data = line[5:].strip()
        if data == "[DONE]":
            break
        event = json.loads(data)
        usage = event.get("usage") or usage
        for choice in event.get("choices") or []:
            delta = choice.get("delta") or {}
            text = delta.get("content") or ""
            if text or delta.get("reasoning_content") or delta.get("reasoning"):
                last = time.perf_counter()
                first = first or last
            print(text, end="", flush=True)

if first is None:
    sys.exit("No tokens received. Check the server log.")

tokens = usage.get("completion_tokens", 0)
print(f"\n\ntime to first token: {first - start:.2f} s")
print(f"end-to-end time:     {time.perf_counter() - start:.2f} s")
if tokens > 1 and last > first:
    print(f"decode speed:        {(tokens - 1) / (last - first):.1f} tok/s")
if usage.get("spec_verify_ct"):  # only Uzu reports how many model passes it ran
print(f"tokens per pass: {tokens / usage['spec_verify_ct']:.2f}")一次运行一个引擎
一次只运行一个服务器,以便模型的一个副本驻留在统一内存中,且两个引擎不会争用内存带宽。
对于每个引擎,在一个终端中启动服务器,然后在第二个终端中运行客户端两次。第一次运行包括预热工作,因此丢弃它并保留第二次。在继续之前,使用 Ctrl-C 停止服务器。
对于 Uzu,在第一个终端中启动服务器:
mirai server \
  --model trymirai/Qwen3.5-9B-M \
  --port 8000 \
--no-prefix-cache从第二个终端运行客户端:
ENDPOINT=http://127.0.0.1:8000/v1/chat/completions \
MODEL=trymirai/Qwen3.5-9B-M \
python3 compare_client.py运行客户端两次。丢弃第一次结果,因为它包含预热工作。保留第二次结果以及 Uzu 服务器打印的解码统计信息。然后使用 Ctrl-C 停止 Uzu。
在第一个终端中启动 MLX:
mlx_lm.server \
  --model mlx-community/Qwen3.5-9B-4bit \
--port 8001从第二个终端运行相同的客户端:
ENDPOINT=http://127.0.0.1:8001/v1/chat/completions \
MODEL=mlx-community/Qwen3.5-9B-4bit \
python3 compare_client.py同样,丢弃第一次运行并保留第二次。使用 Ctrl-C 停止 MLX。
在第一个终端中启动 llama.cpp:
llama-server \
  -hf unsloth/Qwen3.5-9B-MTP-GGUF:Q4_K_S \
  --alias qwen3.5-9b-q4-k-s \
  -ngl 99 -fa on -c 8192 -np 1 \
--port 8002从第二个终端运行客户端:
ENDPOINT=http://127.0.0.1:8002/v1/chat/completions \
MODEL=qwen3.5-9b-q4-k-s \
python3 compare_client.py丢弃第一次运行并保留第二次。比较应保持以下设置固定:
- Mac 及其电源模式
- 提示词和聊天模板
- 输出 token 限制
- 温度和采样设置
- 预热次数
- 测量请求的数量
客户端的解码速度包括 HTTP 流式传输,因此预计会略低于每个引擎在其日志中打印的速度。比较客户端的数字,而不是与 CLI 数字比较。
Mirai CLI 没有用于关闭推测的开关,因此此过程比较完整的引擎路径,而不是隔离 DFlash-Weaver。
在第一段视频中,llama.cpp 在启用和不启用 MTP 的情况下运行,是观察投机解码效果的最接近的同引擎视角。
Conclusion(结论)
加载量化检查点只是本地推理的第一步。
真正的工作在于,当每个请求都在用户的设备上以批量大小为一运行时,保持生成的实用性。
Uzu 在多个层面处理这个问题。
- 量化减少了内存流量。
- 其 Metal 内核针对 Apple 硬件优化。
- DFlash-Weaver 提出了更长的 token 序列,而无需回滚的验证则检查这些序列,无需重复恢复循环状态。
在基础 M5 上,这一组合将 4 位 9B 模型从使用普通 llama.cpp 的每秒 22 个 token 提升到使用 Uzu 处理相同提示词时的每秒 92 个。
接受率随工作负载而变化。硬件、量化质量、上下文长度和热状态也会改变结果。正确的测试应使用应用程序的提示词,并同时测量质量和延迟。
如果您想深入了解,**Uzu 仓库**包含引擎、本地服务器、构建说明以及 Rust、Swift、Python 和 TypeScript 的绑定。
从本地服务器开始,运行本文中的基准客户端,并将示例提示词替换为实际产品中的请求。
git clone https://github.com/trymirai/uzu.git(别忘了给它加星标 ⭐️)
祝您愉快!
