
我拆解了大型语言模型到底是怎么构建出来的:ChatGPT、Claude 和 Gemini 背后的完整流程,并把它压缩成一张路线图。
收藏这篇,保存下来。 读完之后,你会理解从原始互联网文本到一个能像助手一样回答问题的模型,中间精确经历的五阶段路径。
关注我的 Substack,获取新的 AI 高价值信息:movez.substack.com
这不是夸张。大多数人以为构建 LLM 的关键是架构。这里最核心的一课是:架构反而是最不重要的部分。
关于 LLM,人人都相信的误解
问大多数人,如何构建一个像 Claude 这样的模型,他们会回答:“Transformer。”好像秘密就在神经网络设计里。
并不是。Transformer 架构基本已经标准化,而且公开发布。每个大实验室用的构件大体相同。如果架构是护城河,那所有人早就拥有 GPT-4 了。
真正会重塑你理解的一句话是:在实践中,决定模型成败的是数据、评测和系统,而不是架构微调。最好的模型不只是被训练出来的。它们是被工程化出来的。
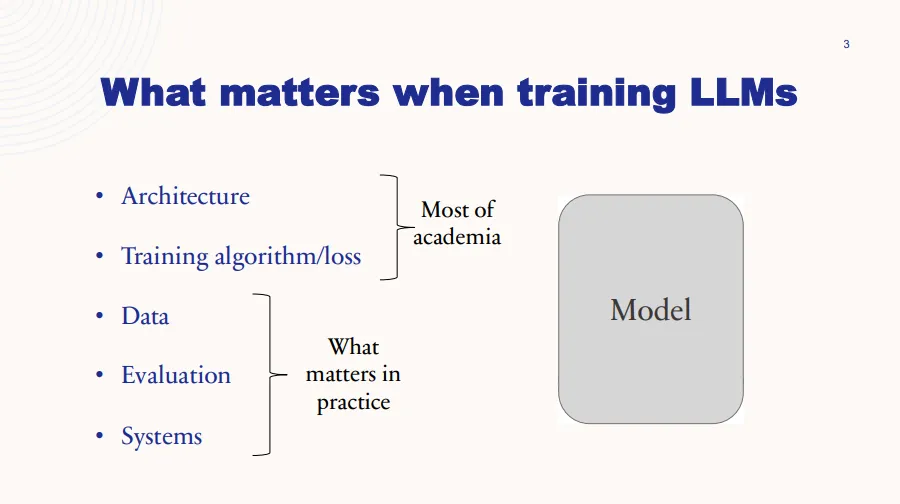
所以这份指南围绕真正重要的事情展开。五个阶段。架构只是第一阶段里的一个脚注。剩下四个阶段,才是真实模型胜负所在。
01. 预训练:教会模型语言本身
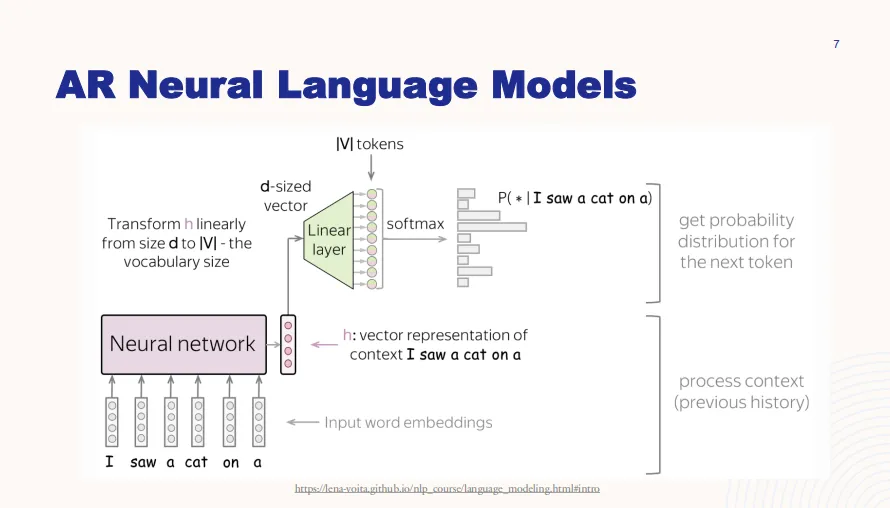
一切都从一个看似简单、实则很深的目标开始:预测下一个词。 这就是自回归语言建模。给定一串词,模型学习接下来会出现什么内容的概率分布。
只要在足够多文本上做这件事,模型就会吸收语法、事实和推理模式。不是因为有人显式教了它们,而是因为想要很好地预测下一个词,就必须掌握这些东西。
分词是第一步
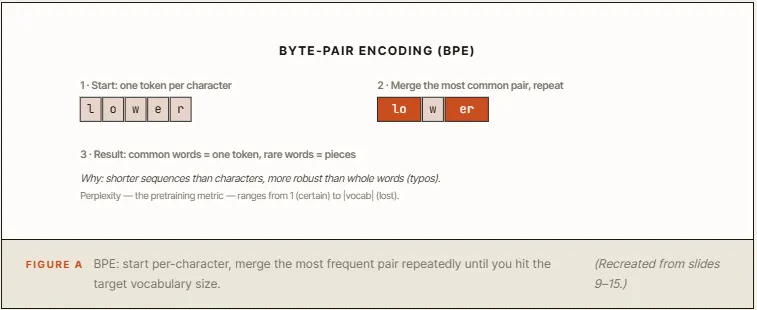
在模型看到文本之前,文本会先被切分成 token。标准方法是 Byte-Pair Encoding(BPE),它的逻辑会影响后续整个流程。
架构:最不重要的那部分
模型是一个 Transformer。对这一节来说,基本就是这样,而这正是重点。你不会靠发明一个更聪明的 Transformer 取胜。 真正的胜负在另外四个阶段。
课程里用缩放曲线证明了这一点:Transformer 只是比 LSTM 拥有更好的常数项和斜率。选标准工具,然后继续往下走。
02. 数据:模型真正的决胜之地
如果架构最不重要,那么数据最重要。这个阶段把好模型和普通模型分开,也是大多数人最容易低估的部分。
流程从 Common Crawl 开始。它是一次对公共网页的大规模抓取,大到要用 PB 衡量:2500 亿个网页,超过 100 万 GB。但原始网页数据非常脏。
把它变成训练材料,是一个残酷的多步骤过滤过程。
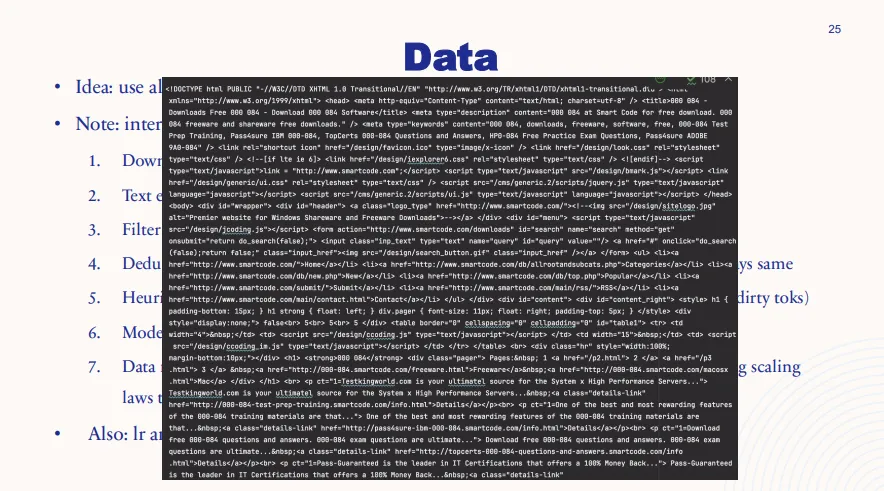
处理流程大致如下:
- 提取:从 HTML 中抽取文本,同时处理数学公式、模板化内容等特殊情况。
- 过滤:去掉不想要的内容,例如 NSFW、有害内容和个人数据。
- 去重:按 URL、文档和行去重。网页会无休止地重复同样的页眉、页脚和菜单。
- 启发式过滤:按词数、异常 token、脏 token 等指标去掉低质量文档。
- 基于模型的过滤:预测一个页面是否可能被 Wikipedia 引用。
- 数据混合:把内容分成代码、书籍、娱乐等类别,并用扩展律重新加权不同来源域。
值得刻进脑子里的那句话是:数据质量胜过数据数量。 把数据收集好,是实践 LLM 工作里的关键部分,也是最隐秘的部分。
把数据收集好,是实践型 LLM 的关键,也是这个领域最严密守护的秘密。
封闭数据集远大于开放数据集:LLaMA 3 用 15 万亿 token 训练;GPT-4 估计用了 13 万亿 token。
03. 缩放定律——最优地使用算力资源
你有 1 万张 GPU,可以用一个月。你该训练什么模型?更大的模型,还是在更多数据上训练?靠猜会浪费数百万美元。缩放定律可以给出可预测的答案。
经验发现是:更多数据和更大模型会可靠地带来更好性能,而且在真正训练之前,就可以根据模型规模和数据量预测模型表现。
现代流程会先在小模型上调超参数,然后沿着曲线外推到最终那次巨大的训练运行。
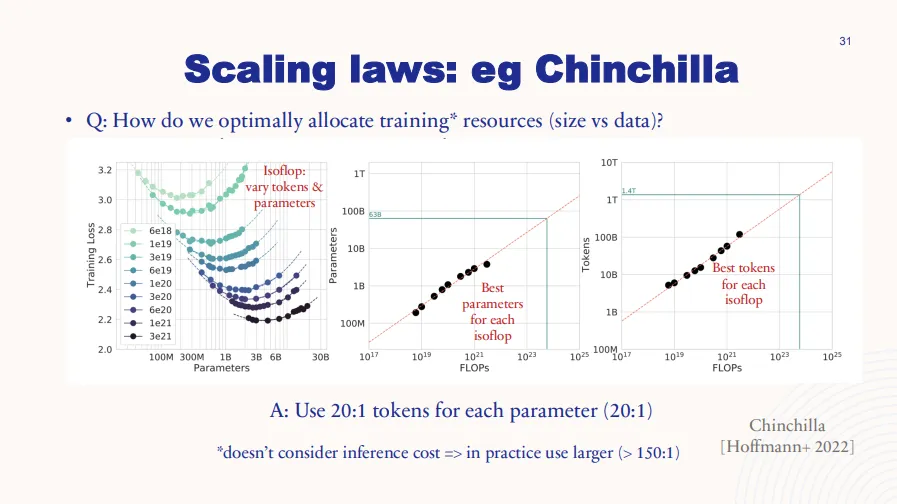
著名的 Chinchilla 结论是:大约 每个参数 20 个训练 token,在训练成本上是计算最优的。但这只考虑训练成本。
一旦把运行模型的成本,也就是推理成本算进去,实际比例会急剧上升,超过 每个参数 150 个 token。你会用更多数据训练一个更小的模型,因为之后要把它运行数百万次。
还有一个元教训,也就是所谓的“苦涩教训”:不要过度复杂化。做简单的事,然后把它扩展起来。 从长期看,唯一真正重要的是利用计算。
04. 后训练:把预测器变成助手
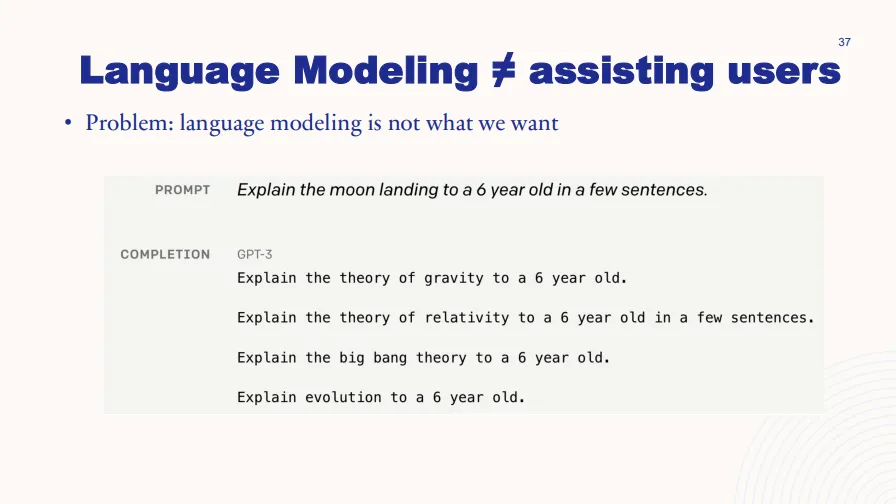
预训练之后,你得到的是一个强大但不适合聊天的东西。它会补全文本,但不知道自己应该回答你。
你问它一个问题,它可能接着生成另外三个问题;从“预测下一个词”的角度看,这完全可能是合理续写。
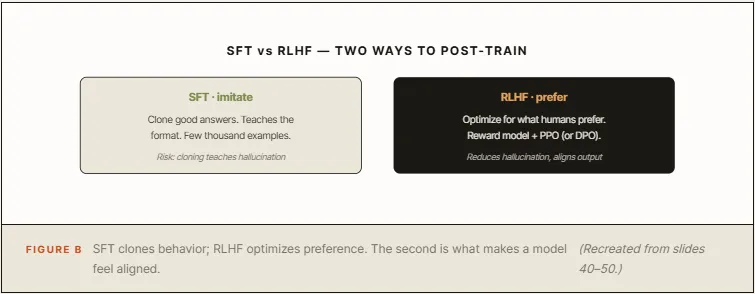
监督微调(SFT)
你给模型看成千上万个示例:一个提示词后面跟着一个好回答。模型会学习模仿这种模式。这就是行为克隆,也是 从 GPT-3 到 ChatGPT 的关键一步。
令人意外的是,你需要的数据很少。几千个示例就足够了,因为 SFT 只是在教模型“好答案的格式”。知识早已存在于预训练模型里。
Alpaca 项目甚至用另一个 LLM 生成自己的数据:52,000 对指令与回答,用来把一个 LLaMA 7B 微调成有能力的助手。
RLHF:按人类偏好对齐
SFT 有三个问题:它受限于人的能力;它会教模型幻觉,也就是克隆一个模型其实不知道的“正确”答案,等于教它编东西;理想答案的获取成本很高。RLHF 通过优化偏好而不是模仿来解决这些问题。
模型生成两个答案。人类选择更好的那个。这些偏好会训练一个奖励模型,然后再优化 LLM,让它最大化这个奖励。经典做法是使用 PPO。
一个更简单的现代替代方案是 DPO。它用普通监督学习就能达到相近质量,现在已经成为开源社区的标准做法。
05. 评测与系统:证明它有效,并让它真正可行
有两件事包裹着整条流程。跳过任何一个,你都没有真正的模型。
评测:衡量开放式输出
预训练期间,指标是困惑度:模型在多少个 token 之间“犹豫”。2017 到 2023 年间,最好的模型从大约 70 个 token 中犹豫,下降到少于 10 个。但对齐之后,困惑度就失效了,所以评测会转向基准和比较:
- MMLU 与 HELM:包含许多领域、带标准答案的任务套件。MMLU 是最受信任的预训练基准之一。
- Chatbot Arena:人类盲测比较两个模型并投票;超过 30 万票支撑一个 Elo 排行榜。
- AlpacaEval:让一个 LLM 评判其他 LLM。它与 Chatbot Arena 的相关性达到 98%,耗时不到 3 分钟,成本低于 10 美元,但也有偏差,比如偏爱更长的回答。
诚实的结论是:评测一个已经对齐的模型确实很难,没有任何单一数字能完整描述它。同一个模型在 MMLU 上可能得 0.637,也可能得 0.488,差别只来自提示词格式。
系统:让训练在物理上可行
每个人都会被算力卡住。GPU 昂贵、稀缺,而且还受到通信速度的物理限制。一个 7B 模型如果天真训练,光训练就需要约 112GB 内存。因此系统层不是可选项;它让整件事变得可行:
- 低精度:使用 16 位(bf16)而不是 32 位,内存减半,速度提升。
- 算子融合与分块:减少访问全局内存的慢路径;仅 FlashAttention 就能带来约 1.7 倍端到端加速。
- 数据并行:把数据集拆分到多张 GPU 上,用 ZeRO 切分优化器状态来节省内存。
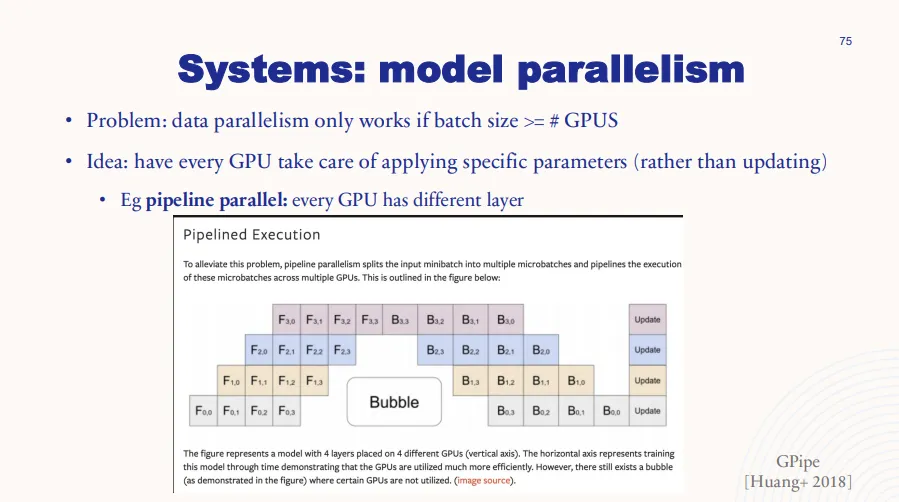
- 模型并行:把模型按层拆到多张 GPU 上,也就是流水线并行;或者按矩阵拆分,也就是张量并行。
- 稀疏性:专家混合(Mixture of Experts):通过每个 token 只激活一部分参数,在相同 FLOPs 下拥有更多参数。
整条流程真正教会我们的东西
回头看这五个阶段,核心论点已经非常清楚。架构,也就是人人痴迷的部分,反而获得了最少关注。数据、扩展、对齐、评测和系统,才是所有真实决策发生的地方。
这就是为什么两个实验室即使用同一种架构,也会做出差异巨大的模型。架构是共享的。真正重要的东西不是。
会拖垮 LLM 项目的错误
- 痴迷架构。 这是整个技术栈里最容易被复制、也最不具备差异化的部分。
- 把数据当成普通商品。 脏数据会封住上限,不管你有多少算力。质量优先于数量。
- 跳过 Chinchilla 数学。 对数据量来说过大的模型,会训练不足并浪费算力。
- 停在 SFT。 微调模型会模仿;没有 RLHF 或 DPO,它永远学不会人真正偏好的是什么。
- 在对齐之后仍然相信困惑度。 后训练会改变分布,困惑度会失去意义。
结语
好模型不是训练出来的。它是工程化出来的。
大多数人会继续相信,构建 LLM 的关键是架构;继续阅读 Transformer 解释文章;继续错过真正工作的发生地点。
理解这条流程的人会看得很清楚:先是语言建模,然后是干净数据,然后是最优扩展,然后是对齐,最后是在高效系统上的诚实评测。五个阶段。架构只是其中一个阶段里的一段话。
选一个你一直忽视的阶段深入下去,可能是数据,也可能是评测。差异就藏在那里。
